Contents — find the section you need
Vision-Language-Action (VLA)-Modelle sind eine Architektur, die Kamerabilder und natürlichsprachliche Anweisungen in einem einzigen System vereint und die Aktionen (Motorbefehle) eines Roboters direkt ausgibt. Im Gegensatz zur traditionellen Robotik, die Wahrnehmung (Erkennung) und Steuerung (Planung und Ausführung) als separate Prozesse konzipierte, besteht der Kerngedanke hier in einem Paradigmenwechsel: der Integration beider in ein einziges Transformator-Modell.
Vision-Language-Action (VLA)-Modelle sind eine Architektur, die Kamerabilder und natürlichsprachliche Anweisungen in einem einzigen System vereint und so die Aktionen eines Roboters (Motorbefehle) direkt ausgibt.
 Sehen + Sprache → Handlung
Für die großen VLA-Unternehmen (Physical Intelligence usw.) konnte kein lizenzfreies offizielles Logo gefunden werden. Daher wurde stattdessen ein einfaches Symbol erstellt, das die Integration von Sehen, Sprache und Handlung darstellt.
VLA auf einen Blick
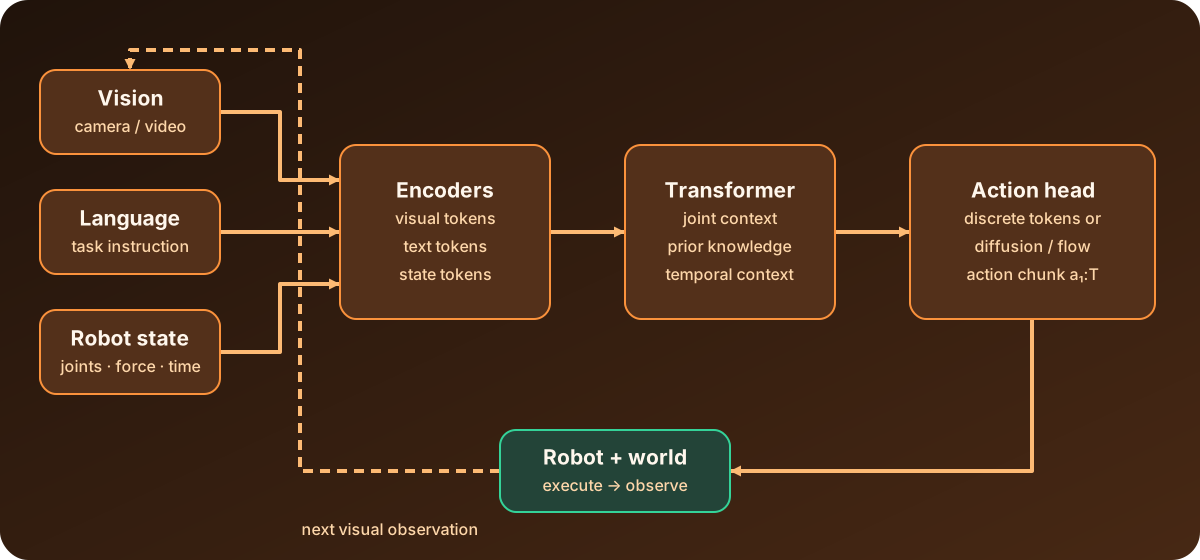
Diagramm: Duskcoil. Es vereinfacht die Darstellung des Zusammenhangs zwischen VLA-Inferenz und Feedback aus der physischen Welt.
Ein VLA ist nicht nur ein Modell, das Bilder und Sprache lesen kann; es ist Teil eines geschlossenen Regelkreises, dessen Ausgabe mit einer physischen Aktion verknüpft ist. Bilder, Anweisungen und Gelenkzustände werden in eine gemeinsame Repräsentation abgebildet, ein Transformer integriert den Kontext, und ein Aktionskopf wandelt ihn in einen Aktionsblock um. Da die Beobachtung nach der Ausführung die nächste Eingabe darstellt, muss die praktische Evaluierung neben der Modellgenauigkeit auch die Inferenzlatenz, die Aktionsglätte und einen Mechanismus umfassen, der bei abnormalem Verhalten sicher stoppt.
Entwicklung: Von RT-1 über RT-2 zu OpenVLA
Googles RT-1 war ein frühes Vorzeigebeispiel, und sein Nachfolger RT-2 entwickelte die Idee weiter, indem er Wissen aus einem großen, mit webbasierten Bild- und Sprachdaten vortrainierten Modell zur Generierung von Roboteraktionen nutzte. Im Open-Source-Bereich folgten Modelle wie Open-VLA, Octo und CLIP-RT mit Transformer-basierten Architekturen, die auf crossmodaler Aufmerksamkeit (einem Mechanismus zur gegenseitigen Aufmerksamkeit zwischen Bild und Sprache) basieren. Allen gemeinsam ist, dass „Sehen“, „Verstehen“ und „Handeln“ nicht in separate Module aufgeteilt sind – ein einziges Netzwerk wird end-to-end trainiert. Ende, vom Input (Videomaterial plus Anweisung) bis zum Output (Aktion).
Interne Struktur: Drei Subsysteme
Die Rechenarchitektur eines VLA-Modells lässt sich grob in drei Subsysteme unterteilen. Zunächst wandelt ein Vision-Encoder die Rohpixeldaten der Kamera in eine strukturierte Merkmalsdarstellung um – oft eine Kombination aus vortrainierten Bild-Encodern wie SigLIP oder DINOv2. Anschließend folgt ein Projektionsmodul (üblicherweise ein mehrschichtiges Perzeptron), das die extrahierten visuellen Merkmale in den Einbettungsraum des Sprachmodells abbildet. Schließlich verarbeitet ein Decoder-Transformator die verkettete Sequenz aus visuellen und sprachlichen Token (Anweisungen) und generiert die endgültige Aktion.
Aktionsgenerierung: Zwei Designansätze
Nach der Integration von Bildverarbeitung und Sprache gibt es im Wesentlichen zwei Designansätze für die Generierung des eigentlichen Motorbefehls (der Aktion).
Der eine Ansatz verwendet diskrete Aktions-Token: Kontinuierliche Aktionswerte (Gelenkwinkel, Geschwindigkeiten usw.) werden in eine feste Anzahl von Bins diskretisiert. (z. B. 256), und Token-IDs aus dem Vokabular des Sprachmodells, die sonst kaum verwendet werden, werden zur Darstellung von Aktionen umfunktioniert. Der Vorteil besteht darin, dass Bildverarbeitung, Sprache und Aktion einheitlich als dieselbe Art von „Token-Sequenz“ behandelt werden können. Die Aktionssequenz a_{1:T} wird autoregressiv generiert – bedingt durch die Beobachtung o, wobei jedes nächste Token auf den zuvor generierten basiert.
Diese Formulierung entspricht exakt der Vorhersage des nächsten Wortes in der natürlichen Sprachgenerierung und erfasst die Kernidee der VLA – die Verarbeitung von Bildverarbeitung, Sprache und Aktion innerhalb desselben probabilistischen Modells.
Der andere Ansatz verwendet einen diffusionsbasierten Aktionskopf: Die Aufgabe des Transformators beschränkt sich auf die Erzeugung eines „Auslese-Tokens“, das die visuellen und sprachlichen Informationen zusammenfasst. Die Generierung der eigentlichen kontinuierlichen Aktionswerte wird an ein Diffusionsmodell übergeben. Diskrete Aktions-Token, die schrittweise generiert werden, können mitunter die Echtzeitfähigkeit beeinträchtigen. Ein auf Diffusion basierender Aktionskopf erzeugt tendenziell gleichmäßigere, kontinuierliche Aktionen, während ein solcher auf Glätte basierter Aktionskopf eine gleichmäßigere, kontinuierliche Aktionsausgabe erzeugt. Kombinationen beider Ansätze werden immer häufiger – Octo beispielsweise verarbeitet Bild- und Sprach-Tokens als Sequenz durch einen Transformator und übergibt dessen Ausgabe (das ausgelesene Token) als Bedingung an einen auf Diffusion basierenden Aktionskopf.
Was dieses Design in der Praxis bedeutet
Ein klassisches Steuerungssystem kann Situationen, für die es nicht konzipiert wurde, nur bewältigen, indem es seinem Skript folgt. Der Vorteil eines VLA-Modells liegt in der Möglichkeit, auf Bedingungen zu generalisieren, für die es nie explizit trainiert wurde. Sein Anwendungsbereich erweitert sich rasant, von der Lagerautomatisierung bis hin zu chirurgischen Assistenzrobotern, und es positioniert sich zunehmend als Kerntechnologie hinter Embodied AI. Gleichzeitig bleibt die starke Abhängigkeit von umfangreichen menschlichen Demonstrationsdaten eine große Herausforderung, sowohl hinsichtlich der Datenerfassung als auch der Trainingskosten.
Die π0-Linie von Physical Intelligence
Einer der Namen, der in der VLA-Szene in letzter Zeit viel Aufmerksamkeit erregt hat, ist π0 (Pi-Null) von Physical Intelligence, einem Startup, das über 100 Millionen US-Dollar an Kapital eingesammelt hat. 400 Millionen US-Dollar. Es wurde als universelle Roboterstrategie angekündigt, die die großflächige Datenerfassung mehrerer Roboter für verschiedene Aufgaben mit einer neuen Netzwerkarchitektur kombiniert. Diese ist in der Lage, ein breites Aufgabenspektrum zu bewältigen – vom Wäschefalten über das Abräumen eines Tisches bis hin zum Abfüllen von Kaffeebohnen. Physical Intelligence hat den Code und die Gewichte von π0 als Open-Source-Repository (openpi) veröffentlicht und seitdem kontinuierlich verbesserte Versionen herausgegeben – π0.5, π0.6 und π0.7. π0 Base wurde mit den sieben eigenen Roboterplattformen des Unternehmens auf dem Open X-Embodiment (OXE)-Datensatz vortrainiert und ist als universelles Modell für die Feinabstimmung konzipiert: Es ist sofort einsatzbereit für Aufgaben, die bereits durch die Vortrainingsdaten abgedeckt sind, wurde aber so entwickelt, dass die Feinabstimmung der erwartete Weg zu einem spezifischen Anwendungsfall ist.
Aktuelles von Physical Intelligence: π0.7 und darüber hinaus
Laut dem offiziellen Blog von Physical Intelligence wurde die π0-Produktreihe bis 2026 kontinuierlich um neue Funktionen erweitert. März 2026 brachte zwei aufeinanderfolgende Veröffentlichungen: eine Methode, die ein aus dem VLA-Modell extrahiertes „RL-Token“ nutzt, um Manipulationsaufgaben realer Roboter mittels Online-Reinforcement-Learning schnell zu verfeinern, und „Multi-Scale Embodied Memory“, das Langzeit- und Kurzzeitgedächtnis integriert, um Aufgaben mit einer Laufzeit von über zehn Minuten zu bewältigen. π0.7, angekündigt im April, positioniert sich als steuerbares Modell – eines, das extern gesteuert werden kann – und weist neuartige Fähigkeiten auf, die einen Quantensprung in der Generalisierungsleistung bedeuten. Der Schwerpunkt der Entwicklung scheint sich von der Imitation von Einzeltests hin zu Fähigkeiten zu verlagern, die einem wirklich autonomen Roboterbetrieb deutlich näherkommen: Gedächtnis, Online-Lernen, Steuerbarkeit.
LIBERO erreicht Sättigung und das Rennen um die Geschwindigkeit
LIBERO, der Simulations-Benchmark, der sich in der VLA-Forschung als Standard etabliert hat, verzeichnete in der zweiten Jahreshälfte 2026 mehrere Methoden mit Erfolgsquoten von über 90 % – die Genauigkeit nähert sich effektiv der Sättigung. Temporal Forcing (August) DriftingVLA (August 2026), das das Verständnis von zeitlichem Kontext durch die Ausrichtung an einer 4D-Szenendarstellung verbessert, erzielt 98,8 % auf LIBERO und steigert die Erfolgsquote bei einer anspruchsvolleren Aufgabe zur „versteckten Platzierung“ von 20,0 % auf 43,3 %. Dies deutet darauf hin, dass sich der Fokus der Evaluierung im Feld mit zunehmender Sättigung des Standard-Benchmarks auf schwierigere Generalisierungsaufgaben verlagert.
Da die Genauigkeit der verschiedenen Methoden konvergiert, konzentriert sich die Forschung nun auch auf die Optimierung der Inferenzgeschwindigkeit. DriftingVLA (August 2026), das den herkömmlichen mehrstufigen Diffusionsprozess durch einen einzigen Vorwärtsdurchlauf ersetzt, erzielt weiterhin 98,32 % Erfolg auf LIBERO und verzeichnet eine 3,36-fache Beschleunigung bei der Generierung von Aktions-Chunks im Vergleich zu iterativen Methoden. AdaVLA (August 2026, IROS 2026), das bereits trainierte Modelle ohne erneutes Training beschleunigt, führt eine Metrik ein, die die Generierungssicherheit anhand der Krümmung des Flussabgleichs schätzt. Trajektorie, die 1,87-fache bzw. 2,24-fache Beschleunigungen auf π0.5 bzw. X-VLA ohne zusätzliches Training erzielt. SMILE (August 2026), das auf die Generierung flüssiger Bewegungen bei Aufgaben mit langem Zeithorizont abzielt, erreicht ebenfalls eine Erfolgsquote von 98,0 % auf LIBERO und erzielt gleichzeitig eine 1,1-fache Beschleunigung durch ein Design, das B-Spline-Koeffizienten vorhersagt – „schneller ohne Genauigkeitsverlust“ hat sich in der zweiten Jahreshälfte 2026 zu einem der Hauptthemen der VLA-Forschung entwickelt.
Die Entwicklung im Jahr 2026
Die Forschung im Bereich VLA hat sich bis weit in das Jahr 2026 hinein rasant weiterentwickelt. ABot-M0, das Aktions-Manifold-Lernen integriert; ACE-Brain-0.5, ein einheitliches Basismodell für verkörperte agentenbasierte KI; Kairos, das ein Weltmodell mit Aktionen integriert – die Forschung geht über einfaches „Sehen und Bewegen“ hinaus und umfasst Modellierung, Erinnerung und Handeln. Die physische Welt wird integriert. VLA als Konzept wird neu positioniert – von einer roboterspezifischen Technologie hin zu einem Kernelement des umfassenderen Frameworks der „Physischen KI“.
Wo die Evaluierung endet und der reale Roboterbetrieb beginnt
VLA-Benchmark-Ergebnisse sind Vergleichsmessungen unter kontrollierten Bedingungen: Trainingsroboter, Kamerapositionierung, Befehlsformulierung, Erfolgskriterium und Reset-Prozedur sind in der Benchmark-Definition festgelegt. Eine Benchmark-Erfolgsrate kann nicht direkt als Sicherheitsaussage für einen anderen Roboter oder eine andere Arbeitsumgebung interpretiert werden. Vor dem Einsatz benötigt die Aktionsausgabe eine separate Überwachungsebene, die Geschwindigkeits-, Beschleunigungs- und Gelenkgrenzen durchsetzt und den Roboter bei Kommunikationsverlust, Inferenz-Timeout oder Sensorausfall stoppt.
Ein von einem VLA generierter Aktionsblock ist eine Vorhersage basierend auf den zum Inferenzzeitpunkt verfügbaren Beobachtungen. Bewegt sich eine Person oder ein Objekt während des Blocks, führt die Ausführung des gesamten Blocks ohne weitere Beobachtung dazu, dass Befehle auf veralteter Wahrnehmung im System basieren. Kürzere Blöcke mit häufigerer Neuplanung verbessern die Reaktionsfähigkeit, aber Die Inferenz- und Kommunikationslast erhöht sich. Längere Datenblöcke können effizienter sein, reagieren aber langsamer auf Verdeckung oder Kontaktänderungen. Der praktische Übergang von der Forschung zum Betrieb besteht darin, neben dem Erfolg der Aufgabe auch den Anhalteweg, die Umplanungszeit und die Wiederherstellungsrate zu messen.
Die Verteilung der Trainingsdaten ist ebenfalls wichtig. Beleuchtung, Material, Gelenkreibung und Kameralatenz, die von den Trainingsbedingungen abweichen, können beim realen Roboter zu Aktionsfehlern führen. Die Evaluierung sollte daher wiederholte bekannte Aufgaben von Tests mit bewegten Objekten, paraphrasierten Anweisungen, Wiederherstellung nach Verdeckung und absichtlich verzögerter Kommunikation trennen. Ein Modell nach einem Fehler einfach erneut versuchen zu lassen, identifiziert die Ursache nicht. Speichern Sie das Eingabebild, die Anweisung, die generierte Aktion, die Überwachungsgrenzen und den Stoppgrund in einer gemeinsamen Zeitbasis. Dies erleichtert es, einen Wahrnehmungsfehler von einem mechanischen oder Kommunikationsfehler zu unterscheiden und die gleiche Evaluierung nach einem Modellupdate zu wiederholen.
Einsatzentscheidungen sollten ebenfalls schrittweise getroffen werden. Erfolg in der Simulation, eine im Labor funktionierende Stoppbedingung und die Aufgabenerfüllung in einer begrenzten Umgebung sind unterschiedliche Nachweise. Bevor der Roboter im Freien oder in von Menschen genutzten Bereichen eingesetzt wird, testen Sie unbekannte Objekte und Beleuchtungsänderungen. Bei niedrigem Batteriestand und Netzwerkausfall dokumentieren Sie die Bedingungen für die Vertrauenswürdigkeit des Modells und die Bedingungen für die Rückgabe der Steuerung an einen konventionellen Regler. Die explizite Festlegung dieser Grenze erhält die Flexibilität eines VLA, ohne die für ein Regelsystem erforderliche Überprüfbarkeit zu beeinträchtigen.
Das Versuchsprotokoll sollte die Modell- und Gewichtungsversion, die Eingangsauflösung, die Inferenzzeit, die Regelperiode und die Dauer der Aktionshaltung enthalten. Ohne diese Angaben liefert die erneute Ausführung desselben Modells kein vergleichbares Ergebnis. Selbst „Erfolg“ kann Verschiedenes bedeuten: das Platzieren eines Objekts am Ziel, das Vermeiden einer Berührung oder das Abschließen einer Aufgabe nach dem Eingreifen eines Begrenzers. Definieren Sie Erfolgs- und Abbruchkriterien im Voraus und dokumentieren Sie separat die Ergebnisse des Modells und die der Überwachungsebene. Um Forschungsergebnisse in operative Entscheidungen einzubeziehen, müssen die Messbedingungen und der nicht gemessene Bereich in derselben Tabelle aufgeführt werden.
Im Routinebetrieb kann sich das Verhalten nach einem Kamerawechsel oder einer Änderung der Beleuchtung ändern, selbst wenn das Modell selbst unverändert bleibt. Um Verteilungsverschiebungen zu erkennen, protokollieren Sie kontinuierlich Konfidenzindikatoren, Aktionsstärken und die Anzahl der Eingriffe der Überwachungsebene. Bei anhaltenden Anomalien schalten Sie in den Langsambetrieb oder in den manuellen Betrieb um. Eine Diagnose ist einfacher als wiederholte automatische Wiederholungsversuche. Die Betrachtung eines VLA als eine Komponente in einem System, das Beobachtung, Schlussfolgerung, Begrenzung und Stopp trennt, fördert sowohl Reproduzierbarkeit als auch Sicherheit.
Führt das erkennbare Verständnis von Anweisungen zu sicheren Roboteraktionen?
Aktionsbegrenzungen, Ausführungsbedingungen, Fehlererkennung und Stoppmechanismen bleiben notwendig. Flüssige Sprachkenntnisse sind kein Beweis für physischen Erfolg.
Referenzen
- Vision Language Action Models in Robotic Manipulation: A Systematic Review (arXiv)
- π0: Physical Intelligence Official Blog
- Präzise Manipulation mit effizientem Online-RL (Physical Intelligence)
- VLAs mit Langzeit- und Kurzzeitgedächtnis (Physical Intelligence)
- OpenPi-GitHub-Repository-Abdeckung für Physical Intelligence (The Robot Report)
- Vision-Language-Action (VLA)-Modelle für die Robotik (Roboflow Blog)
- Eine Übersicht über Vision-Language-Action-Modelle: Eine Perspektive der Aktionstokenisierung (arXiv)
- Offizieller Blog von Physical Intelligence
- Paper zu temporaler Forcing (arXiv)
- DriftingVLA-Paper (arXiv)
- AdaVLA-Paper (IROS 2026, arXiv)
- SMILE-Paper (arXiv)
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.