Contents — find the section you need
视觉-语言-动作 (VLA) 模型是一种架构,它将摄像头拍摄的画面和自然语言指令整合到一个单一的系统中,直接输出机器人的动作(运动指令)。与机器人领域将感知(识别)和控制(规划和执行)设计为独立流程的传统做法不同,VLA 的核心思想在于思维方式的转变:将两者集成到一个单一的 Transformer 模型中。
 视觉 + 语言 → 动作
由于找不到主要 VLA 公司(例如 Physical Intelligence 等)的免版权费官方标志,因此我们创建了一个简单的图标来代表视觉、语言和动作的整合。
VLA 概览
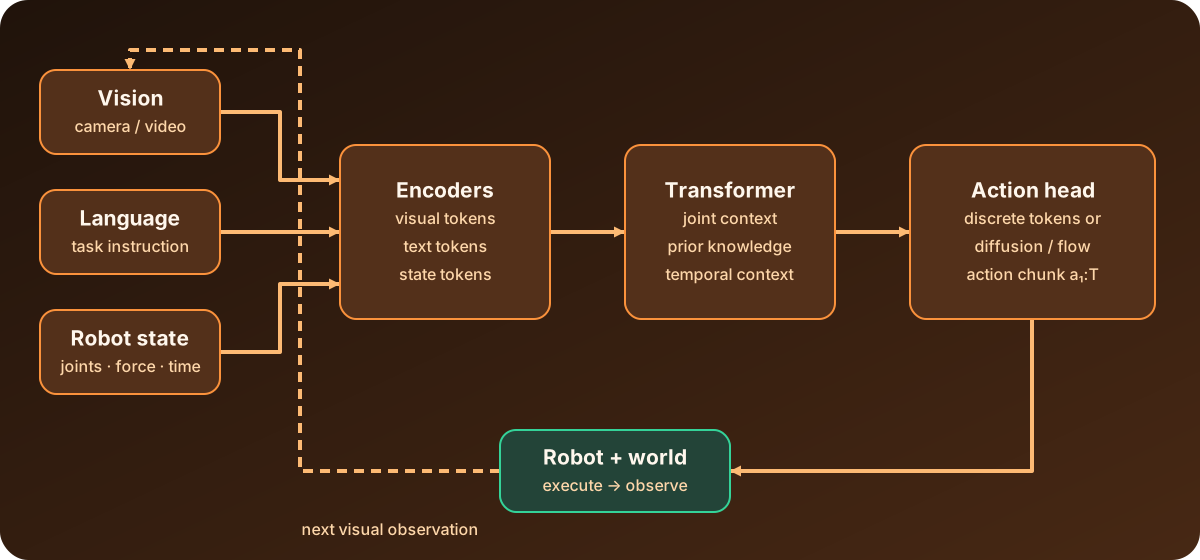
图示:Duskcoil。它简化了 VLA 推理和物理世界反馈之间的代表性关系。
VLA 不仅仅是一个可以读取图像和语言的模型;它是……的一部分这是一个闭环模型,其输出与物理动作相连。图像、指令和关节状态被映射到一个共享的表示中,Transformer 组件整合上下文信息,动作头将其转换为动作块。由于执行后的观察结果会成为下一个输入,因此实际评估不仅要包括模型准确率,还要包括推理延迟、动作流畅度以及在行为异常时安全停止的机制。
演化历程:从 RT-1 到 RT-2 再到 OpenVLA
谷歌的 RT-1 是早期旗舰模型,其后续的 RT-2 进一步发展了这一理念,将基于网络规模视觉和语言数据预训练的大型模型的知识用于生成机器人动作。在开源方面,Open-VLA、Octo 和 CLIP-RT 等模型也采用了基于 Transformer 的架构,并围绕跨模态注意力机制(一种跨越视觉和语言的相互注意力机制)构建。所有这些模型的共同之处在于,“观看”、“理解”和“执行”并没有被拆分成独立的模块——而是使用单个网络进行端到端的训练,从输入(视频素材加上……)开始。从指令(输入)到输出(动作)。
内部结构:三个子系统
VLA 模型的计算架构大致可以理解为三个子系统。首先,视觉编码器将来自摄像头的原始像素数据转换为结构化的特征表示——通常是预训练图像编码器(例如 SigLIP 或 DINOv2)的组合。接下来是投影模块(通常是多层感知器),它将提取的视觉特征映射到语言模型工作的嵌入空间。最后,仅解码器 Transformer 处理连接后的视觉和语言(指令)标记序列,并生成最终动作。
生成动作:两种设计方法
视觉和语言集成后,生成实际运动指令(动作)的设计方法大致有两种。
一种方法是使用离散动作标记:将连续的动作值(关节角度、速度等)离散化为固定数量的区间。 (例如 256 个),语言模型词汇表中很少用于其他用途的标记 ID 会被重新用于表示动作。其优势在于,视觉、语言和动作都可以统一地作为同一种“标记序列”进行处理,从而以自回归的方式生成动作序列 a_{1:T}——以观察结果 o 为条件,并基于之前生成的标记生成每个后续标记。
这种形式与自然语言生成中的下一个词预测完全相同,并且它抓住了 VLA 的核心思想——在同一个概率模型中处理视觉、语言和动作。
另一种方法使用基于扩散的动作头:Transformer 的任务简化为生成一个概括视觉和语言信息的“读取标记”,而生成实际的连续动作值则交给扩散模型。由于离散的动作标记是分阶段生成的,因此有时可能无法满足实时性要求。响应速度和流畅性是传统方法的优势,而基于扩散的动作头则倾向于产生更平滑、连续的动作输出。两者的结合也越来越常见——例如,Octo 将图像和语言标记作为单个序列输入到 Transformer 中,然后将其输出(读取标记)作为条件传递给基于扩散的动作头。
这种设计在实践中的意义
传统的控制系统只能通过遵循其脚本来处理其设计之外的情况,除此之外别无他法。VLA 模型的优势在于能够泛化到从未明确训练过的情况。其应用范围正在迅速扩展,从仓库自动化到手术辅助机器人,并且它正日益成为具身人工智能的核心技术。与此同时,对大规模人类演示数据的严重依赖仍然是一个主要挑战,无论是在数据收集方面还是在训练成本方面。
Physical Intelligence 的 π0 传承
最近在 VLA 领域最受关注的名字之一是 π0(pi-zero),它来自 Physical Intelligence,一家已融资超过4亿美元。该项目被宣布为一项通用机器人战略,它将大规模多任务、多机器人数据采集与一种全新的网络架构相结合,能够处理各种各样的任务——从折叠衣物、清理餐桌到舀咖啡豆。Physical Intelligence 将 π0 的代码和权重开源为 openpi 代码库,并持续发布改进版本——π0.5、π0.6 和 π0.7。π0 基础模型基于 Open X-Embodiment (OXE) 数据集以及该公司自有的七个机器人平台进行预训练,被设计为一个通用模型,便于微调:对于预训练数据已涵盖的任务,该模型可直接使用,无需额外训练;但其设计初衷是为特定用例的微调提供路径。
Physical Intelligence 最新动态:π0.7 及后续版本
根据 Physical Intelligence 的官方博客,π0 系列在 2026 年之前持续稳步提升功能。2026 年 3 月,该系列发布了两个新版本。接连发布的两项技术:一种利用从 VLA 模型中提取的“RL Token”通过在线强化学习快速改进真实机器人操作任务的方法,以及“多尺度具身记忆”,它整合了长短期记忆,以处理运行时间超过十分钟的任务。四月份发布的 π0.7 被定位为可控模型——即可以外部引导的模型——展现出涌现能力,实现了泛化性能的“飞跃”。研发的重心似乎正在从单次演示模仿转向更接近真正自主机器人操作的能力:记忆、在线学习和可控性。
LIBERO 饱和与速度竞赛
LIBERO 是 VLA 研究的标准仿真基准测试,到 2026 年下半年,多种方法的任务成功率已达到 90% 以上——准确率实际上已接近饱和。时间强制(2026 年 8 月)通过与 4D 场景表示对齐,增强了对时间上下文的理解,在 LIBERO 测试中取得了 98.8% 的准确率,同时在难度更高的“隐藏位置”任务中,成功率从 20.0% 提升至 43.3%——这表明,随着标准基准测试的饱和,该领域的评估重点正转向更具挑战性的泛化任务。
随着各种方法的准确率趋于一致,研究重点也转向了优化推理速度。DriftingVLA(2026 年 8 月)用单次前向传播取代了传统的多步扩散过程,在 LIBERO 测试中保持了 98.32% 的成功率,同时与迭代方法相比,动作块生成速度提高了 3.36 倍。AdaVLA(2026 年 8 月,IROS 2026)无需重新训练即可加速已训练的模型,引入了一种根据流匹配轨迹的曲率估计生成置信度的指标,并取得了显著成果。在 π0.5 和 X-VLA 上分别实现了 1.87 倍和 2.24 倍的加速,且无需额外训练。SMILE(2026 年 8 月)旨在生成长时域任务中的平滑运动,同样在 LIBERO 上保持了 98.0% 的成功率,并通过预测 B 样条系数的设计实现了 1.1 倍的加速——“在不牺牲精度的前提下提高速度”已成为 2026 年下半年 VLA 研究的主要方向之一。
2026 年的发展
VLA 领域的研究在 2026 年继续快速发展。ABot-M0 融合了动作流形学习;ACE-Brain-0.5 是具身智能体的统一基础模型;Kairos 将世界模型与动作相结合——研究正从简单的“观察和移动”扩展到以集成的方式在物理世界中建模、记忆和行动。VLA 作为一种该概念本身正在被重新定位——从一项机器人专用技术转变为更广泛的“物理人工智能”框架的核心要素。
评估结束,真实机器人操作开始
VLA 基准测试结果是在受控条件下进行的对比测量:训练机器人、摄像头位置、指令措辞、成功标准和重置程序均在基准测试定义范围内。基准测试的成功率不能直接解读为对其他机器人或工作环境的安全声明。在部署之前,动作输出需要一个单独的监控层来强制执行速度、加速度和关节限制,并在通信丢失、推理超时或传感器故障时停止机器人。
VLA 生成的动作块是基于推理时可用观测结果的预测。如果在动作块执行期间有人或物体移动,在没有其他观测结果的情况下执行整个动作块会导致系统中存在基于过时感知的指令。更短的动作块和更频繁的重新规划可以提高响应速度,但会增加推理和通信负载。更长的动作块分块处理效率更高,但对遮挡或接触变化的反应速度较慢。从研究到实际应用的关键在于,除了任务成功率之外,还要测量停止距离、重新规划周期和恢复率。
训练数据的分布也至关重要。与训练条件不同的光照、材质、关节摩擦和摄像头延迟都可能导致真实机器人出现动作错误。因此,评估应将重复的已知任务与移动物体、指令修改、遮挡后恢复以及故意延迟通信的测试区分开来。仅仅要求模型在失败后重试并不能确定失败原因。应将输入图像、指令、生成的动作、监督限制和停止原因存储在同一个时间基准下。这样更容易区分感知错误与机械或通信故障,并在模型更新后重复相同的评估。
部署决策也应分阶段进行。仿真中的成功、实验室中有效的停止条件以及在有限环境中完成任务是不同的证据。在进入室外或人流密集空间之前,应测试未知物体、光照变化、低电量和网络中断等情况,并记录测试结果。模型信任条件和将控制权交还给传统控制器的条件。明确这一边界既能保持 VLA 的灵活性,又不会放弃控制系统所需的验证性。
实验记录应包含模型和权重版本、输入分辨率、推理时间、控制周期和动作保持持续时间。缺少这些字段,重新运行同一模型将无法产生可比的结果。即使是“成功”也可能意味着不同的事情:例如将物体放置在目标位置、避免接触或在限位器介入后完成任务。预先定义成功和中断标准,并分别报告模型的输出结果和监控层允许的结果。要在操作决策中使用研究数据,必须将测量条件和未测量范围记录在同一表格中。
在日常操作中,即使模型本身未做任何改动,更换摄像头或改变光照条件后,行为也可能发生改变。为了检测分布变化,应持续记录置信度指标、动作幅度以及监控层的干预次数。当异常值持续存在时,切换到慢速模式或手动操作更容易进行诊断。比反复自动重试更有效。将视觉语言动作模型 (VLA) 视为一个系统中的一个组件,该系统将观察、推理、限制和停止等步骤分离,从而支持可重复性和安全性。
表面上的指令理解是否能确保机器人安全操作?
动作限制、执行条件、故障检测和停止机制仍然必不可少。流畅的语言表达并不代表物理操作成功。
评论
请先登录。
暂无数据。