Contents — find the section you need
I modelli Vision-Language-Action (VLA) sono un'architettura che integra le riprese video e le istruzioni in linguaggio naturale in un unico sistema, generando direttamente le azioni del robot (comandi motori). Contrariamente alla tradizione robotica che considerava la percezione (riconoscimento) e il controllo (pianificazione ed esecuzione) come processi separati, l'idea centrale è un cambio di mentalità: integrare entrambi in un unico modello Transformer.
 Visione + Linguaggio → Azione
Non è stato possibile trovare un logo ufficiale libero da diritti d'autore per le principali aziende di VLA (Physical Intelligence, ecc.), quindi è stata creata una semplice icona che rappresenta l'integrazione di visione, linguaggio e azione.
VLA in sintesi
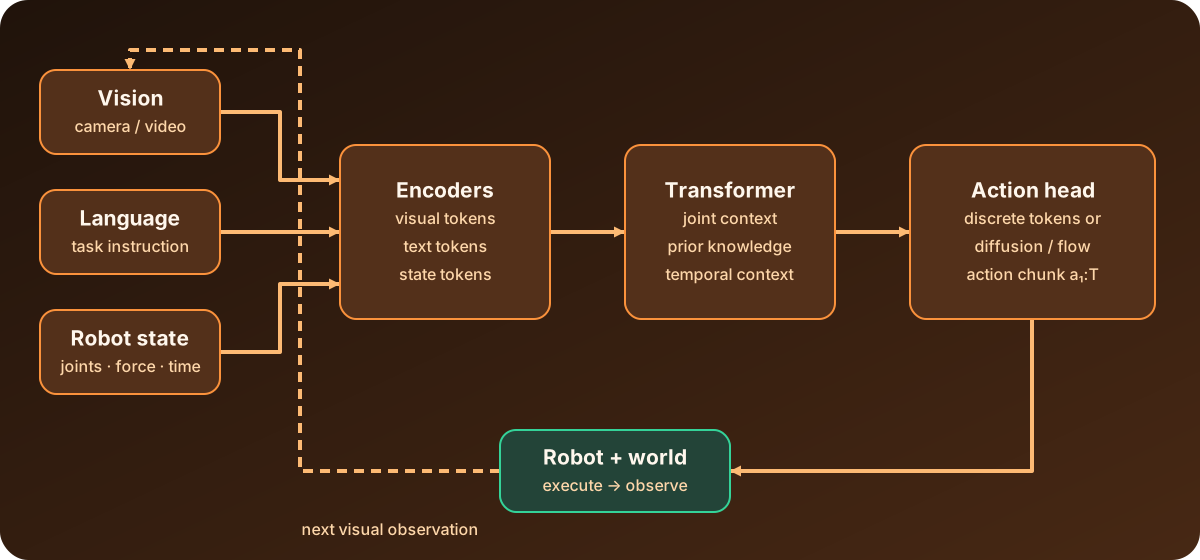
Diagramma: Duskcoil. Semplifica una relazione rappresentativa tra l'inferenza VLA e il feedback del mondo fisico.
Un VLA non è semplicemente un modello che può Legge immagini e linguaggio; fa parte di un ciclo chiuso il cui output è connesso all'azione fisica. Immagini, istruzioni e stato delle articolazioni vengono mappati in una rappresentazione condivisa, un trasformatore integra il contesto e un'unità di controllo lo converte in un blocco di azione. Poiché l'osservazione successiva all'esecuzione diventa l'input successivo, la valutazione pratica deve includere non solo l'accuratezza del modello, ma anche la latenza di inferenza, la fluidità dell'azione e un meccanismo che si arresti in modo sicuro quando il comportamento diventa anomalo.
Evoluzione: da RT-1 a RT-2 a OpenVLA
RT-1 di Google è stato un primo esempio di punta, e il suo successore RT-2 ha ulteriormente sviluppato l'idea, reindirizzando la conoscenza da un modello di grandi dimensioni pre-addestrato su dati di visione e linguaggio su scala web verso la generazione di azioni robotiche. Sul fronte open source, modelli come Open-VLA, Octo e CLIP-RT hanno seguito con architetture basate su trasformatori costruite attorno all'attenzione cross-modale (un meccanismo di attenzione reciproca che abbraccia visione e linguaggio). Ciò che tutti questi modelli hanno in comune è che "vedere", "comprendere" e "agire" non sono suddivisi in moduli separati. Una singola rete neurale viene addestrata end-to-end, dall'input (filmato più istruzioni) fino all'output (azione).
Struttura interna: tre sottosistemi
L'architettura computazionale di un modello VLA può essere suddivisa approssimativamente in tre sottosistemi. Innanzitutto, un encoder visivo converte i dati grezzi dei pixel provenienti dalla telecamera in una rappresentazione strutturata delle caratteristiche, spesso una combinazione di encoder di immagini pre-addestrati come SigLIP o DINOv2. Successivamente, un modulo di proiezione (di solito un percettrone multistrato) mappa le caratteristiche visive estratte nello spazio di embedding in cui opera il modello linguistico. Infine, un trasformatore solo decoder elabora la sequenza concatenata di token visivi e linguistici (istruzioni) e genera l'azione finale.
Generazione dell'azione: due approcci di progettazione
Una volta integrati visione e linguaggio, esistono sostanzialmente due approcci di progettazione per la generazione del comando motorio (l'azione).
Uno utilizza token di azione discreti: i valori di azione continui (angoli articolari, velocità e simili) vengono discretizzati. in un numero fisso di contenitori (ad esempio 256), e gli ID dei token del vocabolario del modello linguistico, che hanno scarso altro utilizzo, vengono riutilizzati per rappresentare le azioni. Il vantaggio è che visione, linguaggio e azione possono essere gestiti uniformemente come lo stesso tipo di "sequenza di token", generando la sequenza di azioni a_{1:T} in modo autoregressivo, condizionato dall'osservazione o, generando ogni token successivo in base a quelli generati in precedenza.
Questa formulazione ha esattamente la stessa struttura della predizione della parola successiva nella generazione del linguaggio naturale e cattura l'idea centrale di VLA: gestire visione, linguaggio e azione all'interno dello stesso modello probabilistico.
L'altro approccio utilizza una testa d'azione basata sulla diffusione: il compito del trasformatore è ridotto a produrre un "token di lettura" che riassume le informazioni visive e linguistiche, mentre la generazione dei valori di azione continui effettivi viene affidata a un modello di diffusione. Discreto I token di azione, essendo generati in fasi, a volte possono risultare carenti in termini di reattività e fluidità in tempo reale, mentre un'unità di controllo basata sulla diffusione tende a produrre un output di azione più fluido e continuo. Anche le combinazioni dei due approcci sono sempre più comuni: Octo, ad esempio, alimenta un trasformatore con token di immagine e di linguaggio come un'unica sequenza, quindi passa il suo output (il token di lettura) come condizione a un'unità di controllo basata sulla diffusione.
Cosa significa questo design nella pratica
Un sistema di controllo classico può gestire una situazione per la quale non è stato progettato solo seguendo il suo script e nient'altro. Il vantaggio di un modello VLA è la possibilità di generalizzare a condizioni per le quali non è mai stato esplicitamente addestrato. Il suo campo di applicazione si sta espandendo rapidamente, dall'automazione dei magazzini ai robot di assistenza chirurgica, e si sta affermando sempre più come la tecnologia di base dell'IA incarnata. Allo stesso tempo, la forte dipendenza da dati dimostrativi umani su larga scala rimane una sfida importante, sia in termini di raccolta dati che di costi di addestramento.
La discendenza π0 dell'Intelligenza Fisica
Uno dei nomi che ha attirato maggiormente l'attenzione nel campo del VLA di recente è π0 (pi-zero), di Physical Intelligence, una startup che ha raccolto oltre 400 milioni di dollari. È stata annunciata come una policy robotica generica, che combina la raccolta di dati multi-task e multi-robot su larga scala con una nuova architettura di rete, in grado di gestire una vasta gamma di attività: piegare il bucato, sparecchiare un tavolo, raccogliere chicchi di caffè. Physical Intelligence ha reso open source il codice e i pesi di π0 nel repository openpi e da allora ha continuato a rilasciare versioni migliorate: π0.5, π0.6, π0.7. La base di π0 è stata pre-addestrata sul dataset Open X-Embodiment (OXE) insieme alle sette piattaforme robotiche dell'azienda ed è progettata come un modello generico pensato per il fine-tuning: utilizzabile come zero-shot per le attività già coperte dai dati di pre-addestramento, ma costruito con il fine-tuning come percorso previsto per un caso d'uso specifico.
Ultime novità di Physical Intelligence: π0.7 e oltre
Seguendo il blog ufficiale di Physical Intelligence, La linea π0 ha continuato ad aggiungere funzionalità in modo costante fino al 2026. A marzo 2026 sono state rilasciate due versioni consecutive: un metodo che utilizza un "RL Token" estratto dal modello VLA per perfezionare rapidamente le attività di manipolazione di robot reali tramite apprendimento per rinforzo online, e "Multi-Scale Embodied Memory", che integra la memoria a lungo e a breve termine per gestire attività che durano più di dieci minuti. π0.7, annunciato ad aprile, si posiziona come un modello controllabile, ovvero guidabile esternamente, che mostra capacità emergenti che rappresentano un "cambiamento radicale" nelle prestazioni di generalizzazione. Il centro di gravità dello sviluppo sembra spostarsi dall'imitazione di dimostrazioni a colpo singolo verso capacità molto più vicine al funzionamento di robot realmente autonomi: memoria, apprendimento online, controllabilità.
Saturazione di LIBERO e la corsa alla velocità
LIBERO, il benchmark di simulazione diventato standard nella ricerca VLA, ha visto diversi metodi raggiungere tassi di successo delle attività superiori al 90% entro la seconda metà del 2026. L'accuratezza si sta effettivamente avvicinando alla saturazione. Temporal Forcing (agosto 2026), che rafforza la comprensione del contesto temporale allineandosi a una rappresentazione della scena 4D, ottiene il 98,8% su LIBERO, aumentando al contempo il successo in un compito più difficile di "posizionamento nascosto" dal 20,0% al 43,3%: un segno che, con la saturazione del benchmark standard, l'attenzione della valutazione del settore si sta spostando verso compiti di generalizzazione più complessi.
Con la convergenza dell'accuratezza tra i metodi, anche l'attenzione della ricerca si è spostata verso l'ottimizzazione della velocità di inferenza. DriftingVLA (agosto 2026), che sostituisce il tradizionale processo di diffusione a più fasi con un singolo passaggio in avanti, mantiene il 98,32% di successo su LIBERO, riportando un'accelerazione di 3,36 volte nella generazione di blocchi di azioni rispetto ai metodi iterativi. AdaVLA (agosto 2026, IROS 2026), che accelera i modelli già addestrati senza riaddestrarli, introduce una metrica che stima la confidenza di generazione dalla curvatura della traiettoria di corrispondenza del flusso, ottenendo accelerazioni di 1,87x e 2,24x rispettivamente su π0.5 e X-VLA senza addestramento aggiuntivo. SMILE (agosto 2026), mirato alla generazione di movimento fluido su compiti a lungo orizzonte, mantiene allo stesso modo il 98,0% di successo su LIBERO, riportando un'accelerazione di 1,1x attraverso un design che predice i coefficienti B-spline: "più veloce senza sacrificare la precisione" è diventato uno degli assi principali della ricerca VLA nella seconda metà del 2026.
La diffusione del 2026
La ricerca nel campo VLA ha continuato ad apparire a ritmo sostenuto anche nel 2026. ABot-M0, che incorpora l'apprendimento della varietà di azioni; ACE-Brain-0.5, un modello di base unificato per l'IA agentica incarnata; Kairos, che integra un modello del mondo con l'azione: la ricerca si sta espandendo oltre Un semplice approccio "vedi e muoviti" verso la modellazione, la memorizzazione e l'azione nel mondo fisico in modo integrato. Il concetto stesso di VLA (Virtual Logical Automation, apprendimento basato sulla realtà virtuale) si sta riposizionando, passando da tecnologia specifica per la robotica a elemento centrale del più ampio quadro dell'"IA fisica".
Dove finisce la valutazione e inizia il funzionamento del robot reale
I risultati dei benchmark VLA sono misurazioni comparative in condizioni controllate: il robot di addestramento, il posizionamento della telecamera, la formulazione delle istruzioni, il criterio di successo e la procedura di ripristino sono inclusi nella definizione del benchmark. Un tasso di successo del benchmark non può essere interpretato direttamente come una garanzia di sicurezza per un altro robot o ambiente di lavoro. Prima dell'implementazione, l'output dell'azione necessita di un livello di supervisione separato che imponga limiti di velocità, accelerazione e articolazione e arresti il robot in caso di perdita di comunicazione, timeout di inferenza o guasto del sensore.
Un blocco di azione generato da un VLA è una previsione basata sull'osservazione disponibile al momento dell'inferenza. Se una persona o un oggetto si muove durante il blocco, l'esecuzione dell'intero blocco senza un'ulteriore osservazione non è possibile. I comandi basati su percezioni obsolete rimangono nel sistema. Intervalli più brevi con ripianificazione più frequente migliorano la reattività, ma aumentano il carico di inferenza e comunicazione. Intervalli più lunghi possono essere più efficienti, pur reagendo più lentamente a occlusioni o cambiamenti di contatto. Il ponte pratico tra la ricerca e l'operatività consiste nel misurare la distanza di arresto, il periodo di ripianificazione e la velocità di recupero, oltre al successo del compito.
Anche la distribuzione dei dati di addestramento è importante. Illuminazione, materiale, attrito delle articolazioni e latenza della telecamera, che differiscono dalle condizioni di addestramento, possono apparire come errori di azione sul robot reale. La valutazione dovrebbe quindi separare i compiti noti ripetuti dai test con oggetti in movimento, istruzioni parafrasate, recupero dopo un'occlusione e comunicazione deliberatamente ritardata. Chiedere semplicemente a un modello di riprovare dopo un errore non ne identifica la causa. Memorizzare l'immagine di input, l'istruzione, l'azione generata, i limiti di supervisione e il motivo dell'arresto rispetto a una base temporale condivisa. Ciò semplifica la distinzione tra un errore di percezione e un guasto meccanico o di comunicazione e consente di ripetere la stessa valutazione dopo un aggiornamento del modello.
Anche le decisioni di implementazione dovrebbero essere graduali. Successo in simulazione, una condizione di arresto funzionante in laboratorio e Il completamento di un'attività in un ambiente limitato rappresenta una prova diversa. Prima di passare a spazi esterni o condivisi con altre persone, testare oggetti sconosciuti, variazioni di illuminazione, batteria scarica e perdita di rete, quindi documentare le condizioni per fidarsi del modello e le condizioni per restituire il controllo a un controller convenzionale. Rendere esplicito questo confine preserva la flessibilità di un VLA senza rinunciare alla verificabilità richiesta da un sistema di controllo.
La registrazione dell'esperimento dovrebbe includere la versione del modello e dei pesi, la risoluzione di input, il tempo di inferenza, il periodo di controllo e la durata del mantenimento dell'azione. Senza questi campi, rieseguire lo stesso modello non produce un risultato comparabile. Anche il "successo" può significare cose diverse: posizionare un oggetto sul bersaglio, evitare il contatto o completare un'attività dopo l'intervento di un limitatore. Definire in anticipo i criteri di successo e di interruzione e riportare separatamente ciò che il modello ha prodotto e ciò che il livello di supervisione ha consentito. Per utilizzare i dati di ricerca in una decisione operativa, le condizioni di misurazione e l'intervallo non misurato devono essere riportati nella stessa tabella.
Nel funzionamento di routine, il comportamento può cambiare dopo la sostituzione di una telecamera o una variazione di illuminazione anche se il modello stesso rimane invariato. Per rilevare gli spostamenti di distribuzione, tenere Registrazione degli indicatori di affidabilità, dell'entità delle azioni e del numero di interventi da parte del livello di supervisione. Quando i valori anomali persistono, il passaggio a una modalità lenta o al funzionamento manuale è più facile da diagnosticare rispetto al tentativo automatico ripetuto. Trattare un VLA come un componente di un sistema che separa osservazione, inferenza, limitazione e arresto favorisce sia la riproducibilità che la sicurezza.
La comprensione apparente delle istruzioni garantisce un'azione robotica sicura?
I limiti di azione, le condizioni di esecuzione, il rilevamento dei guasti e i meccanismi di arresto rimangono necessari. La fluidità del linguaggio non è prova di successo fisico.
Riferimenti
- Vision Language Action Models in Robotic Manipulation: A Systematic Review (arXiv)
- π0: Physical Intelligence Official Blog
- [π0.7 Annuncio ufficiale
- Articolo π0.7 (Intelligenza fisica)
- Manipolazione precisa con apprendimento per rinforzo online efficiente (Intelligenza fisica)
- Modelli VLA con memoria a lungo e breve termine (Intelligenza fisica)
- Copertura del repository GitHub OpenPI sull'Intelligenza fisica (The Robot Report)
- Modelli Visione-Linguaggio-Azione (VLA) per la robotica (Blog di Roboflow)
- Una panoramica sui modelli Visione-Linguaggio-Azione: una prospettiva di tokenizzazione delle azioni (arXiv)
- Blog ufficiale sull'Intelligenza Fisica
- Articolo sulla Forzatura Temporale (arXiv)
- Articolo su DriftingVLA (arXiv)
- Articolo su AdaVLA (IROS 2026, arXiv)
- Articolo su SMILE (arXiv)
Commenti
Accedi per continuare.
Nessun dato disponibile.