Contents — find the section you need
En los últimos años, ejecutar un modelo de lenguaje grande en tu propia máquina, sin utilizar una API en la nube —lo que se conoce como "LLM local"— se ha vuelto práctico. Esto es el resultado de la convergencia de dos tendencias: mejores modelos de ponderación abierta y la reducción del tamaño de los modelos mediante técnicas de cuantización.
 Ollama
 Hugging Face
Imagen: Ollama / Hugging Face logotipos, Wikimedia Commons


Inferencia local en resumen
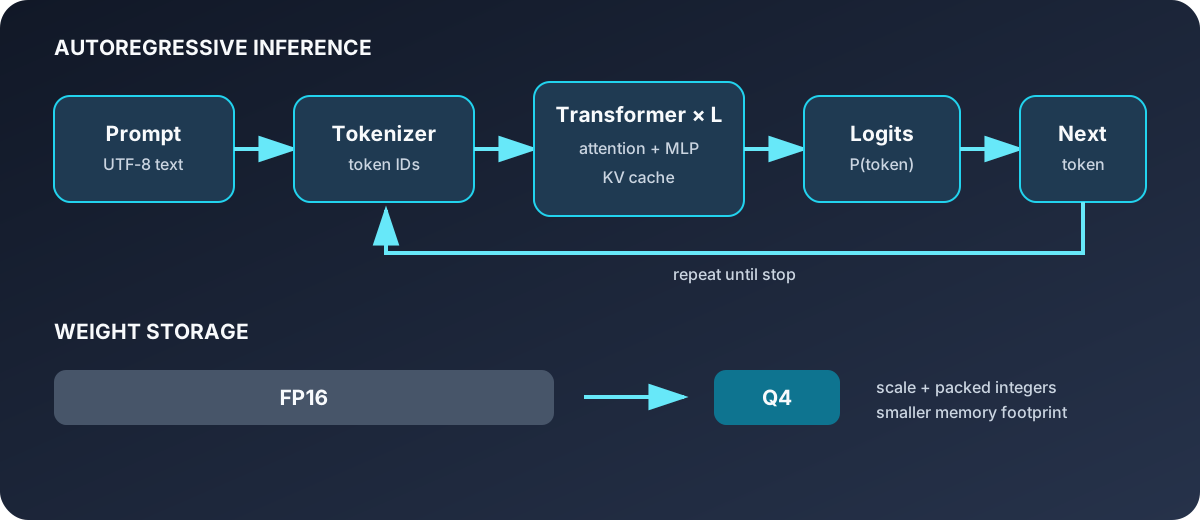
Diagrama: Duskcoil. La ruta de generación y el papel de la cuantización de pesos se muestran por separado.
La clave para comprender un LLM local es separar el bucle de inferencia repetitivo de la memoria necesaria para almacenar el modelo. El texto se convierte en identificadores de tokens; el transformador calcula una distribución para el siguiente token; y el token seleccionado regresa a la entrada. La cuantización, por su parte, modifica principalmente la forma en que se almacenan y calculan los pesos para que un modelo se ajuste a la RAM o VRAM limitada. Por lo tanto, una comparación útil de la implementación considera no solo el nombre del modelo, sino también su formato de peso, la caché KV que crece con la longitud del contexto y los backends de CPU/GPU disponibles.
El rápido auge de los modelos de peso abierto
El panorama de los modelos de peso abierto, a partir de 2026, continúa reorganizándose en una escala de tiempo de meses. DeepSeek impulsa la alta eficiencia en sus variantes Flash y Pro; Qwen ha pasado de ser un serio competidor a ser considerado de primer nivel en razonamiento a nivel de posgrado, gracias a la amplitud de sus opciones de hardware y tamaño de modelo. Llama 4 de Meta ofrece una ventana de contexto de hasta 10 millones de tokens para un modelo abierto. Más recientemente, GLM-5.2 de Z.ai experimentó un gran salto en el rendimiento de los agentes de codificación y se integró en marcos de agentes a los pocos días de su lanzamiento. Kimi K2.7 Code HighSpeed afirma una aceleración de 6x en el razonamiento de codificación multimodal; el ritmo de cambio es extremadamente rápido.
Los resultados de las pruebas de rendimiento también marcan un cambio importante. En las suites de evaluación de codificación tipo SWE-bench, la diferencia entre los mejores modelos de código abierto y los principales modelos comerciales se ha reducido a un porcentaje de un solo dígito, y algunos argumentan que esta diferencia prácticamente se ha cerrado para el trabajo de ingeniería cotidiano.
Fundamentos: El Mecanismo de Atención
Todos los modelos de lenguaje grandes actuales —incluidos los que se ejecutan en Ollama— se basan en la arquitectura Transformer, cuyo núcleo es la autoatención. A partir de las matrices de consulta Q, clave K y valor V derivadas de la secuencia de entrada, se calcula la atención mediante el producto escalar escalado de la siguiente manera:
QK^\top representa la relación (similitud) entre los tokens, y la división por \sqrt{d_k} (la raíz cuadrada de la dimensión de la clave) evita que los productos escalares crezcan tanto que el gradiente de softmax se anule. Repetir esta operación en todos los parámetros y capas del modelo es lo que constituye la inferencia Transformer, y la cuantización, que se explica a continuación, explica hasta qué punto se puede reducir la mayor parte de esos parámetros (las matrices de pesos).
Forma básica de la cuantización lineal
La idea subyacente a GGUF, AWQ y GPTQ es la cuantización lineal: convertir un peso de punto flotante x en un entero de menor número de bits q.
s representa la escala (el ancho de los números reales por paso) y z el punto cero (donde, en la representación entera, se ubica el cero real). Ambos son parámetros de calibración, y la forma en que cada método determina estos dos valores, así como la granularidad (modelo completo, por capa, por peso), es lo que determina las diferencias de rendimiento entre ellos.
La evolución de la cuantización: GGUF, AWQ, GPTQ
Además de un mejor rendimiento del modelo, la cuantización —la reducción del tamaño del modelo— se ha vuelto igualmente esencial. Los métodos de cuantización como GGUF, AWQ y GPTQ han logrado reducir el tamaño de los modelos en aproximadamente un 70%, manteniendo la pérdida de precisión por debajo del 2%. Esto permite que un modelo con 32 mil millones de parámetros se ajuste ahora a 16 GB de memoria. La inferencia local en hardware de consumo típico alcanza ahora entre el 70% y el 85% de la calidad de un modelo de alto nivel, sin coste adicional por solicitud.
Los tres formatos tienen sus propias ventajas. GGUF (anteriormente GGML) es el formato nativo de llama.cpp y su ecosistema (Ollama, LM Studio, etc.), y destaca en la inferencia híbrida CPU+GPU. GPTQ sobresale por su velocidad de inferencia en configuraciones exclusivamente GPU, y AWQ se considera generalmente la mejor opción en cuanto a precisión por tamaño con cuantización de 4 bits. Para el desarrollo local general, GGUF a través de Ollama suele recomendarse como la opción predeterminada.
Diferencias técnicas entre los tres métodos de cuantización
GGUF, AWQ y GPTQ son métodos de cuantización que reducen los pesos del modelo de punto flotante de 16/32 bits a aproximadamente 4 bits, pero lo logran mediante procesos técnicos diferentes.
GPTQ trata la cuantización como un problema de optimización. Utiliza información de segundo orden de la función de pérdida (la matriz hessiana) para determinar qué errores de redondeo de los pesos son más relevantes para el resultado. A medida que cada peso se cuantiza, distribuye el error resultante como compensación entre los pesos aún no cuantizados de la misma fila. Es un método enfocado en el rendimiento de la inferencia en GPU, y cuantizar un modelo de 7 mil millones de parámetros tarda aproximadamente de 2 a 4 horas en una sola GPU A100.
AWQ, en cambio, se centra no en el paso de cuantización en sí, sino en determinar qué pesos son realmente relevantes. Ejecuta una fase de calibración que observa las activaciones reales del modelo, identifica los pesos "relevantes" que afectan significativamente la calidad de la salida y cuantifica agresivamente todo lo demás, manteniendo la alta precisión de dichos pesos. Requiere menos muestras de calibración que GPTQ (aproximadamente entre 128 y 512, frente a más de 2048 para GPTQ), lo que lo hace considerablemente más rápido: entre 10 y 30 minutos para un modelo de 7 bits.
GGUF (el formato nativo de llama.cpp) utiliza un esquema llamado "K-quants", que asigna una profundidad de bits diferente a cada capa: 6 bits para una capa de alta importancia como la de atención, 4 bits para una capa de propagación hacia adelante, etc., logrando una mayor calidad por bit que la cuantificación uniforme ingenua de 4 bits. Se dice que una configuración representativa, Q4_K_M, conserva aproximadamente el 92 % de la calidad del modelo original.
Estas diferencias técnicas se corresponden directamente con qué caso de uso se ajusta mejor a cada método. AWQ para inferencia de alta velocidad solo con GPU; GPTQ es la mejor opción cuando un ecosistema de GPU maduro y una amplia biblioteca de modelos pre-cuantizados son fundamentales; GGUF (a través de Ollama, etc.) es la mejor opción cuando la facilidad de uso en un entorno híbrido CPU/GPU es la prioridad.
llama.cpp: Cómo funciona el motor de inferencia local
Detrás de muchos entornos de ejecución LLM locales, incluido Ollama, se encuentra llama.cpp —un motor de inferencia escrito en C/C++— y GGML, la biblioteca de tensores subyacente. GGML es una biblioteca de cálculo de tensores ligera y con pocas dependencias, similar a PyTorch o TensorFlow, que representa el cálculo completo de un modelo como un "grafo de cálculo". Algunos tensores contienen datos reales (como pesos), mientras que otros simplemente representan el resultado de una operación entre otros tensores, sin almacenar ningún valor hasta que se ejecuta el cálculo. Este grafo computacional puede ejecutarse directamente en la CPU o traducirse a instrucciones para un acelerador (CUDA para GPU NVIDIA, Metal para hardware de Apple). Esta portabilidad, que permite ejecutar el mismo archivo de modelo en una amplia gama de configuraciones de hardware, es la base técnica que sustenta la popularidad del formato GGUF.
Las cifras detrás del crecimiento
La rapidez con la que se ha extendido se refleja en cifras concretas. El número de descargas mensuales de Ollama pasó de 100 000 en el primer trimestre de 2023 a 52 millones en el primer trimestre de 2026, un aumento de 520 veces en tres años. El número de modelos con formato GGUF en Hugging Face, formateados para inferencia local, creció de 200 a 135 000 durante el mismo período. llama.cpp, el proyecto que sustenta todo esto, ha superado las 73 000 estrellas en GitHub.
Panorama de lanzamientos de modelos a finales de 2026
Siguiendo el blog oficial de Ollama, en la segunda mitad de 2026 se sucedieron varios lanzamientos importantes. El 10 de agosto, Meta Superintelligence Labs lanzó su primer modelo abierto, un modelo multimodal de 30 mil millones de parámetros llamado "Muse Glimmer", bajo la licencia Apache 2.0. Al día siguiente, 11 de agosto, NVIDIA anunció "Nemotron 3.5 Lightning", un modelo de 30 mil millones diseñado para tareas de agentes de múltiples pasos. El 29 de junio, se lanzó una actualización que hizo que Gemma 4 fuera hasta un 90 % más rápido en el entorno de ejecución MLX de Apple Silicon, impulsando aún más la velocidad de ejecución para casos de uso de agentes de codificación. Ollama anunció una ronda de financiación de 88 millones de dólares el 9 de julio e informó haber alcanzado los 8,9 millones de usuarios desarrolladores. El ecosistema de modelos de peso abierto está trascendiendo la simple "publicación de modelos" y adoptando la forma de una infraestructura comercial real.
La vanguardia de la cuantización: NVFP4 como nueva opción
Tras GGUF, AWQ y GPTQ, la investigación sobre NVFP4 —un formato de coma flotante de 4 bits diseñado para la arquitectura Blackwell de NVIDIA— ha experimentado un rápido crecimiento hasta 2026 como nuevo formato de cuantización. Un estudio de junio de 2026 reveló que un tamaño de bloque de 16 ofrece el mejor equilibrio entre precisión y almacenamiento, y ScaleSweep (mayo de 2026), que optimiza los valores iniciales de escala de bloque mediante una búsqueda de barrido, es uno de los varios métodos que ahora indican que incluso una cuantización agresiva puede conservar más del 93 % del rendimiento de precisión completa. También han surgido técnicas de posprocesamiento, como H-Scale (agosto de 2026), que refina los valores de escala por grupo utilizando una aproximación de segundo orden basada en la matriz hessiana sin sobrecarga adicional en el tiempo de inferencia, lo que indica que la investigación sobre cuantización está pasando de centrarse en "cuánto se pueden reducir los pesos" a "cómo recuperar la precisión tras su reducción". La compresión de la caché KV (la región de memoria que almacena representaciones intermedias de tokens anteriores durante la generación, cuyo tamaño aumenta con contextos más largos) también avanza en paralelo. SemKV (agosto de 2026), que asigna dinámicamente uno de dos niveles de precisión por token según una puntuación de importancia, informa de una reducción de almacenamiento de 6,0x, evitando el fenómeno de la "caída abrupta de calidad", donde la calidad se degrada repentinamente, y de 7,9x cuando se combina con un cuantificador optimizado. Para la inferencia local en contextos largos, la compresión de la caché KV se está convirtiendo en un aspecto tan práctico como la propia cuantificación de pesos.
¿Es suficiente el ajuste de los pesos en memoria para la inferencia?
La caché KV, el espacio de trabajo y la sobrecarga en tiempo de ejecución también consumen memoria.
Incluir la longitud del contexto y la concurrencia en la estimación. ## Referencias - [Mejores LLM de peso abierto de 2026: DeepSeek vs Qwen vs Kimi vs GLM vs Llama](https://wavect.io/blog/open-weight-llm-comparison-2026/) - [Explicación de la cuantización de LLM: GGUF vs AWQ vs GPTQ — La guía completa de 2026](https://fungies.io/llm-quantization-gguf-awq-gptq-guide-2026/) - [IA local en 2026: Comparativas de Ollama, inferencia de $0 y el fin de los precios por token](https://dev.to/pooyagolchian/local-ai-in-2026-ollama-benchmarks-0-inference-and-the-end-of-per-token-pricing-32e7) - [Guía de cuantización de LLM: Comparación de GGUF vs AWQ vs GPTQ vs bitsandbytes (2026)](https://www.premai.io/blog/llm-quantization-guide-gguf-vs-awq-vs-gptq-vs-bitsandbytes-compared-2026/) - [llama.cpp GitHub (ggml-org)](https://github.com/ggml-org/llama.cpp) - [Blog oficial de Ollama](https://ollama.com/blog) - [Artículo sobre la escala H (arXiv)](https://arxiv.org/abs/2608.28113) - [Artículo sobre ScaleSweep (arXiv)](https://arxiv.org/abs/2606.07618) - [Artículo sobre SemKV (arXiv)](https://arxiv.org/abs/2608.28911)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.