Contents — find the section you need
La detección de objetos consiste en estimar simultáneamente la ubicación (cuadro delimitador) y la categoría de un objeto a partir de una imagen. La familia YOLO ha sido durante mucho tiempo la opción preferida para uso en producción, pero para 2026, los detectores basados en transformadores habrán alcanzado un nivel que amenaza seriamente esa posición.
Este artículo se centra en las tendencias de investigación y presenta brevemente los conceptos esenciales.
 Detección de objetos
No se encontró un logotipo oficial libre de licencia para YOLO/Ultralytics, por lo que se creó un icono simple que representa la detección de cuadros delimitadores.
El diseño del detector: una visión general
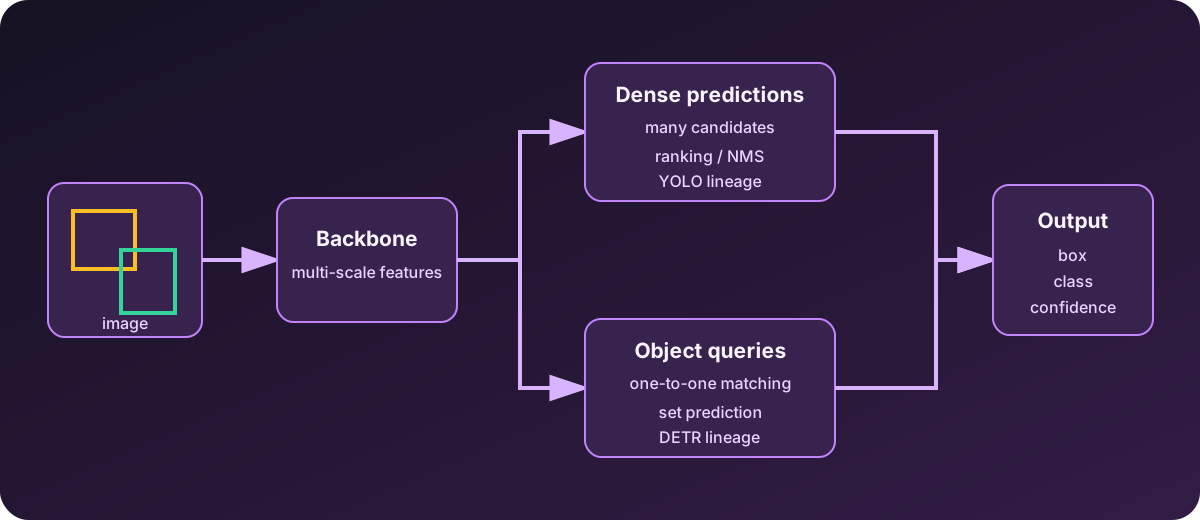
Diagrama: Duskcoil. Destaca la división de diseño representativa entre predicción densa y predicción de conjuntos.
Cada detector de objetos convierte una imagen de entrada en características y, finalmente, devuelve la ubicación, la categoría y la confianza. La principal distinción radica en si crea muchos candidatos y elimina los que no lo son. Posteriormente, se eliminan los duplicados o se comparan las consultas de objetos aprendidos uno a uno con la verdad fundamental, prediciendo directamente un conjunto con baja duplicación. Esta elección influye en la necesidad de la supresión de no máximos (NMS), el objetivo de entrenamiento, la velocidad y el comportamiento en escenas con muchos objetos.
Posición de la familia YOLO: Sin NMS
La NMS tradicional es un paso de posprocesamiento que reduce varias cajas candidatas generadas para el mismo objeto a una detección final, descartando cualquier caja cuya superposición (IoU: Intersección sobre Unión, el área de superposición entre dos cajas dividida por su área de unión) con otra supere un umbral.
Este posprocesamiento se ejecuta como un paso independiente fuera de la red y conlleva ciertas limitaciones: ajuste empírico del umbral y tendencia a descartar erróneamente objetos genuinamente distintos y muy próximos entre sí. YOLO26, la última generación de YOLO, adopta una arquitectura sin NMS que ya no requiere la supresión de no máximos, el paso de posprocesamiento estándar. Años. La supresión de ruido (NMS) suele ser un cuello de botella tanto para el coste computacional como para la latencia en el proceso de inferencia, y su eliminación busca mejorar la velocidad de inferencia y la simplicidad de la implementación. En cuanto al rendimiento puro, el segmento ligero y de alta velocidad también cuenta con una amplia oferta; RTMDet, por ejemplo, supera los 300 FPS.
El auge de los detectores basados en transformadores: RF-DETR y RT-DETRv2
Otra tendencia importante es la madurez práctica de la línea DETR (DEtection TRansformer). RT-DETR/RT-DETRv2 combinan una CNN con un transformador y, al igual que la familia YOLO, están diseñados para generar detecciones finales directamente sin NMS.
El gran acontecimiento de 2026 fue la llegada de RF-DETR, presentado en ICLR 2026. Se describe como el primer modelo en tiempo real en superar los 60 mAP en el benchmark COCO, y también lidera el benchmark RF100-VL, que evalúa la transferencia de dominio. Su licencia es Apache. 2.0 —permisivo para uso comercial— a diferencia de YOLO26/YOLOv12, que tiene licencia AGPL.
Detección de vocabulario abierto mediante indicaciones de texto
Otra tendencia importante es la "detección de vocabulario abierto": la detección de categorías para las que el modelo nunca fue entrenado. YOLO-World y Grounding DINO pueden detectar una categoría arbitraria con solo una indicación de texto, sin necesidad de datos de entrenamiento adicionales. Esto supone un cambio de mentalidad respecto a la detección limitada a una lista de clases fija, y se adapta bien a casos de uso donde las categorías del mundo real no se pueden enumerar completamente de antemano, como el reconocimiento de objetos para un robot de propósito general.
El mecanismo técnico detrás de la eliminación de NMS
La transición de YOLO26 a la detección sin NMS no se limita a omitir un paso de posprocesamiento, sino que proviene de un cambio en el método de entrenamiento. El diseño tradicional de YOLO toleraba múltiples cuadros predictivos por objeto durante el entrenamiento (asignación de uno a muchos), bajo el supuesto de que NMS YOLO26 rediseña el módulo de predicción, adoptando una asignación uno a uno, donde se genera un único cuadro delimitador definitivo por instancia de objeto desde el entrenamiento. Además, reemplaza el enfoque basado en distribución utilizado para la regresión de cuadros delimitadores (Distribution Focal Loss) con una parametrización más ligera y compatible con el hardware, eliminando operaciones que tienden a ser inestables entre compiladores y entornos de ejecución. El resultado es una inferencia hasta un 43 % más rápida en la CPU, junto con una implementación de posprocesamiento más sencilla en general.
RF-DETR también está libre de NMS, pero mediante un mecanismo diferente al de YOLO26. RF-DETR utiliza un Vision Transformer preentrenado, DINOv2, como base, extrae características multirresolución y las procesa mediante un decodificador que trabaja con consultas aprendibles (representaciones abstractas que representan objetos candidatos). Cada capa del decodificador consta de autoatención (que captura las relaciones entre las consultas) y atención cruzada deformable (que atiende solo a un pequeño conjunto aprendido de puntos de muestreo). dentro de las características de la imagen), y una red de propagación hacia adelante que refina la predicción. Esta atención deformable, que "solo considera un pequeño número de puntos aprendidos", mantiene el costo computacional por debajo de la atención cruzada de transformador estándar, a la vez que produce predicciones únicas basadas en conjuntos, razón por la cual la supresión de mínimos cuadrados (NMS) resulta innecesaria.
Lo que muestran las comparaciones entre generaciones: YOLOv8/v11/v26
También han surgido datos que contradicen la suposición de que "una generación más reciente equivale a una precisión uniformemente mayor". Una prueba de rendimiento de agosto de 2026, que abarcó tres generaciones de YOLO y cinco escalas de modelo —dirigida a estructuras de grano fino (ramas, frutas, otros objetos pequeños) en la detección de huertos y la segmentación de instancias— reveló que el mAP@50:95 más alto no lo estableció YOLOv26, sino YOLOv11s-960 (0,402 de mAP de máscara@50:95, 0,426 de mAP de caja@50:95). Mientras tanto, YOLOv26s-960 logró una precisión comparable con solo 10,37 millones de parámetros. Por lo tanto, la conclusión es la siguiente: las mejoras en la precisión bruta no se producen de forma uniforme con cada nueva generación, pero la eficiencia de los parámetros —igualar la precisión con mucha menos capacidad de cálculo— avanza de forma constante.
La detección de objetos pequeños sigue siendo un desafío real sin resolver. Una evaluación realizada en agosto de 2026, que comparó seis variantes de YOLO y dos variantes de DETR en la detección de vehículos militares, reveló un patrón consistente: los modelos más grandes funcionan mejor, los enfoques basados en DETR son prometedores y el ajuste fino mejora el rendimiento aire-tierra (A2G); sin embargo, todos los modelos siguen teniendo dificultades para detectar objetos pequeños en el escenario A2G. Ni el diseño sin NMS de YOLO26 ni el alto mAP de RF-DETR han resuelto por completo este problema de los "objetos pequeños y distantes".
Avances en la detección con vocabulario abierto: Cifras de AP concretas
Generación de detectores con vocabulario abierto tras YOLO-World/Grounding DINO También ha logrado mejoras constantes en la precisión hasta 2026. FlowOVD (mayo de 2026), que utiliza un flujo rectificado generativo para transformar consultas independientes del texto en consultas guiadas por texto, reporta 49,5 AP en COCO y 31,5 AP en LVIS, mejoras de +1,2 AP (un +2,5% relativo) y +4,1 AP (un +15,0% relativo) con respecto a Grounding DINO, respectivamente. OPUS, publicado en agosto de 2026, maneja múltiples tipos de indicaciones (texto, visuales [interactivas/genéricas] y mixtas) dentro de un único marco unificado y, a pesar de un diseño más simple que evita la fusión multimodal pesada, publica cifras de vanguardia de 68,1/69,2/54,7 AP en los benchmarks COCO, LVIS-minival y ODinW35. La detección de vocabulario abierto ya no es solo una victoria cualitativa (la capacidad de manejar categorías desconocidas), sino que está comenzando a ser cuantitativamente competitiva con Detectores de clase fija también.
Panorama actual a partir de 2026
La detección de objetos hoy en día se basa principalmente en dos ejes: arquitecturas de transformadores de una sola etapa sin NMS y la familia YOLO con su ecosistema consolidado. El sector de los transformadores se desarrolla rápidamente, pero la familia YOLO sigue siendo la columna vertebral de los entornos de producción en tiempo real, gracias a su trayectoria y a la gran cantidad de herramientas que ofrece. Desglosado por caso de uso:
- Precisión ante todo: RF-DETR
- Trayectoria y ecosistema de suma importancia: YOLO26/YOLOv12
- Velocidad pura: RTMDet
- Necesidad de gestionar categorías desconocidas: YOLO-World / Grounding DINO
Esta es la división actual del trabajo.
¿Puede mAP seleccionar un detector en tiempo real por sí solo?
Compara la latencia y la calidad con la misma resolución y datos. y hardware. El tiempo de inferencia sin preprocesamiento ni posprocesamiento no es la latencia de extremo a extremo.
## Referencias - [Desmitificando RF-DETR (Hacia la IA)](https://pub.towardsai.net/demystifying-rf-detr-iclr-2026-a-real-time-transformer-pushing-the-limits-of-object-detection-f4d0a9617fdd) - [Artículo RT-DETRv2 (arXiv)](https://arxiv.org/pdf/2407.17140) - [Los DETR superan a los YOLO en la detección de objetos en tiempo real (arXiv)](https://arxiv.org/pdf/2304.08069) - [Los mejores modelos de detección de objetos de 2026 (Blog de Roboflow)](https://blog.roboflow.com/best-object-detection-models/) - [YOLO26: Un análisis del marco de extremo a extremo sin NMS para la detección de objetos en tiempo real (arXiv)](https://arxiv.org/pdf/2601.12882) - [Artículo RF-DETR (ICLR 2026, arXiv)](https://arxiv.org/pdf/2511.09554) - [RF-DETR [GitHub (roboflow)](https://github.com/roboflow/rf-detr) - [Optimización intergeneracional de YOLOv26, YOLOv11 y YOLOv8 (arXiv)](https://arxiv.org/abs/2608.23636) - [Estudio comparativo de tecnología lista para usar para la detección y el reconocimiento automático de objetivos (arXiv)](https://arxiv.org/abs/2608.17917) - [FlowOVD (arXiv)](https://arxiv.org/abs/2606.00782) - [OPUS (arXiv)](https://arxiv.org/abs/2608.30247)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.