目次 — 知りたいところから読む
このプロジェクトの全サービスは、1台のWindows PC上で動いている。専用のサーバー機ではなく、日常的に使うPCの計算資源を間借りする形である。ここではその実行基盤の構成を記す。
 Docker
画像: Dockerロゴ、Wikimedia Commons

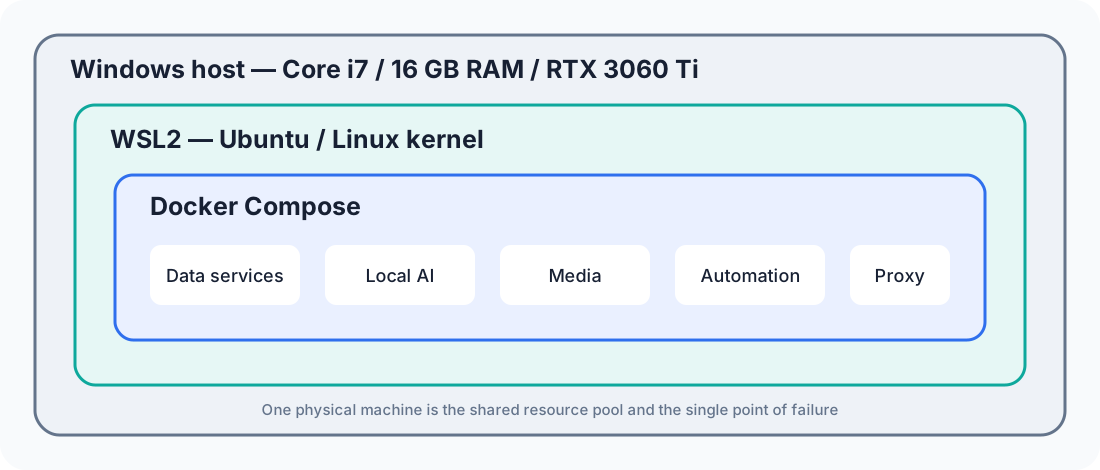
図: Duskcoil作成。1台の物理PC上でOS・仮想化・コンテナの層を分け、GPUとメモリを共有する。
実行基盤: WSL2上のDocker
各サービスはDocker(Docker Compose)のコンテナとして稼働しており、その土台としてWindows Subsystem for Linux 2(WSL2)上のUbuntuを使っている。WSL2はLinuxカーネルを実際に仮想マシン上で動かす方式のため、Docker EngineをネイティブのLinux環境と同様に動作させられる。Windows起動時にWSLとDockerサービスが自動起動するよう設定し、PCの電源を入れるだけでサービス群が立ち上がる状態にしている。
ハードウェア: GPUを含む計算資源
物理的な計算資源はデスクトップPC1台(Intel Core i7-12700、10コア/20スレッド)で、GPU(NVIDIA GeForce RTX 3060 Ti)を搭載していることがローカルAIとメディアのハードウェアトランスコードの両方を成立させている。GPU・CPU・ディスク容量には現状十分な余裕があり、実質的なボトルネックはメモリのみである。物理メモリは16GBで、WSL2側に割り当てるメモリ上限は、このマシン上で並行して動かしている別プロジェクト(ロボット開発用のワークスペース)と共有の設定になっているため、サーバー側の都合だけで変更しない方針にしている。メモリを32GBに増設することが拡張の最有力候補だが、費用対効果を踏まえてまだ実施していない。
1つのGPUを複数サービスで共有する
このPCのGPUは、Jellyfinの動画トランスコード、ComfyUIの画像生成、Immichの機械学習推論(顔認識・被写体検出)、そしてOllamaによるローカルLLM推論という、性質の異なる複数のワークロードから共有されている。常時起動しているサービスもあれば、必要な時だけ手動で起動するサービスもあり、この起動タイミングの使い分け自体が、限られたGPUメモリを実質的に多重化する運用上の工夫になっている。GPUを直接使うサービスには、それぞれコンテナのリソース予約設定でGPUデバイスへのアクセス権(GPU・計算・動画エンコードの各ケイパビリティ)を明示的に割り当てている。
メモリ逼迫インシデントから学んだこと
メモリがボトルネックであることは、実際にインシデントとして表面化した。監視ダッシュボードがswap使用率98%超という重大警告を検知し、調査したところ、画像生成サービス(ComfyUI)が、実際に画像を生成していないアイドル時にもメモリの相当量(WSL2全体の4割超)を保持し続けていたことが原因と判明した。
この時点では、各コンテナに個別のメモリ上限を設定する運用自体がまだ整っていなかった。1つのコンテナが青天井にメモリを確保できる状態では、そのコンテナの都合で他の全コンテナが共倒れになりうる。対応として、まずComfyUIの再起動ポリシーを「常時起動」から「自動再起動しない」に変更し、使う時だけ手動で起動する運用に切り替えた。これによりアイドル時のメモリ消費をゼロにできた。あわせて、当時ほぼ使っていなかった旧サービス群(動画取得の自動化ツール一式)も削除し、結果として使用メモリ・swap使用率とも大幅に改善した。
このインシデントを踏まえ、後日実施したサーバー全体の評価・改善作業の中で、稼働中の全コンテナ(主要サービス群と写真管理サービス側を合わせた約20弱)に対して漏れなくメモリ上限を設定する対応を行った。「瞬間的にメモリを多く使うサービスには余裕を持った上限を、常駐前提の軽量なサービスには小さめの上限を」という原則で、実際の負荷特性に応じて割り当てている。1サービスの想定外の挙動が全体を巻き込む前に、個々のコンテナの側で天井を作っておくという、後手に回った教訓の反映である。
設定のバージョン管理という後回しにしていた基礎
サービス数が増えるにつれ、各サービスの定義ファイルや個々の設定ファイルをどう変更したか、変更前の状態に戻すにはどうすればよいかが曖昧になっていく問題があった。この構成全体はしばらくの間バージョン管理下に置かれておらず、変更履歴は実質的に自分の記憶だけが頼りだった。
後日の評価作業でこの点を指摘され、Docker構成一式のディレクトリをGitリポジトリ化した。実データ・キャッシュ・シークレット類(認証トークンを含む実行時状態ファイル、パスワード本体など)は除外対象として明示し、Compose定義やCaddyの設定ファイルなど、手で編集する設定ファイルだけを追跡する方針にしている。これにより、以降の変更(コンテナのメモリ上限の一括設定や、後述するサービスごとの待受アドレス修正など)がコミット単位で追跡可能になった。サーバーという「動いていて当たり前」の基盤ほど、変更管理を後回しにしがちだが、後から差分を追えることの価値は障害対応の場面で特に大きい。
単一障害点という制約
専用のサーバー機ではなく1台のPCに集約しているため、このPCの停止がそのまま全サービスの停止に直結するという制約がある。この制約を前提に、バックアップの二重化(ローカルの複数世代保持+専用ディスクへの分離)や、ディスク容量・サービス稼働状況の自動監視といった運用面での備えを重ねている。ハードウェアの冗長化(無停電電源装置の導入等)は費用対効果を踏まえて現時点では見送っている。
メモリの合計使用量が上限内なら安定する?
瞬間的なピーク、GPUメモリ、ホストOSの余力も必要になる。単独実行と複数サービス同時実行を分けて測る。
コメント
コメントの投稿にはログインが必要です
まだコメントはありません。