Contents — find the section you need
एक एआई इन्फरेंस एक्सेलेरेटर एक विशेष रूप से प्रशिक्षित न्यूरल नेटवर्क के "इन्फरेंस" पास (केवल फॉरवर्ड कंप्यूटेशन) को चलाने के लिए डिज़ाइन किया गया चिप है, जो सीपीयू या जीपीयू की तुलना में कहीं अधिक ऊर्जा दक्षता प्रदान करता है। इसका मूल भौतिक सिद्धांत सरल है: 32-बिट फ्लोटिंग पॉइंट (FP32) में प्रशिक्षित भारों को 8-बिट पूर्णांक (INT8) जैसे कम परिशुद्धता वाले निरूपण में परिवर्तित करना (क्वांटाइजेशन) समान कंप्यूटिंग इकाइयों और समान मेमोरी बैंडविड्थ का उपयोग करके कहीं अधिक समानांतर संचालन करने में सक्षम बनाता है। यह लेख एसबीसी (सिंगल-बोर्ड कंप्यूटर) की समग्र प्रणालियों के रूप में तुलना नहीं करता है; इसके बजाय, यह पूरी तरह से इन्फरेंस के लिए समर्पित एक्सेलेरेटर चिप्स के पीछे की डिज़ाइन फिलॉसफी और क्वांटाइजेशन सिद्धांत पर केंद्रित है: Google Coral (Edge TPU), Intel Movidius (Myriad X), और NVIDIA Jetson Orin NX।
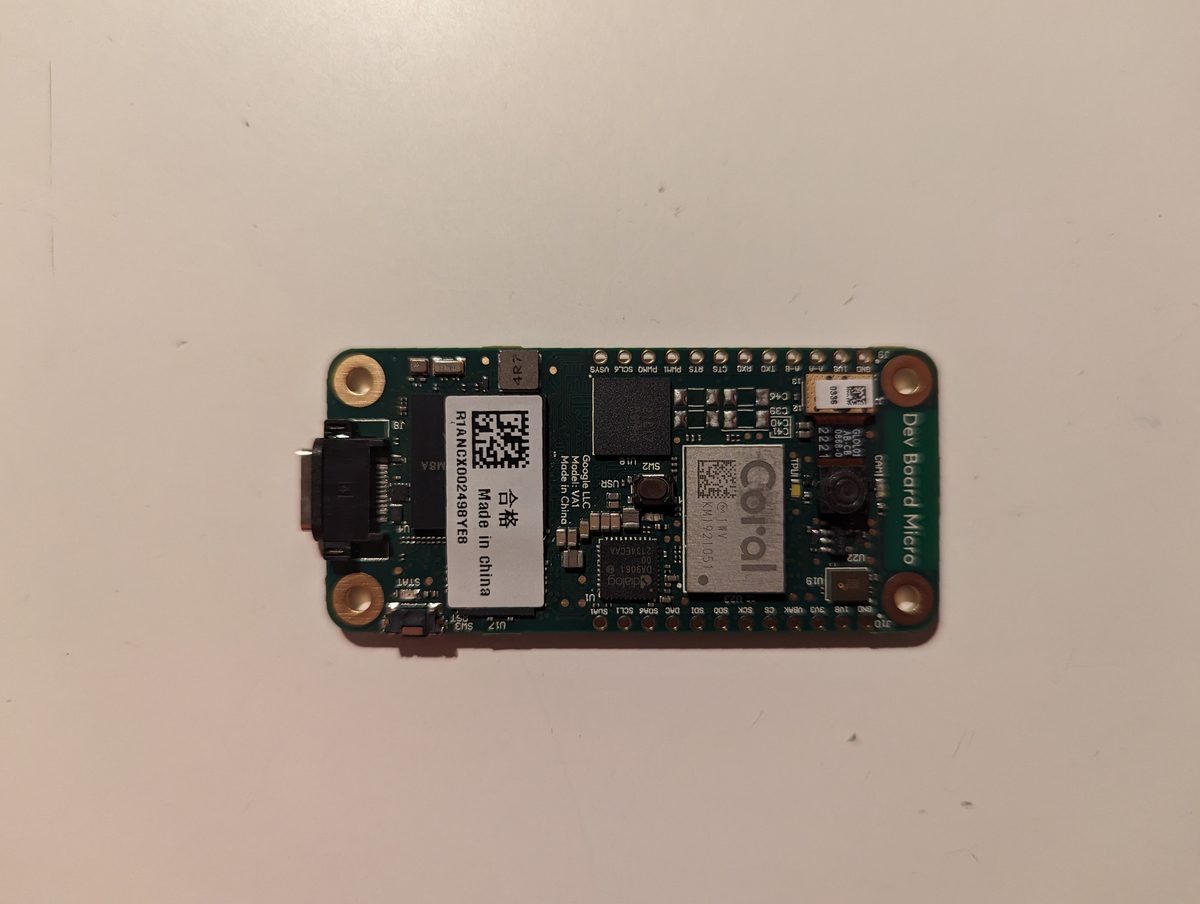 Google Coral Dev Board Micro
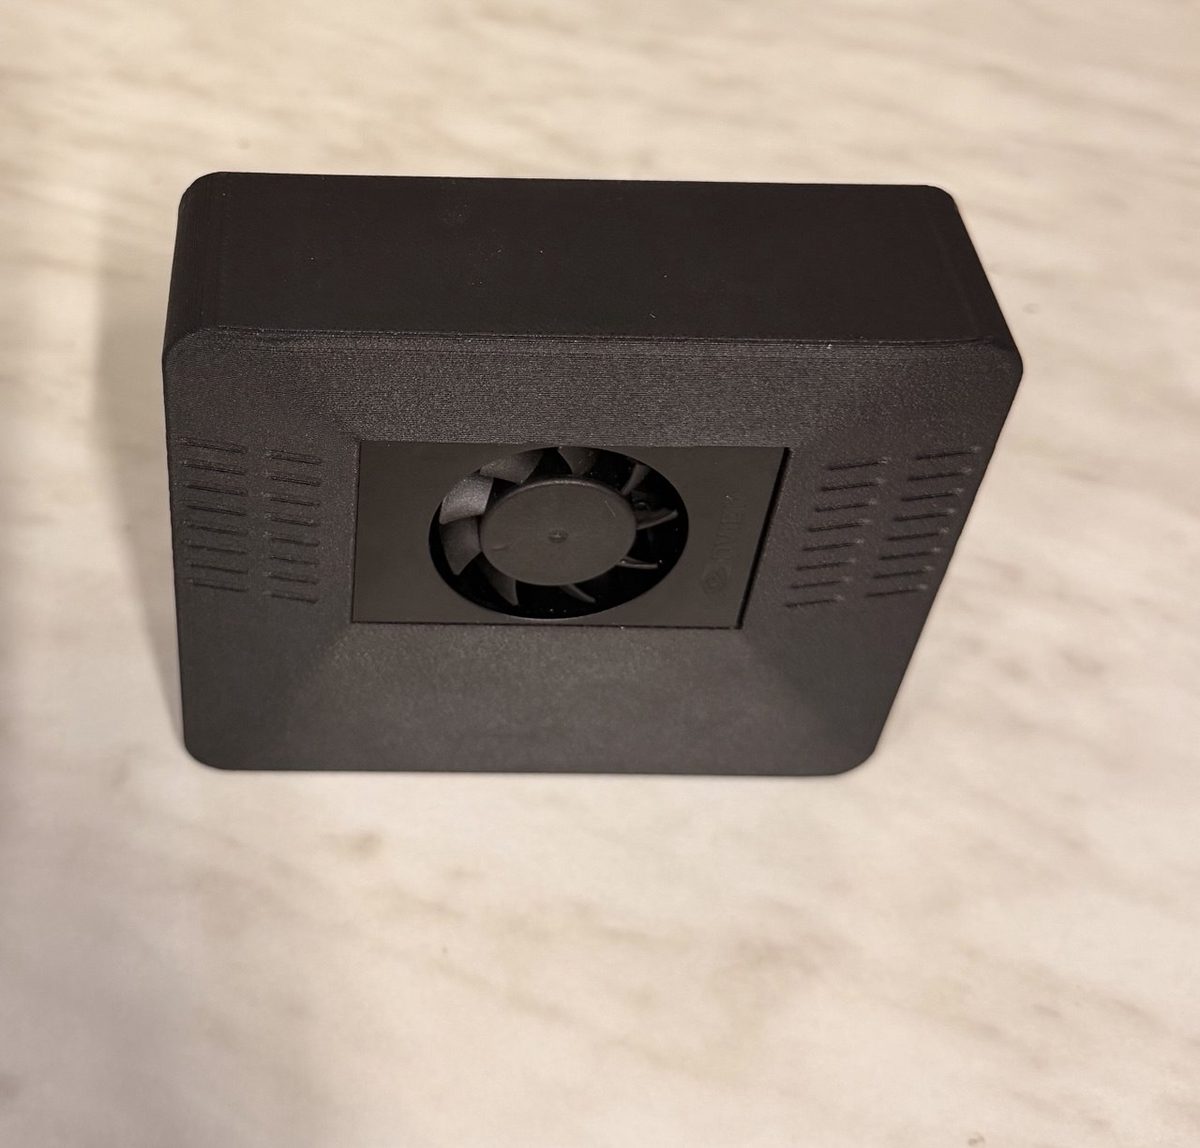 NVIDIA Jetson Orin Nano (2026, ID Robots) पर निर्मित "ClawBox"
चित्र: Hardware PXL 20231201 152957218 (53388218926)(थॉमस एम्बर्ग, CC BY-SA 2.0) / क्लॉबॉक्स एआई सहायक उपकरण (2026) - फ्रंट(क्रालेव, CC BY-SA 4.0), दोनों विकिमीडिया कॉमन्स के माध्यम से।
.jpg)
_-_front.jpg)
सिद्धांत: INT8 क्वांटाइजेशन वास्तव में क्या करता है
FP32 भार और सक्रियणों को 8-बिट पूर्णांकों में संपीड़ित करने का सबसे सामान्य तरीका रैखिक (एफ़ाइन) क्वांटाइजेशन है। वास्तविक मान x को पूर्णांक q में परिवर्तित करने का सूत्र इस प्रकार है:
यहाँ s स्केल (एक पूर्णांक चरण की वास्तविक मान वाली चौड़ाई) है, z शून्य बिंदु (वह ऑफ़सेट जो बताता है कि कौन सा पूर्णांक चरण वास्तविक शून्य के अनुरूप है) है, और b बिट चौड़ाई (INT8 के लिए 8) है। अनुमान के समय मान लगभग x \approx s(q-z) के रूप में प्राप्त होता है। व्यवहार में इस परिमाणीकरण का अर्थ यह है कि मान वितरण को कितनी सटीकता से सीमित किया जा सकता है, यह सीधे तौर पर निर्धारित करता है कि कितनी सटीकता कम हो जाती है। समान 256 चरणों (INT8) के साथ, एक संकीर्ण मान सीमा प्रत्येक चरण की चौड़ाई - परिमाणीकरण त्रुटि - को कम रखती है; बाहरी मानों द्वारा विस्तारित सीमा समान 256 चरणों को पतला कर देती है, जिससे वितरण के अधिकांश भाग को बनाने वाले विशिष्ट मानों का प्रतिनिधित्व स्थैतिक हो जाता है।
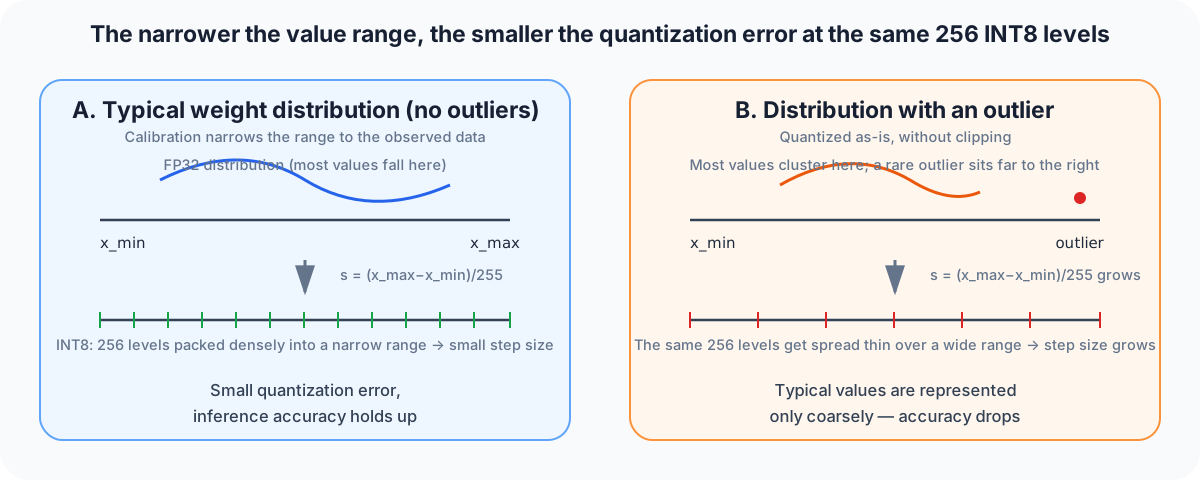
आरेख: डस्ककॉइल। यह दर्शाता है कि वास्तविक मापे गए डेटा का उपयोग करके मान सीमा को सीमित करने वाले "कैलिब्रेशन" की उपस्थिति या अनुपस्थिति, समान बिट चौड़ाई पर भी क्वांटाइजेशन त्रुटि को कैसे महत्वपूर्ण रूप से प्रभावित करती है।
इस मान सीमा का निर्धारण कैलिब्रेशन चरण है, और क्वांटाइजेशन मोटे तौर पर दो दृष्टिकोणों का अनुसरण करता है। प्रशिक्षण के बाद क्वांटाइजेशन (PTQ) प्रशिक्षित FP32 मॉडल के माध्यम से प्रतिनिधि डेटा की एक छोटी मात्रा को चलाता है और प्रत्येक परत की प्रेक्षित आउटपुट सीमा से स्केल s की गणना करता है - एक हल्का दृष्टिकोण, लेकिन कई आउटलायर्स वाले मॉडलों पर सटीकता में अधिक हानि की संभावना होती है। क्वांटाइजेशन-जागरूक प्रशिक्षण (QAT)** प्रशिक्षण के दौरान क्वांटाइजेशन द्वारा उत्पन्न राउंडिंग त्रुटि का अनुकरण करता है और तदनुसार भार को अपडेट करता है; इससे पुनः प्रशिक्षण पास की कीमत पर सटीकता में गिरावट को रोका जा सकता है। एज टीपीयू कंपाइलर, टेन्सरआरटी और ओपनवीएनओ दोनों ही इन दोनों तरीकों का समर्थन करते हैं, लेकिन चूंकि अधिकांश एज इन्फरेंस चिप्स INT8 मानकर अपने कैटलॉग प्रदर्शन (TOPS) का उल्लेख करते हैं, इसलिए व्यावहारिक दुविधा यह है कि क्या PTQ पर्याप्त सटीकता प्रदान करता है या QAT पर स्विच करना आवश्यक है।
एक और पेचीदगी यह है: 2017 के आसपास डिज़ाइन किए गए वीपीयू (विज़न प्रोसेसिंग यूनिट), जैसे कि मोविडियस मायरीड एक्स, ने अपनी प्राथमिक कंप्यूट परिशुद्धता के रूप में INT8 के बजाय FP16 (हाफ-प्रिसिजन फ्लोटिंग पॉइंट) का उपयोग किया। FP16, FP32 की तुलना में मेमोरी फुटप्रिंट और बैंडविड्थ की मांग को आधा कर देता है, जबकि - एक एक्सपोनेंट फ़ील्ड को बनाए रखने के कारण - INT8-शैली रेंज कैलिब्रेशन की आवश्यकता के बिना एक विस्तृत डायनेमिक रेंज का प्रतिनिधित्व करता है। हालांकि, यह INT8 द्वारा प्राप्त की जा सकने वाली समानांतरता तक नहीं पहुंचता है, जो एक कारण है कि बाद में कोरल एज टीपीयू और जेटसन के टेंसर कोर, दोनों INT8-फर्स्ट समर्पित डेटा पाथ पर आधारित, TOPS/W में कई गुना वृद्धि करते हैं।
सिद्धांत: ग्राफ कंपाइलर अनुमान गति में वृद्धि का दूसरा महत्वपूर्ण कारक
क्वांटाइजेशन के साथ-साथ, किसी प्रशिक्षित मॉडल को किसी दिए गए चिप के इंस्ट्रक्शन सेट के लिए जिस रूप में कंपाइल किया जाता है, वह वास्तविक दुनिया में थ्रूपुट का एक अन्य प्रमुख कारक है। TensorFlow Lite या ONNX से निर्यात किया गया मॉडल, अपने आप में, एक जेनेरिक ग्राफ होता है जिसे CPU पर परत दर परत क्रम से निष्पादित किया जाता है। प्रत्येक विक्रेता का कंपाइलर इस ग्राफ पर लगभग तीन प्रकार के ऑप्टिमाइजेशन लागू करता है।
-
ऑपरेटर फ्यूजन: कनवोल्यूशन→बैचनॉर्म→ReLU जैसे अनुक्रम को एक एकल फ्यूज्ड कर्नेल में मर्ज किया जाता है, जिससे मध्यवर्ती परिणाम मेमोरी में वापस लिखने के बजाय रजिस्टरों में रखे जाते हैं, जिससे मेमोरी एक्सेस की संख्या कम हो जाती है।
-
लेआउट ट्रांसफॉर्मेशन: CPU द्वारा पसंदीदा NCHW (चैनल-फर्स्ट) लेआउट और वेक्टर-यूनिट द्वारा पसंदीदा NHWC (चैनल-लास्ट) लेआउट को लक्ष्य हार्डवेयर के वास्तविक मेमोरी एक्सेस पैटर्न से मेल खाने के लिए पुनः चयनित किया जाता है।
-
निश्चित ग्राफ़ में संकलन: कुछ कंपाइलर, जैसे कि कोरल एज टीपीयू कंपाइलर, केवल पूरी तरह से समर्थित ऑपरेटरों से निर्मित एक निश्चित ग्राफ़ को ही स्वीकार करते हैं, गतिशील आकृतियों या असमर्थित ऑपरेटरों को पूरी तरह से अस्वीकार करते हैं। यदि मॉडल में एक भी असमर्थित ऑपरेटर दिखाई देता है, तो निष्पादन सीपीयू और उसके आसपास के एज टीपीयू के बीच विभाजित हो जाता है, और परिणामस्वरूप द्विदिशात्मक डेटा स्थानांतरण लागत गति को काफी हद तक कम कर सकती है।
एनवीडिया का टेन्सरआरटी और इंटेल का ओपनवीएनओ अधिक लचीला "आंशिक ऑफलोड" दृष्टिकोण अपनाते हैं - असमर्थित ऑपरेटरों को सीपीयू पर वापस भेजते हैं जबकि बाकी को एक्सेलेरेटर पर ऑफलोड करते हैं - जबकि कोरल एज टीपीयू कंपाइलर पूरी तरह से समर्थित ग्राफ़ और बिल्कुल भी त्वरण न होने के बीच एक पूर्ण या शून्य विकल्प के करीब है। यह अंतर हार्डवेयर मेट्रिक्स जैसे कि [एसबीसी तुलना] में शामिल टीओपीएस/मेमोरी-बैंडविड्थ ट्रेडऑफ़ में नहीं दिखता है। लेख](/hi/blog/posts/sensor-sbc.html) — यह सॉफ़्टवेयर स्टैक की डिज़ाइन फिलॉसफी में अंतर है, और यह किसी मॉडल को पोर्ट करने की वास्तविक लागत को काफी हद तक प्रभावित करता है।
प्रमुख चिप तुलना: कोरल, मोविडियस, जेटसन
| उत्पाद | परिशुद्धता | एआई प्रदर्शन | शक्ति | इंटरफ़ेस | कीमत |
|---|---|---|---|---|---|
| गूगल कोरल एज टीपीयू (यूएसबी एक्सेलेरेटर) | केवल INT8 | 4 TOPS (2 TOPS/W) | 2W | यूएसबी 3.0 | लगभग $75–99 (2019 में लॉन्च) |
| इंटेल मोविडियस मायरीड एक्स (न्यूरल कंप्यूट स्टिक 2) | मुख्य रूप से FP16 | लगभग 4 TOPS के बराबर (कोई आधिकारिक प्रकाशित आंकड़ा नहीं) | लगभग 1.5–2.5W | यूएसबी 3.0 | लगभग $79–99 (2018 में लॉन्च, अब) (बंद कर दिया गया) |
हेलो-8 (एम.2) | INT8 | 26 टॉप्स (10.4 टॉप्स/डब्ल्यू) | ~2.5W | एम.2/पीसीआईई | ~$110 |
एनवीडिया जेटसन ओरिन नैनो सुपर | INT8 | 67 टॉप्स (MAXN सुपर मोड) | 7–25W | SoM (एकीकृत मॉड्यूल) | $249 |
एनवीडिया जेटसन ओरिन एनएक्स (16GB) | INT8 | 100 टॉप्स | 10–25W | SoM (एकीकृत मॉड्यूल) | $599 |
इंटेल के आधिकारिक मोविडियस मायरीड एक्स स्पेसिफिकेशन पेज पर सटीक टॉप्स आंकड़ा नहीं दिया गया है, लेकिन कई समीक्षाओं में इसे कुल मिलाकर "प्रति सेकंड 4 ट्रिलियन से अधिक ऑपरेशन" देने वाला बताया गया है, और इंटेल ने स्वयं कहा है कि मायरीड एक्स, मायरीड 2 (100–150 GFLOPS) से 10 गुना से अधिक तेज है। न्यूरल कंप्यूट इंजन के साथ 16 प्रोग्रामेबल SHAVE वेक्टर प्रोसेसर कोर - एक समर्पित ब्लॉक जो Myriad X के साथ पेश किया गया था - को 720p (तीन स्टीरियो जोड़े) पर छह कैमरों को 60 fps पर एक साथ प्रोसेस करने के लिए डिज़ाइन किया गया था। Hailo-8 और Jetson Orin Nano Super/NX के बारे में SBC तुलना लेख में अधिक विस्तार से बताया गया है, इसलिए यह लेख दोहराव से बचने के लिए ऊपर दी गई तालिका प्रविष्टियों तक ही सीमित है।
कोरल लाइनअप में Dev Board Micro भी शामिल है, जो ऊपर सूचीबद्ध USB एक्सेलेरेटर का एक उन्नत संस्करण है। Linux-सक्षम एप्लिकेशन प्रोसेसर के बजाय, यह Edge TPU कोप्रोसेसर को एक हमेशा चालू रहने वाले, कम बिजली खपत वाले माइक्रोकंट्रोलर (MCU)-श्रेणी के बोर्ड के साथ जोड़ता है, जो बैटरी से चलने वाले TinyML उपयोग मामलों जैसे कि हमेशा सुनने वाली आवाज या कंपन का पता लगाने के लिए बनाया गया है। जहाँ Dev Board/USB एक्सेलेरेटर एक सामान्य-उद्देश्य वाले SoC को एक बाहरी Edge TPU के साथ जोड़ता है, वहीं Dev Board Micro पूरी तरह से एक अलग उपयोग मामले को लक्षित करता है: एक हमेशा चालू रहने वाला डिटेक्शन ट्रिगर।
इतिहास: इंटेल द्वारा मोविडियस के अधिग्रहण से जन्मी वीपीयू डिज़ाइन फिलॉसफी
मोविडियस सैन माटेओ स्थित एक स्टार्टअप था जो कंप्यूटर विज़न प्रोसेसिंग के लिए विशेष रूप से कम बिजली खपत करने वाले चिप्स डिज़ाइन करता था। इंटेल ने सितंबर 2016 में इसका अधिग्रहण किया। अधिग्रहण से पहले इसके मायरीड 2 वीपीयू (विज़न प्रोसेसिंग यूनिट) का डिज़ाइन सामान्य-उद्देश्यीय सीपीयू जैसा नहीं था; इसके बजाय इसमें समर्पित कंप्यूटर विज़न हार्डवेयर ब्लॉक को 12 कस्टम-डिज़ाइन किए गए वेक्टर प्रोसेसर कोर (SHAVE) के साथ जोड़ा गया था। अधिग्रहण के बाद, इसका उपयोग गूगल के लाइफलॉगिंग कैमरा "क्लिप्स", फ्लिर के थर्मल इमेजिंग कैमरा "फायरफ्लाई", डीजेआई के "फैंटम 4" ड्रोन और टेनसेंट के "डीपगेज़" सहित कई उत्पादन उपकरणों में किया जाने लगा। इसके उत्तराधिकारी, मायरीड एक्स की घोषणा 2017 में की गई, जिसमें SHAVE कोर की संख्या बढ़ाकर 16 कर दी गई और पहली बार न्यूरल नेटवर्क इन्फरेंस के लिए एक समर्पित हार्डवेयर ब्लॉक, न्यूरल कंप्यूट इंजन, जोड़ा गया, जिससे मायरीड के प्रदर्शन से 10 गुना से अधिक का लाभ हुआ। 2 और 1 टेराफ्लॉप्स से अधिक की अधिकतम क्षमता। ऊपर उल्लिखित न्यूरल कंप्यूट स्टिक 2 (NCS2) एक USB स्टिक उत्पाद है जिसमें एक सिंगल मायरीड X चिप लगी है, जिसे 2018 की चौथी तिमाही में लॉन्च किया गया था; इंटेल के अपने उत्पाद विनिर्देश पृष्ठ पर अब इसे "बंद" के रूप में चिह्नित किया गया है - एक VPU चिप जो कभी एज AI के शुरुआती दिनों का प्रतिनिधित्व करती थी, लेकिन बाद में आए INT8-समर्पित ASIC और GPU-एकीकृत चिप्स के कारण बाजार में अपनी जगह खो बैठी।
इस अधिग्रहण के साथ ही, इंटेल ने 16 मई, 2018 को अपने ओपनवीएनओ टूलकिट का पहला संस्करण जारी किया, जो एक सॉफ्टवेयर स्टैक है जिसका उद्देश्य अपने हार्डवेयर में क्वांटाइजेशन और ग्राफ ऑप्टिमाइजेशन को समान रूप से संभालना है। ओपनवीएनओ का NNCF (न्यूरल नेटवर्क कम्प्रेशन फ्रेमवर्क) घटक INT8 क्वांटाइजेशन और मॉडल कम्प्रेशन को संभालता है, और इसे न केवल मोविडियस-परिवार के VPUs बल्कि इंटेल CPUs और एकीकृत GPUs को भी कवर करने वाले एक ही वर्कफ़्लो के माध्यम से मॉडल को अनुकूलित और तैनात करने के लिए डिज़ाइन किया गया था - यह तथ्य कि यह एक टूलचेन के रूप में बना हुआ है, न कि एक अलग उत्पाद के रूप में, इंटेल की शान है। एकल एक्सेलेरेटर चिप से जुड़ा होना, हार्डवेयर की पीढ़ियों में तेजी से बदलाव आने वाले क्षेत्र में जीवित रहने की एक रणनीति को दर्शाता है।
इतिहास: एज टीपीयू, डेटासेंटर टीपीयू वंश का उत्तराधिकारी
गूगल कोरल उत्पादों में मौजूद एज टीपीयू, बिजली की कमी वाले एम्बेडेड उपकरणों के लिए, उसी "सिस्टोलिक ऐरे" कंप्यूटिंग आर्किटेक्चर का छोटा रूप है जिसे गूगल ने अपने डेटासेंटर-श्रेणी के टीपीयू (टेन्सर प्रोसेसिंग यूनिट) के लिए बनाया था। एक सिस्टोलिक ऐरे बड़ी संख्या में मल्टीप्लाई-एक्यूमुलेट इकाइयों को एक ग्रिड में व्यवस्थित करता है और डेटा को एक दिशा में प्रवाहित करता है, इसे केवल आसन्न इकाइयों के बीच ही पास करता है। एक सामान्य-उद्देश्यीय सीपीयू के विपरीत, जिसे प्रत्येक निर्देश के लिए रजिस्टरों और मेमोरी तक पहुंचना होता है, यह इसे अत्यधिक ऊर्जा दक्षता पर बड़े मैट्रिक्स गुणन को पूरा करने की अनुमति देता है। गूगल के डेटासेंटर टीपीयू इस ग्रिड को विशाल पैमाने पर बनाते हैं, तरल-शीतित तांबे के हीट स्प्रेडर से सुसज्जित एक बोर्ड पर कई चिप्स लगाते हैं (गूगल द्वारा जारी की गई नीचे दी गई तस्वीर में एक टीपीयू v3 बोर्ड दिखाया गया है जिसमें चार चिप्स तरल-शीतित ट्यूबों द्वारा स्पष्ट रूप से जुड़े हुए हैं)। एज टीपीयू इसी मूल विचार को बरकरार रखता है लेकिन यह ग्रिड को काफी हद तक छोटा कर देता है और बिजली की खपत को एकल-अंकीय वाट तक कम कर देता है, जिससे यह यूएसबी बस या एम.2 स्लॉट के पावर बजट के भीतर चल सकता है।
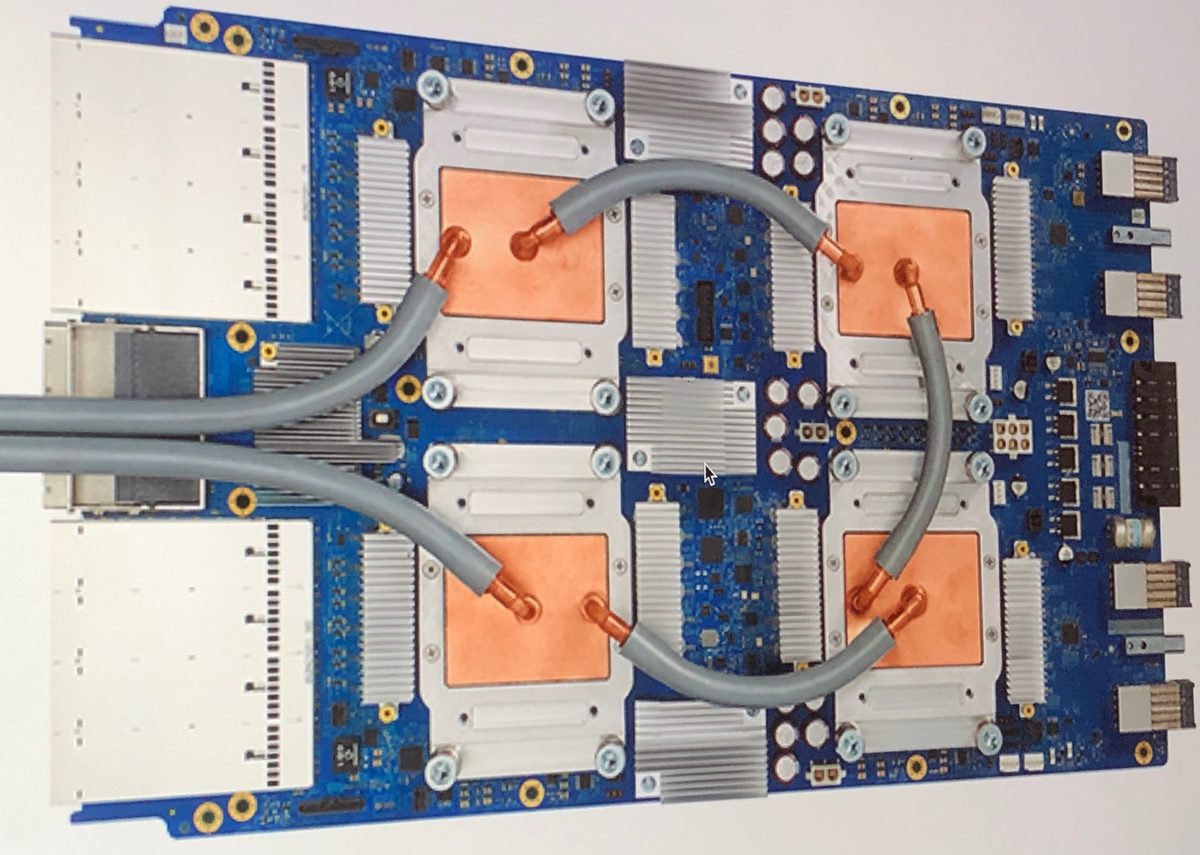
छवि: Tensor Processing Unit 3.0(Zinskauf, CC BY-SA 4.0), विकिमीडिया कॉमन्स। डेटासेंटर-क्लास TPU v3 का एक बोर्ड फोटो — एज TPU स्वयं नहीं, बल्कि डेटासेंटर "पैरेंट" के पैमाने को दर्शाने वाला एक संदर्भ जो समान सिस्टोलिक-एरे दृष्टिकोण साझा करता है।

2019 में, Google ने इस एज TPU (4 TOPS, 2W) को ले जाने वाला Dev Board और USB Accelerator लॉन्च किया, और इसने एक लोकप्रिय उत्पाद के रूप में लोकप्रियता हासिल की। Raspberry Pi जैसे मौजूदा SBC के लिए एक ऐड-ऑन एक्सेलेरेटर, जो बिजली की बचत करने वाले इन्फरेंस द्वारा समर्थित है और MobileNet v2 को लगभग 400 फ्रेम प्रति सेकंड की गति से चला सकता है। हालांकि, तब से Google ने कोई उल्लेखनीय नया हार्डवेयर जारी किए बिना इस उत्पाद श्रृंखला में निवेश करना लगभग बंद कर दिया है, और 2026 तक इसकी आधिकारिक coral.ai साइट एक सामान्य Google डेवलपर्स पेज पर रीडायरेक्ट हो जाती है। इसके बावजूद Coral उत्पादों का उपयोग पूरी तरह से बंद न होने का कारण यह है कि Google ने ड्राइवर और फर्मवेयर को ओपन सोर्स के रूप में जारी किया, जिससे Frigate NVR जैसे ऑब्जेक्ट-डिटेक्शन सर्विलांस सॉफ्टवेयर जैसे सामुदायिक प्रोजेक्ट्स को इसका समर्थन प्राप्त करने और हार्डवेयर को उत्पादन में बनाए रखने में मदद मिली (इसका विस्तृत विवरण SBC तुलना लेख में दिया गया है)।
वास्तविक दुनिया का उदाहरण: Skydio X2 ड्रोन पर लगे एक Jetson TX2 चिप पर एक साथ चल रहे नौ न्यूरल नेटवर्क
एकल एक्सेलेरेटर चिप द्वारा समानांतर रूप से कई न्यूरल नेटवर्क चलाने का एक प्रमुख उदाहरण स्वायत्त उड़ान ड्रोन Skydio X2/X2D है। X2 एक जेटसन TX2 में इस्तेमाल होने वाला वही SoC, NVIDIA Tegra X2, इसके मुख्य कंप्यूटिंग चिप के रूप में काम करता है। यह छह ऑनबोर्ड कैमरों (तीन स्टीरियो जोड़े, एक ट्रिनोकुलर कॉन्फ़िगरेशन) से प्राप्त डेटा को प्रोसेस करके नौ विशेष रूप से डिज़ाइन किए गए डीप न्यूरल नेटवर्क को एक साथ, पूरी तरह से ऑनबोर्ड ही चलाता है। इन इन्फ़रेंस आउटपुट का उपयोग करके, यह एक साथ 20 तक महत्वपूर्ण वस्तुओं (बाधाओं, लोगों या वाहनों जैसे विषयों) को ट्रैक कर सकता है, साथ ही एक 3D वर्ल्ड मॉडल का निर्माण करता है जिसे प्रति सेकंड दस लाख से अधिक बिंदुओं की दर से अपडेट किया जाता है। इस वर्ल्ड मॉडल को उड़ान कमांड में बदलने वाला डिसीजन लूप 500 हर्ट्ज़ की दर से चलता है। यह घने जंगलों या इनडोर स्थानों में GPS पर निर्भर किए बिना बाधाओं से बचते हुए तेजी से उड़ान भर सकता है, इसका कारण यह है कि यह पूरी प्रक्रिया क्लाउड पर लोड होने के बजाय, ऑनबोर्ड मौजूद एक ही Tegra X2 चिप पर पूरी होती है।

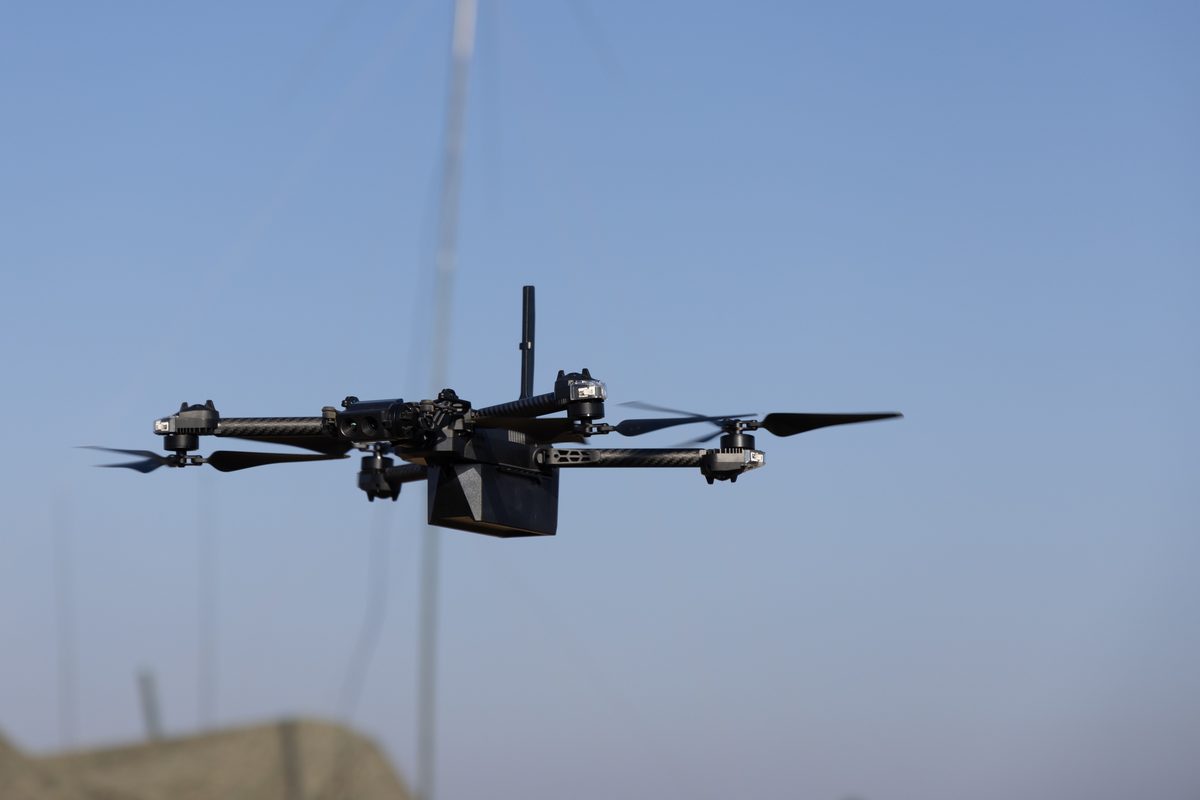
Images: Skydio X2D inspecting aircraft(Mauricio Campino, Public domain) / U S Marines Practice UAS Operations (9269101)(Public domain, U.S. Marine Corps), both via Wikimedia Commons.


X2D पदनाम रक्षा विभाग के संस्करण को संदर्भित करता है, और सार्वजनिक रूप से जारी की गई अमेरिकी रक्षा विभाग की तस्वीरों में दर्ज वास्तविक तैनाती में डेलावेयर के डोवर वायु सेना अड्डे पर 436वीं मिशन जेनरेशन ग्रुप द्वारा KC-10 एक्सटेंडर हवाई ईंधन भरने वाले विमान की संरचनात्मक अखंडता का निरीक्षण करने के लिए X2D का उपयोग करना (नवंबर 2022), साथ ही ओकिनावा के कैंप श्वाब में प्रशिक्षण ले रही 5वीं वायु-नौसेना गनफायर संपर्क कंपनी (5वीं ANGLICO) और जर्मनी के होहेनफेल्स प्रशिक्षण क्षेत्र में प्रशिक्षण ले रही 10वीं माउंटेन डिवीजन शामिल हैं, दोनों ही Skydio X2D को एक छोटे मानवरहित विमान प्रणाली (sUAS) के रूप में संचालित कर रहे हैं। इसका उत्तराधिकारी, X10, टेग्रा X2 से जेटसन ओरिन पीढ़ी के SoC पर चला गया है और इसके नेविगेशन कैमरों को 32 मेगापिक्सल तक अपग्रेड किया गया है - यह इस बात का एक अच्छा उदाहरण है कि कैसे प्रति-चिप TOPS में पीढ़ी दर पीढ़ी होने वाली वृद्धि सीधे तौर पर वास्तविक परिचालन लाभों में तब्दील होती है: एक साथ अधिक न्यूरल नेटवर्क चल सकते हैं, एक साथ अधिक वस्तुओं को ट्रैक किया जा सकता है, और निर्णय लेने की प्रक्रिया उच्च आवृत्ति वाली हो जाती है।
शौकिया"AI उपकरण" से ऑन-डिवाइस प्रशिक्षण के क्षेत्र में अग्रणी
जीपीयू-एकीकृत एक्सेलेरेटर, जो कभी रोबोटिक्स और रक्षा अनुप्रयोगों पर केंद्रित थे, 2026 तक व्यक्तिगत और छोटे पैमाने के डेवलपर्स तक भी पहुंचने लगे हैं। बुल्गारिया की ID Robots द्वारा निर्मित "ClawBox" एक AI सहायक हार्डवेयर उपकरण है जिसमें NVIDIA Jetson Orin Nano चिप लगी है, और यह हथेली के आकार के एक आवरण में रखा गया है जिसमें एक कूलिंग फैन और साइड वेंटिलेशन है - यह उसी SoM का पुन: उपयोग करता है जिसे मूल रूप से रोबोटिक्स कार्यभार के लिए डिज़ाइन किया गया था। ड्रोन या औद्योगिक रोबोट के "मस्तिष्क" के रूप में डिज़ाइन की गई चिप को सीधे किसी छोटे स्टार्टअप द्वारा निर्मित ऐसे उत्पाद में डाला जा सकता है जिसकी सैकड़ों या कुछ हज़ार इकाइयाँ ही बिकती हैं। यह तथ्य GPU-एकीकृत एक्सेलरेटर की व्यापकता को रेखांकित करता है — एक समर्पित ASIC के विपरीत, ये किसी भी CUDA मॉडल को सीधे चला सकते हैं।
दूसरा, संबंधित रुझान यह है कि शोध उस एज एक्सेलरेटर को, जो पहले केवल अनुमान-आधारित था, ऑन-डिवाइस प्रशिक्षण की ओर ले जा रहा है — यानी मॉडल को सीधे डिवाइस पर पुनः प्रशिक्षित करना। जुलाई 2026 में प्रकाशित एक शोध पत्र, "Empowering On-Device Model Adaptation with an Edge AI Inference Accelerator" (Piechocki, Capotondi, Kraft, arXiv:2607.18101), Hailo-8L (ऊपर वर्णित Hailo-8 का एक निम्न-स्तरीय संस्करण) का उपयोग करते हुए एक पाइपलाइन का प्रस्ताव करता है जो चिप्स के बीच इन्फरेंस और ट्रेनिंग कार्य को विभाजित करता है: क्वांटाइज्ड बैकबोन का इन्फरेंस Hailo-8L पर चलता है, जबकि केवल हल्के अंतिम लेयर्स को CPU पर FP32 में धीरे-धीरे फाइन-ट्यून किया जाता है। शोध पत्र में Raspberry Pi 5 की तुलना में ऑन-डिवाइस ट्रेनिंग के लिए 15.4 गुना तक वॉल-क्लॉक स्पीडअप की रिपोर्ट दी गई है - यह शोध के उस नए क्षेत्र की एक झलक है जहां "केवल इन्फरेंस" की मूल अवधारणा कमजोर पड़ने लगी है, जो क्वांटाइजेशन और ग्राफ कंपाइलेशन की समान अंतर्निहित प्रौद्योगिकी स्टैक पर आधारित है।
शौकिया "AI उपकरण" से ऑन-डिवाइस प्रशिक्षण के क्षेत्र में अग्रणी
जीपीयू-एकीकृत एक्सेलेरेटर, जो कभी रोबोटिक्स और रक्षा अनुप्रयोगों पर केंद्रित थे, 2026 तक व्यक्तिगत और छोटे पैमाने के डेवलपर्स तक भी पहुंचने लगे हैं। बुल्गारिया की ID Robots द्वारा निर्मित "ClawBox" एक AI सहायक हार्डवेयर उपकरण है जिसमें NVIDIA Jetson Orin Nano चिप लगी है, और यह हथेली के आकार के एक आवरण में रखा गया है जिसमें एक कूलिंग फैन और साइड वेंटिलेशन है - यह उसी SoM का पुन: उपयोग करता है जिसे मूल रूप से रोबोटिक्स कार्यभार के लिए डिज़ाइन किया गया था। ड्रोन या औद्योगिक रोबोट के "मस्तिष्क" के रूप में डिज़ाइन की गई चिप को सीधे किसी छोटे स्टार्टअप द्वारा निर्मित ऐसे उत्पाद में डाला जा सकता है जिसकी सैकड़ों या कुछ हज़ार इकाइयाँ ही बिकती हैं। यह तथ्य GPU-एकीकृत एक्सेलरेटर की व्यापकता को रेखांकित करता है — एक समर्पित ASIC के विपरीत, ये किसी भी CUDA मॉडल को सीधे चला सकते हैं।
दूसरा, संबंधित रुझान यह है कि शोध उस एज एक्सेलरेटर को, जो पहले केवल अनुमान-आधारित था, ऑन-डिवाइस प्रशिक्षण की ओर ले जा रहा है — यानी मॉडल को सीधे डिवाइस पर पुनः प्रशिक्षित करना। जुलाई 2026 में प्रकाशित एक शोध पत्र, "Empowering On-Device Model Adaptation with an Edge AI Inference Accelerator" (Piechocki, Capotondi, Kraft, arXiv:2607.18101), Hailo-8L (ऊपर वर्णित Hailo-8 का एक निम्न-स्तरीय संस्करण) का उपयोग करते हुए एक पाइपलाइन का प्रस्ताव करता है जो चिप्स के बीच इन्फरेंस और ट्रेनिंग कार्य को विभाजित करता है: क्वांटाइज्ड बैकबोन का इन्फरेंस Hailo-8L पर चलता है, जबकि केवल हल्के अंतिम लेयर्स को CPU पर FP32 में धीरे-धीरे फाइन-ट्यून किया जाता है। शोध पत्र में Raspberry Pi 5 की तुलना में ऑन-डिवाइस ट्रेनिंग के लिए 15.4 गुना तक वॉल-क्लॉक स्पीडअप की रिपोर्ट दी गई है - यह शोध के उस नए क्षेत्र की एक झलक है जहां "केवल इन्फरेंस" की मूल अवधारणा कमजोर पड़ने लगी है, जो क्वांटाइजेशन और ग्राफ कंपाइलेशन की समान अंतर्निहित प्रौद्योगिकी स्टैक पर आधारित है।
प्रदर्शन निर्धारित करने वाले पैरामीटर
- TOPS/W दक्षता बनाम परिशुद्धता लचीलापन: कोरल एज टीपीयू 2 TOPS/W की उच्च दक्षता प्रदान करता है, लेकिन इसकी एक सीमा यह है कि यह केवल INT8 में पूर्व-क्वांटाइज़्ड निश्चित ग्राफ़ ही चला सकता है। इसके विपरीत, जेटसन ओरिन एनएक्स, कोरल के TOPS/W से कम प्रदर्शन करते हुए, FP16/INT8 के मिश्रण में किसी भी CUDA मॉडल को चला सकता है। चिप चयन में सबसे पहला निर्णय यही होता है कि कोई प्रोजेक्ट कितनी लचीलता को त्याग सकता है।
- कंपाइलर की कठोरता: कोरल एज टीपीयू कंपाइलर जैसा पूर्णतः निश्चित-ग्राफ़ कंपाइलर, जो किसी भी असमर्थित ऑपरेटर की अनुमति नहीं देता है, मॉडल डिज़ाइन को शुरू से ही समर्थित ऑपरेटरों तक सीमित कर देता है। TensorRT/OpenVINO जैसे पार्शियल-ऑफलोड कंपाइलर पोर्टिंग में अधिक लचीलापन प्रदान करते हैं, लेकिन CPU फॉलबैक ट्रिगर होने पर गति में होने वाली कमी को नज़रअंदाज़ करना आसान है।
- क्वांटाइजेशन विधि का चुनाव (PTQ बनाम QAT): PTQ, जिसे केवल थोड़ी मात्रा में प्रतिनिधि डेटा की आवश्यकता होती है, विकसित करने में सस्ता है, लेकिन कई आउटलायर्स वाले मॉडल पर सटीकता में अधिक हानि होने की संभावना होती है। QAT में एक रिट्रेनिंग पास की आवश्यकता होती है, लेकिन यह उस गिरावट को कम करता है। Movidius Myriad X पीढ़ी के VPU, जो मुख्य रूप से FP16 पर आधारित हैं, डिज़ाइन के अनुसार क्वांटाइजेशन के कैलिब्रेशन प्रयास को पूरी तरह से दरकिनार कर देते हैं।
- इंटरफ़ेस बैंडविड्थ: Coral USB एक्सेलेरेटर या NCS2 जैसे USB-कनेक्टेड डिवाइस कई इकाइयों को संयोजित करने पर होस्ट-साइड USB बस बैंडविड्थ की बाधा का सामना कर सकते हैं (इसका विस्तृत विवरण SBC तुलना लेख में Frigate NVR मामले में दिया गया है)। Hailo-8 या SoM-एकीकृत Jetson जैसे M.2/PCIe-कनेक्टेड डिवाइस इस बाधा से कम प्रभावित होते हैं।
- आपूर्ति निरंतरता और रोडमैप: इंटेल के Movidius NCS2 को उसके अपने स्पेसिफिकेशन पेज पर स्पष्ट रूप से "बंद" के रूप में चिह्नित किया गया है, और कोरल की आधिकारिक साइट अब कहीं और रीडायरेक्ट करती है, जबकि Jetson लाइन की नई पीढ़ियां लगातार भेजी जा रही हैं। किसी दीर्घकालिक परियोजना के लिए, आपूर्ति की निरंतरता स्वयं एक जोखिम कारक बन जाती है, जो कि प्रति डॉलर TOPS की एक बार की तुलना से कहीं अधिक महत्वपूर्ण है।
- मूल्य-प्रदर्शन अनुपात ($/TOPS): साधारण $/TOPS आधार पर, Jetson Orin Nano Super ($249/67 TOPS ≈ $3.7/TOPS) और Jetson Orin NX ($599/100 TOPS ≈ $6/TOPS) Hailo-8 ($110/26 TOPS ≈ $4.2/TOPS) या Coral ($75–99/4 TOPS ≈ $19–25/TOPS) की तुलना में सस्ते लग सकते हैं — लेकिन अंतिम चुनाव अभी भी उत्पाद के वास्तविक चेसिस आकार और पावर बजट के संतुलन पर निर्भर करता है, न कि केवल कच्चे प्रदर्शन और इकाई मूल्य पर।
क्या TOPS का दोगुना होने का मतलब एप्लिकेशन की गति का दोगुना होना है?
परिशुद्धता, मेमोरी, समर्थित ऑपरेटर, स्थानांतरण और प्रीप्रोसेसिंग गति को प्रभावित करते हैं।
वास्तविक मॉडल पर एंड-टू-एंड लेटेंसी मापें।
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।