Contents — find the section you need
人工智能推理加速器是一种专用于运行已训练神经网络“推理”阶段(即仅进行前向计算)的芯片,其能效远高于 CPU 或 GPU。其核心物理原理很简单:将以 32 位浮点数 (FP32) 训练的权重转换为低精度表示,例如 8 位整数 (INT8)(即量化),从而使相同的计算单元和内存带宽能够处理更多的并行操作。本文不比较单板计算机 (SBC) 等整体系统;而是专注于专门用于推理的加速器芯片的设计理念和量化原理,例如 Google Coral(Edge TPU)、Intel Movidius(Myriad X)和 NVIDIA Jetson Orin NX。
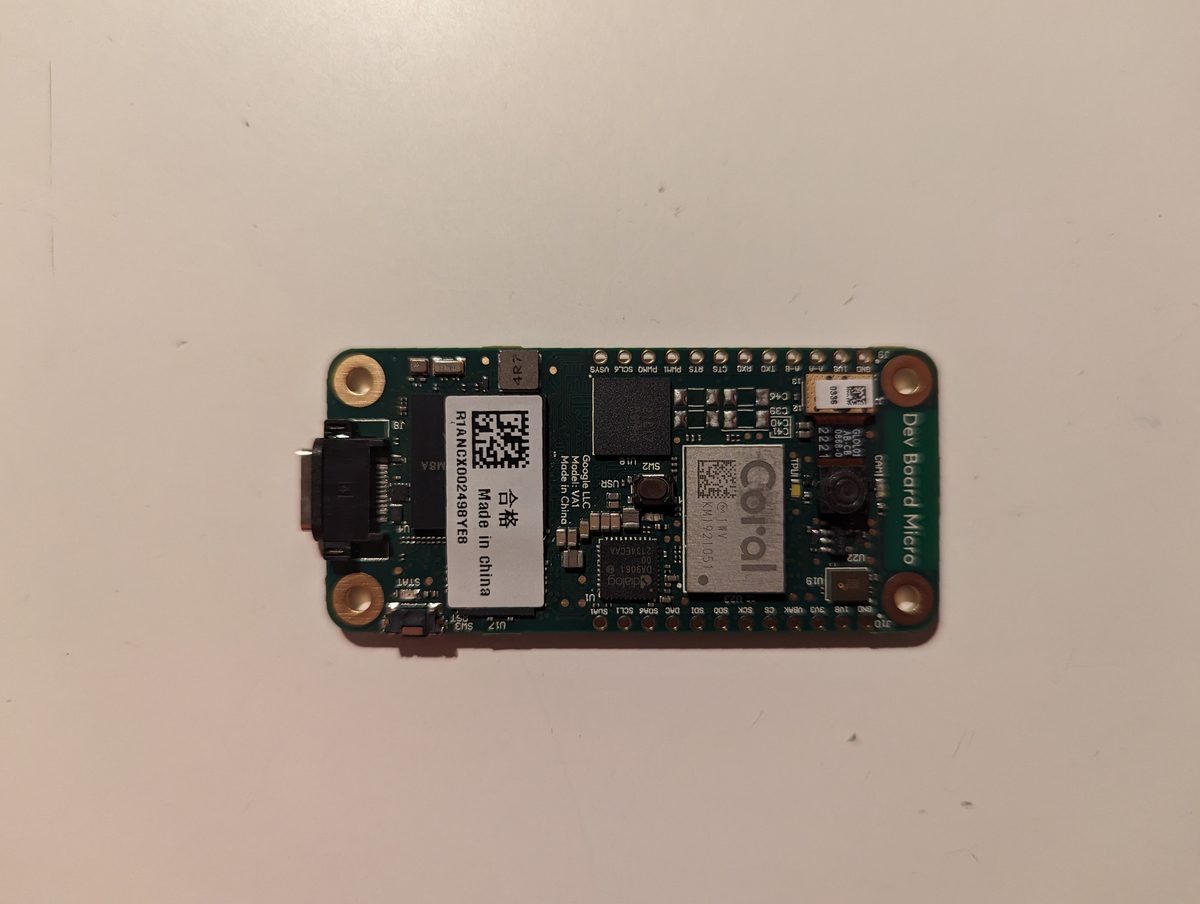 Google Coral Dev Board Micro
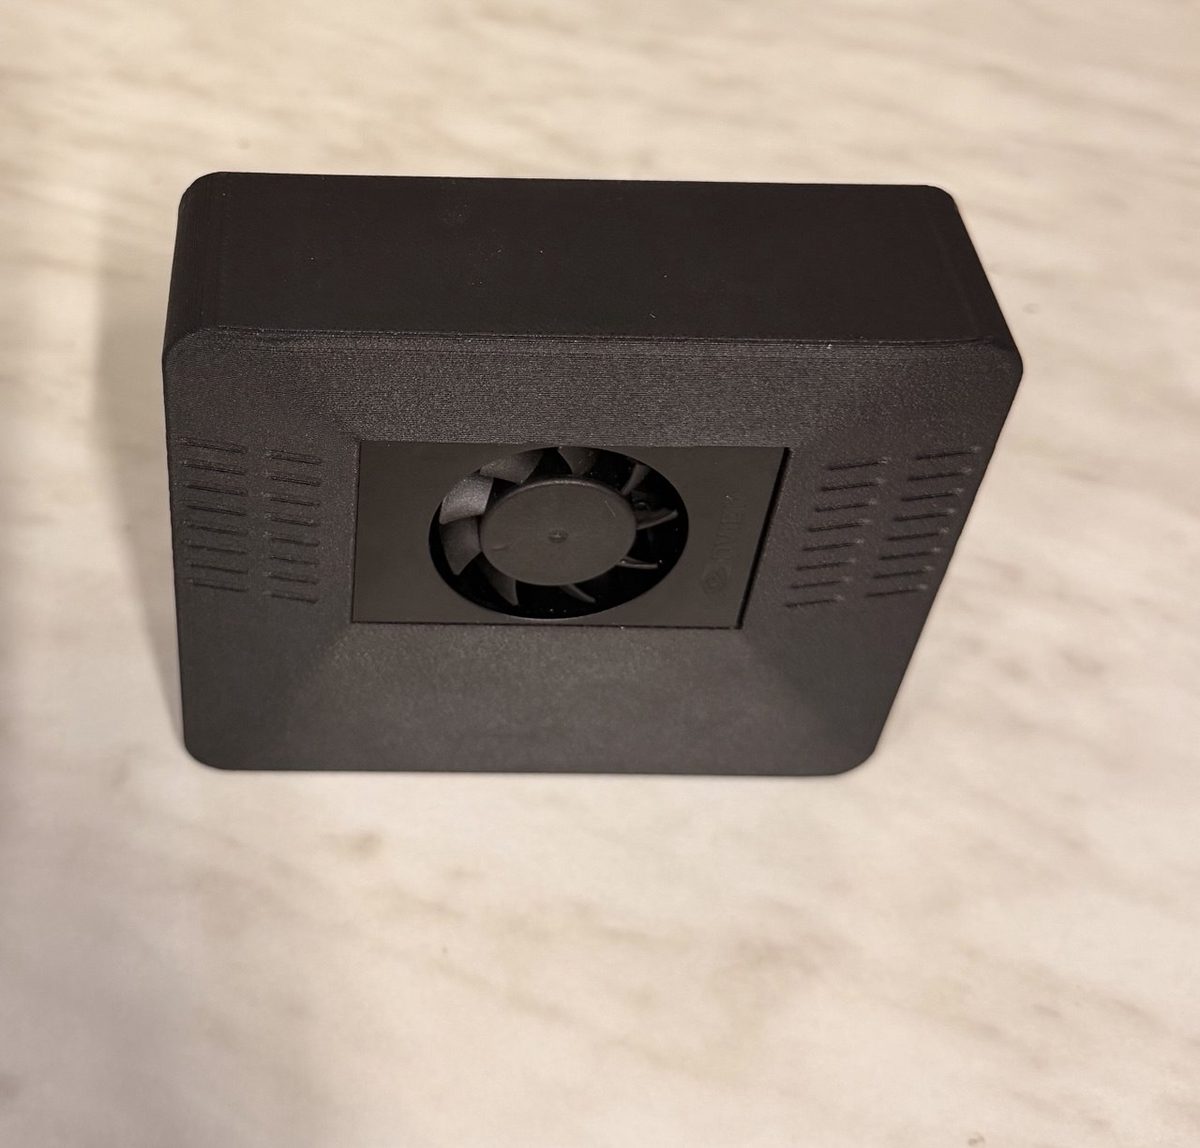 “ClawBox”,基于 NVIDIA Jetson Orin Nano(2026 年,ID Robots)构建
图片:Hardware PXL 20231201 152957218 (53388218926)(Thomas Amberg,CC BY-SA 2.0) / ClawBox AI 助手设备 (2026) - 正面(Kkralev, CC BY-SA 4.0),均来自 Wikimedia Commons。
.jpg)
_-_front.jpg)
原理:INT8 量化的实际作用
将 FP32 权重和激活值压缩到 8 位整数的最常用方法是线性(仿射)量化。将实数 x 转换为整数 q 的公式为:
其中,s 是缩放比例(一个整数步长的实数宽度),z 是零点(偏移量,用于指示哪个整数步长对应于实数零),b 是位宽(INT8 为 8)。在推理时,该值近似地恢复为 x \approx s(q-z)。这种量化在实践中意味着值分布的边界限制程度直接决定了精度损失的大小。在相同的 256 个步长(INT8)下,较窄的值范围会使每个步长的宽度(即量化误差)保持较小;而异常值导致范围扩大,则会使相同的 256 个步长变窄,从而粗略地表示构成分布主体的典型值。
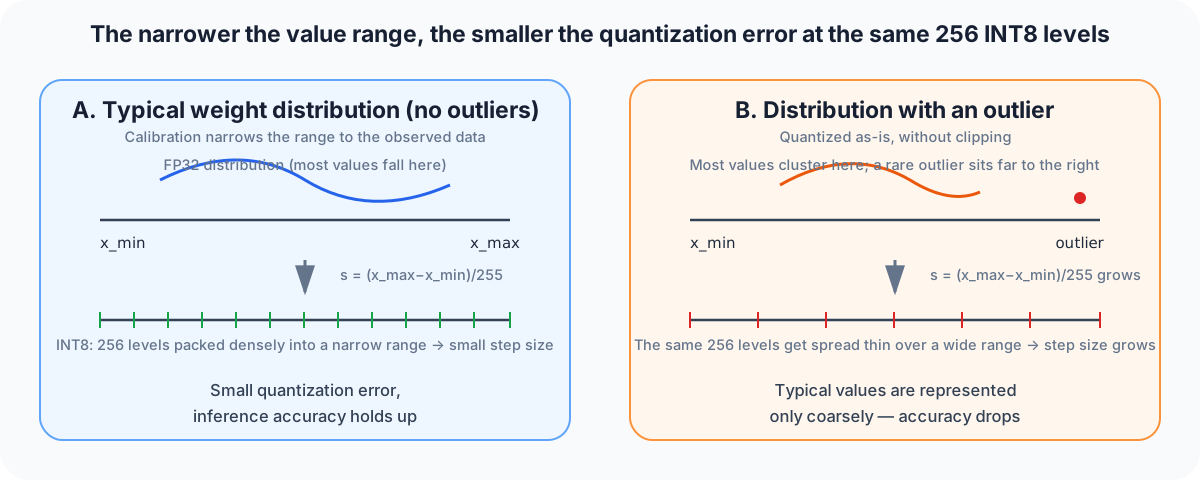
图表:Duskcoil。说明了“校准”(使用实际测量数据限定值范围)的存在与否如何显著影响量化误差,即使在相同的比特宽度下也是如此。
确定此值范围是校准步骤,量化大致遵循两种方法。训练后量化 (PTQ) 只是简单地将少量代表性数据输入到训练好的 FP32 模型中,并根据每一层的观测输出范围计算尺度 s——这是一种轻量级方法,但对于包含大量异常值的模型,容易造成较大的精度损失。量化感知训练 (QAT) 模拟量化引入的舍入误差。在训练过程中,会相应地更新权重;这可以抑制精度下降,但代价是需要重新训练一次。Edge TPU 编译器、TensorRT 和 OpenVINO 都支持这两种方法,但由于大多数边缘推理芯片在标明其产品目录性能(TOPS)时都假设使用 INT8 精度,因此实际的选择在于 PTQ 是否能提供足够的精度,或者是否需要切换到 QAT。
此外,还有一个问题:2017 年前后设计的 VPU(视觉处理单元),例如 Movidius Myriad X,使用 FP16(半精度浮点)而非 INT8 作为其主要计算精度。与 FP32 相比,FP16 的内存占用和带宽需求减半,同时由于保留了指数域,因此无需像 INT8 那样进行范围校准即可表示更宽的动态范围。然而,它的并行度达不到 INT8 的水平,这也是后来的 Coral Edge TPU 和 Jetson 的 Tensor Core 都基于 INT8 构建的原因之一。 INT8优先的专用数据路径,可显著提升TOPS/W性能。
原理:图编译器作为推理加速的第二个维度
除了量化之外,训练好的模型最终被编译成什么格式以适应特定芯片的指令集,是影响实际吞吐量的另一个主要因素。从TensorFlow Lite或ONNX导出的模型本身就是一个通用图,它会在CPU上逐层执行。每个厂商的编译器都会对该图应用大致三种优化。
-
算子融合:将卷积→批量归一化→ReLU等操作序列合并成一个融合内核,并将中间结果保存在寄存器中而不是写回内存,从而减少内存访问次数。
-
布局转换:CPU优先的NCHW(通道优先)布局和向量单元优先的NHWC(通道后置)布局会被重新选择,以匹配目标硬件的实际内存访问模式。
-
编译成固定格式图**:某些编译器,例如 Coral Edge TPU 编译器,只接受完全由受支持运算符构建的固定图,完全禁止动态形状或不支持的运算符。如果模型中出现哪怕一个不受支持的运算符,执行就会在 CPU 和它周围的 Edge TPU 之间进行分配,由此产生的双向数据传输成本会显著降低速度。
NVIDIA 的 TensorRT 和 Intel 的 OpenVINO 采用更灵活的“部分卸载”方法——将不受支持的运算符回退到 CPU,同时将其余运算符卸载到加速器——而 Coral Edge TPU 编译器则更接近于在完全受支持的图和完全不加速之间做出非此即彼的选择。这种区别不会体现在硬件指标上,例如SBC 对比文章中提到的 TOPS/内存带宽权衡——这是软件栈设计理念上的差异,并且会显著影响模型移植的实际成本。
主要芯片对比:Coral、Movidius、Jetson
| 产品 | 精度 | AI 性能 | 功耗 | 接口 | 价格 | |---|---|---|---|---|---|---| | Google Coral Edge TPU(USB 加速器)| 仅支持 INT8 | 4 TOPS (2 TOPS/W) | 2W | USB 3.0 | 约 75-99 美元(2019 年发布)| | Intel Movidius Myriad X(神经计算棒 2)| 主要支持 FP16 | 约 4 TOPS(无官方公布数据)| 约 1.5-2.5W | USB 3.0 | 约 79-99 美元(2018 年发布,现已停产)| | Hailo-8 (M.2) | INT8 | 26 TOPS (10.4 TOPS/W) | 约 2.5W | M.2/PCIe | 约 110 美元 | | NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS(MAXN Super 模式)| 7–25W | 系统模块 (SoM) | 249 美元 | | NVIDIA Jetson Orin NX (16GB) | INT8 | 100 TOPS | 10–25W | 系统模块 (SoM) | 599 美元 |
英特尔官方的 Movidius Myriad X 规格页面并未给出确切的 TOPS 数值,但多篇评测称其总运算速度“超过每秒 4 万亿次”,英特尔也表示 Myriad X 的速度比 Myriad 2(100–150 GFLOPS)快 10 倍以上。Myriad X 搭载了 16 个可编程的 SHAVE 矢量处理器核心以及神经计算引擎(一个首次应用于 Myriad X 的专用模块),旨在同时处理六个摄像头 720p(三对立体摄像头)60fps 的画面。Hailo-8 和 Jetson Orin Nano Super/NX 均包含在内。关于SBC对比文章的更详细内容,本文仅涵盖以上表格中的条目,以避免重复。
Coral产品线还包括Dev Board Micro,它是上文提到的USB加速器的衍生产品。它并非采用支持Linux的应用处理器,而是将Edge TPU协处理器与始终开启的低功耗微控制器(MCU)级开发板相结合,专门针对电池供电的TinyML应用场景,例如始终监听的语音或振动检测。Dev Board/USB加速器将通用SoC与外部Edge TPU相结合,而Dev Board Micro则面向完全不同的应用场景:始终开启的检测触发器。
历史:源于英特尔收购Movidius的VPU设计理念
Movidius是一家位于圣马特奥的初创公司,专门设计用于计算机视觉处理的低功耗芯片,于2016年9月被英特尔收购。其收购前的Myriad 2 VPU (视觉处理单元)并没有采用通用CPU的设计;相反,它将专用的计算机视觉硬件模块与12个定制设计的矢量处理器核心(SHAVE)相结合。收购后,它被应用于包括谷歌生活记录相机“Clips”、FLIR热成像相机“Firefly”、大疆“Phantom 4”无人机和腾讯“DeepGaze”在内的众多量产设备中。其继任者Myriad X于2017年发布,将SHAVE核心数量扩展到16个,并首次加入了用于神经网络推理的专用硬件模块——神经计算引擎,其性能是Myriad 2的10倍以上,峰值运算能力超过1万亿次浮点运算/秒(1 teraFLOPS)。上文提到的神经计算棒2(NCS2)是一款USB产品,内置单个Myriad X芯片,于2018年第四季度发布;英特尔的产品规格页面现在将其标记为“已停产”——这款VPU芯片曾代表了早期技术的发展。边缘人工智能(Edge AI)的市场份额逐渐被后来的 INT8 专用 ASIC 和集成 GPU 的芯片所取代。
伴随此次收购,英特尔于 2018 年 5 月 16 日发布了首个版本的 OpenVINO 工具包,该工具包是一个软件栈,旨在统一处理其硬件上的量化和图优化。OpenVINO 的 NNCF(神经网络压缩框架)组件负责 INT8 量化和模型压缩,其设计目标是通过单一工作流程优化和部署模型,该工作流程不仅适用于 Movidius 系列 VPU,还适用于英特尔 CPU 和集成 GPU。它能够作为一个工具链而非与单一加速器芯片绑定而存续下来,这体现了在硬件快速更迭的领域中一种有效的生存策略。
历史:边缘 TPU,数据中心 TPU 的继承者
谷歌 Coral 产品中的边缘 TPU 是一种针对功耗受限的嵌入式设备而设计的架构,它将谷歌为其数据中心构建的“脉动阵列”计算架构进行了缩减。数据中心级 TPU(张量处理单元)。脉动阵列将大量乘加单元排列成网格状,并沿单向传输数据,数据仅在相邻单元之间传递——与通用 CPU 不同,后者每条指令都必须访问寄存器和内存,这使得 TPU 能够以极高的能效完成大型矩阵乘法运算。谷歌的数据中心级 TPU 以惊人的规模构建了这种网格,将多个芯片安装在配备液冷铜散热片的电路板上(下图由谷歌发布,展示了一块 TPU v3 电路板,其中四个芯片通过液冷管清晰可见地连接在一起)。Edge TPU 沿用了相同的基本理念,但大幅缩小了网格尺寸,并将功耗降低到个位数瓦,因此可以在 USB 总线或 M.2 插槽的功耗范围内运行。
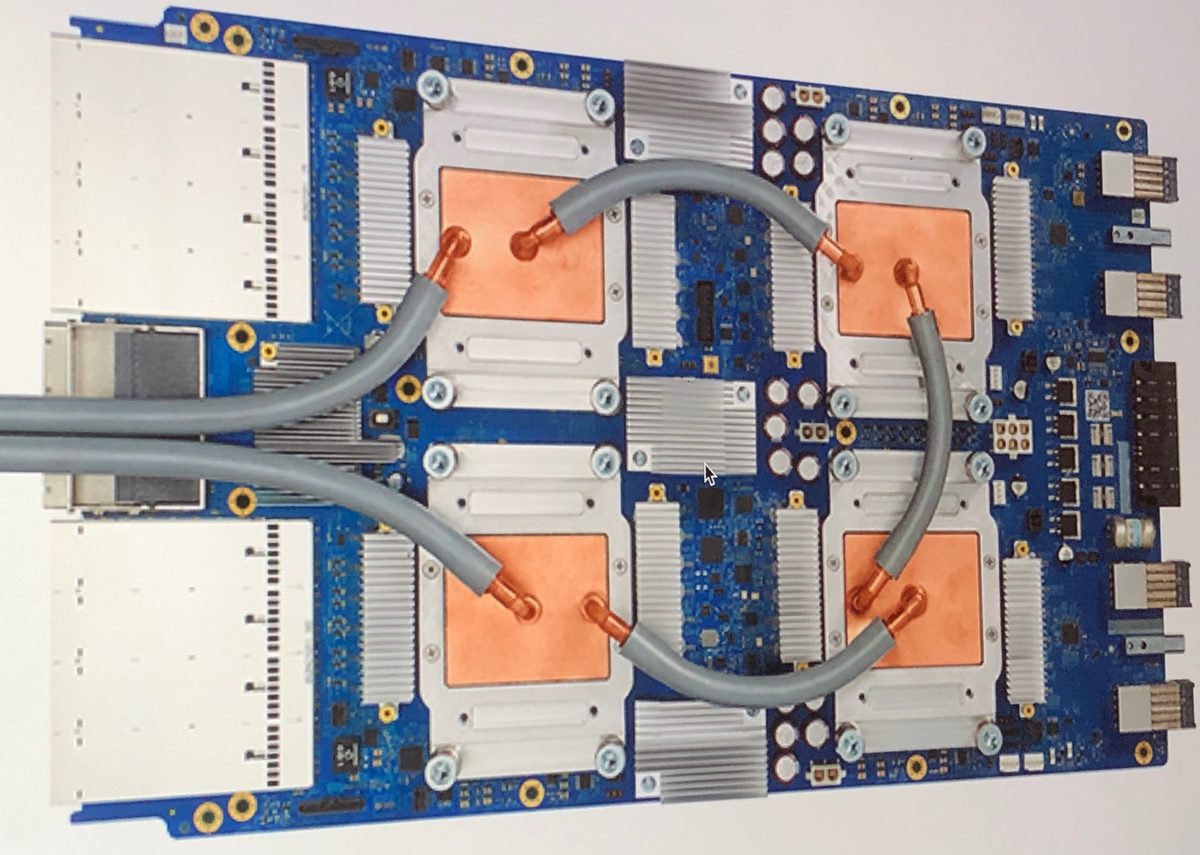
图片:Tensor Processing Unit 3.0(Zinskauf, CC BY-SA 4.0), Wikimedia Commons。数据中心级 TPU v3 的电路板照片——并非 Edge TPU 本身,而是用于展示采用相同脉动阵列架构的数据中心“父级”的规模。

2019 年,谷歌推出了搭载这款 Edge TPU(4 TOPS,2W)的开发者板和 USB 加速器,它作为树莓派等现有单板计算机的附加加速器而广受欢迎,其高效节能的推理能力使其能够以大约每秒 400 帧的速度运行 MobileNet v2。然而,自那以后,谷歌实际上已经停止了对该产品线的投资,也没有推出任何值得关注的新硬件。截至 2026 年,其官方网站 coral.ai 已重定向到通用的 Google Developers 页面。Coral 产品之所以没有完全消失,原因在于……尽管如此,谷歌开源了驱动程序和固件,使得像 Frigate NVR 这样的目标检测监控软件等社区项目能够获得支持,并保证该硬件在生产环境中继续运行(详情请参阅SBC 对比文章)。
实际案例:Skydio X2 无人机搭载的 Jetson TX2 芯片同时运行九个神经网络
Skydio X2/X2D 是一款利用单颗加速芯片并行运行多个神经网络的典型案例。X2 搭载了 NVIDIA Tegra X2 芯片(与 Jetson TX2 相同)作为其主计算芯片,处理来自六个机载摄像头(三对立体摄像头,三目配置)的画面,从而在机载端同时运行九个定制设计的深度神经网络。利用这些推理输出,它可以同时追踪多达 20 个感兴趣的目标——障碍物、行人或车辆等——并构建一个 3D 世界模型,更新频率超过一百万次。每秒采集点数,并将该世界模型转化为飞行指令的决策回路以 500 Hz 的频率运行。它之所以能够在茂密的森林或室内空间快速飞行并避开障碍物而无需依赖 GPS,是因为整个流程都在机载的单个 Tegra X2 上完成,而不是卸载到云端。
 Skydio X2D 检查 KC-10 加油机(多佛空军基地)
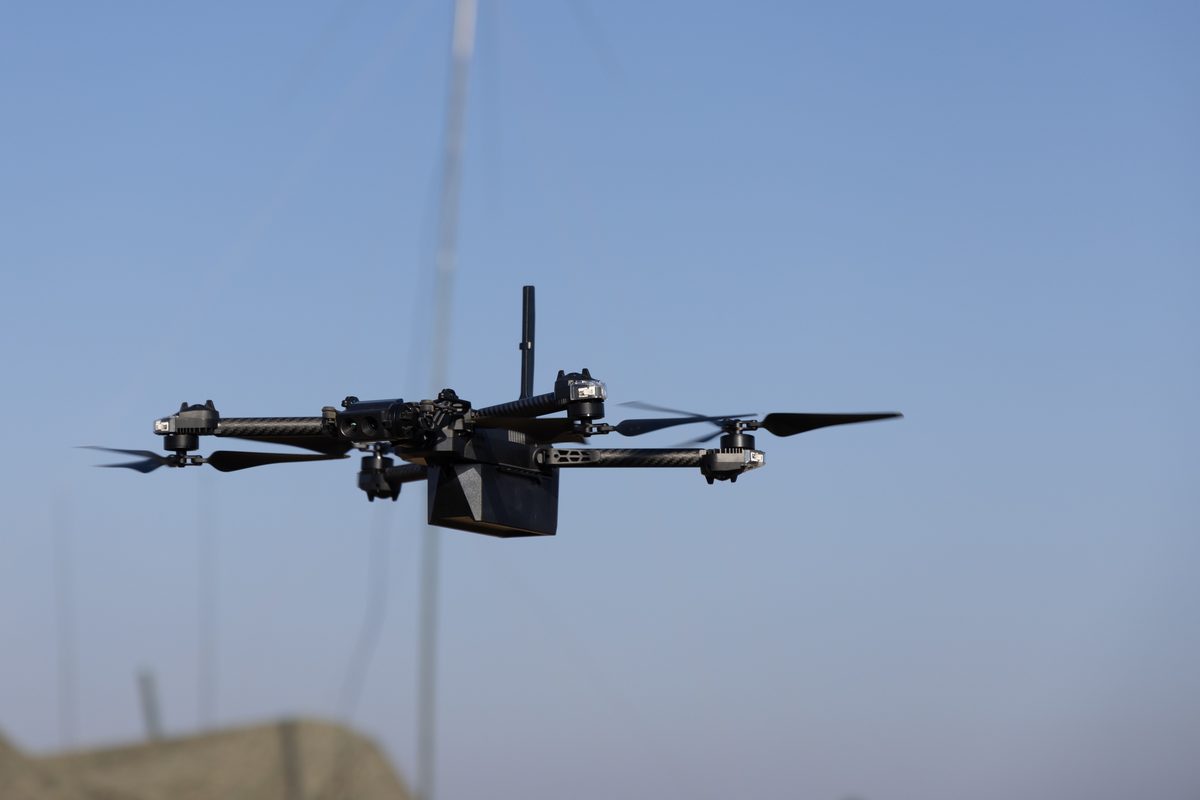 一架 Skydio X2D 无人机正在训练中飞行(冲绳施瓦布营地)
图片:Skydio X2D 检查飞机(Mauricio Campino,公共领域)/ 美国海军陆战队练习无人机系统操作 (9269101)(公共领域,美国海军陆战队),均来自 Wikimedia Commons。

.jpg)
X2D 指的是美国国防部的型号。美国国防部公开的照片记录了该型号的实际部署情况,包括:2022 年 11 月,特拉华州多佛空军基地的第 436 任务生成大队使用 X2D 检查 KC-10 Extender 空中加油机的结构完整性;以及第 5 空海炮火部队。驻冲绳施瓦布营地的第5空中导航联络连和驻德国霍亨费尔斯训练场的第10山地师均使用Skydio X2D作为小型无人机系统(sUAS)。其后续型号X10从Tegra X2升级到Jetson Orin一代SoC,并将导航摄像头升级到3200万像素——这很好地说明了芯片性能的逐代提升如何直接转化为实际的作战优势:更多的神经网络可以同时在机载上运行,可以同时跟踪更多的目标,以及更高的决策循环频率。
从业余爱好者的“人工智能设备”到设备端训练的前沿
曾经主要面向机器人和国防应用的GPU集成加速器,到2026年也将开始惠及个人和小规模开发者。由保加利亚ID Robots公司开发的“ClawBox”是一款人工智能助手硬件设备,它搭载了NVIDIA Jetson Orin Nano,并被封装在一个掌上大小的外壳中,配备散热风扇和侧面通风口——它直接沿用了最初为机器人工作负载设计的系统级模块(SoM)。这款原本设计用于无人机或工业机器人的“大脑”芯片,如今却能被一家小型初创公司直接集成到一款产量达数百甚至数千台的产品中,这凸显了GPU集成加速器的通用性优势——与专用ASIC芯片不同,它们可以直接运行任意CUDA模型。
另一个相关的趋势是,研究正推动原本纯粹用于推理的边缘加速器向设备端训练方向发展——即直接在设备上重新训练模型。 2026 年 7 月发表的论文《利用边缘 AI 推理加速器赋能设备端模型自适应》(Piechocki、Capotondi 和 Kraft,arXiv:2607.18101)提出了一种使用 Hailo-8L(上文讨论的 Hailo-8 的低层版本)的流水线,将推理和训练工作分配到不同的芯片上:量化骨干网络的推理在 Hailo-8L 上运行,而只有轻量级的最终层在 CPU 上以 FP32 格式进行增量微调。该论文报告称,与仅使用 Raspberry Pi 5 相比,设备端训练的实际运行速度提升高达 15.4 倍——这让我们得以窥见一个研究前沿,在这个前沿领域,“仅推理”的前提正开始瓦解,而这一切都建立在量化和图编译的底层技术栈之上。
决定性能的参数
-
TOPS/W 效率与精度灵活性:Coral Edge TPU 的效率高达 2 TOPS/W,但其限制在于只能运行预先量化为 INT8 的固定图。相比之下,Jetson Orin NX 可以运行任意 FP16/INT8 混合精度的 CUDA 模型,但代价是 TOPS/W 低于 Coral。项目能够承受多大的灵活性损失通常是芯片选择时首先要考虑的问题。
-
编译器严格性:像 Coral Edge TPU 编译器这样的完全固定图编译器不允许使用任何不支持的运算符,这迫使模型设计从一开始就必须使用受支持的运算符。像 TensorRT/OpenVINO 这样的部分卸载编译器提供了更大的移植灵活性,但很容易忽略触发 CPU 回退时出现的速度损失。
-
量化方法的选择(PTQ 与 QAT):PTQ 只需要少量代表性数据,开发成本低,但对于异常值较多的模型,其精度损失较大。QAT 需要一次重新训练,但可以抑制这种精度下降。Movidius Myriad X 系列的 VPU 主要基于 FP16 构建,其设计完全绕过了量化校准工作。
-
接口带宽:像 Coral USB Accelerator 或 NCS2 这样的 USB 连接设备,在多个设备组合使用时,可能会遇到主机端 USB 总线带宽瓶颈(详见 SBC 对比文章 中的 Frigate NVR 案例)。像 Hailo-8 这样的 M.2/PCIe 连接设备,或者集成了 SoM 的 Jetson 设备,受此限制的影响较小。
-
供应连续性和路线图:英特尔 Movidius NCS2 在其规格页面上已明确标明“已停产”,Coral 的官方网站也已重定向到其他页面,而 Jetson 产品线仍在持续推出新一代产品。对于长期项目而言,供应的连续性本身就成为一项风险因素,而不仅仅是一次性的每美元TOPS的比较。
-
性价比 (美元/TOPS):仅从美元/TOPS的角度来看,Jetson Orin Nano Super (249美元/67 TOPS ≈ 3.7美元/TOPS) 和 Jetson Orin NX (599美元/100 TOPS ≈ 6美元/TOPS) 看起来比 Hailo-8 (110美元/26 TOPS ≈ 4.2美元/TOPS) 或 Coral (75-99美元/4 TOPS ≈ 19-25美元/TOPS) 更便宜——但最终的选择仍然取决于产品实际能够容纳的机箱尺寸和功耗预算之间的平衡,而不仅仅是原始性能和单价。
TOPS 翻倍是否意味着应用程序速度翻倍?
精度、内存、支持的运算符、传输和预处理都会影响速度。在实际模型上测量端到端延迟。


评论
请先登录。
暂无数据。