Contents — find the section you need
AI 추론 가속기는 학습된 신경망의 "추론" 단계, 즉 순방향 연산만을 CPU나 GPU보다 훨씬 높은 에너지 효율로 실행하도록 특별히 설계된 칩입니다. 핵심적인 물리적 원리는 간단합니다. 32비트 부동 소수점(FP32)으로 학습된 가중치를 8비트 정수(INT8)와 같은 저정밀 표현으로 변환하는 양자화 과정을 통해 동일한 연산 장치와 메모리 대역폭으로 훨씬 더 많은 병렬 연산을 처리할 수 있습니다. 이 글에서는 SBC(싱글보드 컴퓨터) 전체 시스템을 비교하는 것이 아니라, 추론 전용 가속기 칩인 Google Coral(Edge TPU), Intel Movidius(Myriad X), 그리고 NVIDIA Jetson Orin NX의 설계 철학과 양자화 원리에 초점을 맞춥니다.
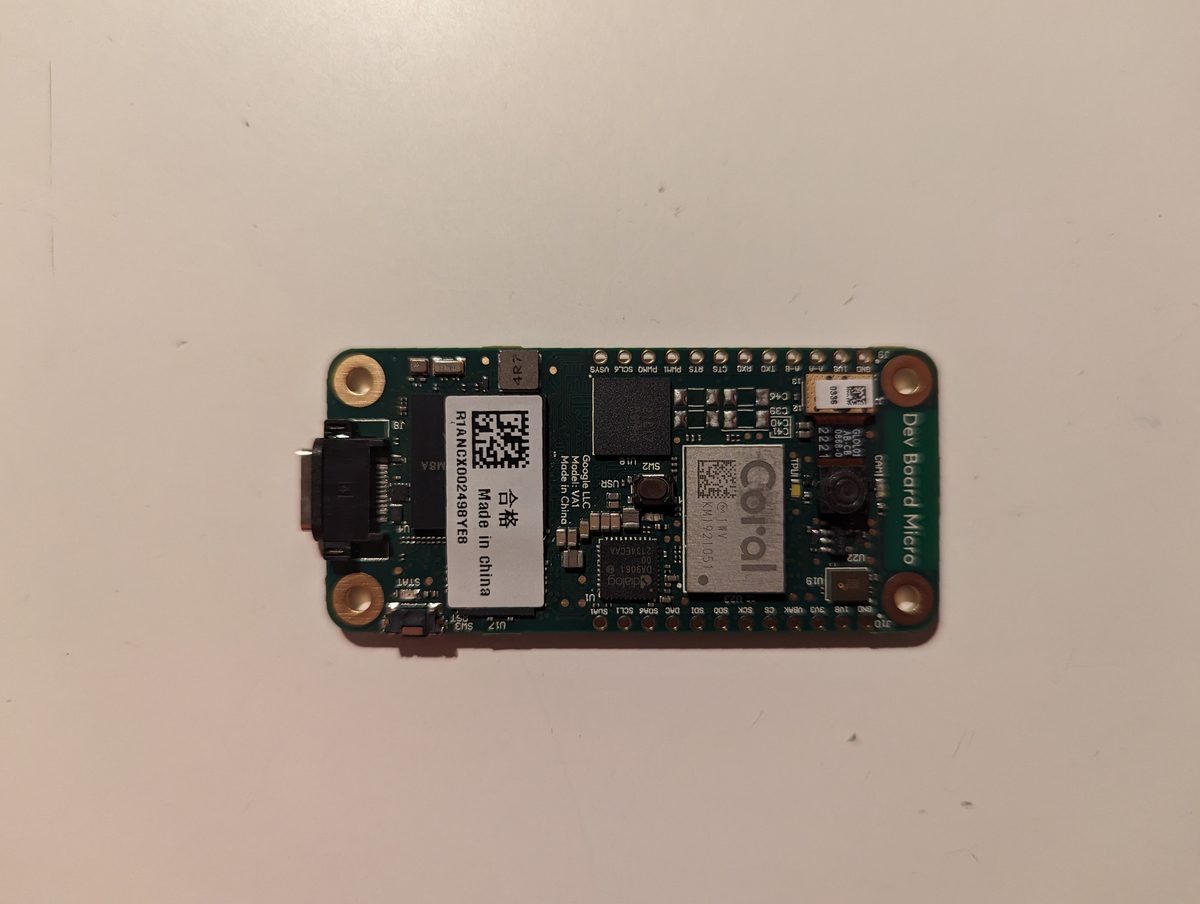 Google Coral Dev Board Micro
 "ClawBox", NVIDIA Jetson Orin Nano(2026, ID Robots) 기반
이미지: 하드웨어 PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA 2.0) / ClawBox AI 비서 장치(2026) - 전면(Kkralev, CC BY-SA 4.0), Wikimedia Commons 제공.
.jpg)
_-_front.jpg)
원리: INT8 양자화의 실제 작동 방식
FP32 가중치와 활성화 값을 8비트 정수로 변환하는 가장 일반적인 방법은 선형(아핀) 양자화입니다. 실수 값 x를 정수 q로 변환하는 공식은 다음과 같습니다.
여기서 s은 스케일(한 정수 단계의 실수 값 너비), z은 0점(실수 0에 해당하는 정수 단계를 나타내는 오프셋), b는 비트 너비(INT8의 경우 8)입니다. 추론 시점에 값은 대략 x \approx s(q-z)으로 복원됩니다. 실제로 이 양자화는 값 분포를 얼마나 좁게 제한할 수 있느냐에 따라 정확도 손실이 결정된다는 것을 의미합니다. 동일한 256단계(INT8)를 사용할 경우, 좁은 값 범위는 각 단계의 폭, 즉 양자화 오차를 작게 유지합니다. 반면 이상치로 인해 범위가 넓어지면 동일한 256단계가 더 얇게 퍼져 분포의 대부분을 차지하는 일반적인 값의 표현이 거칠어집니다.
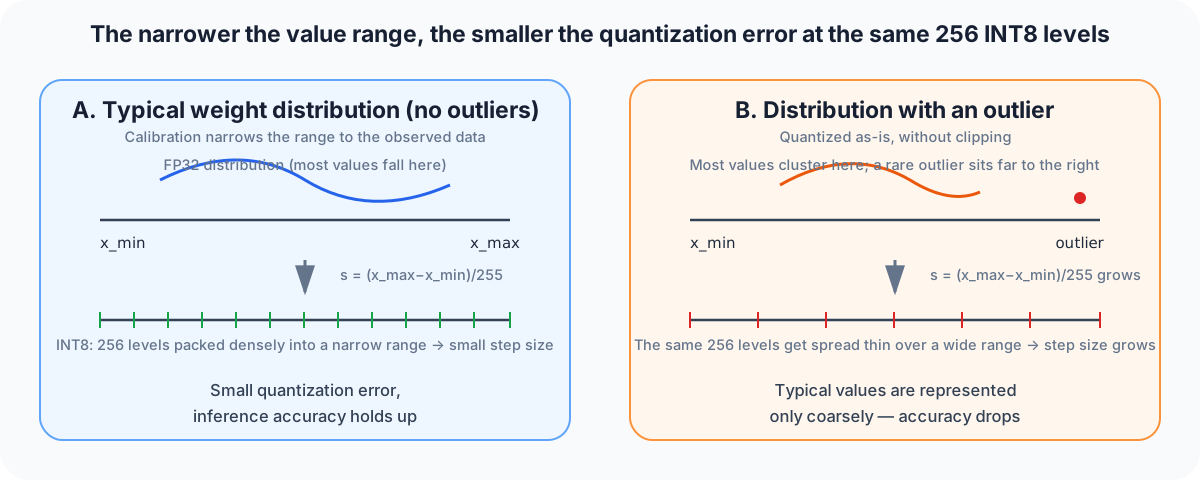
다이어그램: Duskcoil. 실제 측정 데이터를 사용하여 값 범위를 제한하는 "보정"의 유무가 동일한 비트 폭에서도 양자화 오류에 얼마나 큰 영향을 미치는지 보여줍니다.
이 값 범위를 결정하는 것이 보정 단계이며, 양자화는 크게 두 가지 접근 방식을 따릅니다. 학습 후 양자화(PTQ)는 학습된 FP32 모델에 소량의 대표 데이터를 입력하고 각 레이어의 관찰된 출력 범위에서 스케일 s를 계산하는 간단한 접근 방식입니다. 이는 가벼운 방식이지만 이상치가 많은 모델에서는 정확도 손실이 더 클 수 있습니다. 양자화 인식 학습(QAT)은 반올림 오류를 시뮬레이션합니다. 학습 과정 자체에서 양자화로 인해 발생하는 오차를 보정하고 그에 따라 가중치를 업데이트하는 방식이 있습니다. 이 방식은 재학습 과정을 거쳐야 하지만 정확도 저하를 억제합니다. Edge TPU 컴파일러, TensorRT, OpenVINO는 모두 두 가지 방식을 모두 지원하지만, 대부분의 엣지 추론 칩은 카탈로그 성능(TOPS)을 INT8을 기준으로 명시하기 때문에, 실제 선택은 PTQ가 충분한 정확도를 제공하는지 아니면 QAT로 전환해야 하는지에 달려 있습니다.
또한, 2017년경에 설계된 Movidius Myriad X와 같은 VPU(비전 처리 장치)는 기본 연산 정밀도로 INT8 대신 FP16(하프 정밀도 부동 소수점)을 사용했습니다. FP16은 FP32에 비해 메모리 사용량과 대역폭 요구량을 절반으로 줄이면서도 지수 필드를 유지하기 때문에 INT8 방식의 범위 보정 없이도 넓은 동적 범위를 표현할 수 있습니다. 하지만 INT8만큼의 병렬 처리 성능은 제공하지 못하는데, 이것이 이후 출시된 Coral Edge TPU와 Jetson의 Tensor Core가 INT8을 기본 연산 정밀도로 사용하는 이유 중 하나입니다. 두 컴파일러 모두 INT8 우선 전용 데이터 경로를 기반으로 구축되어 TOPS/W가 몇 배 향상되었습니다.
원칙: 그래프 컴파일러를 통한 추론 속도 향상
양자화와 더불어, 학습된 모델이 특정 칩의 명령어 세트에 맞게 컴파일되는 방식은 실제 처리량에 영향을 미치는 또 다른 주요 요인입니다. TensorFlow Lite 또는 ONNX에서 내보낸 모델은 그 자체로 CPU에서 계층별로 순차적으로 실행되는 일반 그래프입니다. 각 벤더의 컴파일러는 이 그래프에 대략 세 가지 유형의 최적화를 적용합니다.
-
연산자 융합: 컨볼루션→배치정규화→ReLU와 같은 순서는 단일 융합 커널로 병합되어 중간 결과를 메모리에 다시 쓰는 대신 레지스터에 저장함으로써 메모리 접근 횟수를 줄입니다.
-
레이아웃 변환: CPU가 선호하는 NCHW(채널 우선) 레이아웃과 벡터 유닛이 선호하는 NHWC(채널 후행) 레이아웃이 대상 하드웨어의 실제 메모리 접근 패턴에 맞게 다시 선택됩니다.
-
고정 그래프 컴파일: Coral Edge TPU 컴파일러와 같은 일부 컴파일러는 지원되는 연산자로만 구성된 완전히 고정된 그래프만 허용하며, 동적 형태나 지원되지 않는 연산자는 아예 허용하지 않습니다. 모델에 지원되지 않는 연산자가 하나라도 포함되면 CPU와 해당 연산자 주변의 Edge TPU 간에 실행이 분산되고, 그로 인해 발생하는 양방향 데이터 전송 비용이 속도를 크게 저하시킬 수 있습니다.
NVIDIA의 TensorRT와 Intel의 OpenVINO는 지원되지 않는 연산자는 CPU로, 나머지는 가속기로 오프로드하는 보다 유연한 "부분 오프로드" 방식을 채택하는 반면, Coral Edge TPU 컴파일러는 완전히 지원되는 그래프와 가속을 전혀 사용하지 않는 두 가지 극단적인 선택에 가깝습니다. 이러한 차이는 SBC 비교 기사에서 다룬 TOPS/메모리 대역폭 트레이드오프와 같은 하드웨어 성능 지표에는 나타나지 않지만, 소프트웨어 스택 설계 철학의 차이이며 실제 비용에 상당한 영향을 미칩니다. 모델 포팅에 대한 내용입니다.
주요 칩 비교: Coral, Movidius, Jetson
| 제품 | 정밀도 | AI 성능 | 전력 | 인터페이스 | 가격 |
|---|---|---|---|---|---|
| Google Coral Edge TPU (USB 가속기) | INT8만 지원 | 4 TOPS (2 TOPS/W) | 2W | USB 3.0 | ~$75–99 (2019년 출시) |
| Intel Movidius Myriad X (신경 컴퓨팅 스틱 2) | 주로 FP16 | ~4 TOPS 상당 (공식 수치 미공개) | ~1.5–2.5W | USB 3.0 | ~$79–99 (2018년 출시, 현재 단종) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10.4 TOPS/W) | ~2.5W | M.2/PCIe | 약 110달러 |
| NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (MAXN Super 모드) | 7~25W | SoM (통합 모듈) | 249달러 |
| NVIDIA Jetson Orin NX (16GB) | INT8 | 100 TOPS | 10~25W | SoM (통합 모듈) | 599달러 |
인텔의 공식 Movidius Myriad X 사양 페이지에는 정확한 TOPS 수치가 명시되어 있지 않지만, 여러 리뷰에서 "초당 4조 회 이상의 연산"을 제공한다고 설명하고 있으며, 인텔 자체에서도 Myriad X가 Myriad 2(100~150 GFLOPS)보다 10배 이상 빠르다고 밝혔습니다. 16개의 프로그래밍 가능한 SHAVE 벡터 프로세서 코어와 Myriad X에 처음 탑재된 전용 블록인 Neural Compute Engine의 조합은 720p 해상도에서 6개의 카메라(스테레오 3쌍)를 초당 60프레임으로 동시에 처리하도록 설계되었습니다. Hailo-8과 Jetson Orin Nano Super/NX에 대한 자세한 내용은 SBC 비교 기사에서 다루므로, 이 글에서는 중복을 피하기 위해 위 표의 항목만 설명합니다.
Coral 제품군에는 위에서 언급한 USB Accelerator의 후속 버전인 Dev Board Micro도 포함됩니다. Linux 지원 애플리케이션 프로세서 대신, Dev Board Micro는 Edge TPU 코프로세서와 상시 작동 저전력 마이크로컨트롤러(MCU)급 보드를 결합하여 상시 음성 또는 진동 감지와 같은 배터리 구동 TinyML 사용 사례에 특화되어 있습니다. Dev Board/USB Accelerator가 범용 SoC와 외부 Edge TPU를 결합하는 반면, Dev Board Micro는 상시 작동 감지 트리거라는 완전히 다른 사용 사례를 목표로 합니다.
역사: Movidius 인수에서 탄생한 Intel의 VPU 설계 철학
Movidius는 샌마테오에 위치한 컴퓨터 비전 처리 전문 저전력 칩 설계 스타트업으로, 2016년 9월 Intel에 인수되었습니다. 인수 전의 Myriad 2 VPU(비전 프로세싱 유닛)는 범용 CPU와 같은 설계가 아니었습니다. 대신 전용 컴퓨터 비전 하드웨어 블록과 12개의 맞춤형 벡터 프로세서 코어(SHAVE)를 결합했습니다. 인수 후에는 Google의 라이프 로깅 카메라 "Clips", FLIR의 열화상 카메라 "Firefly", DJI의 "Phantom 4" 드론, Tencent의 "DeepGaze" 등 여러 양산 기기에 탑재되었습니다. 후속 제품인 Myriad X는 2017년에 발표되었으며, SHAVE 코어 수를 16개로 확장하고 최초로 신경망 추론 전용 하드웨어 블록인 Neural Compute Engine을 추가하여 Myriad 2보다 10배 이상 향상된 성능과 1테라플롭스 이상의 최고 성능을 달성했습니다. 위에서 언급한 Neural Compute Stick 2(NCS2)는 Myriad X 칩 하나를 탑재한 USB 스틱 제품으로, 2018년 4분기에 출시되었으며 현재 인텔의 제품 사양 페이지에도 표시되어 있습니다. "단종" — 한때 엣지 AI의 초기를 대표했던 VPU 칩으로, 이후 등장한 INT8 전용 ASIC 및 GPU 통합 칩에 시장을 내주었습니다.
이 인수와 함께 인텔은 2018년 5월 16일, 자사 하드웨어 전반에 걸쳐 양자화 및 그래프 최적화를 균일하게 처리하도록 설계된 소프트웨어 스택인 OpenVINO 툴킷의 첫 번째 버전을 출시했습니다. OpenVINO의 NNCF(신경망 압축 프레임워크) 구성 요소는 INT8 양자화 및 모델 압축을 처리하며, Movidius 제품군 VPU뿐만 아니라 인텔 CPU 및 통합 GPU까지 아우르는 단일 워크플로를 통해 모델을 최적화하고 배포하도록 설계되었습니다. 특정 가속기 칩에 종속되지 않고 툴체인 형태로 살아남았다는 사실은 하드웨어 세대 교체가 빠른 분야에서 생존 전략의 한 가지 사례를 보여줍니다.
역사: 데이터센터 TPU 계보의 후계자, 엣지 TPU
Google Coral 제품에 탑재된 엣지 TPU는 소형화를 목표로 설계되었습니다. 전력 제약이 있는 임베디드 장치에는 Google이 데이터센터급 TPU(텐서 처리 장치)에 개발한 것과 동일한 "시스톨릭 어레이" 컴퓨팅 아키텍처가 사용됩니다. 시스톨릭 어레이는 다수의 곱셈-누적 장치를 그리드 형태로 배열하고 데이터를 한 방향으로만 스트리밍하여 인접한 장치 간에만 데이터를 전달합니다. 모든 명령어마다 레지스터와 메모리에 접근해야 하는 범용 CPU와 달리, 이러한 구조 덕분에 대규모 행렬 곱셈을 매우 높은 에너지 효율로 처리할 수 있습니다. Google의 데이터센터 TPU는 액체 냉각 방식의 구리 방열판이 장착된 보드에 여러 개의 칩을 탑재하여 이 그리드를 대규모로 구축합니다(아래 사진은 Google이 공개한 것으로, 액체 냉각 튜브로 연결된 4개의 칩이 있는 TPU v3 보드를 보여줍니다). 엣지 TPU는 이러한 기본 개념을 유지하면서 그리드 크기를 대폭 줄이고 전력 소비를 한 자릿수 와트 수준으로 낮춰 USB 버스나 M.2 슬롯의 전력 예산 내에서 작동할 수 있도록 했습니다.
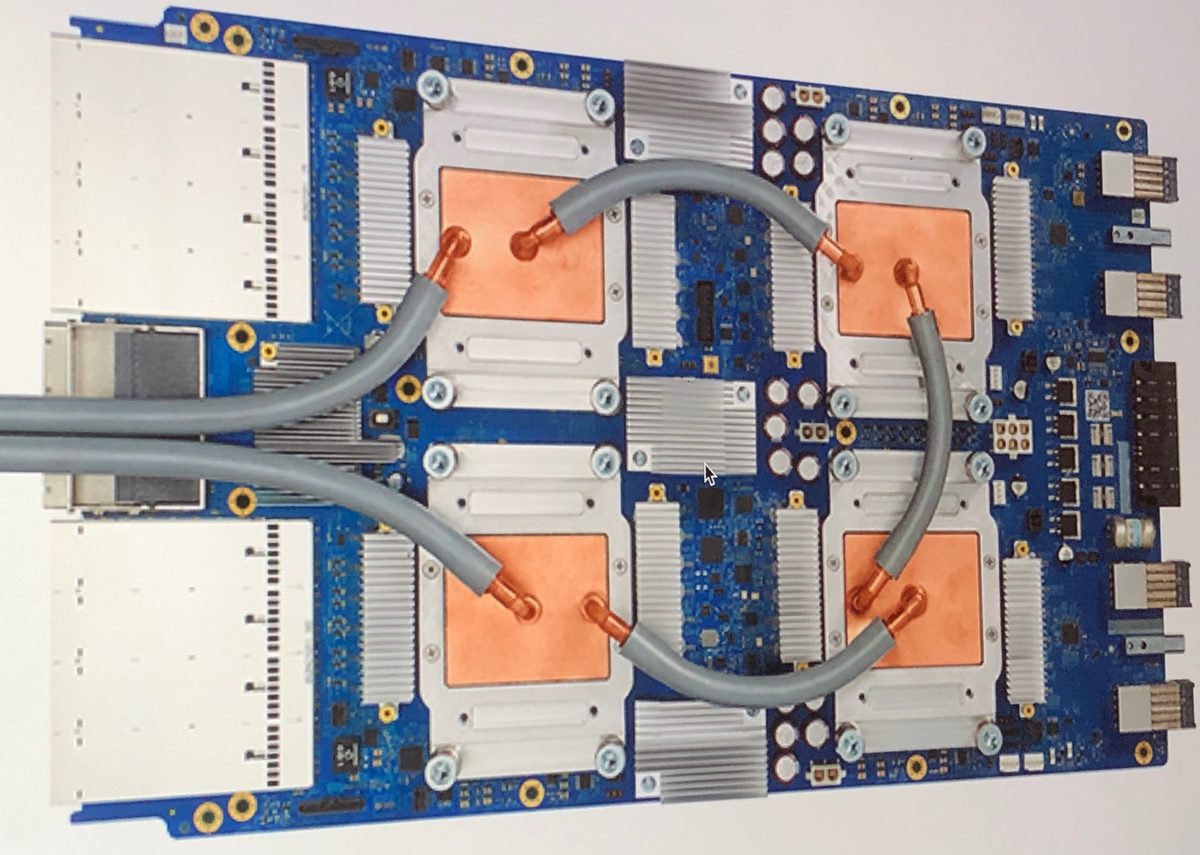
이미지: Tensor Processing Unit 3.0(Zinskauf, CC BY-SA 4.0), Wikimedia Commons. 데이터센터급 TPU v3의 보드 사진입니다. Edge TPU 자체는 아니지만, 동일한 시스톨릭 어레이 방식을 공유하는 데이터센터 "상위" 장치의 규모를 보여주는 참조 이미지입니다.

2019년, Google은 이 Edge TPU(4 TOPS, 2W)를 탑재한 Dev Board와 USB Accelerator를 출시했으며, Raspberry Pi와 같은 기존 SBC용 추가 가속기로 인기를 얻었습니다. 이 제품은 전력 효율적인 추론을 통해 MobileNet v2를 초당 약 400프레임으로 실행할 수 있었습니다. 그러나 그 이후 Google은 주목할 만한 새로운 하드웨어를 출시하지 않고 해당 제품 라인에 대한 투자를 사실상 중단했으며, 2026년 현재 공식 coral.ai 사이트는 일반 Google Developers 사이트로 리디렉션됩니다. 이 페이지에 나와 있습니다. 그럼에도 불구하고 Coral 제품이 완전히 사용되지 않게 되지 않은 이유는 Google이 드라이버와 펌웨어를 오픈 소스로 공개하여 Frigate NVR과 같은 객체 감지 감시 소프트웨어 커뮤니티 프로젝트가 지원을 받아 하드웨어를 계속 생산에 활용할 수 있도록 했기 때문입니다(자세한 내용은 SBC 비교 기사 참조).
실제 사례: Skydio X2 드론에 탑재된 단일 Jetson TX2에서 9개의 신경망이 동시에 실행됨
단일 가속기 칩으로 여러 신경망을 병렬로 실행하는 대표적인 예는 자율 비행 드론 Skydio X2/X2D입니다. X2는 Jetson TX2에 탑재된 것과 동일한 NVIDIA Tegra X2 SoC를 메인 컴퓨팅 칩으로 사용하여 6개의 온보드 카메라(3개의 스테레오 쌍, 1개의 삼안 카메라)에서 들어오는 영상을 처리하고, 자체 설계된 9개의 딥 뉴럴 네트워크를 온보드에서 동시에 실행합니다. 이러한 추론 결과를 사용하여 최대 20개의 관심 대상(장애물, 피사체 등)을 동시에 추적할 수 있습니다. 사람이나 차량과 같은 장애물을 감지하는 동시에 초당 백만 개 이상의 포인트로 업데이트되는 3D 세계 모델을 구축하고, 이 세계 모델을 비행 명령으로 변환하는 결정 루프는 초당 500회 실행됩니다. GPS에 의존하지 않고 빽빽한 숲이나 실내 공간에서 장애물을 피하며 빠르게 비행할 수 있는 이유는 이 모든 파이프라인이 클라우드로 오프로드되지 않고 온보드 Tegra X2 칩 하나에서 완료되기 때문입니다.
 Skydio X2D inspecting a KC-10 Extender (Dover Air Force Base)
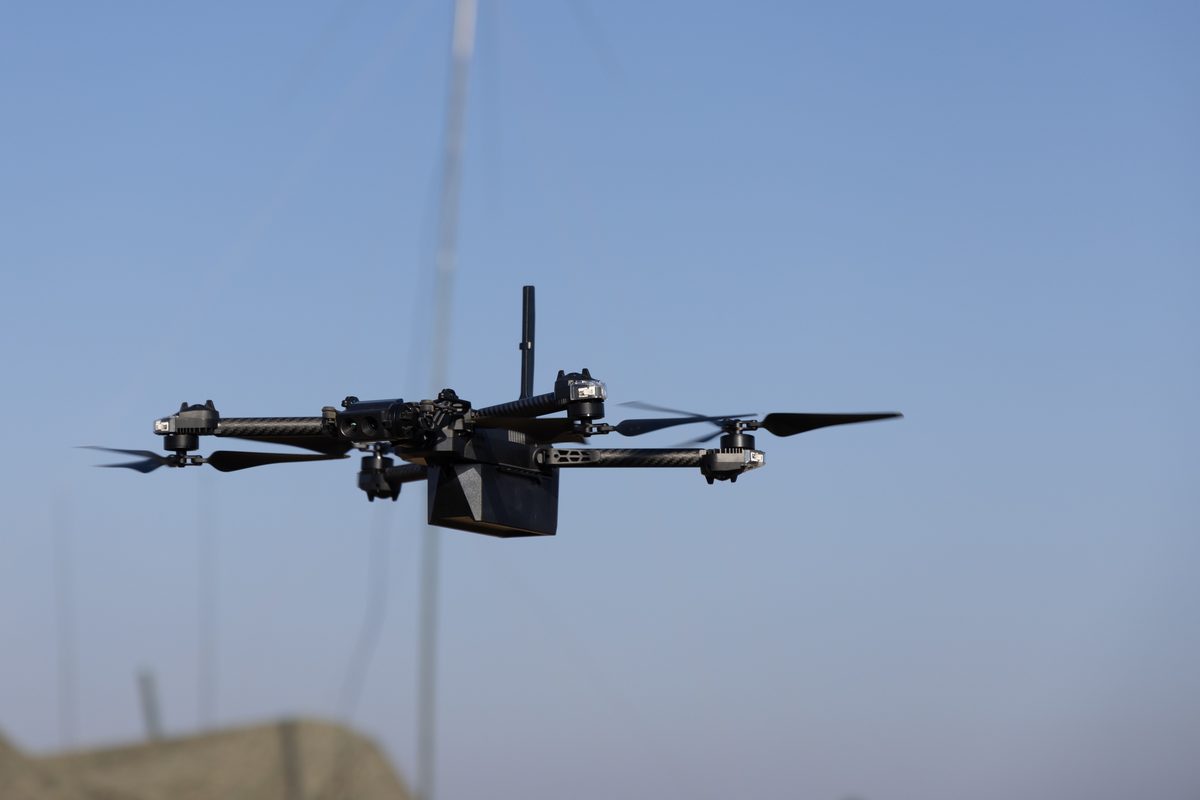 스카이디오 X2D 비행 모습 (오키나와 캠프 슈왑)
이미지 출처: Skydio X2D가 항공기를 검사하는 모습(마우리시오 캄피노, 퍼블릭 도메인) / 미 해병대가 무인항공기 운용 훈련을 하는 모습 (9269101)(퍼블릭 도메인, 미 해병대), 모두 위키미디어 커먼즈 제공.

.jpg)
X2D는 미 국방부에서 개발한 변형 기종을 지칭하며, 공개된 미 국방부 사진에는 델라웨어주 도버 공군기지의 제436임무발행단이 X2D를 사용하여 KC-10 익스텐더 공중급유기의 구조적 안전성을 검사하는 모습(11월)과 같은 실제 배치 사례가 기록되어 있습니다. 2022년) 오키나와 캠프 슈왑에서 훈련 중인 제5항공해군포병연락중대(5th ANGLICO)와 독일 호헨펠스 훈련장에서 훈련 중인 제10산악사단 모두 스카이디오 X2D를 소형 무인항공기 시스템(sUAS)으로 운용하고 있습니다. 후속 기종인 X10은 테그라 X2에서 젯슨 오린(Jetson Orin) 세대 SoC로 업그레이드되고 내비게이션 카메라가 3200만 화소로 향상되었습니다. 이는 세대 간 칩당 TOPS(성능 포인트)의 향상이 실제 운영상의 이점으로 직결되는 좋은 예입니다. 즉, 더 많은 신경망이 동시에 온보드에서 실행되고, 더 많은 객체가 동시에 추적되며, 더 높은 빈도의 의사 결정 루프가 가능해집니다.


댓글
먼저 로그인해 주세요.
아직 데이터가 없습니다.