Contents — find the section you need
Un acelerador de inferencia de IA es un chip diseñado específicamente para ejecutar la fase de inferencia de una red neuronal entrenada (el cálculo directo únicamente) con una eficiencia energética mucho mayor que la de una CPU o GPU. El principio físico fundamental es sencillo: convertir los pesos entrenados en coma flotante de 32 bits (FP32) a una representación de menor precisión, como enteros de 8 bits (INT8) (cuantización), permite que las mismas unidades de cómputo y el mismo ancho de banda de memoria procesen muchas más operaciones en paralelo. Este artículo no compara las SBC (computadoras de placa única) como sistemas completos; en cambio, se centra directamente en la filosofía de diseño y el principio de cuantización de los chips aceleradores dedicados exclusivamente a la inferencia: Google Coral (Edge TPU), Intel Movidius (Myriad X) y NVIDIA Jetson Orin NX.
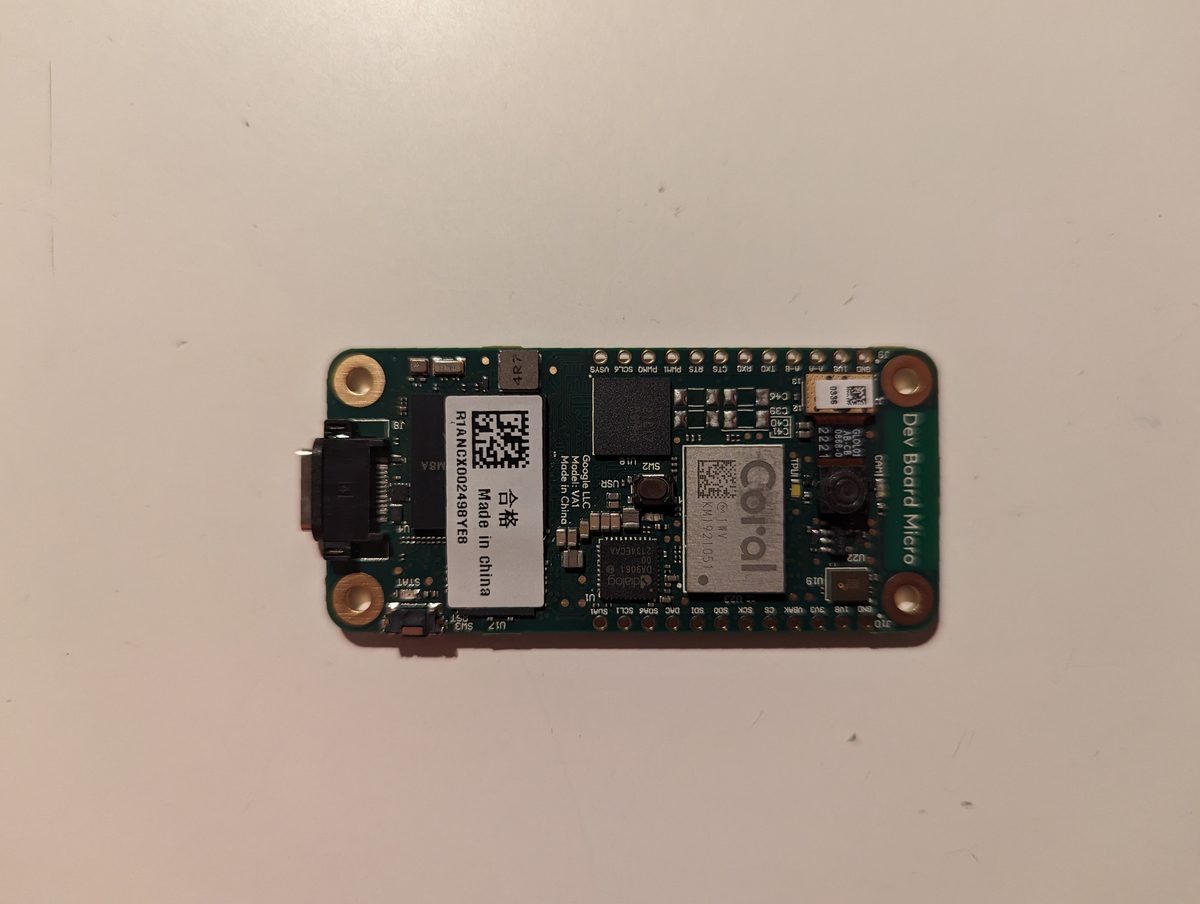 Placa de desarrollo Google Coral Micro
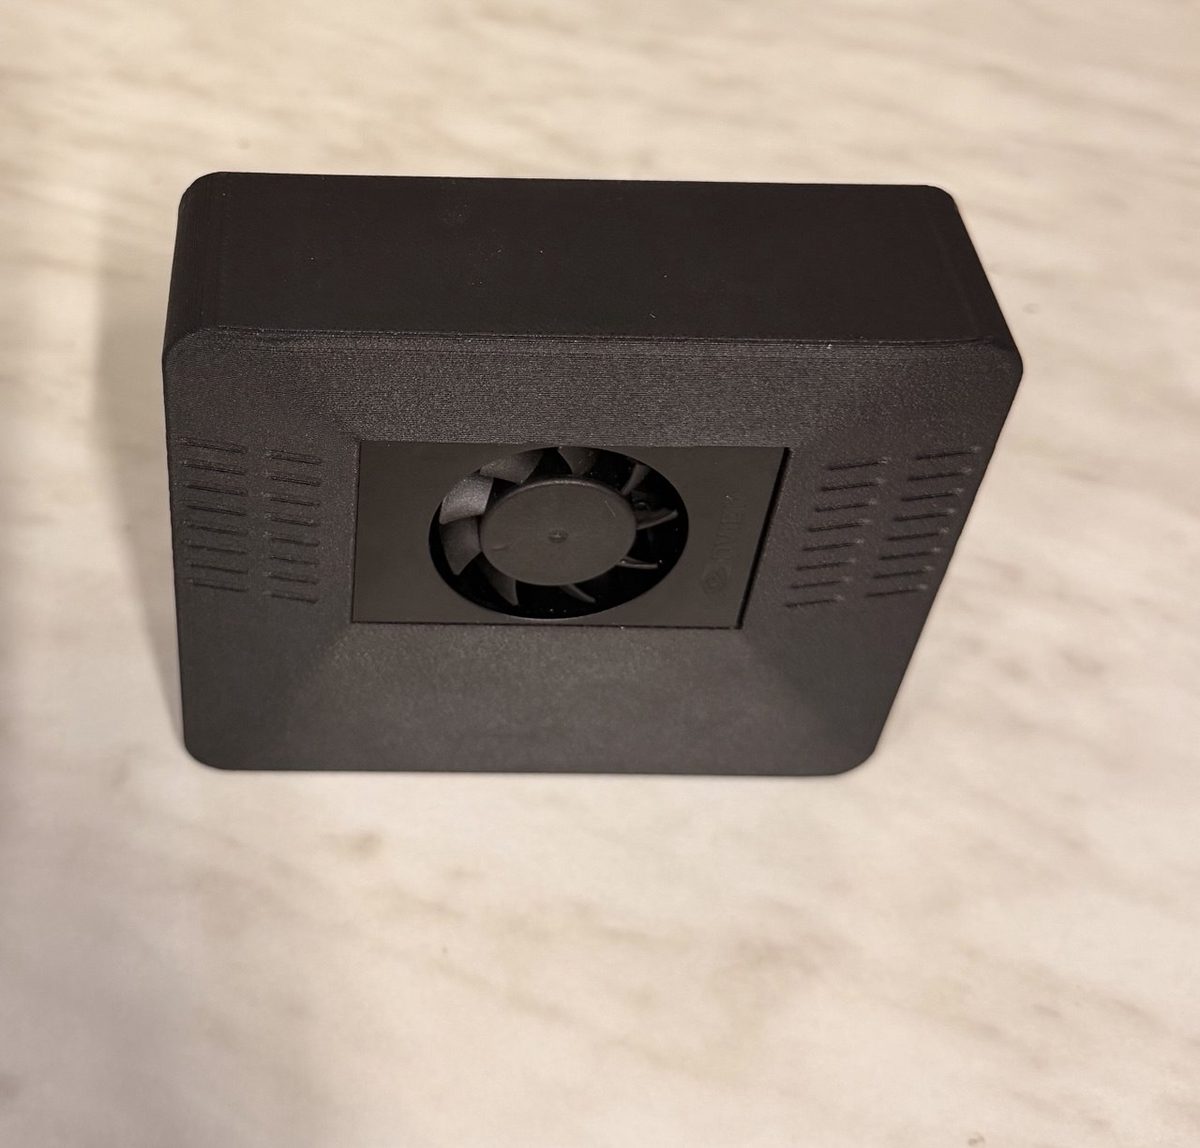 "ClawBox", basado en una NVIDIA Jetson Orin Nano (2026, ID Robots)
Imágenes: Hardware PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA 2.0) / Dispositivo asistente de IA ClawBox (2026) - frontal (Kkralev, CC BY-SA 4.0), ambos a través de Wikimedia Commons.
.jpg)
_-_front.jpg)
Principio: qué hace realmente la cuantización INT8
La forma más común de convertir pesos y activaciones FP32 en enteros de 8 bits es la cuantización lineal (afín). La fórmula que convierte un valor real x en un entero q es:
Aquí, s es la escala (el ancho de un paso entero en valor real), z es el punto cero (el desplazamiento que indica qué paso entero corresponde al cero real) y b es el ancho de bits (8 para INT8). En el momento de la inferencia, el valor se recupera aproximadamente como x \approx s(q-z). En la práctica, esta cuantización implica que la precisión con la que se puede acotar la distribución de valores determina directamente la cantidad de precisión que se pierde. Con los mismos 256 pasos (INT8), un rango de valores estrecho mantiene pequeño el ancho de cada paso (el error de cuantización); un rango ampliado por valores atípicos reduce el ancho de esos mismos 256 pasos, lo que dificulta la representación de los valores típicos que conforman la mayor parte de la distribución.
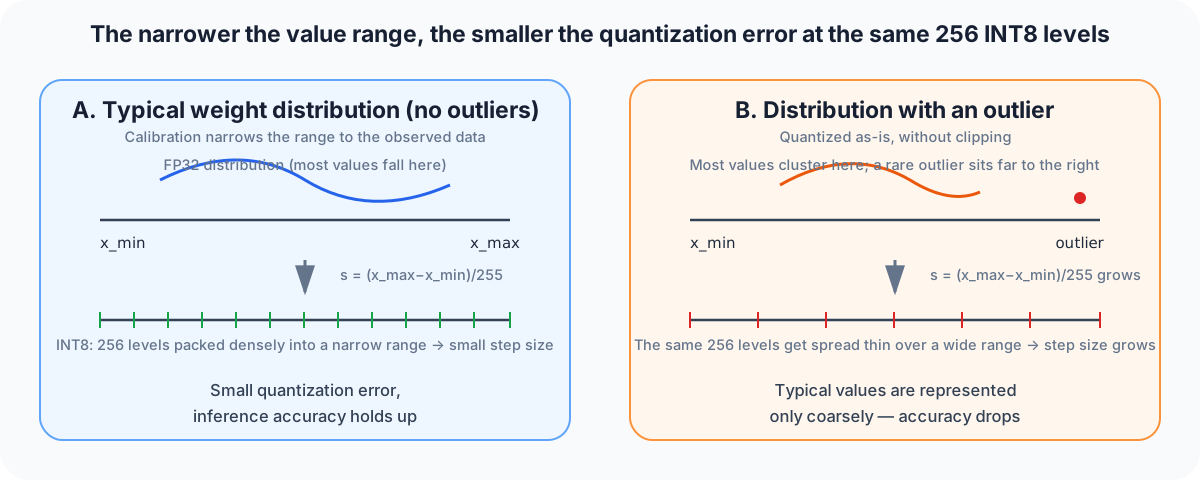
Diagrama: Duskcoil. Ilustra cómo la presencia o ausencia de "calibración" —limitar el rango de valores utilizando datos reales medidos— afecta significativamente el error de cuantización incluso con el mismo ancho de bits.
Decidir este rango de valores es el paso de calibración, y la cuantización sigue, en general, dos enfoques. La Cuantización Posterior al Entrenamiento (PTQ) simplemente procesa una pequeña cantidad de datos representativos a través del modelo FP32 entrenado y calcula la escala s a partir del rango de salida observado de cada capa; un enfoque ligero, pero propenso a una mayor pérdida de precisión en modelos con muchos valores atípicos. El Entrenamiento Consciente de la Cuantización (QAT) simula el error de redondeo introducido por La cuantización durante el entrenamiento actualiza los pesos en consecuencia; esto suprime la degradación de la precisión a costa de una pasada de reentrenamiento. Edge TPU Compiler, TensorRT y OpenVINO admiten ambos enfoques, pero dado que la mayoría de los chips de inferencia de borde indican su rendimiento de catálogo (TOPS) asumiendo INT8, la disyuntiva práctica radica en determinar si PTQ proporciona la precisión suficiente o si es necesario cambiar a QAT.
Además, existe otra complicación: las VPU (Unidades de Procesamiento de Visión) diseñadas alrededor de 2017, como la Movidius Myriad X, utilizaban FP16 (punto flotante de precisión media) en lugar de INT8 como su precisión de cálculo principal. FP16 reduce a la mitad el consumo de memoria y ancho de banda en comparación con FP32, mientras que, al conservar un campo exponencial, representa un amplio rango dinámico sin necesidad de calibración de rango al estilo INT8. Sin embargo, no alcanza el paralelismo que puede lograr INT8, razón por la cual las posteriores Coral Edge TPU y los Tensor Cores de Jetson, ambos construidos en torno a Las rutas de datos dedicadas INT8-first generan varias veces el TOPS/W.
Principio: el compilador de grafos como segundo eje de aceleración de la inferencia
Junto con la cuantización, la forma en que se compila un modelo entrenado para el conjunto de instrucciones de un chip determinado es otro factor importante en el rendimiento real. Un modelo exportado desde TensorFlow Lite u ONNX es, en sí mismo, un grafo genérico que se ejecuta capa por capa en secuencia en una CPU. El compilador de cada proveedor aplica aproximadamente tres tipos de optimización a este grafo.
-
Fusión de operadores: Una secuencia como Convolución→BatchNorm→ReLU se fusiona en un único kernel fusionado, manteniendo los resultados intermedios en registros en lugar de escribirlos en la memoria, lo que reduce el número de accesos a memoria.
-
Transformación de la disposición: La disposición NCHW (canal primero), preferida por la CPU, y la disposición NHWC (canal último), preferida por la unidad vectorial, se vuelven a seleccionar para que coincidan con el patrón real de acceso a memoria del objetivo. Hardware.
-
Compilación a un grafo fijo: Algunos compiladores, como el Coral Edge TPU Compiler, solo aceptan un grafo completamente fijo construido exclusivamente con operadores compatibles, rechazando por completo las formas dinámicas o los operadores no compatibles. Si aparece incluso un solo operador no compatible en el modelo, la ejecución se divide entre la CPU y la Edge TPU a su alrededor, y el costo de transferencia de datos bidireccional resultante puede reducir considerablemente la velocidad.
TensorRT de NVIDIA y OpenVINO de Intel adoptan un enfoque más flexible de "descarga parcial", delegando los operadores no compatibles a la CPU y el resto al acelerador. En cambio, el Coral Edge TPU Compiler se acerca más a una elección de todo o nada entre un grafo totalmente compatible y la ausencia total de aceleración. Esta diferencia no se refleja en las métricas de hardware, como las compensaciones entre TOPS y ancho de banda de memoria que se analizan en el artículo de comparación de SBC (Sensor-sbc.html); se trata de una diferencia en la filosofía de diseño de la pila de software, y tiene un impacto sustancial. afecta al coste real de portar un modelo.
Comparativa de chips principales: Coral, Movidius, Jetson
| Producto | Precisión | Rendimiento de IA | Consumo | Interfaz | Precio |
|---|---|---|---|---|---|
| Google Coral Edge TPU (Acelerador USB) | Solo INT8 | 4 TOPS (2 TOPS/W) | 2W | USB 3.0 | ~$75–99 (lanzamiento en 2019) |
| Intel Movidius Myriad X (Neural Compute Stick 2) | Principalmente FP16 | ~4 TOPS equivalentes (sin cifra oficial publicada) | ~1,5–2,5W | USB 3.0 | ~$79–99 (lanzamiento en 2018, ahora descatalogado) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10,4 TOPS/W) | ~2,5W | M.2/PCIe | ~$110 |
| NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (modo MAXN Super) | 7–25 W | SoM (módulo integrado) | $249 |
| NVIDIA Jetson Orin NX (16 GB) | INT8 | 100 TOPS | 10–25 W | SoM (módulo integrado) | $599 |
La página oficial de especificaciones de Intel Movidius Myriad X no indica una cifra exacta de TOPS, pero varias reseñas describen que ofrece "más de 4 billones de operaciones por segundo" en total, e Intel ha afirmado que Myriad X es más de 10 veces más rápido que Myriad 2 (100–150 GFLOPS). La combinación de 16 núcleos de procesador vectorial SHAVE programables con el Neural Compute Engine —un bloque dedicado que debutó con Myriad X— se diseñó para procesar seis cámaras a 720p (tres pares estéreo) a 60 Hz. fps simultáneamente. Hailo-8 y Jetson Orin Nano Super/NX se tratan con mayor detalle en el artículo de comparación de SBC, por lo que este artículo se limita a las entradas de la tabla anterior para evitar repeticiones.
La línea Coral también incluye la Dev Board Micro, una versión posterior del Acelerador USB mencionado anteriormente. En lugar de un procesador de aplicaciones compatible con Linux, combina el coprocesador Edge TPU con una placa de microcontrolador (MCU) de bajo consumo y siempre activa, diseñada específicamente para casos de uso de TinyML alimentados por batería, como la detección de voz o vibración en escucha constante. Mientras que la Dev Board/Acelerador USB combina un SoC de propósito general con un Edge TPU externo, la Dev Board Micro se centra en un caso de uso completamente diferente: un disparador de detección siempre activo.
Historia: una filosofía de diseño de VPU nacida de la adquisición de Movidius por parte de Intel
Movidius era una startup con sede en San Mateo que diseñaba chips de bajo consumo especializados en el procesamiento de visión artificial, adquirida por Intel en 1999. Septiembre de 2016. Su VPU (Unidad de Procesamiento de Visión) Myriad 2, anterior a la adquisición, no tenía un diseño de CPU de propósito general; en su lugar, combinaba bloques de hardware dedicados a la visión artificial con 12 núcleos de procesador vectorial (SHAVE) diseñados a medida, y tras la adquisición se incluyó en dispositivos de producción como la cámara de registro de vida "Clips" de Google, la cámara de imágenes térmicas "Firefly" de FLIR, el dron "Phantom 4" de DJI y "DeepGaze" de Tencent. Su sucesor, Myriad X, se anunció en 2017, ampliando el número de núcleos SHAVE a 16 y añadiendo, por primera vez, un bloque de hardware dedicado a la inferencia de redes neuronales, el Neural Compute Engine, alcanzando más de 10 veces el rendimiento de Myriad 2 y más de 1 teraFLOPS de pico. El Neural Compute Stick 2 (NCS2) mencionado anteriormente es un producto USB que contiene un único Myriad X, lanzado en el cuarto trimestre de 2018; la propia página de especificaciones del producto de Intel ahora lo marca como tal. «Descontinuado»: un chip VPU que en su día representó los inicios de la IA en el borde, cediendo el mercado a los ASIC dedicados a INT8 y a los chips integrados en GPU que le siguieron.
Junto con esta adquisición, Intel lanzó la primera versión de su kit de herramientas OpenVINO el 16 de mayo de 2018, un conjunto de software diseñado para gestionar la cuantización y la optimización de gráficos de forma uniforme en su propio hardware. El componente NNCF (Neural Network Compression Framework) de OpenVINO gestiona la cuantización INT8 y la compresión de modelos, y fue diseñado para optimizar e implementar modelos mediante un único flujo de trabajo que abarca no solo las VPU de la familia Movidius, sino también las CPU y GPU integradas de Intel. El hecho de que haya sobrevivido como una cadena de herramientas en lugar de estar vinculado a un único chip acelerador ilustra una estrategia de supervivencia en un sector donde las generaciones de hardware cambian rápidamente.
Historia: Edge TPU, heredero del linaje de las TPU para centros de datos
La Edge TPU integrada en los productos Google Coral tiene un diseño escalable, para entornos con limitaciones de energía. Los dispositivos integrados utilizan la misma arquitectura de computación de "matriz sistólica" que Google diseñó para su TPU (Unidad de Procesamiento Tensorial) de clase centro de datos. Una matriz sistólica organiza un gran número de unidades de multiplicación y acumulación en una cuadrícula y transmite datos en una sola dirección, pasándolos únicamente entre unidades adyacentes. A diferencia de una CPU de propósito general, que debe acceder a los registros y la memoria para cada instrucción, esto le permite realizar grandes multiplicaciones de matrices con una eficiencia energética extremadamente alta. Las TPU de los centros de datos de Google construyen esta cuadrícula a una escala enorme, montando múltiples chips en una placa equipada con disipadores de calor de cobre refrigerados por líquido (la foto inferior, publicada por Google, muestra una placa TPU v3 con cuatro chips visiblemente conectados por tubos de refrigeración líquida). La Edge TPU mantiene esta misma idea subyacente, pero reduce drásticamente el tamaño de la cuadrícula y disminuye el consumo de energía a unos pocos vatios, por lo que puede funcionar dentro del presupuesto de energía de un bus USB o una ranura M.2.
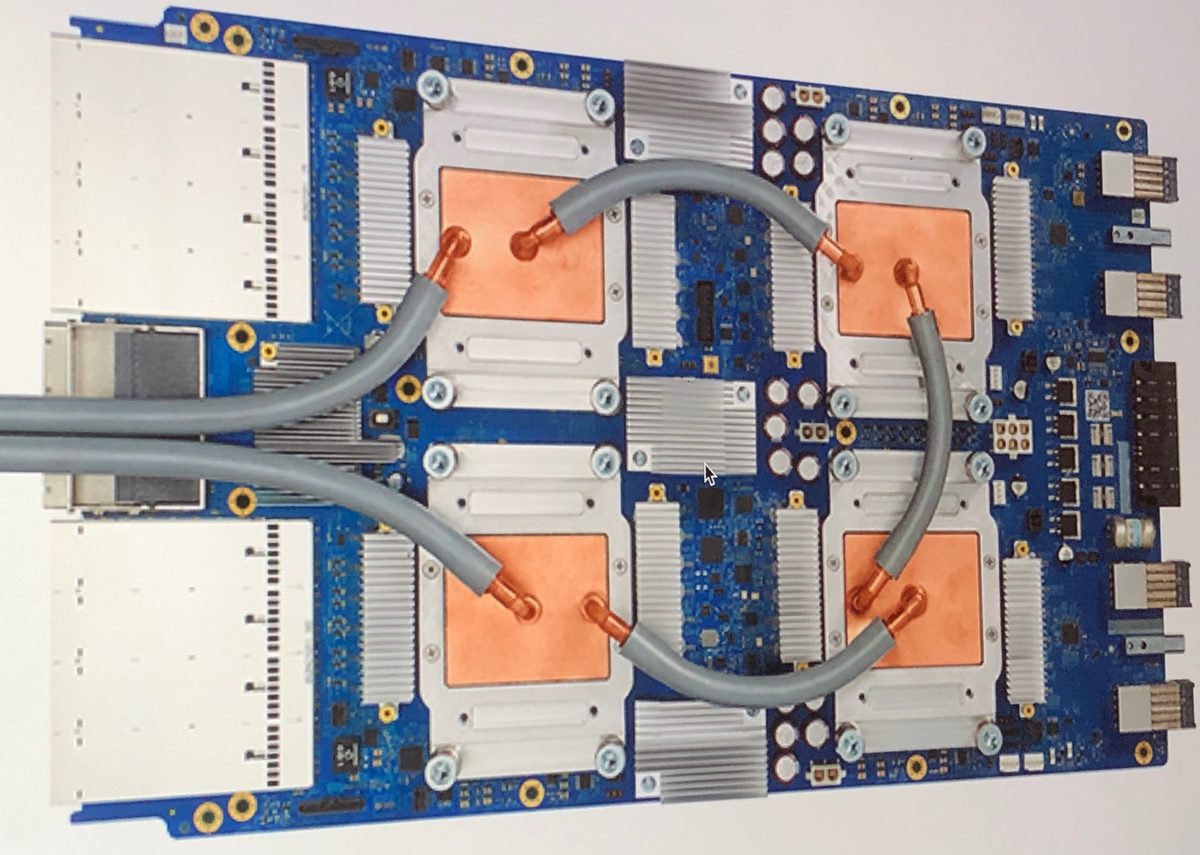
Imagen: Tensor Unidad de Procesamiento 3.0 (Zinskauf, CC BY-SA 4.0), Wikimedia Commons. Foto de la placa de la TPU v3 de clase centro de datos; no se trata de la Edge TPU en sí, sino de una referencia que muestra la escala del componente principal del centro de datos, que comparte el mismo enfoque de matriz sistólica.

En 2019, Google lanzó la Dev Board y el acelerador USB con esta Edge TPU (4 TOPS, 2 W), que se popularizó como acelerador adicional para SBC existentes como la Raspberry Pi, gracias a su inferencia de bajo consumo que permitía ejecutar MobileNet v2 a aproximadamente 400 fotogramas por segundo. Sin embargo, desde entonces, Google ha dejado de invertir en esta línea de productos sin lanzar ningún hardware nuevo destacable, y a partir de 2026, su sitio web oficial coral.ai redirige a una página genérica de Google Developers. La razón por la que los productos Coral no han caído completamente en desuso, a pesar de esto, es que Google liberó los controladores y el firmware como código abierto, lo que permitió que proyectos comunitarios como el software de vigilancia con detección de objetos Frigate NVR recibieran soporte y mantuvieran el hardware en producción (se detalla más en el artículo de comparación de SBC).
Ejemplo práctico: nueve redes neuronales ejecutándose simultáneamente en un solo Jetson TX2 a bordo de un dron Skydio X2
Un ejemplo destacado de un único chip acelerador que ejecuta múltiples redes neuronales en paralelo es el dron autónomo Skydio X2/X2D. El X2 lleva un NVIDIA Tegra X2 —el mismo SoC que se encuentra en el Jetson TX2— como su chip de procesamiento principal, que procesa las señales de seis cámaras integradas (tres pares estéreo, una configuración trinocular) para ejecutar simultáneamente nueve redes neuronales profundas diseñadas a medida, completamente a bordo. Utilizando estos resultados de inferencia, puede rastrear hasta 20 objetos de interés simultáneos —obstáculos, sujetos como personas o vehículos— mientras construye una red neuronal. El modelo 3D del mundo se actualiza a una velocidad superior a un millón de puntos por segundo, y el bucle de decisión que convierte ese modelo en comandos de vuelo se ejecuta a una velocidad de 500 Hz. La razón por la que puede volar rápido a través de bosques densos o espacios interiores evitando obstáculos sin depender del GPS es que todo este proceso se completa en un único Tegra X2 a bordo, en lugar de descargarse a la nube.
 Skydio X2D inspeccionando un KC-10 Extender (Base de la Fuerza Aérea de Dover)
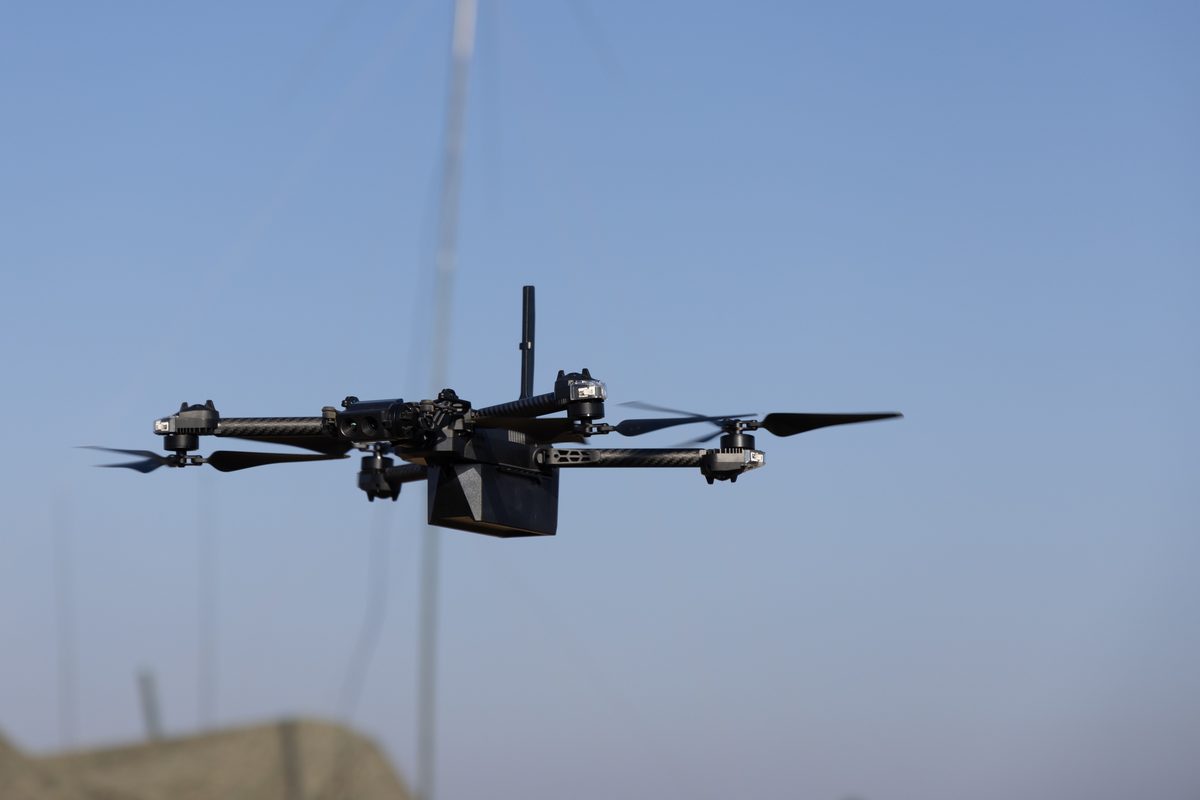 Un Skydio X2D volando durante un entrenamiento (Campamento Schwab, Okinawa)
Imágenes: Skydio X2D inspeccionando aeronave (Mauricio Campino, dominio público) / Marines de EE. UU. practican operaciones con UAS (9269101) (dominio público, Cuerpo de Marines de EE. UU.), ambas a través de Wikimedia Commons.

.jpg)
La designación X2D se refiere a la variante del Departamento de Defensa, y entre los despliegues reales registrados en fotos del Departamento de Defensa de EE. UU. publicadas se incluye el del 436.º Grupo de Generación de Misiones en la Base de la Fuerza Aérea Dover, Delaware, que utilizó un X2D para inspeccionar la integridad estructural de un avión de reabastecimiento aéreo KC-10 Extender (noviembre de 2022). Además, la 5.ª Compañía de Enlace de Artillería Aeronaval (5.ª ANGLICO), que se entrenaba en Camp Schwab, Okinawa, y la 10.ª División de Montaña, que se entrenaba en el Área de Entrenamiento de Hohenfels, Alemania, ambas operaban el Skydio X2D como un pequeño sistema aéreo no tripulado (sUAS). Su sucesor, el X10, pasa del Tegra X2 a un SoC Jetson de la generación Orin y mejora sus cámaras de navegación a 32 megapíxeles, un buen ejemplo de cómo un salto en el rendimiento por chip entre generaciones se traduce directamente en ventajas operativas reales: más redes neuronales ejecutándose simultáneamente a bordo, más objetos rastreados al mismo tiempo y un ciclo de decisión de mayor frecuencia.
De un "dispositivo de IA" para aficionados a la vanguardia del entrenamiento en dispositivos
Los aceleradores con GPU integrada, que antes se centraban en aplicaciones de robótica y defensa, han comenzado a llegar, para 2026, también a desarrolladores individuales y de pequeña escala. "ClawBox", fabricado por la empresa búlgara ID Robots, es un dispositivo de hardware de asistencia con IA que incorpora un NVIDIA Jetson Orin Nano, alojado en una carcasa del tamaño de la palma de la mano con ventilador y ventilación lateral. Reutiliza, tal cual, el mismo SoM diseñado originalmente para cargas de trabajo robóticas. El hecho de que un chip diseñado para ser el "cerebro" de un dron o robot industrial pueda integrarse directamente en un producto que se comercializa por cientos o miles de unidades, fabricado por una pequeña empresa emergente, subraya la versatilidad de los aceleradores con GPU integrada: a diferencia de un ASIC dedicado, pueden ejecutar modelos CUDA arbitrarios sin necesidad de configuración adicional.
Una segunda tendencia relacionada es la investigación que impulsa lo que antes era un acelerador de borde exclusivamente para inferencia hacia el entrenamiento en el dispositivo, es decir, el reentrenamiento de un modelo directamente en el dispositivo. Un artículo publicado en julio de 2026, titulado "Empowering On-Device Model Adaptation with an Edge AI Inference Accelerator" (Piechocki, Capotondi, Kraft, arXiv:2607.18101), propone una arquitectura que utiliza el Hailo-8L (una versión inferior del Hailo-8 mencionado anteriormente) para dividir el trabajo de inferencia y entrenamiento entre diferentes chips: la inferencia de la arquitectura base cuantificada se ejecuta en el Hailo-8L, mientras que solo las capas finales, de menor tamaño, se ajustan incrementalmente en FP32 en la CPU. El artículo reporta una aceleración de hasta 15,4 veces en el tiempo real para el entrenamiento en el dispositivo en comparación con una Raspberry Pi 5 sola, lo que abre un atisbo de una frontera de investigación donde la premisa misma de "solo inferencia" comienza a desmoronarse, basada en la misma pila tecnológica subyacente de cuantificación y compilación de grafos.
Parámetros que determinan el rendimiento
- Eficiencia TOPS/W frente a flexibilidad de precisión: La TPU Coral Edge es altamente eficiente con 2 TOPS/W, pero esto implica la limitación de ejecutar solo gráficos fijos pre-cuantizados a INT8. La Jetson Orin NX, por el contrario, puede ejecutar modelos CUDA arbitrarios en una combinación de FP16/INT8, aunque a costa de no alcanzar el rendimiento TOPS/W de Coral. La flexibilidad que un proyecto puede permitirse sacrificar suele ser el primer factor a considerar en la selección del chip.
- Estrictez del compilador: Un compilador de gráficos totalmente fijos, como el compilador de la TPU Coral Edge, que no permite ningún operador no compatible, obliga a que el diseño del modelo se limite a los operadores compatibles desde el principio. Los compiladores de descarga parcial como TensorRT/OpenVINO ofrecen mayor flexibilidad de portabilidad, pero es fácil pasar por alto la penalización de velocidad que se produce cuando se activa la opción de usar la CPU.
- Elección del método de cuantización (PTQ vs. QAT): PTQ, que solo requiere una pequeña cantidad de datos representativos, es económico de desarrollar, pero propenso a una mayor pérdida de precisión en modelos con muchos valores atípicos. QAT requiere una pasada de reentrenamiento, pero suprime esa degradación. Las VPU de la generación Movidius Myriad X, construidas principalmente en torno a FP16, evitan por completo el esfuerzo de calibración de la cuantización por diseño.
- Ancho de banda de la interfaz: Los dispositivos conectados por USB, como el acelerador USB Coral o el NCS2, pueden experimentar un cuello de botella en el ancho de banda del bus USB del host cuando se combinan varias unidades (detallado en el caso del NVR Frigate en el artículo de comparación de SBC). Los dispositivos con conexión M.2/PCIe, como el Hailo-8 o los Jetson con SoM integrado, están menos expuestos a esta limitación.
- Continuidad del suministro y hoja de ruta: El Movidius NCS2 de Intel aparece explícitamente como "Descatalogado" en su página de especificaciones, y el sitio web oficial de Coral ahora redirige a otro sitio, mientras que la línea Jetson continúa lanzando nuevas generaciones. Para un proyecto de larga duración, la continuidad del suministro se convierte en un factor de riesgo que va más allá de una simple comparación de TOPS por dólar.
- Relación precio-rendimiento (£/TOPS): En términos de relación precio-rendimiento (£/TOPS), el Jetson Orin Nano Super (£249/67 TOPS ≈ £3,7/TOPS) y el Jetson Orin NX (£599/100 TOPS ≈ £6/TOPS) pueden parecer más económicos que el Hailo-8 (£110/26 TOPS ≈ £4,2/TOPS) o el Coral (£75–99/4 TOPS ≈ £19–25/TOPS), pero la decisión final depende del equilibrio entre el tamaño del chasis y el consumo energético que el producto pueda soportar, no solo del rendimiento bruto y el precio unitario.
¿El doble de TOPS significa el doble de velocidad de la aplicación?
La precisión, la memoria, los operadores admitidos, las transferencias y el preprocesamiento afectan la velocidad. Mida la latencia de extremo a extremo en el modelo real.
Referencias
- Marco de compresión de redes neuronales (NNCF) — OpenVINO oficial
- OpenVINO (Wikipedia)
- Intel Neural Compute Stick 2 — Especificaciones del producto (Intel oficial)
- Análisis: Intel Neural Compute Stick 2 para IA en el borde (viso.ai)
- Intel adquirirá la empresa de visión artificial Movidius (Camino a la realidad virtual)
- Intel anuncia el Movidius Myriad X (Notebookcheck)
- Google Coral Edge TPU / Dev Board — CNX Software
- Placa de desarrollo Coral TPU (NXP)
- Arquitectura del sistema Cloud TPU (Google Cloud oficial)
- Análisis del módulo NVIDIA Jetson Orin NX de 16 GB (ThinkRobotics)
- Hoja de datos de la serie NVIDIA Jetson Orin NX (NVIDIA Developer)
- Kit de desarrollo Jetson Orin Nano Super (NVIDIA oficial)
- Análisis de Inception: El dron Skydio 2 con tecnología NVIDIA Jetson (Blog técnico de NVIDIA)
- Comparativa entre Skydio X10 y X2 (THE FUTURE 3D) )- Adaptación de modelos en dispositivos con un acelerador de inferencia de IA en el borde (arXiv:2607.18101)
- Inferencia LLM sostenible para IA en el borde (arXiv:2504.03360)
- Hardware PXL 20231201 152957218 (53388218926) — Wikimedia Commons
- Unidad de procesamiento tensorial 3.0 — Wikimedia Commons
- Dispositivo asistente de IA ClawBox (2026) - vista frontal — Wikimedia Commons
- Inspección de Skydio X2D aeronave — Wikimedia Commons
- Marines de EE. UU. practican operaciones con UAS (9269101) — Wikimedia Commons


Comentarios
Inicia sesión para continuar.
Todavía no hay datos.