Contents — find the section you need
Yapay zeka çıkarım hızlandırıcı, eğitilmiş bir sinir ağının "çıkarım" aşamasını (sadece ileri hesaplama) bir CPU veya GPU'dan çok daha yüksek enerji verimliliğiyle çalıştırmak için özel olarak tasarlanmış bir çiptir. Temel fiziksel prensip basittir: 32 bit kayan nokta (FP32) ile eğitilmiş ağırlıkları 8 bit tamsayılar (INT8) gibi daha düşük hassasiyetli bir gösterime dönüştürmek (nicelleştirme), aynı işlem birimlerinin ve aynı bellek bant genişliğinin çok daha fazla paralel işlem gerçekleştirmesini sağlar. Bu makale, [tek kartlı bilgisayarları (SBC'ler) bütün sistemler olarak karşılaştırmaz; bunun yerine, yalnızca çıkarıma adanmış hızlandırıcı çiplerin tasarım felsefesine ve nicelleştirme prensibine odaklanır: Google Coral (Edge TPU), Intel Movidius (Myriad X) ve NVIDIA Jetson Orin NX.
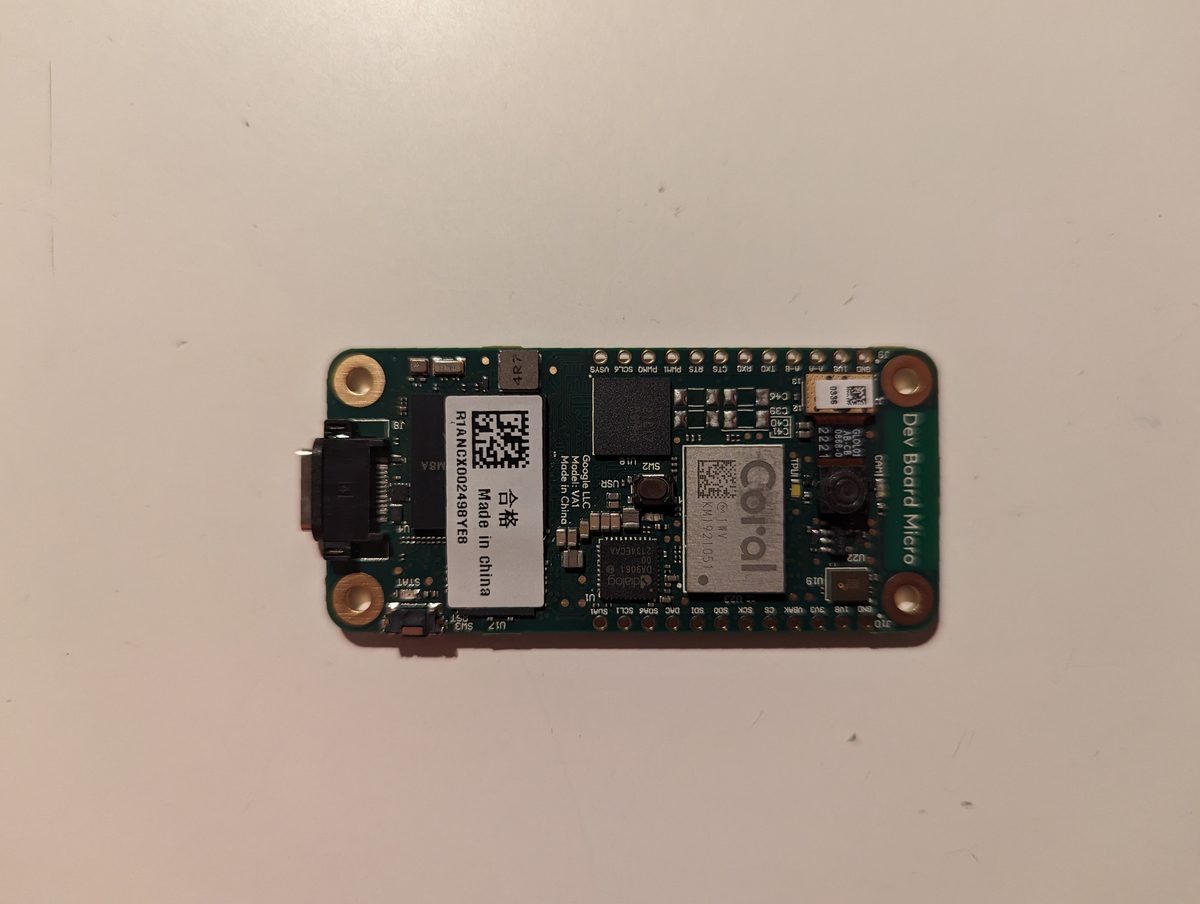 Google Coral Dev Board Micro
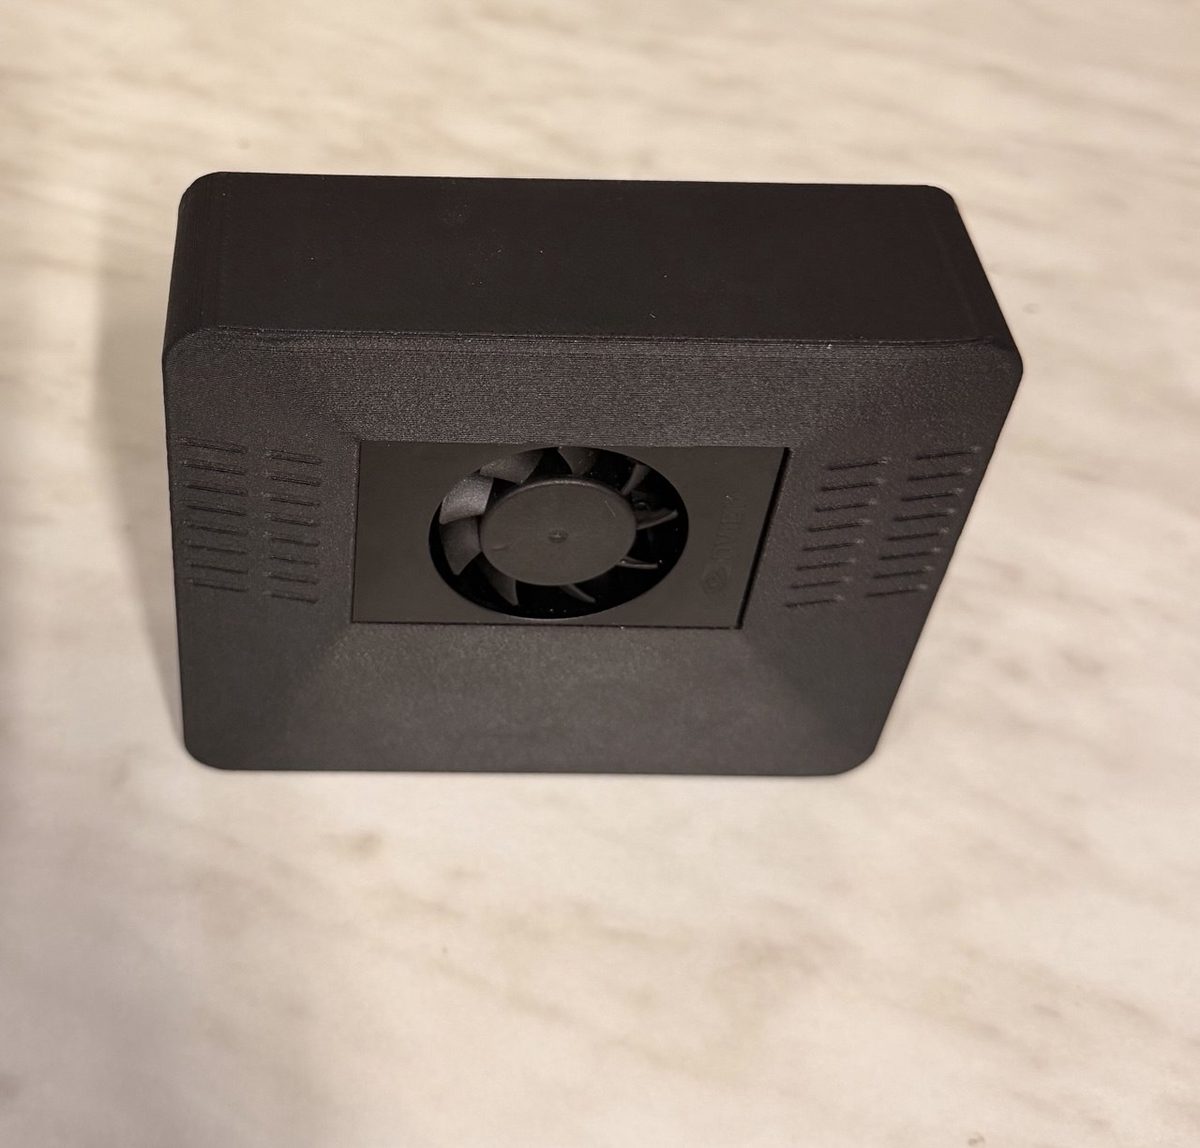 "ClawBox," bir NVIDIA Jetson Orin Nano (2026, ID Robots) üzerine inşa edilmiştir
Görseller: Donanım PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA) 2.0) / ClawBox yapay zeka asistan cihazı (2026) - ön(Kkralev, CC BY-SA 4.0), her ikisi de Wikimedia Commons aracılığıyla.
.jpg)
_-_front.jpg)
Prensip: INT8 nicelemesi aslında ne yapar
FP32 ağırlıklarını ve aktivasyonlarını 8 bitlik tamsayılara sıkıştırmanın en yaygın yolu doğrusal (afin) nicelemedir. Gerçek bir değer olan x'ü tam sayı q'e dönüştüren formül şöyledir:
Burada s ölçek (bir tam sayı adımının gerçek değerli genişliği), z sıfır noktası (hangi tam sayı adımının gerçek sıfıra karşılık geldiğini gösteren ofset) ve b bit genişliğidir (INT8 için 8). Çıkarım zamanında değer yaklaşık olarak x \approx s(q-z) olarak geri kazanılır. Bu nicelemenin pratikteki anlamı şudur: Değer dağılımının ne kadar sıkı sınırlandırılabileceği, ne kadar doğruluk kaybının doğrudan belirleyicisidir. Aynı 256 adımda (INT8), dar bir değer aralığı her adımın genişliğini -nicelleme hatasını- küçük tutar; aykırı değerlerle genişleyen bir aralık, aynı 256 adımı daha ince yayarak, dağılımın büyük kısmını oluşturan tipik değerlerin temsilini kabalaştırır.
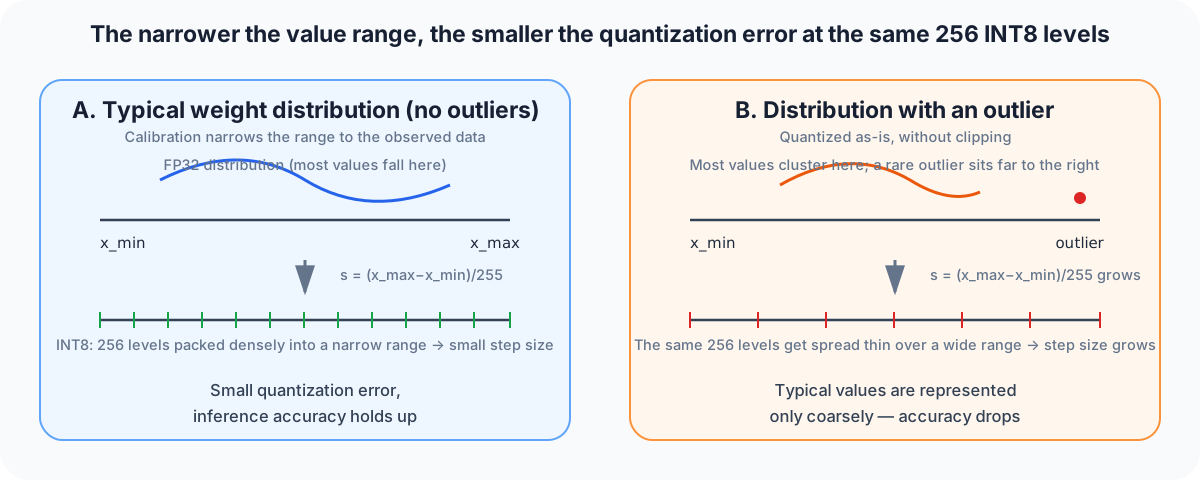
Diyagram: Duskcoil. Gerçek ölçülen verileri kullanarak değer aralığını sınırlandıran "kalibrasyonun" varlığının veya yokluğunun, aynı bit genişliğinde bile niceleme hatasını nasıl önemli ölçüde etkilediğini göstermektedir.
Bu değer aralığının kalibrasyon adımı olduğuna karar verilir ve niceleme genel olarak iki yaklaşımı izler. Eğitim Sonrası Niceleme (PTQ), eğitilmiş FP32 modelinden az miktarda temsili veri geçirir ve her katmanın gözlemlenen çıktı aralığından ölçeği hesaplar s - hafif bir yaklaşım, ancak birçok aykırı değere sahip modellerde daha büyük doğruluk kaybına eğilimlidir. Nicelleme Farkındalıklı Eğitim (QAT) Bu yöntem, eğitim sırasında niceleme tarafından ortaya çıkarılan yuvarlama hatasını simüle eder ve ağırlıkları buna göre günceller; bu, yeniden eğitim geçişi pahasına doğruluk düşüşünü bastırır. Edge TPU Derleyicisi, TensorRT ve OpenVINO her iki yaklaşımı da destekler, ancak çoğu uç çıkarım çipi katalog performanslarını (TOPS) INT8 varsayarak belirttiğinden, pratik yol ayrımı PTQ'nun yeterli doğruluk sağlayıp sağlamadığı veya QAT'ye geçmenin gerekli olup olmadığıdır.
Ayrıca bir başka sorun daha var: 2017 civarında tasarlanan VPU'lar (Görsel İşleme Birimleri), örneğin Movidius Myriad X, birincil hesaplama hassasiyeti olarak INT8 yerine FP16 (yarım hassasiyetli kayan nokta) kullandı. FP16, FP32'ye göre bellek ayak izini ve bant genişliği talebini yarıya indirirken - bir üs alanı koruduğu için - INT8 tarzı aralık kalibrasyonuna ihtiyaç duymadan geniş bir dinamik aralığı temsil eder. Bununla birlikte, INT8'in elde edebileceği paralelliğe ulaşamaz; bu da daha sonraki Coral Edge TPU ve Jetson'ın Tensor Çekirdekleri, her ikisi de INT8 öncelikli özel veri yolları etrafında inşa edilmiş olup, TOPS/W'de birkaç kat daha yüksek performans sergiliyor.
Prensip: Çıkarım hızlandırmasının ikinci ekseni olarak grafik derleyici
Nicelleştirmenin yanı sıra, eğitilmiş bir modelin belirli bir çipin komut seti için derlendiği şey, gerçek dünya verimliliğinde diğer önemli faktördür. TensorFlow Lite veya ONNX'ten dışa aktarılan bir model, kendi başına, bir CPU üzerinde katman katman sırayla yürütülen genel bir grafiktir. Her satıcının derleyicisi bu grafiğe kabaca üç tür optimizasyon uygular.
-
Operatör birleştirme: Evrişim→BatchNorm→ReLU gibi bir dizi, ara sonuçları belleğe geri yazmak yerine kayıtlarda tutarak, bellek erişim sayısını azaltan tek bir birleştirilmiş çekirdeğe birleştirilir.
-
Yerleşim dönüşümü: CPU tarafından tercih edilen NCHW (kanal öncelikli) yerleşim ve vektör birimi tarafından tercih edilen NHWC (kanal son) yerleşim Hedef donanımın gerçek bellek erişim modeline uyacak şekilde yeniden seçildi.
- Sabit bir grafiğe derleme: Coral Edge TPU Derleyicisi gibi bazı derleyiciler, tamamen desteklenen operatörlerden oluşturulmuş, tamamen sabit bir grafiği kabul eder ve dinamik şekilleri veya desteklenmeyen işlemleri tamamen reddeder. Modelde tek bir desteklenmeyen operatör bile görünse, yürütme CPU ve etrafındaki Edge TPU arasında bölünür ve ortaya çıkan çift yönlü veri aktarım maliyeti hızı önemli ölçüde düşürebilir.
NVIDIA'nın TensorRT'si ve Intel'in OpenVINO'su daha esnek bir "kısmi yük boşaltma" yaklaşımı benimser - desteklenmeyen operatörleri CPU'ya geri bırakırken geri kalanını hızlandırıcıya boşaltır - oysa Coral Edge TPU Derleyicisi, tamamen desteklenen bir grafik ile hiç hızlandırma olmaması arasında her şey ya da hiçbir şey seçeneğine daha yakındır. Bu ayrım, [SBC karşılaştırmasında] ele alınan TOPS/bellek bant genişliği takasları gibi donanım ölçümlerinde görünmez. Makale — Bu, yazılım yığınının tasarım felsefesindeki bir farktır ve bir modelin taşınmasının gerçek maliyetini önemli ölçüde etkiler.
Başlıca çip karşılaştırması: Coral, Movidius, Jetson
| Ürün | Hassasiyet | Yapay Zeka performansı | Güç | Arayüz | Fiyat |
|---|---|---|---|---|---|
| Google Coral Edge TPU (USB Hızlandırıcı) | Yalnızca INT8 | 4 TOPS (2 TOPS/W) | 2W | USB 3.0 | ~75–99$ (2019 lansmanı) |
| Intel Movidius Myriad X (Sinirsel Hesaplama Çubuğu 2) | Çoğunlukla FP16 | ~4 TOPS eşdeğeri (resmi olarak yayınlanmış bir rakam yok) | ~1,5–2,5W | USB 3.0 | ~79–99$ (2018 lansmanı, artık üretimi durduruldu) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10,4 TOPS/W) | ~2,5W | M.2/PCIe | ~110$ |
| NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (MAXN Süper modu) | 7–25W | SoM (entegre modül) | 249$ |
| NVIDIA Jetson Orin NX (16GB) | INT8 | 100 TOPS | 10–25W | SoM (entegre modül) | 599$ |
Intel'in resmi Movidius Myriad X teknik özellik sayfasında kesin bir TOPS rakamı belirtilmiyor, ancak birçok inceleme toplamda "saniyede 4 trilyondan fazla işlem" sağladığını belirtiyor ve Intel'in kendisi de Myriad X'in Myriad 2'den (100–150 GFLOPS) 10 kat daha hızlı olduğunu söylüyor. 16 programlanabilir SHAVE vektör işlemci çekirdeğinin birleşimiyle... Myriad X ile birlikte piyasaya sürülen özel bir blok olan Neural Compute Engine, 720p çözünürlükte (üç stereo çifti) altı kamerayı 60 fps hızında eş zamanlı olarak işlemek üzere tasarlanmıştır. Hailo-8 ve Jetson Orin Nano Super/NX, SBC karşılaştırma makalesinde daha ayrıntılı olarak ele alınmıştır, bu nedenle bu yazı tekrardan kaçınmak için yukarıdaki tablo girişleriyle sınırlıdır.
Coral serisi ayrıca, yukarıda listelenen USB Accelerator'ın daha sonraki bir türevi olan Dev Board Micro'yu da içerir. Linux uyumlu bir uygulama işlemcisi yerine, Edge TPU yardımcı işlemcisini sürekli açık, düşük güç tüketimli bir mikrodenetleyici (MCU) sınıfı kartla eşleştirir ve sürekli dinleme veya titreşim algılama gibi pil gücüyle çalışan TinyML kullanım durumlarını hedef alır. Dev Board/USB Accelerator genel amaçlı bir SoC'yi harici bir Edge TPU ile eşleştirirken, Dev Board Micro tamamen farklı bir kullanım durumunu hedefler: sürekli açık bir algılama tetikleyicisi.
Tarihçe: a Intel'in Movidius'u satın almasının ardından ortaya çıkan VPU tasarım felsefesi
Movidius, bilgisayar görüşü işleme konusunda uzmanlaşmış düşük güç tüketimli çipler tasarlayan San Mateo merkezli bir girişim şirketiydi ve Eylül 2016'da Intel tarafından satın alındı. Satın almadan önceki Myriad 2 VPU'su (Görsel İşleme Birimi), genel amaçlı bir CPU benzeri tasarıma sahip değildi; bunun yerine, özel olarak tasarlanmış 12 vektör işlemci çekirdeği (SHAVE) ile özel bilgisayar görüşü donanım bloklarını birleştiriyordu ve satın almanın ardından Google'ın yaşam kaydı kamerası "Clips", FLIR'ın termal görüntüleme kamerası "Firefly", DJI'nin "Phantom 4" dronu ve Tencent'in "DeepGaze"i de dahil olmak üzere üretim cihazlarında yer aldı. Halefi Myriad X, 2017'de duyuruldu ve SHAVE çekirdek sayısını 16'ya çıkardı ve ilk kez sinir ağı çıkarımı için özel bir donanım bloğu olan Sinirsel Hesaplama Motorunu ekleyerek Myriad 2'nin performansının 10 katından fazlasına ve 1 teraFLOPS'un üzerine ulaştı. Zirve. Yukarıda bahsedilen Neural Compute Stick 2 (NCS2), 2018'in dördüncü çeyreğinde piyasaya sürülen ve tek bir Myriad X taşıyan bir USB-stick ürünüdür; Intel'in kendi ürün spesifikasyon sayfası artık onu "Üretimi Durduruldu" olarak işaretliyor - bir zamanlar uç yapay zekanın ilk günlerini temsil eden bir VPU çipi, daha sonra piyasaya sürülen INT8'e özel ASIC'lere ve GPU entegre çiplerine pazar payını kaptırdı.
Bu satın almanın yanı sıra Intel, 16 Mayıs 2018'de, kendi donanımında nicelleştirme ve grafik optimizasyonunu tekdüze bir şekilde ele almak için tasarlanmış bir yazılım yığını olan OpenVINO araç setinin ilk sürümünü yayınladı. OpenVINO'nun NNCF (Sinir Ağı Sıkıştırma Çerçevesi) bileşeni, INT8 nicelleştirme ve model sıkıştırmayı ele alır ve yalnızca Movidius ailesi VPU'larını değil, Intel CPU'larını ve entegre GPU'ları da kapsayan tek bir iş akışı aracılığıyla modelleri optimize etmek ve dağıtmak için tasarlanmıştır - tek bir hızlandırıcı çipe bağlı olmak yerine bir araç zinciri olarak hayatta kalması, bunun bir örneğini göstermektedir. Donanım nesillerinin hızla değiştiği bir alanda hayatta kalma stratejisi.
Tarihçe: Veri merkezi TPU soyunun varisi Edge TPU
Google Coral ürünlerinin içindeki Edge TPU, Google'ın veri merkezi sınıfı TPU'su (Tensor İşleme Birimi) için geliştirdiği aynı "sistolik dizi" hesaplama mimarisini, güç kısıtlamalı gömülü cihazlar için küçültülmüş bir tasarım olarak sunar. Sistolik dizi, çok sayıda çarpma-toplama birimini bir ızgarada düzenler ve verileri tek yönde, yalnızca bitişik birimler arasında aktarır; her talimat için kayıtlara ve belleğe erişmesi gereken genel amaçlı bir CPU'nun aksine, bu, son derece yüksek enerji verimliliğiyle büyük matris çarpımlarını gerçekleştirmesine olanak tanır. Google'ın veri merkezi TPU'ları bu ızgarayı muazzam ölçekte oluşturur ve sıvı soğutmalı bakır ısı dağıtıcılarla donatılmış bir kart üzerine birden fazla çip monte eder (Google tarafından yayınlanan aşağıdaki fotoğraf, sıvı soğutma tüpleriyle görünür şekilde birbirine bağlı dört çipli bir TPU v3 kartını göstermektedir). Edge TPU, aynı temel fikri korur ancak ızgarayı önemli ölçüde küçültür ve güç tüketimini tek haneli rakamlara düşürür. 4 watt güç tüketimi sayesinde, USB veri yolu veya M.2 yuvasının güç bütçesi dahilinde çalışabilir.
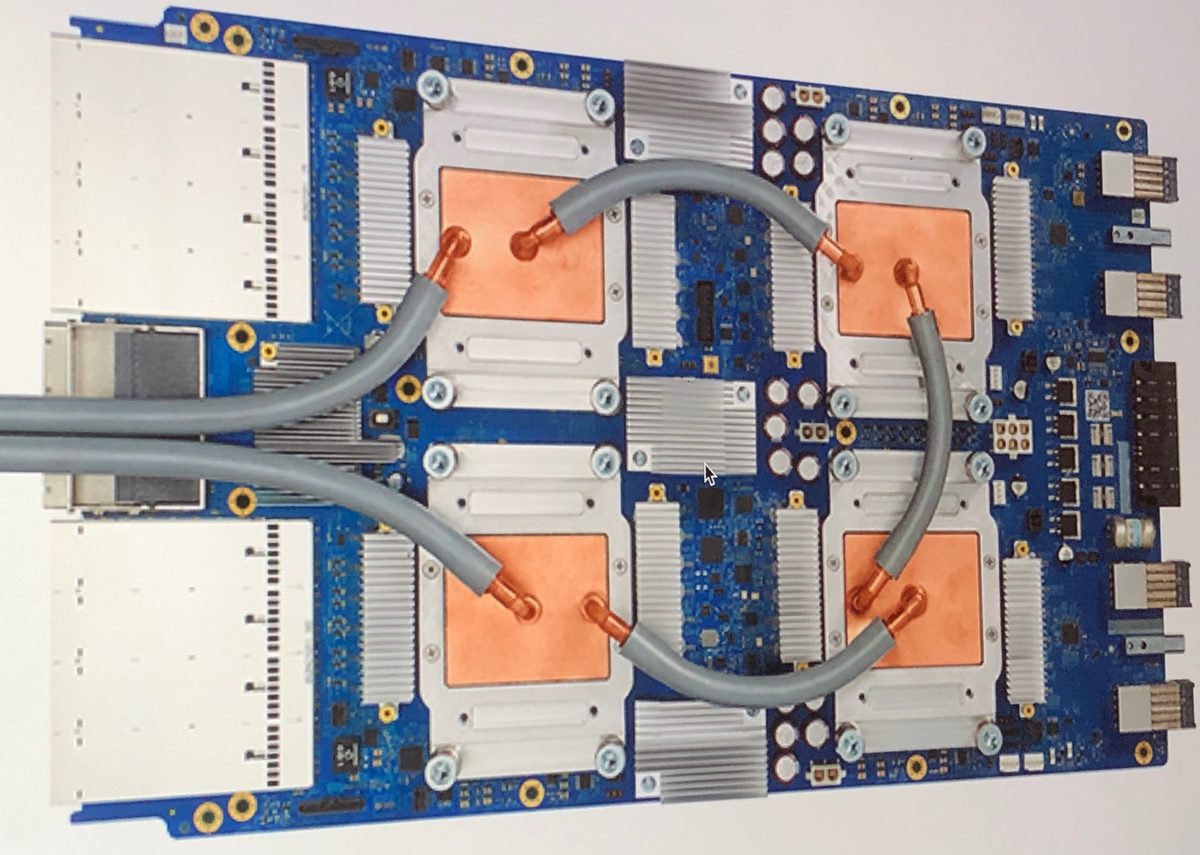
Resim: Tensor İşlem Birimi 3.0(Zinskauf, CC BY-SA 4.0), Wikimedia Commons. Veri merkezi sınıfı TPU v3'ün bir kart fotoğrafı - Edge TPU'nun kendisi değil, aynı sistolik dizi yaklaşımını paylaşan veri merkezi "ebeveyninin" ölçeğini gösteren bir referans.

2019'da Google, bu Edge TPU'yu (4 TOPS, 2W) taşıyan Geliştirici Kartı ve USB Hızlandırıcıyı piyasaya sürdü ve Raspberry Pi gibi mevcut SBC'ler için güç verimliliğiyle desteklenen bir eklenti hızlandırıcı olarak takipçi kazandı. Yaklaşık 400 kare/saniye hızında MobileNet v2 çalıştırabilen bir çıkarım yöntemi vardı. Ancak o zamandan beri Google, kayda değer yeni bir donanım piyasaya sürmeden ürün hattına yatırım yapmayı fiilen durdurdu ve 2026 itibariyle resmi coral.ai sitesi genel bir Google Geliştiriciler sayfasına yönlendiriliyor. Buna rağmen Coral ürünlerinin tamamen kullanım dışı kalmamasının nedeni, Google'ın sürücüleri ve bellenimi açık kaynak olarak yayınlaması ve Frigate NVR gibi nesne algılama gözetim yazılımı gibi topluluk projelerinin destek almasını ve donanımın üretimde kalmasını sağlamasıdır (ayrıntılar SBC karşılaştırma makalesinde daha ayrıntılı olarak açıklanmıştır).
Gerçek dünya örneği: Skydio X2 drone'da tek bir Jetson TX2 üzerinde eş zamanlı olarak çalışan dokuz sinir ağı
Tek bir hızlandırıcı çipin birden fazla sinir ağını paralel olarak çalıştırmasına önde gelen bir örnek, otonom uçan drone Skydio X2/X2D'dir. X2, ana işlemci olarak NVIDIA Tegra X2'yi (Jetson TX2'de bulunan aynı SoC) taşır. Altı adet yerleşik kameradan (üç stereo çift, bir trinoküler konfigürasyon) gelen verileri işleyen işlemci çipi, dokuz adet özel olarak tasarlanmış derin sinir ağını eş zamanlı olarak, tamamen yerleşik olarak çalıştırır. Bu çıkarım çıktılarını kullanarak, 20 adede kadar eş zamanlı ilgi nesnesini (engeller, insanlar veya araçlar gibi nesneler) takip edebilirken, saniyede bir milyondan fazla noktayı aşan bir hızda güncellenen 3 boyutlu bir dünya modeli oluşturur ve bu dünya modelini uçuş komutlarına dönüştüren karar döngüsü 500 Hz hızında çalışır. GPS'e güvenmeden yoğun ormanlarda veya kapalı alanlarda engellerden kaçınarak hızlı bir şekilde uçabilmesinin nedeni, tüm bu işlem hattının buluta aktarılmak yerine, yerleşik tek bir Tegra X2 üzerinde tamamlanmasıdır.

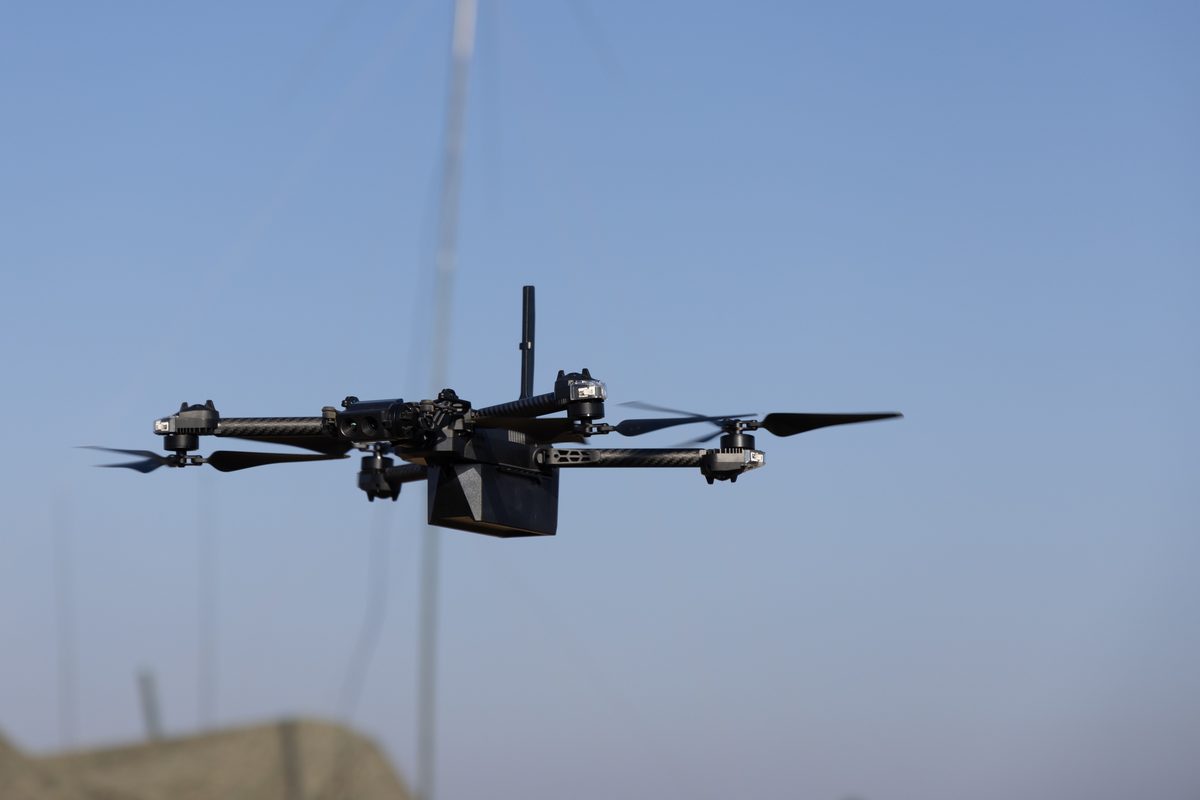 Eğitim sırasında uçan bir Skydio X2D (Camp Schwab, Okinawa)
Resimler: Skydio X2D uçağı inceliyor(Mauricio Campino, Kamu malı) / ABD Deniz Piyadeleri İHA Operasyonları Uyguluyor (9269101)(Kamu malı, ABD Deniz Piyade Kolordusu), her ikisi de Wikimedia aracılığıyla Ortak Alanlar.
X2D tanımı, Savunma Bakanlığı varyantını ifade eder ve kamuoyuna açıklanan ABD Savunma Bakanlığı fotoğraflarında kaydedilen gerçek konuşlandırmalar arasında, Delaware, Dover Hava Kuvvetleri Üssü'ndeki 436. Görev Üretim Grubu'nun bir KC-10 Extender havadan yakıt ikmal uçağının yapısal bütünlüğünü incelemek için bir X2D kullanması (Kasım 2022), Okinawa, Camp Schwab'da eğitim gören 5. Hava-Deniz Topçu İrtibat Bölüğü (5. ANGLICO) ve Almanya'daki Hohenfels Eğitim Alanı'nda eğitim gören 10. Dağ Tümeni yer almaktadır; her ikisi de Skydio X2D'yi küçük insansız hava aracı sistemi (sUAS) olarak kullanmaktadır. Halefi olan X10, Tegra X2'den Jetson Orin nesli SoC'ye geçiyor ve navigasyon kameralarını 32 megapiksele yükseltiyor; bu, çip başına TOPS'taki artışın nesiller boyunca gerçek operasyonel kazanımlara nasıl doğrudan yansıdığının iyi bir örneği: daha fazla sinir ağının eş zamanlı olarak çalışması, daha fazla eş zamanlı olarak izlenen nesne ve daha yüksek frekanslı karar döngüsü.

Bir hobi meraklısının "yapay zeka cihazından" cihaz üzerinde eğitimin sınırına
Bir zamanlar robotik ve savunma uygulamalarına odaklanan GPU entegre hızlandırıcılar, 2026 yılı itibariyle bireysel ve küçük ölçekli geliştiricilere de ulaşmaya başladı. Bulgaristan'ın ID Robots şirketi tarafından üretilen "ClawBox", avuç içi büyüklüğünde bir muhafaza içinde soğutma fanı ve yan havalandırma ile donatılmış bir NVIDIA Jetson Orin Nano taşıyan bir yapay zeka asistanı donanım cihazıdır; robotik iş yükleri için tasarlanmış aynı SoM'yi olduğu gibi yeniden kullanıyor. Bir insansız hava aracı veya endüstriyel robotun "beyni" olarak tasarlanan bir çipin, küçük bir girişim şirketi tarafından üretilen ve yüzlerce veya birkaç bin adetlik seri halinde piyasaya sürülen bir ürüne doğrudan entegre edilebilmesi, GPU entegre hızlandırıcıların genelliğinin gücünü vurgulamaktadır; özel bir ASIC'in aksine, bunlar rastgele CUDA modellerini olduğu gibi çalıştırabilirler.
İkinci ve ilgili bir eğilim ise, bir zamanlar yalnızca çıkarım odaklı olan uç hızlandırıcıları, cihaz üzerinde eğitime (bir modeli doğrudan cihaz üzerinde yeniden eğitmeye) doğru iten araştırmalardır. Temmuz 2026'da yayınlanan "Edge AI Çıkarım Hızlandırıcı ile Cihaz Üzerinde Model Uyarlamayı Güçlendirme" (Piechocki, Capotondi, Kraft, arXiv:2607.18101) başlıklı makale, çıkarım ve eğitim işlerini çipler arasında bölen Hailo-8L'yi (yukarıda bahsedilen Hailo-8'in alt kademe bir kardeşi) kullanan bir işlem hattı öneriyor: nicelleştirilmiş omurganın çıkarımı Hailo-8L üzerinde çalışırken, yalnızca hafif son katmanlar CPU'da FP32'de artımlı olarak ince ayarlanıyor. Makale, cihaz üzerinde eğitim için Raspberry Pi 5'e kıyasla 15,4 kata kadar gerçek zamanlı hızlanma bildirmektedir; bu, nicelleştirme ve grafik derleme gibi aynı temel teknoloji yığını üzerine kurulu, "yalnızca çıkarım" önermesinin aşınmaya başladığı bir araştırma sınırına bir bakış sunmaktadır.
Performansı Belirleyen Parametreler
- TOPS/W verimliliği ve hassasiyet esnekliği: Coral Edge TPU, 2 TOPS/W ile oldukça verimlidir, ancak bu, yalnızca INT8'e önceden nicelenmiş sabit grafiklerin çalıştırılması kısıtlamasıyla birlikte gelir. Buna karşılık, Jetson Orin NX, Coral'ın TOPS/W'sinin gerisinde kalma pahasına, FP16/INT8 karışımında keyfi CUDA modellerini çalıştırabilir. Bir projenin ne kadar esneklikten vazgeçebileceği genellikle çip seçiminde ilk karar verme noktasıdır.
- Derleyici katılığı: Hiçbir desteklenmeyen operatöre izin vermeyen Coral Edge TPU Derleyicisi gibi tamamen sabit grafikli bir derleyici, model tasarımının baştan itibaren desteklenen operatörlerle sınırlandırılmasını zorunlu kılar. TensorRT/OpenVINO gibi kısmi yük boşaltma derleyicileri daha fazla taşıma esnekliği sunar, ancak bir CPU geri dönüşü tetiklendiğinde ortaya çıkan hız kaybını gözden kaçırmak kolaydır.
- Nicelleştirme yöntemi seçimi (PTQ vs. QAT): Sadece az miktarda temsili veri gerektiren PTQ, geliştirilmesi ucuzdur ancak birçok aykırı değere sahip modellerde daha büyük doğruluk kaybına eğilimlidir. QAT, yeniden eğitim geçişine mal olur ancak bu bozulmayı bastırır. Movidius Myriad X neslinin VPU'ları, esas olarak FP16 etrafında inşa edilmiş olup, tasarım gereği nicelleştirmenin kalibrasyon çabasını tamamen atlar.
- Arayüz bant genişliği: Coral USB Hızlandırıcı veya NCS2 gibi USB bağlantılı cihazlar, birkaç ünite birleştirildiğinde ana bilgisayar tarafında USB veri yolu bant genişliği darboğazına takılabilir (ayrıntılar SBC karşılaştırma makalesinde Frigate NVR örneğinde verilmiştir). Hailo-8 veya SoM entegre Jetson'lar gibi M.2/PCIe bağlantılı cihazlar bu kısıtlamaya daha az maruz kalıyor.
- Tedarik sürekliliği ve yol haritası: Intel'in Movidius NCS2'si kendi teknik özellik sayfasında açıkça "Üretimi Durduruldu" olarak işaretlenmiş ve Coral'ın resmi sitesi artık başka bir yere yönlendiriyor, Jetson serisi ise yeni nesillerini göndermeye devam ediyor. Uzun süreli bir proje için, tedarik sürekliliği, tek seferlik TOPS/dolar karşılaştırmasının ötesinde bir risk faktörü haline gelir.
- Fiyat-performans ($/TOPS): Basit bir $/TOPS bazında, Jetson Orin Nano Super ($249/67 TOPS ≈ $3.7/TOPS) ve Jetson Orin NX ($599/100 TOPS ≈ $6/TOPS), Hailo-8'den ($110/26 TOPS ≈ $4.2/TOPS) veya Coral'dan ($75–99/4 TOPS ≈ $19–25/TOPS) daha ucuz görünebilir — ancak nihai seçim, yalnızca ham performans ve birim fiyatına değil, belirli bir ürünün gerçekten karşılayabileceği kasa boyutu ve güç bütçesine karşı dengeye bağlıdır.
anlayışınız

Yorumlar
Lütfen önce giriş yapın.
Henüz veri yok.