Contents — find the section you need
Ein KI-Inferenzbeschleuniger ist ein Chip, der speziell für die Durchführung des Inferenzdurchlaufs eines trainierten neuronalen Netzes – also der reinen Vorwärtsberechnung – entwickelt wurde und dabei deutlich energieeffizienter als eine CPU oder GPU arbeitet. Das zugrundeliegende physikalische Prinzip ist einfach: Die Umwandlung von in 32-Bit-Gleitkommazahlen (FP32) trainierten Gewichten in eine weniger präzise Darstellung wie 8-Bit-Ganzzahlen (INT8) – die Quantisierung – ermöglicht es denselben Recheneinheiten und derselben Speicherbandbreite, deutlich mehr parallele Operationen auszuführen. Dieser Artikel vergleicht keine Einplatinencomputer (SBCs) als Gesamtsysteme, sondern konzentriert sich ausschließlich auf die Designphilosophie und das Quantisierungsprinzip von Beschleunigerchips, die speziell für die Inferenz entwickelt wurden: Google Coral (Edge TPU), Intel Movidius (Myriad X) und NVIDIA Jetson Orin NX.
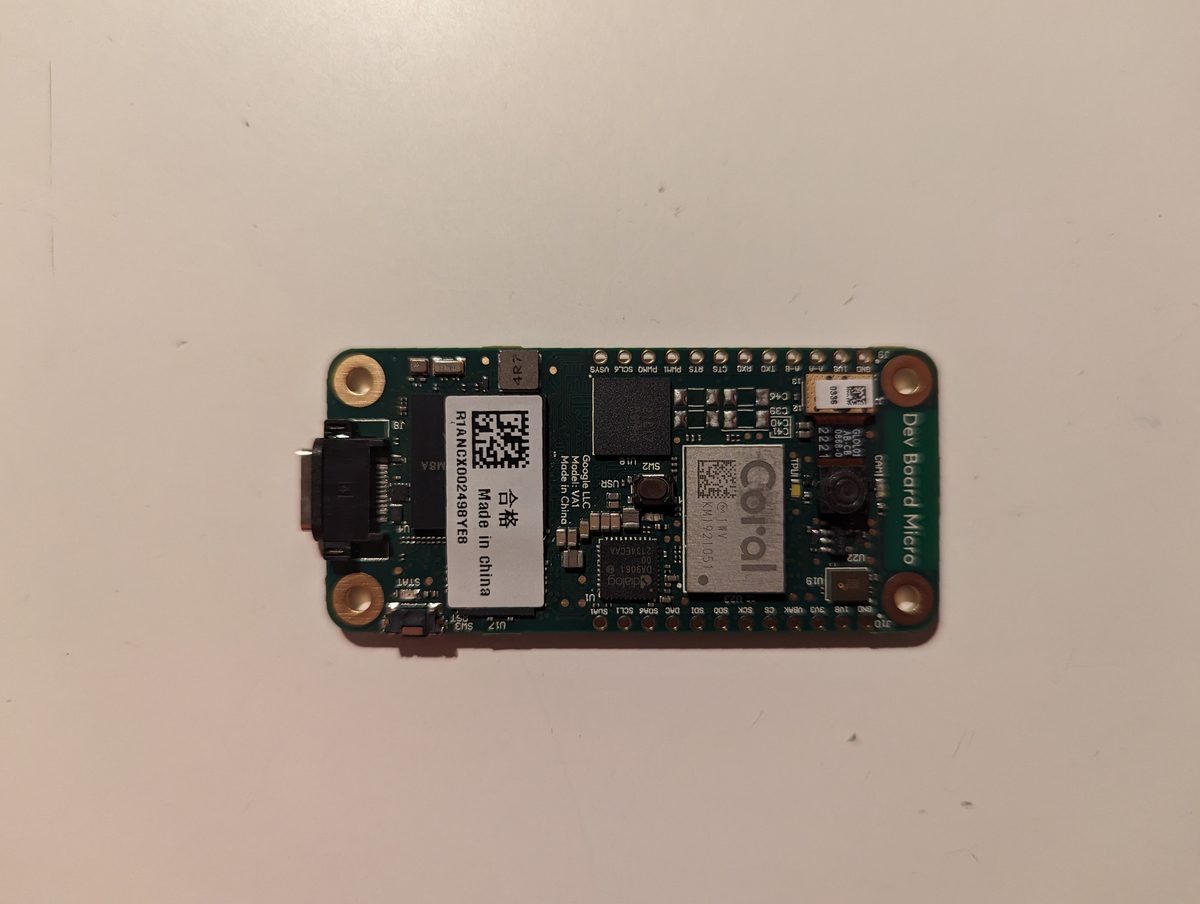 Google Coral Dev Board Micro
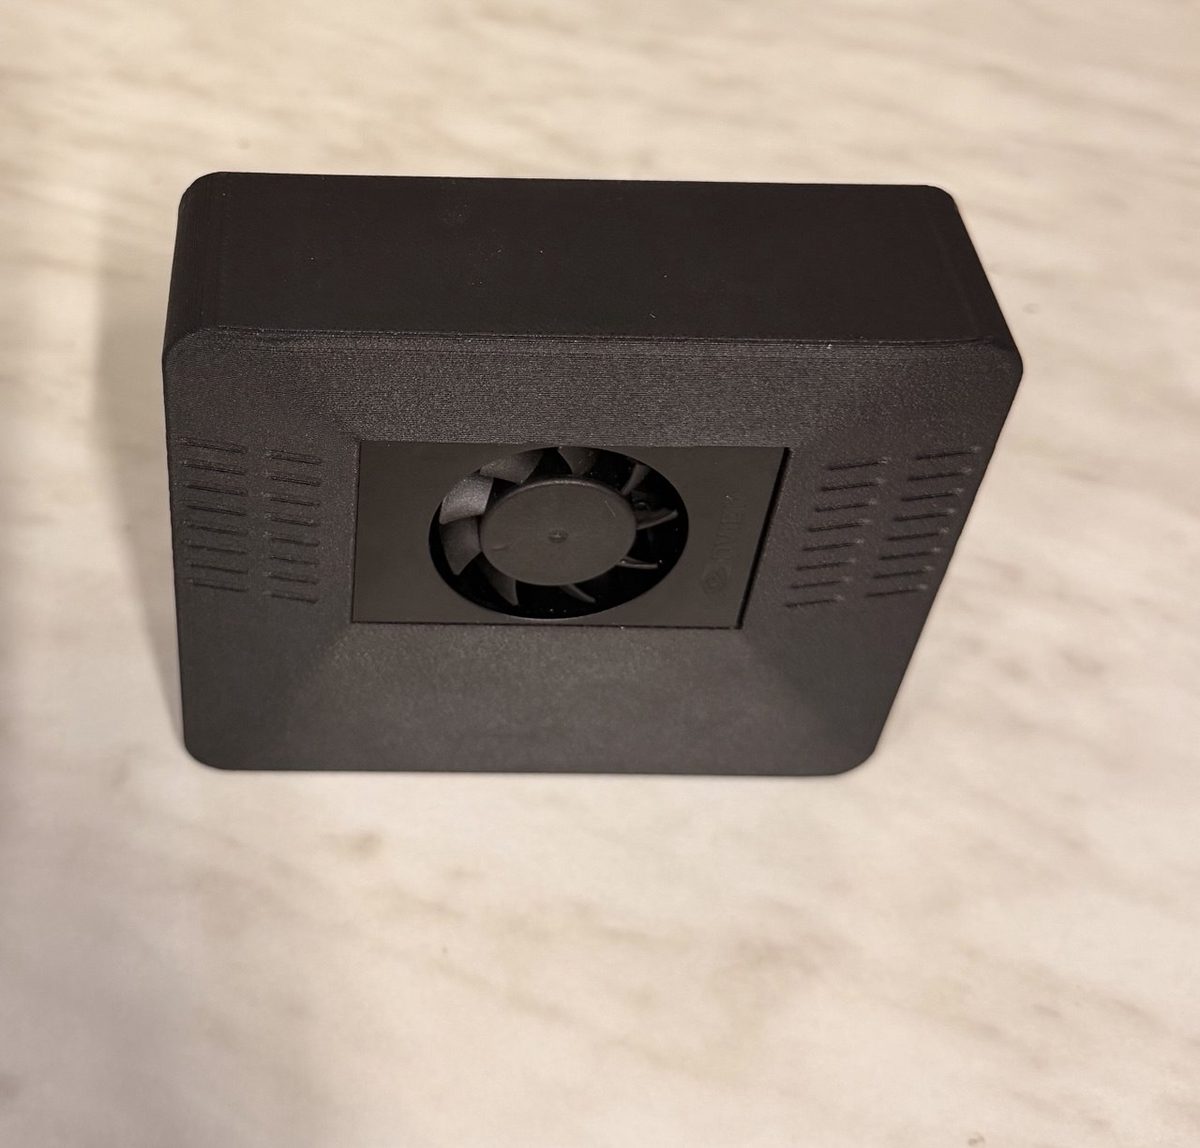 ClawBox, entwickelt auf einem NVIDIA Jetson Orin Nano (2026, ID Robots)
Bilder: Hardware PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA 2.0) / ClawBox KI-Assistentengerät (2026) - Vorderseite(Kkralev, CC BY-SA 4.0), beide via Wikimedia Commons.
.jpg)
_-_front.jpg)
Prinzip: Was die INT8-Quantisierung bewirkt
Die gängigste Methode, FP32-Gewichte und -Aktivierungen in 8-Bit-Ganzzahlen umzuwandeln, ist die lineare (affine) Quantisierung. Die Formel zur Umwandlung eines reellen Wertes x in eine Ganzzahl q lautet:
Hierbei ist s die Skalierung (die reelle Breite eines Ganzzahlschritts), z der Nullpunkt (der Offset, der angibt, welcher Ganzzahlschritt der reellen Null entspricht) und b die Bitbreite (8 für INT8). Zum Zeitpunkt der Inferenz wird der Wert näherungsweise als x \approx s(q-z) wiederhergestellt. In der Praxis bedeutet diese Quantisierung, dass die Genauigkeitsverluste direkt davon abhängen, wie eng die Werteverteilung begrenzt werden kann. Bei denselben 256 Schritten (INT8) hält ein enger Wertebereich die Breite jedes Schritts – den Quantisierungsfehler – gering; ein durch Ausreißer erweiterter Bereich führt zu einer geringeren Streuung der 256 Schritte und damit zu einer gröberen Darstellung der typischen Werte, die den Großteil der Verteilung ausmachen.
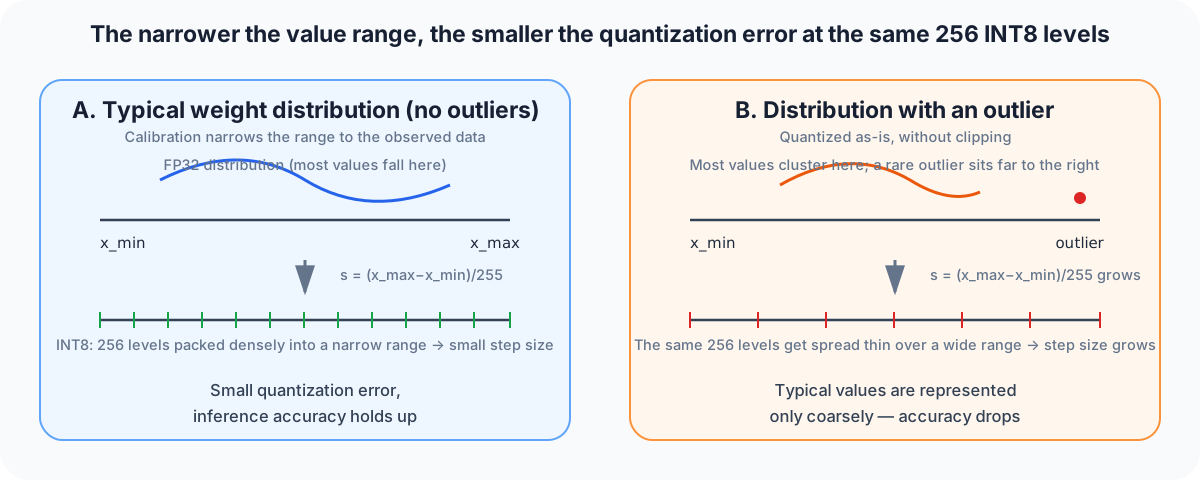
Diagramm: Duskcoil. Veranschaulicht, wie das Vorhandensein oder Fehlen einer „Kalibrierung“ – der Begrenzung des Wertebereichs anhand realer Messdaten – den Quantisierungsfehler selbst bei gleicher Bitbreite erheblich beeinflusst.
Die Festlegung dieses Wertebereichs ist der Kalibrierungsschritt, und die Quantisierung folgt im Wesentlichen zwei Ansätzen. Post-Training Quantization (PTQ) verarbeitet einfach eine kleine Menge repräsentativer Daten mit dem trainierten FP32-Modell und berechnet die Skalierung s aus dem beobachteten Ausgabebereich jeder Schicht – ein ressourcenschonender Ansatz, der jedoch bei Modellen mit vielen Ausreißern zu größeren Genauigkeitsverlusten führen kann. Quantization-Aware Training (QAT) simuliert den durch die Quantisierung während des Trainings selbst entstehenden Rundungsfehler. Die Gewichte werden entsprechend aktualisiert; dies unterdrückt Genauigkeitsverluste, erfordert jedoch einen erneuten Trainingsdurchlauf. Der Edge TPU Compiler, TensorRT und OpenVINO unterstützen beide Ansätze. Da die meisten Edge-Inferenzchips ihre Katalogleistung (TOPS) jedoch unter der Annahme von INT8 angeben, besteht die praktische Entscheidung darin, ob PTQ ausreichende Genauigkeit liefert oder ob ein Wechsel zu QAT notwendig ist.
Hinzu kommt eine weitere Komplikation: VPUs (Vision Processing Units), die um 2017 entwickelt wurden, wie beispielsweise die Movidius Myriad X, verwendeten FP16 (Halbgenauigkeits-Gleitkomma) anstelle von INT8 als primäre Rechengenauigkeit. FP16 halbiert den Speicherbedarf und die Bandbreitenanforderung im Vergleich zu FP32 und stellt – da es ein Exponentenfeld beibehält – einen großen Dynamikbereich ohne die für INT8 übliche Bereichskalibrierung dar. Es erreicht jedoch nicht die Parallelität von INT8, was ein Grund dafür ist, dass die späteren Coral Edge TPU und Jetsons Tensor Cores, die beide auf dedizierten INT8-Datenpfaden basieren, mehrere multipliziert mit TOPS/W.
Prinzip: Der Graph-Compiler als zweite Achse der Inferenzbeschleunigung
Neben der Quantisierung ist die Art und Weise, wie ein trainiertes Modell für den Befehlssatz eines bestimmten Chips kompiliert wird, der andere entscheidende Faktor für den Durchsatz in der Praxis. Ein aus TensorFlow Lite oder ONNX exportiertes Modell ist an sich ein generischer Graph, der Schicht für Schicht sequenziell auf einer CPU ausgeführt wird. Die Compiler der einzelnen Hersteller wenden im Wesentlichen drei Arten von Optimierungen auf diesen Graphen an.
-
Operatorfusion: Eine Sequenz wie Convolution→BatchNorm→ReLU wird zu einem einzigen fusionierten Kernel zusammengeführt. Zwischenergebnisse werden in Registern gespeichert, anstatt sie zurück in den Speicher zu schreiben, wodurch die Anzahl der Speicherzugriffe reduziert wird.
-
Layout-Transformation: Das CPU-optimierte NCHW-Layout (Kanal zuerst) und das Vektor-Unit-optimierte NHWC-Layout (Kanal zuletzt) werden neu ausgewählt, um dem tatsächlichen Speicherzugriffsmuster der Zielhardware zu entsprechen.
-
Kompilierung zu einem festen Graphen: Einige Compiler wie der Coral Edge TPU Compiler akzeptieren ausschließlich vollständig statische Graphen, die ausschließlich aus unterstützten Operatoren bestehen. Dynamische Formen oder nicht unterstützte Operationen sind kategorisch ausgeschlossen. Sobald auch nur ein einziger nicht unterstützter Operator im Modell auftaucht, wird die Ausführung zwischen CPU und Edge TPU aufgeteilt. Der dadurch entstehende bidirektionale Datentransfer kann die Geschwindigkeit erheblich beeinträchtigen.
NVIDIAs TensorRT und Intels OpenVINO verfolgen einen flexibleren Ansatz der „partiellen Auslagerung“: Nicht unterstützte Operatoren werden an die CPU zurückverwiesen, während die restlichen Operationen vom Beschleuniger ausgeführt werden. Der Coral Edge TPU Compiler hingegen bietet eine Alles-oder-Nichts-Entscheidung: entweder ein vollständig unterstützter Graph oder gar keine Beschleunigung. Dieser Unterschied spiegelt sich nicht in Hardware-Metriken wie den im SBC-Vergleichsartikel beschriebenen TOPS/Speicherbandbreiten-Kompromissen wider – er liegt vielmehr in der Designphilosophie des Software-Stacks begründet und beeinflusst die tatsächlichen Kosten der Modellportierung maßgeblich.
Wichtigster Chip Vergleich: Coral, Movidius, Jetson
| Produkt | Präzision | KI-Leistung | Stromverbrauch | Schnittstelle | Preis |
|---|---|---|---|---|---|
| Google Coral Edge TPU (USB-Beschleuniger) | Nur INT8 | 4 TOPS (2 TOPS/W) | 2 W | USB 3.0 | ca. 75–99 € (Einführung 2019) |
| Intel Movidius Myriad X (Neural Compute Stick 2) | Hauptsächlich FP16 | Entspricht ca. 4 TOPS (keine offizielle Angabe) | ca. 1,5–2,5 W | USB 3.0 | ca. 79–99 € (Einführung 2018, nicht mehr erhältlich) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10,4 TOPS/W) | ca. 2,5 W | M.2/PCIe | ca. 110 € |
NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (MAXN Super-Modus) | 7–25 W | SoM (integriertes Modul) | 249 $ |
NVIDIA Jetson Orin NX (16 GB) | INT8 | 100 TOPS | 10–25 W | SoM (integriertes Modul) | 599 $ |
Auf der offiziellen Spezifikationsseite von Intels Movidius Myriad X wird kein exakter TOPS-Wert angegeben. Mehrere Tests sprechen jedoch von „über 4 Billionen Operationen pro Sekunde“. Intel selbst gibt an, dass Myriad X mehr als zehnmal schneller als Myriad 2 (100–150 GFLOPS) ist. Die Kombination aus 16 programmierbaren SHAVE-Vektorprozessorkernen und der Neural Compute Engine – einem dedizierten Block, der mit Myriad X eingeführt wurde – ermöglicht die gleichzeitige Verarbeitung von sechs Kameras mit 720p (drei Stereopaare) bei 60 fps. Hailo-8 und die Jetson Orin Nano Super/NX werden im SBC-Vergleichsartikel ausführlicher behandelt. Daher beschränkt sich dieser Artikel auf die obigen Tabelleneinträge, um Wiederholungen zu vermeiden.
Die Coral-Produktreihe umfasst auch das Dev Board Micro, eine Weiterentwicklung des oben genannten USB Accelerators. Anstelle eines Linux-fähigen Anwendungsprozessors kombiniert es den Edge-TPU-Coprozessor mit einem permanent aktiven, stromsparenden Mikrocontroller (MCU). Dieses Board ist speziell für batteriebetriebene TinyML-Anwendungen wie die permanente Sprach- oder Vibrationserkennung konzipiert. Während das Dev Board/USB Accelerator einen Allzweck-SoC mit einer externen Edge TPU kombiniert, verfolgt das Dev Board Micro einen völlig anderen Anwendungsfall: die permanente Erkennung von Signalen.
Geschichte: Eine VPU-Designphilosophie, die aus Intels Übernahme von Movidius hervorging
Movidius war ein in San Mateo ansässiges Startup-Unternehmen, das stromsparende Chips für die Bildverarbeitung entwickelte und im September 2016 von Intel übernommen wurde. Die vor der Übernahme entwickelte Myriad 2 VPU (Vision Processing Unit) besaß kein universelles CPU-ähnliches Design; stattdessen kombinierte sie dedizierte Hardwareblöcke für Computer Vision mit 12 speziell entwickelten Vektorprozessorkernen (SHAVE). Nach der Übernahme kam sie in Seriengeräten wie Googles Lifelogging-Kamera „Clips“, FLIRs Wärmebildkamera „Firefly“, DJIs Drohne „Phantom 4“ und Tencents „DeepGaze“ zum Einsatz. Ihr Nachfolger, Myriad X, wurde 2017 angekündigt. Er erweiterte die Anzahl der SHAVE-Kerne auf 16 und fügte – erstmals – einen dedizierten Hardwareblock für neuronale Netzwerkinferenz hinzu, die Neural Compute Engine. Damit erreichte er mehr als die zehnfache Leistung von Myriad 2 und über 1 TeraFLOPS. Der oben erwähnte Neural Compute Stick 2 (NCS2) ist ein USB-Stick mit einer einzelnen Myriad X, der im vierten Quartal 2018 auf den Markt kam; Intels Produktseite kennzeichnet ihn nun als solchen. „Eingestellt“ – ein VPU-Chip, der einst die Anfänge der Edge-KI repräsentierte und den Markt später an die INT8-spezifischen ASICs und GPU-integrierten Chips abgeben musste.
Parallel zu dieser Übernahme veröffentlichte Intel am 16. Mai 2018 die erste Version seines OpenVINO-Toolkits. Dieser Software-Stack sollte Quantisierung und Graphoptimierung einheitlich auf der eigenen Hardware handhaben. Die NNCF-Komponente (Neural Network Compression Framework) von OpenVINO übernimmt die INT8-Quantisierung und Modellkomprimierung und wurde entwickelt, um Modelle über einen einzigen Workflow zu optimieren und bereitzustellen, der nicht nur VPUs der Movidius-Familie, sondern auch Intel-CPUs und integrierte GPUs umfasst. Dass es sich als Toolchain und nicht an einen einzelnen Beschleunigerchip gebunden gehalten hat, verdeutlicht eine Überlebensstrategie in einem Bereich, in dem sich Hardwaregenerationen rasant verändern.
Geschichte: Edge TPU, Nachfolger der Rechenzentrums-TPU-Familie
Die in Google Coral-Produkten integrierte Edge TPU ist ein skalierbares Design für Leistungsbeschränkte eingebettete Geräte nutzen dieselbe „systolische Array“-Rechenarchitektur, die Google für seine TPU (Tensor Processing Unit) der Rechenzentrumsklasse entwickelt hat. Ein systolisches Array ordnet eine große Anzahl von Multiplikations-Akkumulations-Einheiten in einem Raster an und streamt Daten in eine Richtung, wobei sie nur zwischen benachbarten Einheiten weitergegeben werden. Im Gegensatz zu einer Allzweck-CPU, die für jede Anweisung auf Register und Speicher zugreifen muss, ermöglicht dies die Durchführung großer Matrixmultiplikationen mit extrem hoher Energieeffizienz. Googles Rechenzentrums-TPUs bauen dieses Raster in enormem Maßstab auf und montieren mehrere Chips auf einer Platine mit flüssigkeitsgekühlten Kupfer-Wärmeverteilern (das untenstehende, von Google veröffentlichte Foto zeigt eine TPU v3-Platine mit vier Chips, die sichtbar durch Flüssigkeitskühlschläuche verbunden sind). Die Edge TPU behält dieses Grundprinzip bei, verkleinert jedoch das Raster drastisch und reduziert den Stromverbrauch auf einstellige Wattzahlen, sodass sie innerhalb des Leistungsbudgets eines USB-Busses oder eines M.2-Steckplatzes betrieben werden kann.
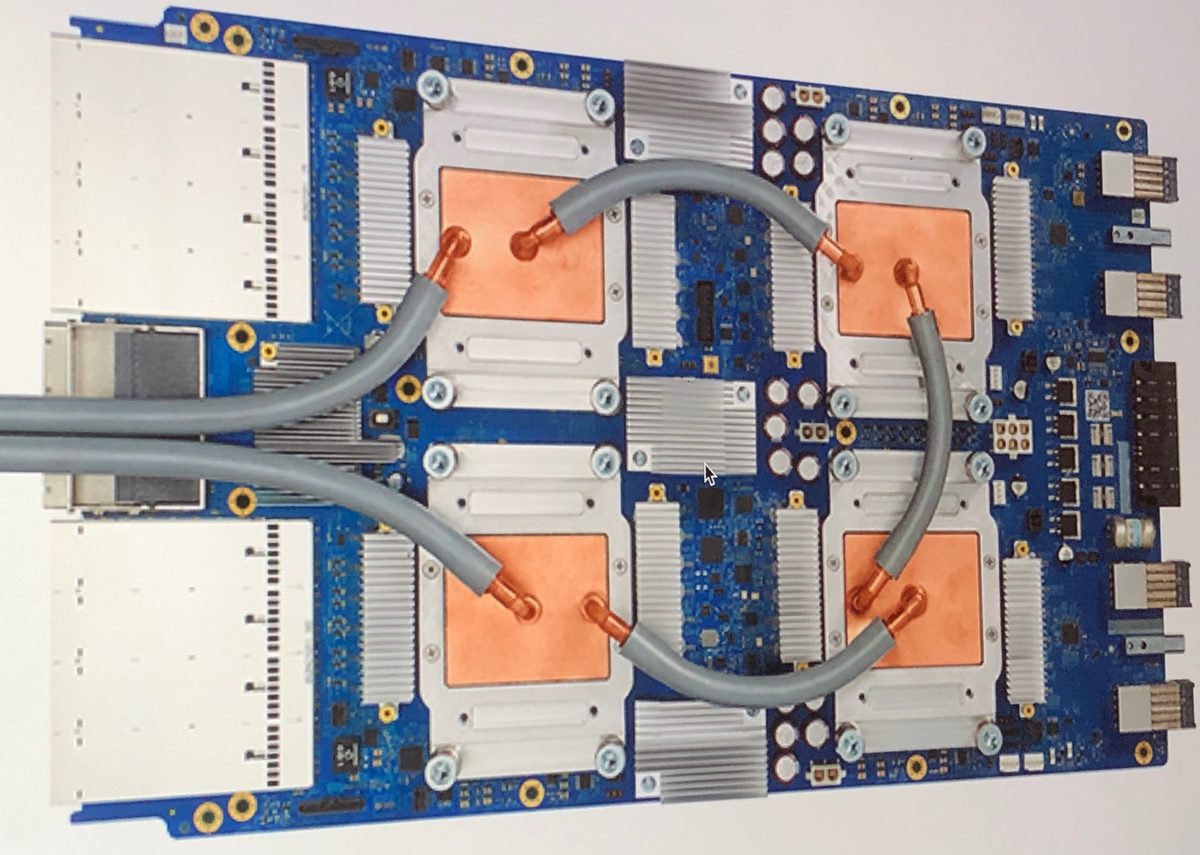
Bild: Tensor Processing Unit 3.0(Zinskauf, CC BY-SA 4.0), Wikimedia Commons. Ein Foto der Rechenzentrums-TPU v3 – nicht die Edge TPU selbst, sondern ein Referenzbild, das die Größe des Rechenzentrums-„Elternteils“ zeigt, der denselben systolischen Array-Ansatz verwendet.

2019 brachte Google das Dev Board und den USB-Beschleuniger mit dieser Edge TPU (4 TOPS, 2 W) auf den Markt. Das Board erfreute sich als Zusatzbeschleuniger für bestehende Einplatinencomputer wie den Raspberry Pi großer Beliebtheit und bot energieeffiziente Inferenz, die MobileNet v2 mit etwa 400 Bildern pro Sekunde ausführen konnte. Seitdem hat Google jedoch die Investitionen in diese Produktlinie praktisch eingestellt, ohne nennenswerte neue Hardware auf den Markt zu bringen. Ab 2026 leitet die offizielle Website coral.ai auf eine generische Google Developers-Website weiter. Seite. Der Grund, warum Coral-Produkte trotz allem nicht völlig außer Gebrauch gekommen sind, liegt darin, dass Google die Treiber und die Firmware als Open Source veröffentlicht hat. Dadurch konnten Community-Projekte wie die Objekterkennungssoftware Frigate NVR die Unterstützung übernehmen und die Hardware weiterhin in der Produktion einsetzen (weitere Details im SBC-Vergleichsartikel).
Praxisbeispiel: Neun neuronale Netze laufen gleichzeitig auf einem einzigen Jetson TX2 an Bord einer Skydio X2-Drohne
Ein Paradebeispiel für einen einzelnen Beschleunigerchip, der mehrere neuronale Netze parallel betreibt, ist die autonome Flugdrohne Skydio X2/X2D. Die X2 verwendet einen NVIDIA Tegra X2 – denselben SoC wie der Jetson TX2 – als Hauptprozessor. Dieser verarbeitet die Daten von sechs Bordkameras (drei Stereopaare, eine trinokulare Konfiguration), um neun speziell entwickelte Deep Neural Networks gleichzeitig und vollständig an Bord auszuführen. Mithilfe dieser Ergebnisse kann sie bis zu 20 Objekte gleichzeitig verfolgen – Hindernisse, Personen usw. wie Personen oder Fahrzeuge – während gleichzeitig ein 3D-Weltmodell mit einer Aktualisierungsrate von über einer Million Punkten pro Sekunde erstellt wird und die Entscheidungsschleife, die dieses Weltmodell in Flugbefehle umsetzt, mit einer Frequenz von 500 Hz läuft. Der Grund, warum die Drohne schnell durch dichte Wälder oder Innenräume fliegen und Hindernissen ausweichen kann, ohne auf GPS angewiesen zu sein, liegt darin, dass diese gesamte Verarbeitung auf einem einzigen Tegra X2-Prozessor an Bord erfolgt, anstatt in die Cloud ausgelagert zu werden.
 Skydio X2D inspiziert einen KC-10 Extender (Dover Air Force Base)
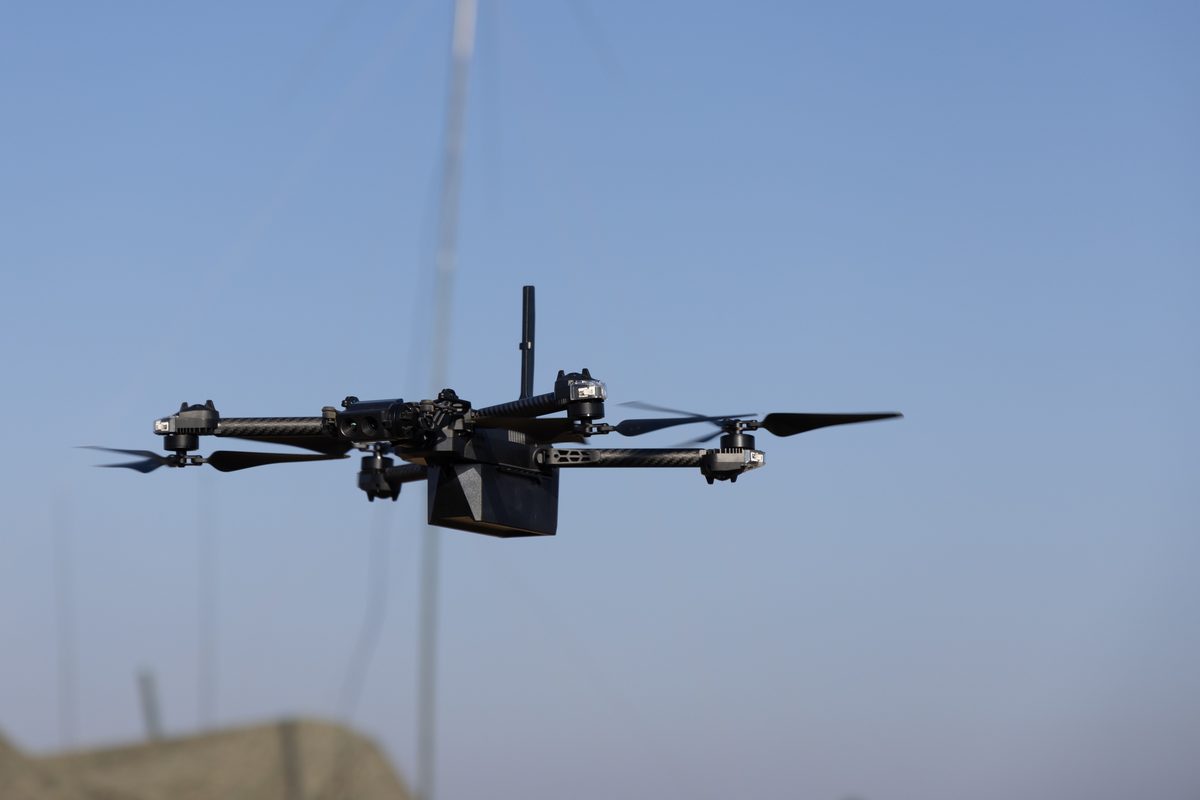 Eine Skydio X2D im Flug während des Trainings (Camp Schwab, Okinawa)
Bilder: Skydio X2D bei der Inspektion eines Flugzeugs (Mauricio Campino, gemeinfrei) / US Marines üben UAS-Einsätze (9269101) (gemeinfrei, U.S. Marine Corps), beide via Wikimedia Commons.
Die Bezeichnung X2D bezieht sich auf die Variante des US-Verteidigungsministeriums. Zu den realen Einsätzen, die auf öffentlich zugänglichen Fotos des US-Verteidigungsministeriums dokumentiert sind, gehört beispielsweise die 436th Mission Generation Group auf der Dover Air Force Base in Delaware, die mit einer X2D die strukturelle Integrität eines KC-10 Extender-Luftbetankungsflugzeugs inspizierte (November 2022). Die 5. Luft- und Marineartillerie-Verbindungskompanie (5. ANGLICO) trainiert in Camp Schwab, Okinawa, und die 10. Gebirgsdivision auf dem Truppenübungsplatz Hohenfels in Deutschland. Beide Systeme nutzen die Skydio X2D als kleines unbemanntes Flugsystem (sUAS). Ihr Nachfolger, die X10, wechselt vom Tegra X2 zu einem SoC der Jetson-Orin-Generation und verbessert seine Navigationskameras auf 32 Megapixel – ein gutes Beispiel dafür, wie ein Sprung in der TOPS-Leistung pro Chip über Generationen hinweg direkt zu realen operativen Vorteilen führt: mehr gleichzeitig laufende neuronale Netze an Bord, mehr gleichzeitig verfolgte Objekte und eine höhere Entscheidungsfrequenz.
.jpg)
Vom KI-Gerät für Hobbyisten zur Speerspitze des On-Device-Trainings
GPU-integrierte Beschleuniger, die einst auf Robotik- und Verteidigungsanwendungen konzentriert waren, werden bis 2026 auch von Einzelentwicklern und kleinen Unternehmen eingesetzt. „ClawBox“, entwickelt vom bulgarischen Unternehmen ID Robots, ist ein Hardware-Gerät mit KI-Unterstützung. Es ist mit einem NVIDIA Jetson Orin Nano ausgestattet und in einem handflächengroßen Gehäuse mit Lüfter und seitlicher Belüftung untergebracht. Dabei wird das ursprünglich für Roboteranwendungen entwickelte System-on-Module (SoM) unverändert wiederverwendet. Die Tatsache, dass ein Chip, der als „Gehirn“ einer Drohne oder eines Industrieroboters konzipiert ist, direkt in ein Produkt integriert werden kann, das von einem kleinen Startup in Hunderten oder Tausenden von Einheiten ausgeliefert wird, unterstreicht die Stärke der universellen Einsatzmöglichkeiten von GPU-integrierten Beschleunigern. Im Gegensatz zu dedizierten ASICs können sie beliebige CUDA-Modelle direkt ausführen.
Ein zweiter, damit zusammenhängender Trend ist die Forschung, die den ehemals rein auf Inferenz basierenden Edge-Beschleuniger hin zum On-Device-Training entwickelt – dem direkten Training eines Modells auf dem Gerät. Eine im Juli 2026 veröffentlichte Studie mit dem Titel „Empowering On-Device Model Adaptation with an Edge AI Inference Accelerator“ (Piechocki, Capotondi, Kraft, arXiv:2607.18101) schlägt eine Pipeline vor, die den Hailo-8L (einen leistungsschwächeren Chip des oben erwähnten Hailo-8) nutzt und Inferenz- und Trainingsprozesse auf verschiedene Chips verteilt: Die Inferenz des quantisierten Backbones läuft auf dem Hailo-8L, während lediglich die ressourcenschonenden letzten Schichten inkrementell in FP32 auf der CPU feinabgestimmt werden. Die Studie berichtet von einer bis zu 15,4-fachen Beschleunigung des On-Device-Trainings im Vergleich zu einem Raspberry Pi 5 allein – ein Einblick in ein Forschungsfeld, in dem die Annahme der reinen Inferenz zunehmend an Bedeutung verliert, basierend auf demselben zugrundeliegenden Technologie-Stack aus Quantisierung und Graphkompilation.
Leistungsbestimmende Parameter
-
TOPS/W-Effizienz versus Präzisionsflexibilität: Die Coral Edge TPU ist mit 2 TOPS/W hocheffizient, allerdings ist sie nur auf die Ausführung von festen, auf INT8 vorquantisierten Graphen beschränkt. Der Jetson Orin NX hingegen kann beliebige CUDA-Modelle in einer Mischung aus FP16 und INT8 ausführen, erreicht aber nicht die TOPS/W-Leistung der Coral. Wie viel Flexibilität ein Projekt aufgeben kann, ist üblicherweise der erste Entscheidungspunkt bei der Chipauswahl.
-
Compiler-Strenge: Ein Compiler mit ausschließlich festen Graphen wie der Coral Edge TPU Compiler, der keinerlei nicht unterstützte Operatoren zulässt, zwingt den Modellentwurf dazu, sich von Anfang an auf unterstützte Operatoren zu beschränken. Compiler mit partieller Auslagerung wie TensorRT/OpenVINO bieten mehr Flexibilität bei der Portierung, doch der Geschwindigkeitsverlust, der beim Auslösen eines CPU-Fallbacks auftritt, wird leicht übersehen.
-
Wahl des Quantisierungsverfahrens (PTQ vs. QAT): PTQ benötigt nur wenige repräsentative Daten und ist kostengünstig in der Entwicklung, neigt aber bei Modellen mit vielen Ausreißern zu größeren Genauigkeitsverlusten. QAT erfordert einen erneuten Trainingsdurchlauf, unterdrückt diese Verschlechterung jedoch. VPUs der Movidius Myriad X-Generation, die hauptsächlich auf FP16 basieren, umgehen den Kalibrierungsaufwand der Quantisierung von vornherein.
-
Schnittstellenbandbreite: USB-Geräte wie der Coral USB Accelerator oder NCS2 können bei der Kombination mehrerer Einheiten an einen Engpass der USB-Busbandbreite auf Host-Seite stoßen (detailliert im Fallbeispiel Frigate NVR im SBC-Vergleichsartikel beschrieben). Geräte mit M.2/PCIe-Anschluss wie der Hailo-8 oder SoM-integrierte Jetson-Systeme sind von dieser Einschränkung weniger betroffen.
– Lieferkontinuität und Roadmap: Intels Movidius NCS2 ist auf seiner Spezifikationsseite explizit als „eingestellt“ gekennzeichnet, und die offizielle Website von Coral leitet nun auf eine andere Seite weiter, während die Jetson-Produktreihe weiterhin neue Generationen ausliefert. Bei einem langfristigen Projekt wird die Versorgungssicherheit selbst zu einem Risikofaktor, der über einen einmaligen TOPS-pro-Dollar-Vergleich hinausgeht.
- **Preis-Leistungs-Verhältnis (/TOPS)**: Betrachtet man das Preis-Leistungs-Verhältnis (/TOPS), erscheinen der Jetson Orin Nano Super (249/67 TOPS ≈3,7/TOPS) und der Jetson Orin NX (599/100 TOPS ≈6/TOPS) günstiger als der Hailo-8 (110/26 TOPS ≈4,2/TOPS) oder der Coral (75–99/4 TOPS ≈19–25/TOPS). Die endgültige Entscheidung hängt jedoch vom Verhältnis zwischen Gehäusegröße und Leistungsbudget des jeweiligen Produkts ab, nicht allein von der reinen Leistung und dem Stückpreis.
Bedeutet die doppelte TOPS-Zahl die doppelte Anwendungsgeschwindigkeit?
Präzision, Speicher, unterstützte Operatoren, Übertragungen und Vorverarbeitung beeinflussen die Geschwindigkeit. Messen Sie die End-to-End-Latenz am tatsächlichen Modell.
Referenzen
- Neural Network Compression Framework (NNCF) — OpenVINO official
- OpenVINO (Wikipedia)
- Intel Neural Compute Stick 2 — Produktspezifikationen (Intel official)
- Test: Intel Neural Compute Stick 2 für Edge AI (viso.ai)
-
Intel übernimmt Computer-Vision-Unternehmen Movidius (Road to VR)
- Google Coral Edge TPU / Dev Board — CNX Software
- Coral Dev Board TPU (NXP)
- Cloud TPU-Systemarchitektur (Google Cloud offiziell)
- NVIDIA Jetson Orin NX 16GB Modul-Test (ThinkRobotics)
- NVIDIA Jetson Orin NX-Serie Datenblatt (NVIDIA Developer)
- Jetson Orin Nano Super Developer Kit (NVIDIA offiziell)
- Inception Spotlight: Skydio 2 Drohne mit NVIDIA Jetson (NVIDIA Technischer Blog)
- Skydio X10 vs. X2 Vergleich (THE FUTURE 3D)
- Ermöglichung der On-Device-Modellanpassung mit einem Edge-KI-Inferenzbeschleuniger (arXiv:2607.18101)
- Nachhaltige LLM-Inferenz für Edge-KI (arXiv:2504.03360)
- Hardware PXL 20231201 152957218 (53388218926) — Wikimedia Commons
- Tensor Processing Unit 3.0 — Wikimedia Commons
- ClawBox KI-Assistentengerät (2026) - Vorderseite — Wikimedia Commons
- Skydio X2D inspiziert Flugzeug — Wikimedia Commons
- US-Marineinfanteristen üben UAS-Operationen (9269101) – Wikimedia Commons


Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.