Contents — find the section you need
Ein Single-Board-Computer (SBC) ist ein kompakter Computer, der CPU, Speicher, Speicherschnittstellen und verschiedene Ein-/Ausgabeschnittstellen auf einer einzigen Platine integriert. In einem autonomen mobilen Roboter oder einer Drohne bildet er das „Gehirn“ für Selbstlokalisierung, Pfadplanung und Sensordatenverarbeitung. Weit entfernt von einem einfachen kleinen PC, variiert die Designphilosophie hinsichtlich der Integration von GPU- oder NPU-Leistung (Neural Processing Unit) für Inferenzprozesse je nach Produktlinie stark. Drei Ansätze laufen parallel: der universelle Linux-SoC Raspberry Pi, der GPU-integrierte KI-Computer NVIDIA Jetson und der dedizierte ASIC-Beschleuniger Google Coral.
 Raspberry Pi 5
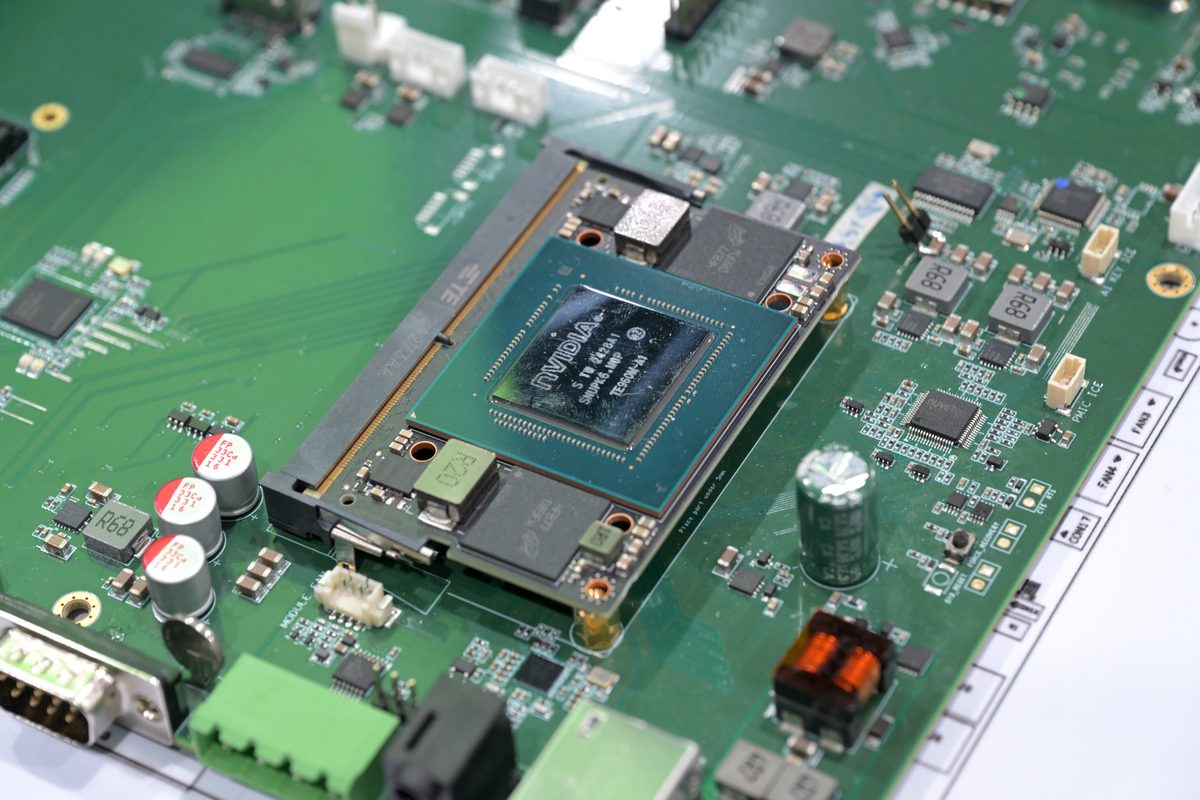 NVIDIA Jetson Orin NX (Computex 2025)
Bilder: Raspberry Pi 5 Board (SimonWaldherr, CC BY-SA 4.0) / Nvidia Jetson Orin NX on a motherboard Computex 2025 (4300streetcar, CC BY 4.0), beide Wikimedia Commons. Nicht der im Text verglichene Jetson Orin Nano Super, sondern ein Orin NX-Modul derselben Orin-Generation mit Ampere-Architektur. Da auf Wikimedia Commons kein klares Foto des Google Coral (Entwicklungsboard/USB-Beschleuniger) zu finden war, ist in diesem Artikel kein Produktfoto enthalten.


Prinzip: Die TOPS-Metrik und die „Speichergrenze“
Bei der Betrachtung der Leistung von Single-Board-Computern (SBCs) reicht die CPU-Taktfrequenz allein nicht mehr aus. Die Leistung einer für neuronale Netze spezialisierten GPU/NPU wird als Anzahl der pro Sekunde ausgeführten quantisierten Integer-Operationen (üblicherweise INT8) in TOPS (Tera-Operationen pro Sekunde – eine Billion Operationen pro Sekunde) angegeben. Die TOPS-Leistung lässt sich grob anhand der Anzahl der parallelen Multiplikations-Akkumulations-Einheiten (MAC) N_{MAC} und der Taktfrequenz f abschätzen:
Eine Multiplikations-Akkumulations-Operation zählt als zwei Operationen – eine Multiplikation plus eine Addition – daher der Faktor 2. NVIDIAs Jetson Orin Nano Super beispielsweise treibt 1024 CUDA-Kerne und 32 Tensor-Kerne mit etwa 1,7 GHz an und erreicht im leistungsoptimierten „MAXN Super“-Modus (25 W) 67 TOPS.
Der Großteil dieses TOPS-Wertes basiert auf 8-Bit-Integer-Arithmetik (INT8) anstelle von 32-Bit-Gleitkommaarithmetik (FP32). Die Quantisierung der während des Trainings verwendeten FP32-Gewichte auf INT8 vor der Inferenz reduziert theoretisch die Modellgröße und die benötigte Speicherbandbreite auf ein Viertel, sodass dieselben Recheneinheiten mehr parallele Operationen ausführen können. Es handelt sich um ein Design, das die Genauigkeit der Inferenz zugunsten eines maximalen Durchsatzes innerhalb eines begrenzten Leistungs- und Speicherbandbreitenbudgets opfert – und Jetson, Hailo und Coral geben alle Katalog-TOPS-Werte an, die diese INT8-Quantisierung voraussetzen.
Allerdings lässt sich der maximale Katalog-TOPS-Wert nicht automatisch in effektive Leistung umrechnen. Selbst die schnellsten Recheneinheiten bleiben ungenutzt, wenn die benötigten Daten (Gewichte, Zwischenmerkmale) nicht schnell genug aus dem Speicher geladen werden können. Das Roofline-Modell erfasst dies: Die effektive Leistung P ist auf den kleineren Wert aus maximalem Rechendurchsatz P_{peak} und der Speicherbandbreite BW multipliziert mit der arithmetischen Intensität (Operationen pro Byte) AI begrenzt.
Der LPDDR4X-4267-Speicher des Raspberry Pi 5 erreicht auf einem 32-Bit-Bus eine theoretische Bandbreite von maximal ca. 17,1 GB/s, im Vergleich zu 102 GB/s beim LPDDR5-Speicher des Jetson Orin Nano Super – also etwa das Sechsfache. Bei CPU-lastigen Anwendungen ist dieser Unterschied kaum spürbar. Bei der Inferenz neuronaler Netze, die große Gewichtsmatrizen in jedem Frame neu einlesen, wird diese Bandbreitenlücke jedoch zum limitierenden Faktor und bestimmt, wie viel des Katalog-TOPS-Werts tatsächlich erreicht werden kann.
Drei Designphilosophien: Allzweck-SoC, GPU-integriert, dedizierter ASIC
Produkte, die als „SBCs“ bezeichnet werden, lassen sich grob in drei Kategorien einteilen, je nachdem, wie sie KI-Inferenz handhaben.
Allzweck-SoC (Raspberry Pi) integriert eine CPU, eine GPU und verschiedene I/O-Controller, verfügt aber nicht über eine dedizierte NPU für die Inferenz neuronaler Netze. Es läuft mit einer vollständigen Linux-Distribution und seine größte Stärke liegt in der Möglichkeit, nahezu den gesamten bestehenden Software-Stack – einschließlich ROS 2 – unverändert zu nutzen. Das Design geht davon aus, dass bei Bedarf an Inferenzleistung ein externer Beschleuniger (z. B. Hailo, siehe unten) die fehlende Leistung bereitstellt.
Der GPU-integrierte KI-Computer (NVIDIA Jetson) integriert eine CUDA-programmierbare GPU und Tensor-Kerne in dasselbe Gehäuse wie einen Speicher mit hoher Bandbreite. Im Gegensatz zu einem dedizierten ASIC, der nur vorquantisierte, feste Berechnungsgraphen verarbeiten kann, bietet er die Flexibilität, beliebige CUDA-Kernel und PyTorch/TensorRT-Modelle direkt auszuführen und gleichzeitig deutlich mehr parallele Rechenleistung zu erzielen. Es gibt auch Produktlinien für höchste Zuverlässigkeit im Automobilbereich, wie beispielsweise den AGX Orin, der über die ISO 26262 ASIL-D-Zertifizierung für funktionale Sicherheit im Bereich autonomes Fahren und Robotik verfügt.
Dedizierte ASIC-Beschleuniger (Google Coral / Hailo) sind ASICs mit fester Funktion, die speziell für die Inferenz quantisierter neuronaler Netze entwickelt wurden und über USB oder M.2 an einen Host-SBC angeschlossen werden. Im Gegenzug für den Verlust an Vielseitigkeit erreichen sie eine deutlich höhere Effizienz (TOPS pro Watt) als die beiden anderen Ansätze.
Diese drei Kategorien schließen sich nicht gegenseitig aus, und in realen Roboterprojekten werden sie häufig kombiniert. Die Kombination eines Allzweck-SoC wie dem Raspberry Pi 5 mit einem ASIC-Beschleuniger (AI HAT+) ist ein Kompromiss, der sowohl die Vielseitigkeit des Linux/ROS 2-Software-Stacks als auch die Energieeffizienz der Auslagerung der Inferenz auf einen ASIC vereint. Wie die unten erwähnte Benchmark-Studie zeigt, kann diese Kombination die Effizienz eines eigenständigen, GPU-integrierten Computers erreichen.
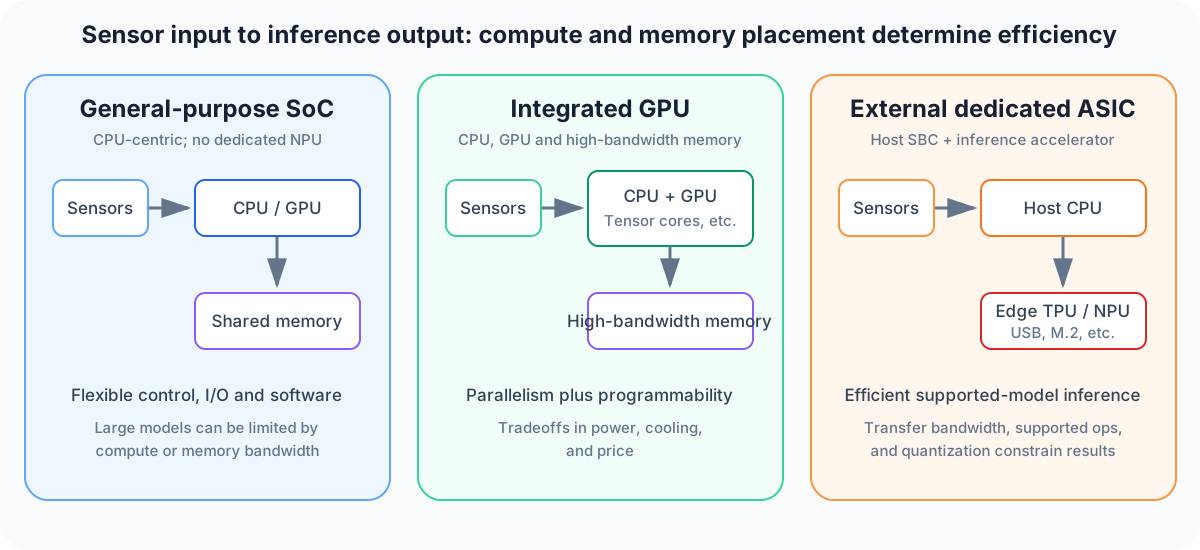
Diagramm: Duskcoil. Dies ist ein konzeptionelles Layout, keine Rangliste der Produktgeschwindigkeit. Die tatsächliche Leistung hängt vom Modell, der Präzision, der Software, der Speicherbandbreite und der Leistungskonfiguration ab.
Vergleich der wichtigsten Produktspezifikationen
| Produkt | Typ | Rechenkerne | KI-Leistung | Speicher | Leistungsaufnahme | Preis |
|---|---|---|---|---|---|---|
| Raspberry Pi 5 (16 GB) | Universelles SoC (ohne NPU) | Cortex-A76 4-Kern, 2,4 GHz | — (extern erforderlich) | LPDDR4X 16 GB (~17,1 GB/s) | 5 V/5 A Stromversorgung (max. 25 W) | 305 $ (Stand: April 2026) |
Raspberry Pi AI HAT+ (Hailo-8) | Dedizierter ASIC (RPi5-Erweiterungs-HAT) | Hailo-8 NPU | 26 TOPS (INT8) | — | ~2,5 W | 110 $ |
Google Coral USB Accelerator | Dedizierter ASIC (USB) | Edge TPU | 4 TOPS (INT8) | — | 2 W | ~75–99 $ |
NVIDIA Jetson Orin Nano Super | KI-Computer mit integrierter GPU | Cortex-A78AE 6-Kern, 1,7 GHz + Ampere-GPU, 1024 Kerne/32 Tensor-Kerne | 67 TOPS (INT8, MAXN Super-Modus) | 8 GB LPDDR5 (102 GB/s) | 7–25 W (variabel) | 249 $ |
NVIDIA Jetson AGX Orin (64 GB) | GPU-integrierter KI-Computer (Flaggschiff) | Cortex-A78AE 12-Kern + Ampere-GPU, 2048 Kerne/64 Tensor-Kerne | 275 TOPS (INT8) | LPDDR5 64 GB, 256 Bit | 15–60 W (variabel) | — |
Der Raspberry Pi 5 dient dem newbot project als Hauptsteuercomputer und übernimmt Edge-Side-Verarbeitung wie Selbstlokalisierung, Sicherheitsüberwachung und Sensordatenerfassung. Da die LiDAR-Inertial-Odometrie (FAST-LIO) von newbot ein Algorithmus ist, der vollständig auf der CPU läuft und das System keine permanente Inferenz großer neuronaler Netze benötigt, genügt ein Allzweck-SoC ohne dedizierte NPU. Umgekehrt benötigt ein Roboter, der auf Echtzeit-Objekterkennung oder -Segmentierung anhand von Kamerabildern basiert, in der Regel eine integrierte GPU wie Jetson oder einen externen Beschleuniger der Hailo/Coral-Klasse. Der Jetson Orin Nano Super hat zudem eine ungewöhnliche Geschichte: Ein Software-Update namens „Super Mode“ vom Dezember 2024 erhöhte die maximale Leistung und steigerte sie von 40 TOPS (499 US-Dollar) der Vorgängergeneration auf 67 TOPS (249 US-Dollar) – mehr Leistung zum halben Preis.
Geschichte: Nostalgie für den BBC Micro und der Kurswechsel eines Herstellers von Gaming-GPUs
Raspberry Pi: Auslöser war ein Rückgang der Zulassungen in Cambridge – Eben Upton, Gründer der Raspberry Pi Foundation, erhielt 1988 im Alter von 10 Jahren einen gebrauchten BBC Micro (einen Heimcomputer, den die BBC in den 1980er-Jahren für Bildungszwecke einsetzte) und machte damit seine ersten Programmiererfahrungen in BASIC. Später, während seiner Tätigkeit als Studiendirektor für Informatik an der Universität Cambridge um 2006, bemerkte er einen Anstieg von Bewerbern mit geringen Programmierkenntnissen und gleichzeitig einen Rückgang der Bewerbungen für den Studiengang Informatik (Computer Science Tripos). Da er das Verschwinden von Computern wie dem BBC Micro, die man einfach einschalten und sofort programmieren konnte, als eine Ursache sah, verbrachte Upton von 2006 bis 2011 Abende und Wochenenden damit, neben seiner Tätigkeit bei Broadcom einen kostengünstigen Einplatinencomputer (SBC) zu entwickeln. Die Raspberry Pi Foundation wurde 2009 offiziell gegründet, mit dem Ziel, einen „programmierbaren Computer für unter 35 US-Dollar“ zu entwickeln. 2011 präsentierten Mitarbeiter der Foundation der BBC einen Prototyp in der Hoffnung, den Namen „BBC Micro“ weiterzuführen. Dies scheiterte jedoch aus rechtlichen Gründen – stattdessen veröffentlichte ein BBC-Journalist ein Demovideo des Prototyps, das viral ging und die starke Nachfrage bereits vor dem offiziellen Verkaufsstart belegte.
Jetson: Ein Hersteller von Gaming-GPUs steigt 2014 in die Robotik ein – Im März 2014 präsentierte NVIDIA-CEO Jensen Huang persönlich den Jetson TK1 im Rahmen einer Keynote auf der GTC (GPU Technology Conference). Dieser kombinierte den für mobile Endgeräte konzipierten Tegra K1-Chip mit einer 192-Kern-GPU der Kepler-Architektur und erreichte 326 GFLOPS – für ein Embedded-Gerät zu dieser Zeit ein enormer Wert. Zudem wurde das CUDA-Programmiermodell eingeführt. Von Anfang an standen Anwendungsfälle wie Roboternavigation und Hindernisvermeidung für Drohnen im Fokus. Dies markierte NVIDIAs tatsächlichen Einstieg in den Markt für Embedded-Robotik, nachdem das Unternehmen bis dahin hauptsächlich im Bereich Gaming- und Rechenzentrums-GPUs tätig gewesen war.
Die Jetson-Produktreihe wurde in der Folgezeit etwa alle zwei Generationen mit einer aktualisierten GPU-Architektur ausgestattet: Der TX2 aus dem Jahr 2017 bot mit seiner 256-Kern-GPU der Pascal-Architektur die doppelte Leistung des TK1. Die Xavier-Generation (2018–2020) mit Volta-Architektur soll die 20-fache Leistung und die 10-fache Energieeffizienz des TX2 bieten; die Orin-Generation (2022) mit Ampere-Architektur folgt. Das Muster ist durchgängig: Architekturen, die zunächst im Markt für Gaming-GPUs eingeführt wurden, werden einige Jahre später für Embedded-Anwendungen adaptiert. Die technische Expertise von NVIDIA im Bereich Rechenzentrums- und PC-GPUs fließt direkt in die Leistungssteigerungen der Embedded-Robotikprodukte ein – die Kernkompetenz von Jetson.
Ein reales Anwendungsbeispiel: Ein Heim-NVR steuert mehrere Coral Edge TPUs an
Ein typisches Beispiel für einen dedizierten ASIC-Beschleuniger, der mehrere Geräte gleichzeitig betreibt, ist Frigate NVR, ein Open-Source-Paket für Aufzeichnung und Objekterkennung. Frigate analysiert Überwachungskamerabilder in Echtzeit und lagert die Personen-/Fahrzeugerkennung an Coral Edge TPUs aus. Die Architektur weist jeder TPU einen dedizierten Prozess zu und verteilt Erkennungsanfragen mehrerer Kameras über eine gemeinsame Warteschlange an diese Prozesse.
Ein einzelner Coral USB Accelerator (4 TOPS) kann die Echtzeiterkennung für etwa zwei bis vier 1080p-Streams allein bewältigen. Eine Konfiguration mit zwei 8-TOPS Coral Dual Edge TPU (M.2)-Karten soll Berichten zufolge über 20 Kameras gleichzeitig verarbeitet haben, wobei die Chipauslastung bei etwa 12 % lag. Andererseits ist bekannt, dass die Kombination mehrerer USB Acceleratoren die USB-Bus-Bandbreite des Hosts als Engpass darstellen kann, sodass die Leistung nicht linear mit der Anzahl der Geräte skaliert. Das Hinzufügen mehrerer dedizierter ASICs zu einem einzelnen NVR-Server zur Skalierung der Kameraanzahl ist ein Standard-Bereitstellungsmuster, das die geringen Kosten und den niedrigen Stromverbrauch pro TOPS nutzt.
Wie die Nachfrage von KI-Rechenzentren die Preise für Hobby-Einplatinencomputer in die Höhe trieb
Im Jahr 2026 sah sich Raspberry Pi gezwungen, die Preise wiederholt zu erhöhen – aus Gründen, die völlig außerhalb des Einflussbereichs des Unternehmens lagen. Ursache war eine Verknappung des Speichermarktes, ausgelöst durch die stark gestiegene Nachfrage von KI-Rechenzentren. Eben Upton, CEO der Raspberry Pi Foundation, gab selbst im Firmenblog bekannt, dass sich die Beschaffungskosten für den im Raspberry Pi 4/5 verwendeten LPDDR4-DRAM innerhalb eines Jahres versiebenfacht hatten. Nach einer Preiserhöhung im Dezember 2025 wurden in der ersten Jahreshälfte 2026 weitere Anhebungen angekündigt. Im April 2026 verteuerte sich das 16-GB-Modell um 100 US-Dollar auf 305 US-Dollar – mehr als das 2,5-Fache des Einführungspreises (Oktober 2024, als das 16-GB-Modell für 120 US-Dollar auf den Markt kam). Ironischerweise brachte die Stiftung parallel zu diesem Preisanstieg 2026 ein neues 1-GB-Modell für nur 45 US-Dollar auf den Markt – ein Beispiel dafür, wie die Nachfrage nach leistungsstarkem KI-Speicher bis in die Preisstruktur eines völlig anderen Marktes vordrang: Hobby-Embedded-Computer.
Coral, von Google aufgegeben, von der Community am Leben erhalten
Die Edge TPU in Coral nutzt dieselbe „systolische Array“-Architektur, die Google für seine Rechenzentrums-TPUs entwickelt hat – sie ist im Prinzip eine miniaturisierte Version. Während die TPU v1 im Rechenzentrumsmaßstab Training und Inferenz mit einem massiven 256×256-systolischen Array durchführt, verkleinert die Edge TPU dieses Array drastisch und reduziert den Stromverbrauch auf einstellige Wattzahlen. Dadurch kann sie in Embedded-Geräten mit begrenztem Energiebudget eingesetzt werden. Google brachte Coral 2019 mit dieser Edge-TPU (4 TOPS, 2 W) auf den Markt, die in einem Entwicklungsboard und einem USB-Beschleuniger integriert war. Dank seiner energieeffizienten Inferenz, die MobileNet v2 mit etwa 400 Bildern pro Sekunde ausführen konnte, etablierte sich Coral schnell als praktische Erweiterung für bestehende Einplatinencomputer wie den Raspberry Pi. Seitdem hat Google jedoch die Investitionen in die Produktlinie praktisch eingestellt, ohne nennenswerte neue Hardware auf den Markt zu bringen. Die meisten der zugehörigen Bibliotheken wurden seit etwa 2022 nicht mehr aktualisiert. Der für PCIe-angeschlossene Coral-Geräte benötigte GASKET-Treiber wird von aktuellen Linux-Kerneln weiterhin nicht unterstützt. Dass Coral nicht völlig in Vergessenheit geraten ist, liegt daran, dass Google die Treiber und Firmware als Open Source veröffentlicht hat. Projekte wie der bereits erwähnte Frigate NVR haben die Unterstützung selbst übernommen und den Produktivbetrieb aufrechterhalten – ein Beispiel dafür, wie offizielles Supportende und fortgesetzte Nutzung nebeneinander bestehen und die Diskrepanz zwischen den Produktzyklen von Hardware und der Lebensdauer von Open-Source-Software verdeutlichen. Das INT8-Quantisierungsprinzip der Edge TPU und der Vergleich ihrer Designphilosophie mit Intel Movidius (Myriad X) – einem anderen, inzwischen eingestellten Chip – werden im Vergleichsartikel für Edge-KI-Beschleuniger ausführlicher beschrieben.
Ist ein auf einem Einplatinencomputer aufgerüsteter Beschleuniger besser als Jetson? Eine Benchmark-Studie aus dem Jahr 2026
Eine im April 2026 veröffentlichte Studie zur Ausführung von Inferenz großer Sprachmodelle (LLM) auf Edge-Einplatinencomputern mit dem Titel „Cloud to Edge: Benchmarking LLM Inference on Hardware-Accelerated Single-Board Computers“ (Renney, Trad, Mattarock, Evetts, Wood) verglich den Stromverbrauch und den Durchsatz in vier Konfigurationen: einem Raspberry Pi 5 (nur CPU), einem Raspberry Pi 5 mit AI HAT+ (Hailo-10H NPU), einem Jetson Orin Nano Super (CPU- und GPU-Konfigurationen separat) und einem M5Stack LLM-Modul (AX630C NPU). Die Ergebnisse: Durch die Integration einer Hailo NPU in den Raspberry Pi 5 konnte die Effizienz der Token-Generierung pro Watt im Vergleich zur reinen CPU-Konfiguration um das 9,57- bis 39,97-Fache gesteigert werden. Gleichzeitig sank der Energieverbrauch pro Megatoken von 27–77 Megajoule auf 0,88–5,51 Megajoule. Im Hinblick auf den reinen Durchsatz war die GPU-Konfiguration des Jetson Orin Nano mit 9–10 Token pro Sekunde am schnellsten. Die Raspberry Pi 5 + Hailo-Konfiguration erreichte jedoch den gleichen Durchsatz wie die reine CPU-Konfiguration des Jetson bei etwa halbem Stromverbrauch und deutlich geringerem Platzbedarf. Diese Daten untermauern die Behauptung, dass eine Kombination aus Allzweck-SoC und dediziertem ASIC hinsichtlich der Energieeffizienz mit einem eigenständigen Computer mit integrierter GPU mithalten kann.
Leistungsbestimmende Parameter
-
TOPS/W (Effizienz): Bei akkubetriebenen kleinen Robotern und Drohnen ist die Leistung pro Watt oft wichtiger als die absolute Leistung. Der Hailo-8 sticht mit 26 TOPS/2,5 W (ca. 10,4 TOPS/W) hervor, während der Jetson Orin Nano Super im MAXN-Super-Modus nur etwa 2,7 TOPS/W (67 TOPS/25 W) erreicht. Beachten Sie jedoch, dass dies die Flexibilität einschränkt, beliebige CUDA-Modelle ausführen zu können, im Gegensatz zu einem dedizierten ASIC, der auf feste Graphen beschränkt ist.
-
Speicherbandbreite: Bei der Inferenz neuronaler Netze, die große Gewichtsmatrizen in jedem Frame neu einlesen, ist die Speicherbandbreite häufiger der limitierende Faktor als die reine Rechenleistung. Der LPDDR5-Speicher des Jetson Orin Nano Super (102 GB/s) ist etwa sechsmal so schnell wie der LPDDR4X-Speicher des Raspberry Pi 5 (~17,1 GB/s). Dieser Unterschied bestimmt, wie viel des Katalog-TOPS-Werts tatsächlich erreicht werden kann.
-
Kompatibilität mit bestehender Software: Ein Raspberry Pi 5 kann eine Standard-Linux-Distribution und ROS 2 ohne weitere Konfiguration ausführen, während ASIC-Beschleuniger wie Coral/Hailo nur vorquantisierte, vorkompilierte feste Graphen verarbeiten können. Welche Kombination optimal ist, hängt davon ab, ob Sie sich in einer Entwicklungsphase mit häufigen Modelländerungen befinden oder in einer Produktionsphase mit ausschließlich finalisierten Inferenzdaten.
-
Lieferrisiko und Roadmap-Kontinuität: Ein Produkt wie Coral, bei dem der Anbieter die Investitionen praktisch eingestellt hat, lebt vom Wohlwollen der Community – ein echtes Risiko für die Akzeptanz neuer Nutzer in einem langjährigen Projekt. Jetson hingegen pflegt Produktlinien, die auf Roadmap-Kontinuität ausgelegt sind, wie beispielsweise die Automobil-Zertifizierung nach ISO 26262 ASIL-D für den AGX Orin.
-
Preisschwankungen außerhalb des Marktes: Wie die Preiserhöhungen für den Raspberry Pi im Jahr 2026 zeigen, können die Preise für Single-Board-Computer (SBCs) aufgrund von Faktoren, die völlig außerhalb eines bestimmten Projekts liegen – wie der Nachfrage von KI-Rechenzentren –, stark schwanken. Bei der Beschaffungsplanung für langfristige Installationen muss neben dem Stückpreis auch die Versorgungssicherheit berücksichtigt werden.
-
Verfügbarkeit von Erweiterungsschnittstellen: Die PCIe 2.0 x1-Lane des Raspberry Pi 5 ist zu schmal, um einen Beschleuniger wie den AI HAT+ mit voller Leistung zu betreiben. In manchen Fällen kann auch die Leistung des Hailo-8 (ausgelegt für PCIe Gen3, 2 Lanes) nicht voll ausgeschöpft werden – eine praktische Einschränkung, die bei jeder nachträglich hinzugefügten Beschleunigerkonfiguration beachtet werden sollte.
-
Gehäusegröße und Wärmeableitung: Ein ultrakompaktes Modul wie das M5Stack LLM-Modul (54 × 54 × 13 mm) kann trotz geringerer absoluter Leistung eine höhere Durchsatzdichte pro Volumeneinheit aufweisen. Dies unterscheidet sich grundlegend von einem Modul mit Kühlkörper wie dem Jetson AGX Orin, das hinsichtlich des Gehäuses oder der Gehäusegröße eine größere Rolle spielt. Bei Drohnen oder kleinen Roboterarmen mit begrenztem Platz und Gewicht ist die Leistung pro Volumeneinheit neben TOPS und TOPS/W ein wichtiges Auswahlkriterium.
Verhindert eine schnellere CPU Engpässe bei der Kameraverarbeitung?
Speicherbandbreite, E/A, Stromverbrauch und Kühlung können den Durchsatz begrenzen. Messen Sie den Dauerbetrieb mit den tatsächlichen Peripheriegeräten.
Referenzen
- Raspberry Pi 5 Produktseite
- Raspberry Pi 5 Produktübersicht (PDF)
- Raspberry Pi 5 mit 1 GB jetzt für 45 $ erhältlich, speicherbedingte Preiserhöhungen (Raspberry Pi)
- Weitere speicherbedingte Preiserhöhungen (Raspberry Pi)
- Raspberry Pi 5 Preis steigt drastisch aufgrund von KI-Mangel (Tom's Hardware)
- NVIDIA Jetson Orin Produktseite
- Jetson Orin Nano Super Developer Kit (NVIDIA)
-
Nvidias neues KI-Entwicklungsboard für 249 US-Dollar verspricht 67 TOPS (Tom's Hardware)
-
NVIDIA JetPack 6.2 bringt den Super-Modus auf Jetson Orin Nano und Orin NX (NVIDIA Developer Blog)
-
Jetson TK1: Mobiler Embedded-Supercomputer bringt CUDA überall hin (NVIDIA Technical Blog)
-
Coral TPU wahrscheinlich eingestellt (Frigate GitHub-Diskussion)
-
Steigerung der Inferenzgeschwindigkeit mit 2 TPUs im Vergleich zu 1 TPU (Frigate GitHub) Diskussion)](https://github.com/blakeblackshear/frigate/discussions/4125)
- Objektdetektoren (Frigate-Dokumentation)
- Raspberry Pi AI HAT+ Produktseite (Raspberry Pi)
- Hailo-8 KI-Beschleuniger (Hailo)
- Hailo-8 M.2 Produktbeschreibung (Hailo PDF)
- BBC Micro und Raspberry Pi (Raspberry Pi)
- Das Leben des Pi: Zehn Jahre Raspberry Pi (Universität Cambridge)
- Cloud to Edge: Benchmarking von LLM-Inferenz auf hardwarebeschleunigten Einplatinencomputern (arXiv:2604.24785)
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.