Contents — find the section you need
Un SBC (ordinateur monocarte) est un ordinateur compact intégrant un processeur, de la mémoire, des interfaces de stockage et diverses entrées/sorties sur une seule carte. Dans un robot mobile autonome ou un drone, il constitue le « cerveau » de l'autolocalisation, de la planification de trajectoire et du traitement des données des capteurs. Bien plus qu'un simple mini-PC, la conception de l'intégration d'un GPU ou d'un NPU (unité de traitement neuronal) pour l'inférence varie considérablement selon les gammes de produits. Trois approches coexistent : le SoC Linux généraliste du Raspberry Pi, l'ordinateur d'IA avec GPU intégré NVIDIA Jetson et l'accélérateur ASIC dédié Google Coral.
 Raspberry Pi 5
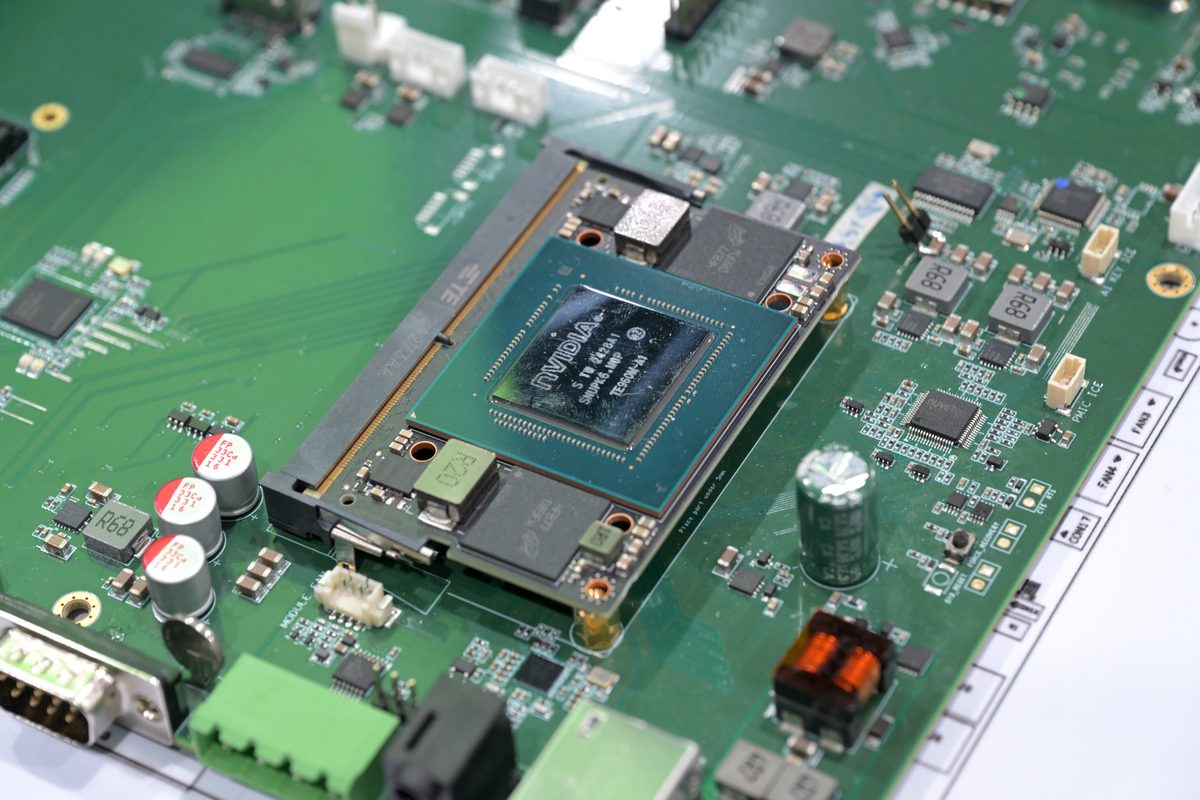 NVIDIA Jetson Orin NX (Computex 2025)
Images : Raspberry Carte Pi 5 (SimonWaldherr, CC BY-SA 4.0) / Nvidia Jetson Orin NX sur une carte mère Computex 2025 (4300streetcar, CC BY 4.0), toutes deux issues de Wikimedia Commons. Il ne s'agit pas du Jetson Orin Nano Super exact comparé dans le texte, mais d'un module Orin NX de la même génération Orin et d'architecture Ampere. Aucune photo nette du Google Coral (carte de développement/accélérateur USB) n'ayant été trouvée sur Wikimedia Commons, aucune photo du produit n'est incluse dans cet article.


Principe : la métrique TOPS et le « mur de la mémoire »
Lorsqu'on aborde les performances des SBC, la fréquence d'horloge du processeur à elle seule ne suffit plus. Les performances d'un GPU/NPU spécialisé dans l'inférence de réseaux neuronaux sont exprimées en nombre d'opérations sur entiers quantifiés (généralement INT8) exécutées par seconde, en TOPS (téra-opérations par seconde – mille milliards d'opérations par seconde). On peut estimer approximativement la puissance de calcul (TOPS) à partir du nombre d'unités de multiplication-accumulation (MAC) parallèles et de la fréquence d'horloge :
Une opération de multiplication-accumulation compte pour deux opérations (une multiplication et une addition), d'où le facteur 2. Par exemple, le Jetson Orin Nano Super de NVIDIA, doté de 1 024 cœurs CUDA et de 32 cœurs Tensor à environ 1,7 GHz, atteint 67 TOPS dans son mode « MAXN Super » (25 W), où la limite de consommation est rehaussée.
Cette valeur de TOPS est calculée sur la base d'une arithmétique entière 8 bits (INT8) plutôt qu'en virgule flottante 32 bits (FP32). La quantification des poids FP32 utilisés pendant l'entraînement en INT8 avant l'inférence permet théoriquement de réduire d'un quart la taille du modèle et la bande passante mémoire requise, ce qui permet aux mêmes unités de calcul d'effectuer davantage d'opérations parallèles. Il s'agit d'une conception qui privilégie le débit maximal à la précision d'inférence, compte tenu des contraintes de consommation d'énergie et de bande passante mémoire. Jetson, Hailo et Coral affichent tous des performances TOPS catalogue basées sur cette quantification INT8.
Cependant, les performances TOPS catalogue maximales ne se traduisent pas automatiquement par des performances effectives. Aussi rapides que soient les unités de calcul, elles restent inactives si les données nécessaires (poids, caractéristiques intermédiaires) ne peuvent être extraites de la mémoire suffisamment rapidement. Le modèle de performance maximale (Roofline Model) reflète ce phénomène : les performances effectives (P) sont plafonnées à la plus petite des deux valeurs suivantes : le débit de calcul maximal (P_{peak}) et la bande passante mémoire (BW) multipliée par l'intensité arithmétique (opérations par octet) (AI).
La mémoire LPDDR4X-4267 du Raspberry Pi 5, sur un bus 32 bits, atteint une bande passante théorique maximale d'environ 17,1 Go/s, contre 102 Go/s pour la LPDDR5 du Jetson Orin Nano Super – soit environ six fois plus. Cette différence est rarement perceptible pour les charges de travail gourmandes en ressources CPU, mais pour l'inférence de réseaux neuronaux nécessitant la relecture de grandes matrices de poids à chaque image, cet écart de bande passante devient le facteur limitant le débit, déterminant la part du TOPS du catalogue que vous pouvez réellement extraire.
Trois philosophies de conception : SoC à usage général, GPU intégré, ASIC dédié
Les produits appelés « SBC » se répartissent en trois grandes catégories selon leur gestion de l'inférence IA.
SoC à usage général (Raspberry Pi) intègre un CPU, un GPU et divers contrôleurs d'E/S, mais ne dispose pas d'une unité de traitement neuronal (NPU) dédiée à l'inférence de réseaux neuronaux. Il exécute une distribution Linux complète et son principal atout réside dans sa capacité à utiliser la quasi-totalité d'une pile logicielle existante, y compris ROS 2, sans modification. Sa conception repose sur le principe qu'en cas de besoin de performances d'inférence accrues, un accélérateur externe (Hailo, présenté ci-dessous, par exemple) prend le relais.
L'ordinateur IA à GPU intégré (NVIDIA Jetson) intègre un GPU programmable CUDA et des cœurs Tensor dans un même boîtier, ainsi qu'une mémoire à large bande passante. Contrairement à un ASIC dédié, limité à l'exécution de graphes de calcul fixes et pré-quantifiés, il offre la flexibilité nécessaire pour exécuter directement des noyaux CUDA et des modèles PyTorch/TensorRT arbitraires, tout en proposant une puissance de calcul parallèle considérablement supérieure. Des gammes de produits existent également pour une fiabilité de niveau automobile, comme l'AGX Orin, certifié ISO 26262 ASIL-D pour la sécurité fonctionnelle dans les domaines de la conduite autonome et de la robotique.
L'accélérateur ASIC dédié (Google Coral / Hailo) se présente sous la forme d'un ASIC à fonction fixe, spécialisé exclusivement dans l'inférence de réseaux neuronaux quantifiés, et ajouté à une carte mère (SBC) via USB ou M.2. En contrepartie d'une polyvalence réduite, il offre une efficacité (TOPS par watt) bien supérieure aux deux autres approches.
Ces trois catégories ne sont pas mutuellement exclusives et sont souvent combinées dans les projets robotiques. Associer un SoC généraliste comme le Raspberry Pi 5 à un accélérateur ASIC (AI HAT+) constitue un compromis visant à tirer parti à la fois de la richesse de la pile logicielle Linux/ROS 2 et de l'efficacité énergétique du déchargement de l'inférence sur un ASIC. Comme le montre l'étude comparative présentée ci-dessous, cette combinaison peut approcher l'efficacité d'un ordinateur autonome intégrant un GPU.
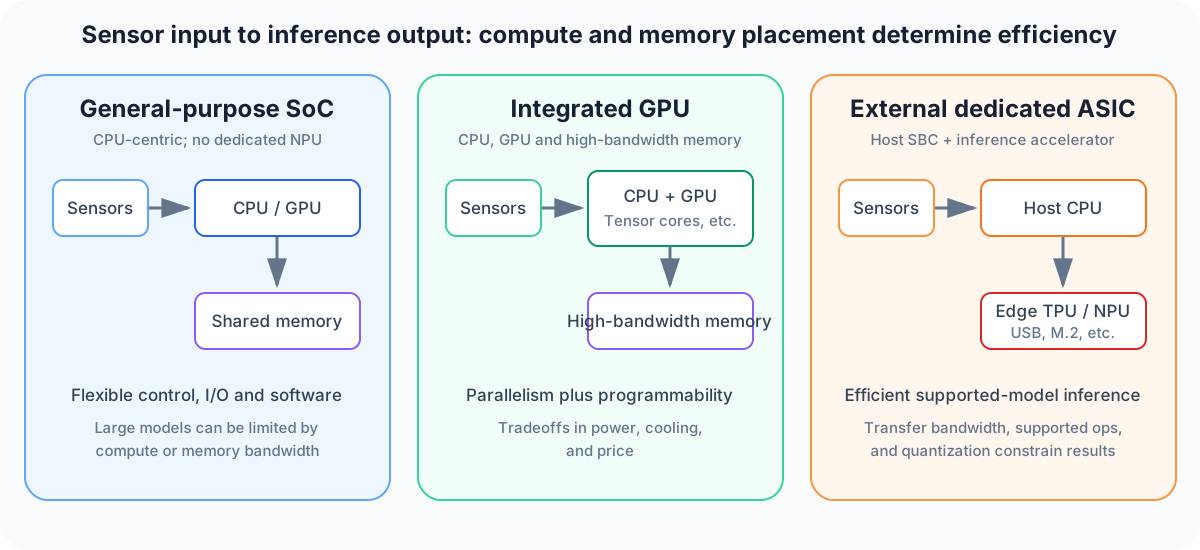
Schéma : Duskcoil. Il s'agit d'une représentation conceptuelle et non d'un classement des performances. Les performances réelles dépendent du modèle, de la précision, du logiciel, de la bande passante mémoire et de la configuration d'alimentation.
Comparaison des principales spécifications des produits
| Produit | Type | Cœurs de calcul | Performances IA | Mémoire | Consommation | Prix |
|---|---|---|---|---|---|---|
| Raspberry Pi 5 (16 Go) | SoC à usage général (sans NPU) | Cortex-A76 quadricœur, 2,4 GHz | — (externe nécessaire) | LPDDR4X 16 Go (~17,1 Go/s) | Alimentation 5 V/5 A (25 W max) | 305 $ (avril 2026) |
| Raspberry Pi AI HAT+ (Hailo-8) | ASIC dédié (module d'extension RPi5) | NPU Hailo-8 | 26 TOPS (INT8) | — | ~2,5 W | 110 $ |
| Accélérateur USB Google Coral | ASIC dédié (USB) | Edge TPU | 4 TOPS (INT8) | — | 2 W | ~75–99 $ |
| NVIDIA Jetson Orin Nano Super | Ordinateur IA avec GPU intégré | Cortex-A78AE 6 cœurs, 1,7 GHz + GPU Ampere, 1024 cœurs/32 cœurs Tensor | 67 TOPS (INT8, mode MAXN Super) | LPDDR5 8 Go (102 Go/s) | 7–25 W (variable) | 249 $ |
| NVIDIA Jetson AGX Orin (64 Go) | Ordinateur IA avec GPU intégré (modèle phare) | Cortex-A78AE 12 cœurs + GPU Ampere, 2048 cœurs/64 cœurs Tensor | 275 TOPS (INT8) | LPDDR5 64 Go, 256 bits | 15–60 W (variable) | — |
Le Raspberry Pi 5 est le modèle utilisé par le projet Newbot comme ordinateur de contrôle principal. Il gère le traitement côté périphérique, notamment l'autolocalisation, la supervision de la sécurité et l'acquisition de données par capteurs. L'algorithme d'odométrie LiDAR-inertielle de Newbot (FAST-LIO) s'exécutant entièrement sur le CPU, et le système n'ayant pas besoin d'effectuer en permanence des inférences de réseaux neuronaux à grande échelle, un SoC généraliste sans NPU dédié suffit à ses besoins. À l'inverse, un robot conçu pour la détection ou la segmentation d'objets en temps réel à partir de flux vidéo nécessiterait généralement un GPU intégré comme Jetson, ou un accélérateur externe de type Hailo/Coral. Le Jetson Orin Nano Super possède également une histoire particulière : une mise à jour logicielle de décembre 2024, baptisée « Super Mode », a augmenté sa puissance maximale, la faisant passer de 40 TOPS (pour la génération précédente, à 499 ) à 67 TOPS (pour 249) — des performances accrues pour la moitié du prix.
Histoire : la nostalgie du BBC Micro et le virage d'un fabricant de GPU pour le jeu
Raspberry Pi : un projet né d'une baisse des inscriptions à Cambridge — Eben Upton, fondateur de la Fondation Raspberry Pi, a mis la main sur un BBC Micro d'occasion (un ordinateur personnel utilisé par la BBC à des fins éducatives dans les années 1980) à l'âge de 10 ans, en 1988. Ce fut sa première expérience de programmation en BASIC. Plus tard, vers 2006, alors qu'il était directeur des études en informatique à l'université de Cambridge, il constata une forte augmentation du nombre de candidats ayant peu d'expérience en programmation, parallèlement à une baisse des inscriptions au Tripos d'informatique. Voyant dans la disparition des ordinateurs « prêts à l'emploi » comme le BBC Micro une des causes de ce phénomène, Upton consacra ses soirées et ses week-ends, de 2006 à 2011, au développement d'un SBC (Single-Board Computer) à bas coût, en parallèle de son travail chez Broadcom. La Fondation Raspberry Pi fut officiellement créée en 2009, avec pour objectif de proposer un « ordinateur programmable pour moins de 35 $ ». En 2011, des membres de la Fondation présentèrent un prototype à la BBC dans l'espoir de conserver le nom « BBC Micro », ce que des contraintes juridiques empêchèrent. Un journaliste de la BBC publia alors une vidéo de démonstration du prototype qui devint virale, prouvant ainsi l'existence d'une forte demande bien avant le lancement officiel.
Jetson : un fabricant de GPU pour le jeu vidéo se lance dans la robotique en 2014 — En mars 2014, Jensen Huang, PDG de NVIDIA, a personnellement dévoilé le Jetson TK1 lors de la conférence GTC (GPU Technology Conference). Ce système associait la puce Tegra K1, conçue pour les appareils mobiles, à un GPU à architecture Kepler de 192 cœurs, offrant une puissance de calcul de 326 GFLOPS — un chiffre impressionnant pour un système embarqué à l'époque — et intégrait le modèle de programmation CUDA. Dès le départ, des cas d'utilisation tels que la navigation robotique et l'évitement d'obstacles par drones étaient mis en avant, marquant ainsi l'entrée de NVIDIA sur le marché de la robotique embarquée, après une activité principalement axée sur les GPU pour le jeu vidéo et les centres de données.
La gamme Jetson a ensuite bénéficié d'une mise à jour de son architecture GPU environ tous les deux ans : le TX2 de 2017, avec un GPU Pascal à 256 cœurs, offrait des performances deux fois supérieures à celles du TK1 ; La génération Xavier (2018-2020), basée sur l'architecture Volta, promettait des performances plus de 20 fois supérieures et une efficacité énergétique plus de 10 fois supérieure à celle du TX2 ; la génération Orin (2022), basée sur l'architecture Ampere, illustre cette tendance. On observe une récurrence : les architectures initialement conçues pour le marché des GPU de jeu sont réorientées vers des applications embarquées quelques années plus tard. Dans ce modèle, l'expertise technique acquise par NVIDIA dans le domaine des GPU pour centres de données et PC contribue directement aux gains de performance de ses produits de robotique embarquée, et c'est là le principal atout de Jetson.
Un exemple concret : un NVR domestique pilotant plusieurs TPU Coral Edge
Frigate NVR, un logiciel open source d'enregistrement et de détection d'objets, est un exemple représentatif d'accélérateur ASIC dédié exécuté simultanément sur plusieurs appareils. Frigate analyse les flux vidéo des caméras de surveillance en temps réel et décharge la détection de personnes et de véhicules sur les TPU Coral Edge. Son architecture attribue un processus dédié par TPU et distribue les requêtes de détection provenant de plusieurs caméras via une file d'attente partagée.
Un seul accélérateur USB Coral (4 TOPS) est capable de gérer la détection en temps réel pour deux à quatre flux 1080p. Une configuration associant deux cartes Coral Dual Edge TPU (M.2) de 8 TOPS aurait géré simultanément plus de 20 caméras, avec une utilisation de la puce d'environ 12 %. Cependant, il est également connu que l'empilement de plusieurs accélérateurs USB peut saturer la bande passante du bus USB de l'hôte, les performances n'étant donc pas proportionnelles au nombre de périphériques. L'ajout de plusieurs ASIC dédiés à un serveur NVR pour augmenter le nombre de caméras est une solution classique qui tire parti du faible coût et de la faible consommation énergétique par TOPS.
Comment la demande des datacenters IA a fait grimper les prix des SBC pour amateurs
En 2026, Raspberry Pi a dû augmenter ses prix à plusieurs reprises pour des raisons indépendantes de sa volonté. La cause ? Une pénurie de mémoire alimentée par la demande croissante des centres de données d'IA. Eben Upton, PDG de la Fondation Raspberry Pi, a lui-même révélé sur le blog de l'entreprise que le coût d'approvisionnement de la mémoire DRAM LPDDR4 utilisée dans les Raspberry Pi 4/5 avait été multiplié par sept en une seule année. Après une première hausse en décembre 2025, plusieurs autres augmentations ont été annoncées au premier semestre 2026. Une augmentation en avril 2026 a ajouté 100 au modèle 16 Go, le portant à 305, soit plus de 2,5 fois son prix de lancement (octobre 2024, date à laquelle le modèle 16 Go était proposé à 120 ). Ironie du sort, parallèlement à cette flambée des prix, la Fondation a également lancé un nouveau modèle 1 Go en 2026 au prix de seulement 45. Un exemple où la demande de mémoire haute performance pour l'IA a même impacté la structure tarifaire d'un marché totalement différent : celui des ordinateurs embarqués pour amateurs.
Coral, abandonné par Google, maintenu en vie par la communauté
L'Edge TPU de Coral utilise la même architecture de calcul « systolique » que Google a développée pour ses TPU de centres de données ; il s'agit en fait d'une version miniaturisée. Alors que le TPU v1, destiné aux centres de données, gère l'entraînement et l'inférence grâce à un imposant réseau systolique de 256 × 256, l'Edge TPU réduit considérablement la taille de ce réseau et sa consommation d'énergie à quelques watts seulement, ce qui lui permet de fonctionner dans des appareils embarqués aux ressources énergétiques limitées. Google a lancé Coral en 2019 avec cet Edge TPU (4 TOPS, 2 W) intégré à une carte de développement et un accélérateur USB. Il a rapidement conquis les utilisateurs comme accélérateur additionnel pour les SBC existants tels que le Raspberry Pi, grâce à son inférence économe en énergie capable d'exécuter MobileNet v2 à environ 400 images par seconde. Depuis, Google a quasiment cessé d'investir dans cette gamme de produits sans commercialiser de nouveau matériel notable, et la plupart des bibliothèques associées n'ont pas été mises à jour depuis 2022 environ. Le pilote GASKET, requis par les périphériques Coral connectés en PCIe, reste incompatible avec les noyaux Linux actuels. Si Coral a pu continuer à être utilisé, c'est parce que Google a rendu ses pilotes et son firmware open source ; des projets comme le NVR Frigate mentionné précédemment ont pris le relais et ont assuré sa maintenance en production. Ce cas illustre la coexistence entre la fin du support officiel et la poursuite de l'utilisation concrète, mettant en évidence le décalage entre les cycles de vie des produits matériels et celle des logiciels open source. Le principe de quantification INT8 de l'Edge TPU, ainsi que la comparaison de sa conception avec celle de l'Intel Movidius (Myriad X) (une autre puce désormais abandonnée), sont abordés plus en détail dans l'article de comparaison des accélérateurs d'IA en périphérie de réseau.
Est-il préférable d'intégrer un accélérateur à une carte SBC plutôt que Jetson ? Une étude comparative de 2026
Une étude d'avril 2026 portant sur l'exécution de l'inférence de grands modèles de langage (LLM) sur des ordinateurs monocartes (SBC) en périphérie, intitulée « Cloud to Edge : Benchmarking LLM Inference on Hardware-Accelerated Single-Board Computers » (Renney, Trad, Mattarock, Evetts, Wood), a comparé la consommation d'énergie et le débit de quatre configurations : un Raspberry Pi 5 nu (CPU uniquement), un Raspberry Pi 5 avec un module AI HAT+ (NPU Hailo-10H), un Jetson Orin Nano Super (configurations CPU et GPU séparées) et un module LLM M5Stack (NPU AX630C). Les résultats : l'ajout d'un NPU Hailo au Raspberry Pi 5 a amélioré l'efficacité énergétique (nombre de jetons générés par watt) de 9,57 à 39,97 fois par rapport à la configuration avec CPU seul, réduisant la consommation d'énergie par mégajeton de 27–77 mégajoules à 0,88–5,51 mégajoules. En termes de débit brut, la configuration GPU du Jetson Orin Nano était la plus rapide avec 9 à 10 jetons par seconde. Cependant, la configuration Raspberry Pi 5 + Hailo atteignait le même débit que la configuration CPU seule du Jetson, tout en consommant environ deux fois moins d'énergie et en occupant un espace réduit. Ces données confirment qu'une combinaison « SoC à usage général et ASIC dédié » peut rivaliser avec un ordinateur autonome doté d'un GPU intégré en termes d'efficacité énergétique.
Paramètres déterminant les performances
-
TOPS/W (efficacité) : Pour les petits robots et drones alimentés par batterie, les performances par watt sont souvent plus importantes que les performances absolues. Le Hailo-8 se distingue avec 26 TOPS/2,5 W (environ 10,4 TOPS/W), tandis que le Jetson Orin Nano Super n'atteint qu'environ 2,7 TOPS/W en mode MAXN Super (67 TOPS/25 W). Notez cependant que cela se fait au détriment de la polyvalence offerte par la possibilité d'exécuter des modèles CUDA arbitraires, contrairement à un ASIC dédié limité aux graphes fixes.
-
Bande passante mémoire : Pour l'inférence de réseaux neuronaux qui relit de grandes matrices de poids à chaque image, la bande passante mémoire devient plus souvent le facteur limitant que la puissance de calcul brute. La mémoire LPDDR5 du Jetson Orin Nano Super (102 Go/s) est environ six fois supérieure à celle du Raspberry Pi 5 (LPDDR4X, environ 17,1 Go/s), et cet écart détermine la part du volume de calculs TOPS du catalogue qui peut être effectivement extraite.
-
Compatibilité avec les logiciels existants : Un Raspberry Pi 5 peut exécuter une distribution Linux standard et ROS 2 sans modification, tandis que les accélérateurs ASIC comme Coral/Hailo ne peuvent exécuter que des graphes fixes pré-quantifiés et précompilés. La combinaison optimale dépend de la phase dans laquelle vous vous trouvez : développement (avec des modèles fréquemment modifiés) ou production (avec uniquement des inférences finalisées).
-
Risque d'approvisionnement et continuité de la feuille de route : Un produit comme Coral, dont le fournisseur a cessé d'investir, repose sur la confiance de la communauté, ce qui représente un risque réel pour l'adoption d'un projet de longue durée. Jetson, en revanche, propose des gammes de produits conçues pour assurer la continuité de sa feuille de route, comme la certification ASIL-D ISO 26262 de qualité automobile de l'AGX Orin.
-
Fluctuations de prix externes : Comme l'ont montré les hausses de prix du Raspberry Pi en 2026, le prix des SBC peut fluctuer fortement en raison de facteurs totalement extérieurs à un projet donné, tels que la demande en IA pour les centres de données. La planification des approvisionnements pour les déploiements de longue durée doit prendre en compte la stabilité de l'approvisionnement autant que le prix unitaire.
-
Disponibilité des interfaces d'extension : L'interface PCIe 2.0 x1 du Raspberry Pi 5 est trop étroite pour exploiter pleinement les spécifications d'un accélérateur comme l'AI HAT+, et dans certains cas, elle ne permet pas d'exploiter pleinement les performances annoncées du Hailo-8 (compatible PCIe Gen3, 2 voies). Il s'agit d'une contrainte pratique à prendre en compte pour toute configuration d'accélérateur additionnel.
-
Dimensions du boîtier et conception thermique : Un module ultra-compact comme le M5Stack LLM (54 × 54 × 13 mm) peut offrir une densité de débit par unité de volume supérieure, même avec des performances absolues inférieures. C'est une approche fondamentalement différente de celle d'un module dépendant d'un dissipateur thermique comme le Jetson AGX Orin, notamment en ce qui concerne le type de châssis ou de structure dans lequel il peut s'intégrer. Pour les drones ou les petits bras robotisés dont l'espace de montage et le poids sont limités, les performances par unité de volume deviennent un critère de sélection au même titre que les TOPS et les TOPS/W.
Un processeur plus rapide permet-il d'éviter les goulots d'étranglement du traitement d'image ?
La bande passante mémoire, les E/S, la consommation d'énergie et le refroidissement peuvent limiter le débit. Mesurer le fonctionnement continu avec les périphériques réels.
Références
-
Raspberry Pi 5 1 Go désormais disponible à 45 $, et hausse des prix liée à la mémoire (Raspberry Pi)
-
La nouvelle carte de développement IA de Nvidia à 249 $ promet 67 TOPS (Tom's Hardware)
-
Jetson TK1 : Le supercalculateur embarqué mobile emporte CUDA partout (Blog technique NVIDIA)
-
Le projet Coral TPU est probablement abandonné (Discussion GitHub Frigate)
-
Augmentation de la vitesse d'inférence avec 2 TPU vs 1 TPU (Discussion GitHub Frigate)
-
L'histoire du Pi : Dix ans de Raspberry Pi (Université de Cambridge)
-
[Du cloud à la périphérie : Évaluation comparative de l'inférence LLM sur des ordinateurs monocartes à accélération matérielle] (arXiv:2604.24785)](https://arxiv.org/abs/2604.24785)
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.