Contents — find the section you need
单板计算机 (SBC) 是一种紧凑型计算机,它将 CPU、内存、存储接口和各种 I/O 接口集成到一块电路板上。在自主移动机器人或无人机中,它是实现自我定位、路径规划和传感器处理的“大脑”。单板计算机远非简单的迷你电脑,其在集成 GPU 或 NPU(神经网络处理单元)进行推理方面的设计理念如今因产品线而异,目前有三种发展趋势并行:树莓派的通用 Linux SoC、NVIDIA Jetson 的集成 GPU 的 AI 计算机以及 Google Coral 的专用 ASIC 加速器。
 Raspberry Pi 5
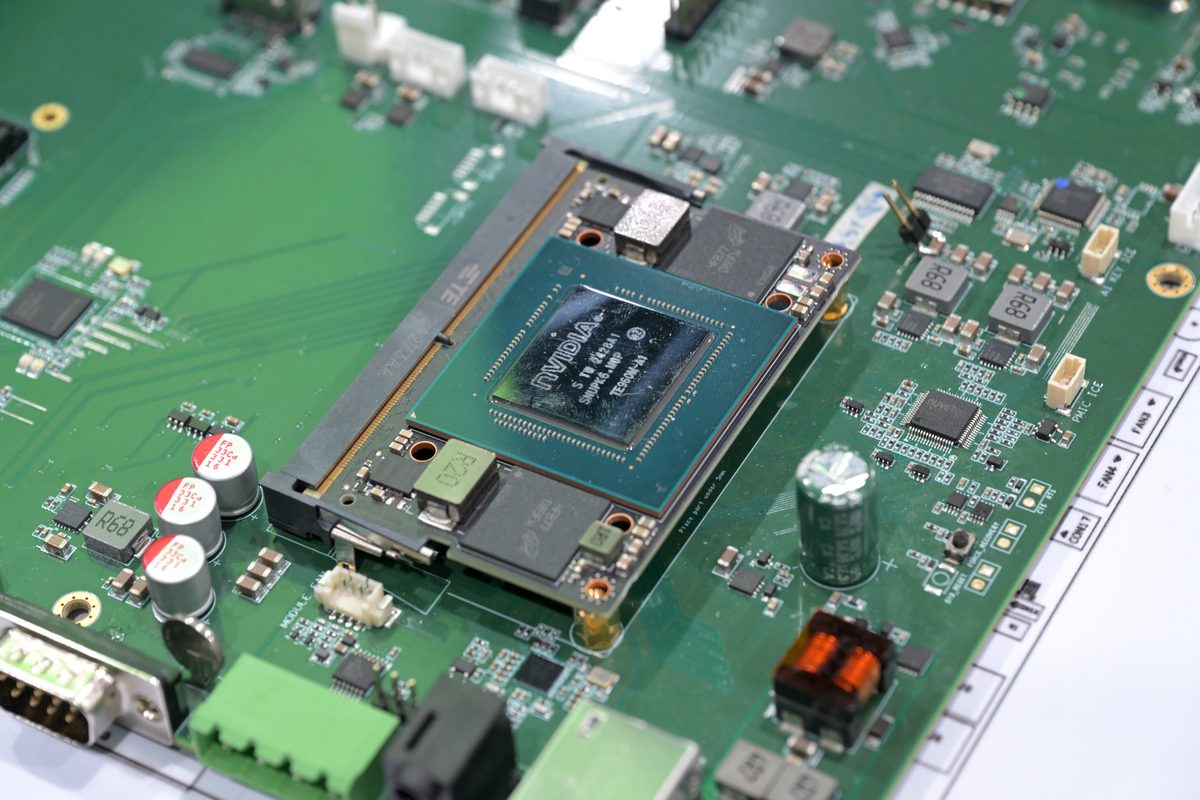 NVIDIA Jetson Orin NX (Computex 2025)
图片:Raspberry Pi 5 Board (SimonWaldherr, CC BY-SA 4.0) / Nvidia Jetson Orin NX on a boards Computex 2025 (4300streetcar, CC BY 4.0),均来自 Wikimedia Commons。


本文中比较的并非Jetson Orin Nano Super,而是同一代Orin系列、同架构Ampere的Orin NX模块。由于在Wikimedia Commons上找不到Google Coral(开发板/USB加速器)的清晰照片,因此本文未包含该产品的图片。
原理:TOPS指标和“内存墙”
在讨论单板计算机(SBC)性能时,仅凭CPU时钟频率已不足以说明问题。专用于神经网络推理的GPU/NPU的性能以每秒执行的量化整数运算次数(通常为INT8)来表示,单位为TOPS(每秒万亿次运算)。 TOPS 可以根据并行乘加 (MAC) 单元的数量 N_{MAC} 和时钟频率 f 粗略估算:
乘加运算算作两次操作——一次乘法加一次加法——因此系数为 2。例如,NVIDIA 的 Jetson Orin Nano Super 拥有 1024 个 CUDA 核心和 32 个 Tensor 核心,运行频率约为 1.7GHz,在其功耗上限提升的“MAXN Super”模式(25W)下,TOPS 可达 67。
该 TOPS 数据主要基于 8 位整数 (INT8) 运算,而非 32 位浮点运算 (FP32)。理论上,在推理之前将训练期间使用的 FP32 权重量化为 INT8,可以将模型大小和所需的内存带宽减少四分之一,从而使相同的计算单元能够处理更多的并行操作。这种设计在有限的功耗和内存带宽预算内,以牺牲推理精度为代价,换取最大吞吐量——Jetson、Hailo 和 Coral 都引用了基于这种 INT8 量化的目录 TOPS 数据。
也就是说,目录峰值 TOPS 并不一定能直接转化为有效性能。无论计算单元的速度有多快,如果无法从内存中足够快地获取所需数据(权重、中间特征),它们就会处于闲置状态。屋顶线模型反映了这一点:有效性能 P 的上限为峰值计算吞吐量 P_{peak} 和内存带宽 BW 乘以运算强度(每字节运算次数)AI 中的较小值。
树莓派 5 的 LPDDR4X-4267 内存采用 32 位总线,理论带宽最高约为 17.1GB/s,而 Jetson Orin Nano Super 的 LPDDR5 内存带宽高达 102GB/s,约为前者的 6 倍。在 CPU 密集型工作负载中,这种带宽差异几乎感觉不到,但对于每帧都需要重新读取大型权重矩阵的神经网络推理而言,这种带宽差距就成了限制性能的瓶颈,决定了实际能够提取多少 TOPS 数据。
三种设计理念:通用 SoC、GPU 集成、专用 ASIC
被称为“单板计算机 (SBC)”的产品,根据其处理 AI 推理的方式,大致可以分为三类。
通用 SoC(树莓派) 集成了 CPU、GPU 和各种 I/O 控制器,但没有配备专用的神经网络推理 (NPU)。它运行完整的 Linux 发行版,其最大的优势在于能够直接使用几乎所有现有的软件栈——包括 ROS 2;该设计假定,当需要推理性能时,外部加速器(例如下文将讨论的 Hailo)可以弥补性能差距。
集成 GPU 的 AI 计算机(NVIDIA Jetson)将 CUDA 可编程 GPU 和 Tensor 内核与高带宽内存集成到同一封装中。与只能处理预量化固定计算图的专用 ASIC 不同,它保留了直接运行任意 CUDA 内核和 PyTorch/TensorRT 模型的灵活性,同时提供更强大的并行计算能力。此外,还有面向汽车级可靠性的产品线,例如 AGX Orin,它获得了 ISO 26262 ASIL-D 功能安全认证,可用于自动驾驶和机器人领域。
专用ASIC加速器(例如Google Coral/Hailo)是一种功能固定的ASIC芯片,专门用于量化神经网络推理,可通过USB或M.2接口连接到主机单板计算机(SBC)。虽然牺牲了一些通用性,但它可以实现远超其他两种方案的效率(每瓦运算次数,TOPS/W)。
这三种方案并非互斥,实际的机器人项目通常会将它们结合起来。将像Raspberry Pi 5这样的通用SoC与ASIC加速器(AI HAT+)结合使用,是一种兼顾Linux/ROS 2软件栈的广度和将推理任务卸载到ASIC所带来的能效的折衷方案——正如下文讨论的基准测试论文所示,这种组合的效率可以接近独立的GPU集成计算机。
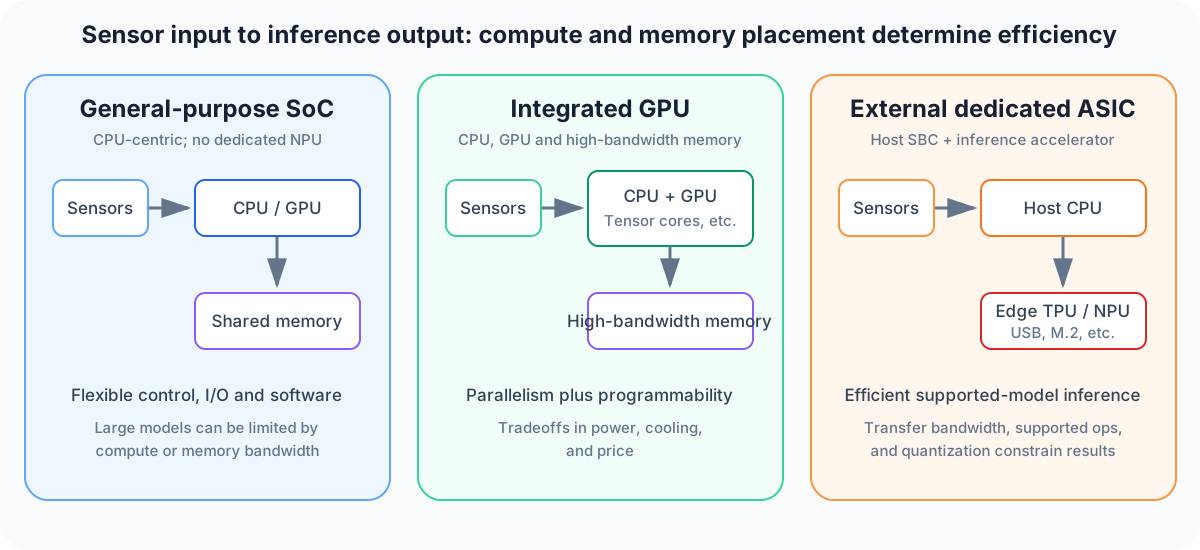
图示:Duskcoil。此为概念布局,并非产品速度排名。实际性能取决于型号、精度、软件、内存带宽和电源配置。
主要产品规格比较
| 产品 | 类型 | 计算核心 | AI性能 | 内存 | 功耗 | 价格 |
|---|---|---|---|---|---|---|
| 树莓派5 (16GB) | 通用SoC(无NPU) | Cortex-A76 四核,2.4GHz | —(需要外部) | LPDDR4X 16GB (~17.1GB/s) | 5V/5A电源(最大25W) | 305 美元(截至 2026 年 4 月) |
| 树莓派 AI HAT+ (Hailo-8) | 专用 ASIC(树莓派 5 扩展 HAT) | Hailo-8 NPU | 26 TOPS (INT8) | — | 约 2.5W | 110 美元 |
| Google Coral USB 加速器 | 专用 ASIC (USB) | Edge TPU | 4 TOPS (INT8) | — | 2W | 约 75–99 美元 |
| NVIDIA Jetson Orin Nano Super | 集成 GPU 的 AI 计算机 | Cortex-A78AE 六核处理器,主频 1.7GHz + Ampere GPU,1024 个核心/32 个 Tensor 核心 | 67 TOPS (INT8,MAXN Super 模式) | LPDDR5 8GB (102GB/s) | 7–25W(可变) | 249 美元 |
| NVIDIA Jetson AGX Orin (64GB) | 集成 GPU 的 AI 计算机(旗舰级) | Cortex-A78AE 12 核 + Ampere GPU,2048 个核心/64 个 Tensor 核心 | 275 TOPS (INT8) | LPDDR5 64GB,256 位 | 15–60W(可变) | — |
newbot 项目 使用 Raspberry Pi 5 作为其主控计算机,负责处理边缘端处理,例如自定位、安全监控和传感器数据采集。由于 newbot 的激光雷达惯性里程计 (FAST-LIO) 算法完全在 CPU 上运行,且系统无需持续进行大规模神经网络推理,因此无需专用 NPU 的通用 SoC 即可满足其需求。相反,围绕实时目标检测或从摄像头画面分割目标而构建的机器人通常需要像 Jetson 这样的集成 GPU,或者 Hailo/Coral 级别的外部加速器。Jetson Orin Nano Super 的发展历程也颇为独特:2024 年 12 月的一次名为“超级模式”的软件更新提升了其性能上限,使其从上一代 499 美元的 40 TOPS 提升至 249 美元的 67 TOPS——性能更强,价格却只有一半。
历史:对 BBC Micro 的怀旧之情,以及一家游戏 GPU 制造商的转型
树莓派:剑桥大学录取人数下降引发的事件 — 树莓派基金会创始人埃本·厄普顿 (Eben Upton) 在 10 岁时(1988 年)获得了一台二手的 BBC Micro(BBC 在 20 世纪 80 年代用于教育的家用电脑),这是他第一次接触 BASIC 编程。后来,大约在 2006 年,当他担任剑桥大学计算机科学系主任时,他注意到申请者中编程经验匮乏的情况激增,与此同时,计算机科学荣誉学位课程 (Computer Science Tripos) 的申请人数却在下降。厄普顿认为,像 BBC Micro 这样“开箱即用”的电脑逐渐从家庭中消失是造成这一现象的原因之一。从 2006 年到 2011 年,他利用在博通公司 (Broadcom) 的日常工作之余,利用晚上和周末时间开发了一款低成本的单板计算机 (SBC)。树莓派基金会于 2009 年正式成立,其目标是打造“售价低于 35 美元的可编程计算机”。2011 年,基金会成员带着原型机前往 BBC,希望沿用“BBC Micro”的名称,但由于法律原因未能实现。不过,一位 BBC 记者发布了该原型机的演示视频,并迅速走红网络,证明在正式发布之前,市场对树莓派的需求就已十分强劲。
Jetson:游戏 GPU 制造商于 2014 年进军机器人领域——2014 年 3 月,NVIDIA CEO 黄仁勋在 GTC(GPU 技术大会)的主题演讲中亲自发布了 Jetson TK1。这款产品将面向移动设备的 Tegra K1 芯片与 192 核 Kepler 架构 GPU 相结合,实现了 326 GFLOPS 的运算能力——这在当时对于一款嵌入式设备来说是一个惊人的数字——并且还引入了 CUDA 编程模型。从一开始,机器人导航和无人机避障等应用案例就被作为宣传重点,这标志着英伟达真正进军嵌入式机器人市场。此前,英伟达的业务主要集中在游戏和数据中心GPU领域。
Jetson产品线此后几乎每隔一代就会更新一次GPU架构:2017年的TX2搭载了256核的Pascal架构GPU,性能是TK1的两倍;2018-2020年的Volta架构Xavier一代,据称性能是TX2的20倍以上,能效是TX2的10倍以上;以及2022年的Ampere架构Orin一代。其一贯的模式是,最初应用于游戏GPU市场的架构会在几年后被重新应用于嵌入式领域——这种结构使得英伟达在数据中心和PC GPU业务方面的技术积累能够直接转化为嵌入式机器人产品的性能提升,而这正是Jetson的核心优势所在。
实际部署案例:一台家用网络录像机驱动多个 Coral Edge TPU
Frigate NVR 就是一个典型的专用 ASIC 加速器“同时运行多个”的案例。Frigate 是一款开源的录像和目标检测软件包。它实时分析监控摄像头视频流,并将人员/车辆检测任务卸载到 Coral Edge TPU 上。其架构为每个 TPU 分配一个专用进程,并通过共享队列将来自多个摄像头的检测请求分发给这些进程。
据估计,单个 Coral USB 加速器(4 TOPS)可以独立处理大约两到四个 1080p 流的实时检测;据报道,使用两张 8 TOPS 的 Coral Dual Edge TPU (M.2) 卡的配置可以同时处理 20 多个摄像头,而芯片利用率保持在 12% 左右。另一方面,众所周知,堆叠多个 USB 加速器可能会遇到主机 USB 总线带宽瓶颈,因此性能并不会随着设备数量的增加而线性增长。在单个NVR服务器上添加多个专用ASIC芯片以扩展摄像头数量,是一种典型的部署模式,充分利用了每TOPS的低成本和低功耗优势。
AI数据中心需求如何推高业余爱好者单板计算机(SBC)价格
2026年,树莓派发现自己不得不反复提价,而这完全是其自身无法控制的原因。其根源在于AI数据中心需求激增导致的内存市场供过于求——树莓派基金会首席执行官Eben Upton本人在公司博客上透露,树莓派4/5所使用的LPDDR4 DRAM的采购成本在一年内飙升了七倍。继 2025 年 12 月价格上涨之后,2026 年上半年又宣布了几次涨价,2026 年 4 月的涨价使 16GB 型号的价格上涨了 100 美元,达到 305 美元——是其上市价格(2024 年 10 月,16GB 型号上市时的价格为 120 美元)的 2.5 倍多。讽刺的是,就在价格飙升的同时,该基金会还在 2026 年推出了一款新的 1GB 型号,售价仅为 45 美元——这表明,对高性能 AI 内存的需求已经渗透到了一个完全不相关的市场:业余嵌入式计算机市场。
Coral,被谷歌放弃,却被社区延续
Coral 内部的边缘 TPU 采用了与谷歌为其数据中心 TPU 开发的“脉动阵列”计算架构相同的架构——它实际上是该架构的微型化版本。数据中心级的 TPU v1 使用 256×256 的大型脉动阵列处理训练和推理,而 Edge TPU 则大幅缩小了阵列尺寸,并将功耗降至个位数瓦,使其能够在功耗预算紧张的嵌入式设备中运行。谷歌于 2019 年推出了 Coral,其开发板和 USB 加速器中就搭载了这款 Edge TPU(4 TOPS,2W)。凭借其高效的推理能力(能够以大约每秒 400 帧的速度运行 MobileNet v2),Coral 作为树莓派等现有单板计算机的附加加速器而广受欢迎。然而,自那以后,谷歌实际上已经停止了对该产品线的投资,没有发布任何值得关注的新硬件,而且大多数支持库自 2022 年左右以来就没有更新过。PCIe 连接的 Coral 设备所需的 GASKET 驱动程序在当前的 Linux 内核上仍然不受支持。Coral 之所以没有完全被淘汰,是因为谷歌开源了其驱动程序和固件。像前面提到的 Frigate NVR 这样的项目自行承担了支持责任,并使其在生产环境中持续运行——这种情况体现了官方停止支持与实际应用持续并存的矛盾,也说明了硬件产品周期与开源软件生命周期之间的不匹配。Edge TPU 的 INT8 量化原理,以及其设计理念与 Intel Movidius(Myriad X,另一款已停产的芯片)的比较,在边缘 AI 加速器对比文章中有更深入的探讨。
在单板计算机 (SBC) 上加装加速器是否优于 Jetson? 2026 年基准测试论文
一篇发表于 2026 年 4 月的论文《云到边缘:硬件加速单板计算机的 LLM 推理基准测试》(作者:Renney、Trad、Mattarock、Evetts 和 Wood)探讨了在边缘单板计算机 (SBC) 上运行大型语言模型 (LLM) 推理的性能。该论文比较了四种配置下的功耗和吞吐量:裸机 Raspberry Pi 5(仅 CPU)、搭载 AI HAT+(Hailo-10H NPU)的 Raspberry Pi 5、Jetson Orin Nano Super(CPU 和 GPU 配置分别测试)以及 M5Stack LLM 模块(AX630C NPU)。结果表明:在 Raspberry Pi 5 中添加 Hailo NPU 后,每瓦生成的令牌数效率比仅 CPU 配置提高了 9.57 倍至 39.97 倍,每个超级令牌的能耗从 27–77 兆焦耳降至 0.88–5.51 兆焦耳。在原始吞吐量方面,Jetson Orin Nano 的 GPU 配置速度最快,可达每秒 9-10 个令牌,但 Raspberry Pi 5 + Hailo 配置的吞吐量与 Jetson 的纯 CPU 配置相当,而功耗却只有后者的一半左右,而且体积更小——这些数据支持了“通用 SoC + 专用 ASIC”组合在能效方面可以与独立 GPU 集成计算机相媲美的说法。
决定性能的参数
-
TOPS/W(效率):对于电池供电的小型机器人和无人机而言,每瓦性能通常比绝对性能更重要。Hailo-8 的每瓦性能高达 26 TOPS/2.5W(约 10.4 TOPS/W),而 Jetson Orin Nano Super 在其 MAXN Super 模式下(67 TOPS/25W)的每瓦性能仅为约 2.7 TOPS/W。不过需要注意的是,这种灵活性有所妥协,例如无法运行任意 CUDA 模型,而专用 ASIC 则仅限于固定图。
-
内存带宽:对于每帧都需要重新读取大型权重矩阵的神经网络推理而言,内存带宽往往比原始计算能力更容易成为限制速率的因素。Jetson Orin Nano Super 的 LPDDR5 (102GB/s) 大约是 Raspberry Pi 5 的 LPDDR4X (~17.1GB/s) 的 6 倍,这一差距决定了实际能够提取多少 TOPS 数据。
-
与现有软件的兼容性:Raspberry Pi 5 可以直接运行标准的 Linux 发行版和 ROS 2,而像 Coral/Hailo 这样的 ASIC 加速器只能执行预量化、预编译的固定图。最佳组合取决于您处于模型频繁变更的开发阶段,还是仅运行最终推理的生产阶段。
-
供应风险和路线图连续性:像 Coral 这样的产品,由于供应商实际上已经停止投资,只能依靠社区的良好口碑生存——这对于长期项目的新用户来说是一个真正的风险。相比之下,Jetson 维护着旨在保持路线图连续性的产品线,例如 AGX Orin 获得了汽车级 ISO 26262 ASIL-D 认证。
-
市场外的价格波动:正如 2026 年 Raspberry Pi 的价格上涨所表明的那样,SBC 的价格可能会因完全超出特定项目范围的因素(例如 AI 数据中心的需求)而出现剧烈波动。长期部署的采购计划需要权衡供应稳定性与单价。
-
扩展接口的可用性:树莓派 5 的 PCIe 2.0 x1 通道太窄,无法让 AI HAT+ 等加速器发挥全部性能,在某些情况下甚至无法完全发挥 Hailo-8 的标称性能(标称 PCIe Gen3,2 通道)——对于任何外接加速器配置来说,这都是一个值得考虑的实际限制。
-
外壳尺寸和散热设计:像 M5Stack LLM 模块这样尺寸仅为 54×54×13mm 的超紧凑型模块,即使在绝对性能上略逊一筹,也能在单位体积吞吐量方面胜出。这与 Jetson AGX Orin 这类依赖散热器的模块有着本质区别,因为后者需要考虑安装到哪些机架或机箱中。对于受限于安装空间和重量的无人机或小型机械臂而言,单位体积性能与 TOPS 和 TOPS/W 一样,成为重要的选择标准。
更快的 CPU 能否避免相机处理瓶颈?
内存带宽、I/O、功耗和散热都会限制吞吐量。
使用实际外设测量持续运行情况。参考资料
-
NVIDIA 新款售价 249 美元的 AI 开发套件开发板承诺 67 TOPS(Tom's Hardware)](https://www.tomshardware.com/tech-industry/artificial-intelligence/nvidia-launches-new-usd249-ai-development-board-that-does-67-tops)
-
NVIDIA JetPack 6.2 为 Jetson Orin Nano 和 Orin NX 带来超级模式(NVIDIA 开发者博客)
评论
请先登录。
暂无数据。