Contents — find the section you need
SBC(싱글 보드 컴퓨터)는 CPU, 메모리, 스토리지 인터페이스 및 다양한 I/O를 단일 보드에 통합한 소형 컴퓨터입니다. 자율 이동 로봇이나 드론에서 SBC는 자체 위치 파악, 경로 계획 및 센서 처리의 "두뇌" 역할을 합니다. 단순한 소형 PC와는 달리, SBC는 GPU 또는 NPU(신경 처리 장치) 기능을 탑재하여 추론을 수행하는 설계 철학이 제품군별로 크게 달라지고 있으며, 현재 세 가지 주요 흐름이 병행하여 진행되고 있습니다. 바로 라즈베리 파이의 범용 리눅스 SoC, NVIDIA 젯슨의 GPU 통합 AI 컴퓨터, 그리고 구글 코랄의 전용 ASIC 가속기입니다.
 Raspberry Pi 5
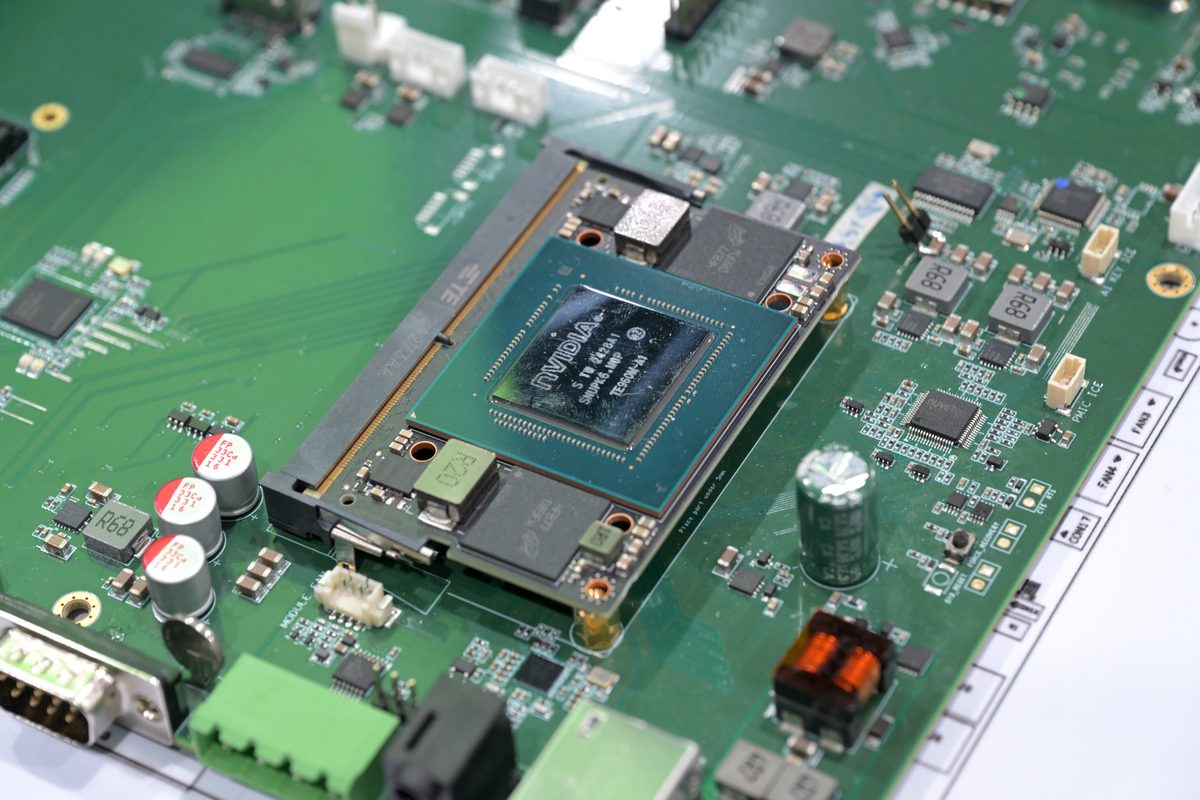 NVIDIA Jetson Orin NX (Computex 2025)
이미지: Raspberry Pi 5 보드 (SimonWaldherr, CC BY-SA 4.0) / Nvidia 마더보드에 장착된 Jetson Orin NX Computex 2025 (4300streetcar, CC BY 4.0), 모두 Wikimedia Commons. 본문에서 비교한 Jetson Orin Nano Super와 정확히 동일한 모델은 아니지만, 동일한 Orin 세대 및 Ampere 아키텍처를 사용하는 Orin NX 모듈입니다. Wikimedia Commons에서 Google Coral(개발 보드/USB 가속기)의 깨끗한 사진을 찾을 수 없어 이 글에는 제품 사진을 포함하지 않았습니다.


원칙: TOPS 지표와 "메모리 병목 현상"
SBC 성능을 논할 때 CPU 클럭 속도만으로는 더 이상 모든 것을 설명할 수 없습니다. 신경망 추론에 특화된 GPU/NPU의 성능은 초당 실행되는 양자화된 정수 연산(일반적으로 INT8) 횟수로 표현되며, 단위는 TOPS(Tera Operations Per Second - 초당 1조 연산)입니다. TOPS는 병렬 곱셈-누적(MAC) 유닛 수(N_{MAC})와 클럭 주파수(f)를 이용하여 대략적으로 추정할 수 있습니다.
곱셈-누적 연산은 곱셈과 덧셈, 두 가지 연산으로 계산되므로 2의 계수가 붙습니다. 예를 들어 NVIDIA의 Jetson Orin Nano Super는 약 1.7GHz로 작동하는 1024개의 CUDA 코어와 32개의 Tensor 코어를 탑재하고 있으며, 전력 소비를 최대화한 "MAXN Super" 모드(25W)에서 67 TOPS를 달성합니다.
이 TOPS 수치의 대부분은 32비트 부동 소수점(FP32) 연산이 아닌 8비트 정수(INT8) 연산을 가정한 것입니다. 학습 과정에서 사용되는 FP32 가중치를 추론 전에 INT8로 양자화하면 이론적으로 모델 크기와 필요한 메모리 대역폭이 1/4로 줄어들어 동일한 컴퓨팅 유닛으로 더 많은 병렬 연산을 처리할 수 있습니다. 이는 제한된 전력 및 메모리 대역폭 예산 내에서 최대 처리량을 얻기 위해 추론 정밀도를 희생하는 설계이며, Jetson, Hailo, Coral 모두 이러한 INT8 양자화를 가정한 카탈로그 TOPS 수치를 제시합니다.
하지만 최고 카탈로그 TOPS가 곧 실제 성능으로 이어지는 것은 아닙니다. 컴퓨팅 장치가 아무리 빠르더라도 필요한 데이터(가중치, 중간 특징)를 메모리에서 충분히 빠르게 가져올 수 없다면 유휴 상태가 됩니다. 루프라인 모델은 이러한 점을 반영합니다. 실제 성능(P)은 최고 컴퓨팅 처리량(P_{peak})과 메모리 대역폭(BW)에 연산 강도(바이트당 연산 횟수)(AI)를 곱한 값 중 더 작은 값으로 제한됩니다.
라즈베리 파이 5의 LPDDR4X-4267은 32비트 버스에서 이론상 최대 대역폭이 약 17.1GB/s인 반면, 젯슨 오린 나노 슈퍼의 LPDDR5는 102GB/s로 약 6배 높습니다. CPU 집약적인 작업에서는 이러한 차이가 체감되는 경우가 드물지만, 매 프레임마다 대규모 가중치 행렬을 다시 읽어들이는 신경망 추론에서는 이 대역폭 차이가 실제로 카탈로그 TOPS 수치 중 얼마나 활용할 수 있는지를 결정하는 속도 제한 요소가 됩니다.
세 가지 설계 철학: 범용 SoC, GPU 통합형, 전용 ASIC
"SBC"라고 불리는 제품들은 AI 추론 처리 방식에 따라 크게 세 가지 유형으로 나뉩니다.
범용 SoC(라즈베리 파이)는 CPU, GPU 및 다양한 I/O 컨트롤러를 통합하지만, 신경망 추론을 위한 전용 NPU는 제공하지 않습니다. 완전한 Linux 배포판을 실행하며, 가장 큰 장점은 ROS 2를 포함한 기존 소프트웨어 스택을 거의 그대로 사용할 수 있다는 점입니다. 추론 성능이 필요할 때는 외부 가속기(예: 아래에서 설명할 Hailo)를 사용하여 부족한 부분을 보완하도록 설계되었습니다.
GPU 통합 AI 컴퓨터(NVIDIA Jetson)는 CUDA 프로그래밍이 가능한 GPU와 Tensor 코어를 고대역폭 메모리와 동일한 패키지에 통합합니다. 미리 양자화된 고정된 연산 그래프만 처리할 수 있는 전용 ASIC과 달리, Jetson은 임의의 CUDA 커널과 PyTorch/TensorRT 모델을 직접 실행할 수 있는 유연성을 유지하면서 훨씬 더 많은 병렬 컴퓨팅 성능을 제공합니다. 자율 주행 및 로봇 공학 분야에서 ISO 26262 ASIL-D 기능 안전 인증을 획득한 AGX Orin과 같은 자동차 등급의 신뢰성을 갖춘 제품 라인도 있습니다.
전용 ASIC 가속기(Google Coral/Hailo)는 양자화된 신경망 추론에 특화된 고정 기능 ASIC 형태로, USB 또는 M.2를 통해 호스트 SBC에 추가됩니다. 다용성을 희생하는 대신, 다른 두 가지 접근 방식보다 훨씬 뛰어난 효율성(와트당 TOPS)을 달성할 수 있습니다.
이 세 가지 범주는 상호 배타적이지 않으며, 실제 로봇 프로젝트에서는 종종 이들을 조합하여 사용합니다. Raspberry Pi 5와 같은 범용 SoC에 ASIC 가속기(AI HAT+)를 결합하는 것은 Linux/ROS 2 소프트웨어 스택의 폭넓은 활용성과 ASIC에 추론 처리를 오프로드하여 얻는 전력 효율성을 모두 확보하기 위한 절충안입니다. 아래에서 논의할 벤치마킹 논문에서 보여주듯이, 이러한 조합은 독립형 GPU 통합 컴퓨터의 효율성에 근접할 수 있습니다.
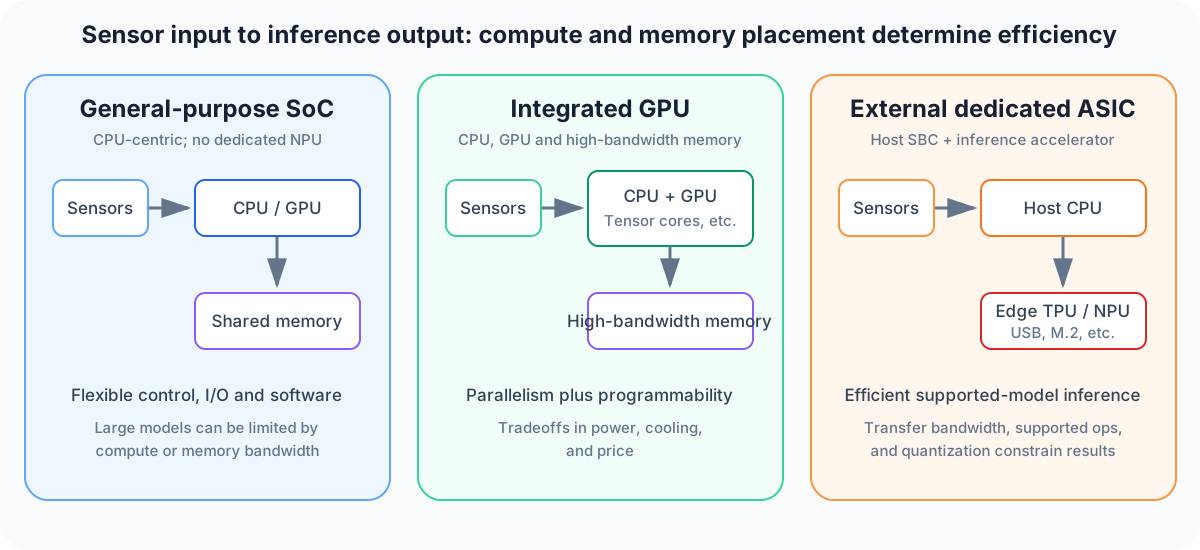
다이어그램: Duskcoil. 이는 개념적인 레이아웃이며 제품 속도 순위가 아닙니다. 실제 성능은 모델, 정밀도, 소프트웨어, 메모리 대역폭 및 전력 구성에 따라 달라집니다.
주요 제품 사양 비교
| 제품 | 유형 | 컴퓨팅 코어 | AI 성능 | 메모리 | 전력 | 가격 |
|---|---|---|---|---|---|---|
| Raspberry Pi 5 (16GB) | 범용 SoC (NPU 없음) | Cortex-A76 4코어, 2.4GHz | — (외부 필요) | LPDDR4X 16GB (~17.1GB/s) | 5V/5A 전원 공급 (최대 25W) | 305달러(2026년 4월 기준) |
| 라즈베리 파이 AI HAT+ (Hailo-8) | 전용 ASIC(RPi5 추가 HAT) | Hailo-8 NPU | 26 TOPS(INT8) | — | 약 2.5W | 110달러 |
| Google Coral USB 가속기 | 전용 ASIC(USB) | 엣지 TPU | 4 TOPS(INT8) | — | 2W | 약 75~99달러 |
| NVIDIA Jetson Orin Nano Super | GPU 통합 AI 컴퓨터 | Cortex-A78AE 6코어, 1.7GHz + Ampere GPU, 1024코어/32 Tensor 코어 | 67 TOPS(INT8, MAXN Super 모드) | LPDDR5 8GB(102GB/s) | 7~25W(가변) | 249달러 |
| NVIDIA Jetson AGX Orin (64GB) | GPU 통합 AI 컴퓨터(플래그십) | Cortex-A78AE 12코어 + Ampere GPU, 2048 코어/64 Tensor 코어 | 275 TOPS(INT8) | LPDDR5 64GB, 256비트 | 15~60W(가변) | — |
라즈베리 파이 5는 newbot 프로젝트에서 메인 제어 컴퓨터로 사용하는 모델로, 자체 위치 파악, 안전 감시, 센서 데이터 수집과 같은 엣지 측 처리를 담당합니다. newbot의 LiDAR-관성 주행 거리 측정(FAST-LIO) 알고리즘은 CPU에서만 실행되고, 시스템에서 대규모 신경망 추론을 지속적으로 실행할 필요가 없기 때문에, 전용 NPU가 없는 범용 SoC로도 요구 사항을 충족할 수 있습니다. 반대로, 카메라 영상에서 실시간으로 객체를 감지하거나 분할하는 로봇은 Jetson과 같은 통합 GPU나 Hailo/Coral급 외장 가속기가 필요할 가능성이 높습니다. Jetson Orin Nano Super는 특이한 이력을 가지고 있는데, 2024년 12월에 출시된 "슈퍼 모드"라는 소프트웨어 업데이트를 통해 성능 한계가 이전 세대의 40 TOPS(499달러)에서 67 TOPS(249달러)로 향상되어 가격이 절반으로 떨어졌습니다.
역사: BBC Micro에 대한 향수와 게임용 GPU 제조업체의 전환점
라즈베리 파이: 케임브리지 입학률 하락이 계기가 된 계기 — 라즈베리 파이 재단 설립자인 에벤 업튼은 1988년 10살 때 중고 BBC Micro(1980년대 BBC가 교육용으로 배포했던 가정용 컴퓨터)를 구하게 되었고, 이것이 그의 첫 BASIC 프로그래밍 경험이었습니다. 이후 2006년경 케임브리지 대학교 컴퓨터 과학 학과장으로 재직하던 그는 프로그래밍 경험이 거의 없는 지원자들이 급증하는 반면, 컴퓨터 과학 학사 학위 과정 자체의 지원자 수는 감소하는 것을 목격했습니다. BBC 마이크로처럼 전원을 켜고 바로 프로그래밍할 수 있는 컴퓨터가 가정에서 사라지는 것이 한 원인이라고 생각한 업튼은 2006년부터 2011년까지 브로드컴에서 본업을 하면서 저녁과 주말을 이용해 저가형 단일 컴퓨터(SBC)를 개발했습니다. 그 결과, "35달러 미만의 프로그래밍 가능한 컴퓨터"를 목표로 하는 라즈베리 파이 재단이 2009년에 공식 설립되었습니다. 2011년, 재단 관계자들은 "BBC 마이크로"라는 이름을 계속 사용하고자 BBC에 시제품을 가져갔지만, 법적인 문제로 무산되었습니다. 그러나 BBC 기자가 시제품의 데모 영상을 공개했고, 이 영상이 입소문을 타면서 공식 출시 이전부터 수요가 높다는 것을 입증했습니다.
젯슨: 게임용 GPU 제조사, 2014년 로봇 시장에 진출 — 2014년 3월, NVIDIA CEO 젠슨 황은 GTC(GPU 기술 컨퍼런스) 기조연설에서 젯슨 TK1을 직접 공개했습니다. 모바일용 테그라 K1 칩과 192코어 케플러 아키텍처 GPU를 결합하여 당시 임베디드 기기로서는 경이로운 326 GFLOPS의 성능을 제공했으며, CUDA 프로그래밍 모델을 함께 탑재했습니다. 처음부터 로봇 내비게이션이나 드론 장애물 회피와 같은 활용 사례가 주요 홍보 내용으로 제시되었으며, 이는 NVIDIA가 그동안 주로 게임 및 데이터센터 GPU 시장에서 활동해 오던 사업 영역을 임베디드 로봇 시장에 본격적으로 진출했음을 알리는 신호탄이었습니다.
젯슨 제품군은 이후 약 2세대마다 GPU 아키텍처를 새롭게 개선해 왔습니다. 2017년에 출시된 TX2는 256코어 파스칼 GPU를 탑재하여 TK1보다 두 배 높은 성능을 제공했습니다. 2018~2020년 볼타 아키텍처 기반의 자비에르(Xavier) 세대는 TX2 대비 20배 이상의 성능과 10배 이상의 전력 효율을 제공한다고 알려져 있으며, 2022년 암페어 아키텍처 기반의 오린(Orin) 세대도 있습니다. 일관된 패턴은 게임용 GPU 시장에서 먼저 선보인 아키텍처가 몇 년 후 임베디드 용도로 재활용된다는 점입니다. 이는 NVIDIA의 데이터센터 및 PC GPU 사업에서 축적된 기술이 임베디드 로봇 제품의 성능 향상에 직접적으로 활용되는 구조이며, 이것이 바로 젯슨(Jetson)의 핵심 강점입니다.
실제 구축 사례: 하나의 가정용 NVR이 여러 개의 코랄 엣지 TPU를 구동하는 경우
전용 ASIC 가속기를 "여러 개를 동시에" 실행하는 대표적인 사례는 오픈 소스 녹화 및 객체 감지 패키지인 프리게이트 NVR(Frigate NVR)입니다. Frigate는 감시 카메라 영상을 실시간으로 분석하고 사람/차량 감지 기능을 Coral Edge TPU로 오프로드합니다. 이 아키텍처는 TPU당 하나의 전용 프로세스를 할당하고, 여러 카메라의 감지 요청을 공유 큐를 통해 해당 프로세스에 분산 처리합니다.
단일 Coral USB Accelerator(4 TOPS)는 약 2~4개의 1080p 스트림에 대한 실시간 감지를 자체적으로 처리할 수 있는 것으로 알려져 있습니다. 8 TOPS Coral Dual Edge TPU(M.2) 카드 두 개를 조합한 구성에서는 칩 사용률이 약 12% 수준으로 유지되면서 20대 이상의 카메라를 동시에 처리할 수 있는 것으로 보고되었습니다. 그러나 여러 USB Accelerator를 함께 사용할 경우 호스트의 USB 버스 대역폭이 병목 현상을 일으킬 수 있으므로 성능이 장치 수에 비례하여 선형적으로 확장되지는 않습니다. 카메라 수를 늘리기 위해 단일 NVR 서버에 여러 개의 전용 ASIC을 추가하는 것은 TOPS당 낮은 비용과 전력 소모를 활용하는 대표적인 구축 방식입니다.
AI 데이터센터 수요 급증으로 인한 취미용 SBC 가격 상승
2026년, 라즈베리 파이는 자사 통제 범위를 벗어난 이유로 가격을 여러 차례 인상해야 했습니다. 원인은 AI 데이터센터의 수요 급증으로 인한 메모리 시장 부족 현상이었습니다. 라즈베리 파이 재단 CEO인 에벤 업튼은 회사 블로그를 통해 라즈베리 파이 4/5에 사용된 LPDDR4 DRAM의 조달 비용이 단 1년 만에 7배나 급등했다고 밝혔습니다. 2025년 12월 가격 인상에 이어 2026년 상반기에도 여러 차례 추가 인상이 발표되었고, 2026년 4월에는 16GB 모델 가격이 100달러 인상되어 305달러가 되었습니다. 이는 출시 당시 가격(2024년 10월, 16GB 모델 120달러)의 2.5배가 넘는 가격입니다. 아이러니하게도, 이러한 가격 급등과 발맞춰 재단은 2026년에 단 45달러에 1GB 모델을 새롭게 출시했습니다. 이는 고성능 AI 메모리에 대한 수요가 전혀 무관한 시장, 즉 취미용 임베디드 컴퓨터 시장의 가격 구조에까지 영향을 미친 사례입니다.
구글이 버렸지만 커뮤니티가 살려낸 Coral
Coral에 탑재된 Edge TPU는 구글이 데이터센터용 TPU를 위해 개발한 "시스톨릭 어레이" 컴퓨팅 아키텍처를 따릅니다. 이는 사실상 소형화된 버전입니다. 데이터센터 규모의 TPU v1이 256×256 크기의 거대한 시스톨릭 어레이로 학습과 추론을 처리하는 반면, Edge TPU는 어레이 크기를 획기적으로 줄이고 전력 소비를 한 자릿수 와트 수준으로 낮춰 전력 예산이 제한적인 임베디드 기기에서도 작동할 수 있도록 했습니다. 구글은 2019년 엣지 TPU(4 TOPS, 2W)를 탑재한 개발 보드와 USB 가속기를 통해 Coral을 출시했습니다. Coral은 Raspberry Pi와 같은 기존 SBC에 추가할 수 있는 가속기로서, MobileNet v2를 초당 약 400프레임으로 실행할 수 있는 전력 효율적인 추론 기능을 강점으로 내세워 인기를 얻었습니다. 그러나 이후 구글은 주목할 만한 새로운 하드웨어를 출시하지 않고 사실상 Coral 제품 라인에 대한 투자를 중단했으며, 대부분의 지원 라이브러리도 2022년 이후로 업데이트되지 않았습니다. PCIe로 연결된 Coral 장치에 필요한 GASKET 드라이버는 현재 Linux 커널에서 지원되지 않습니다. Coral이 완전히 사라지지 않은 이유는 구글이 드라이버와 펌웨어를 오픈 소스로 공개했기 때문입니다. 앞서 언급한 Frigate NVR과 같은 프로젝트들이 자체적으로 지원 부담을 떠맡아 실제 환경에서 계속 사용하고 있습니다. 이는 공식적인 지원 종료와 실제 사용이 공존하는 사례로, 하드웨어 제품 주기와 오픈 소스 소프트웨어 수명 간의 불일치를 보여줍니다. Edge TPU의 INT8 양자화 원리와 설계 철학이 단종된 또 다른 칩인 Intel Movidius(Myriad X)와 어떻게 다른지에 대한 자세한 내용은 엣지 AI 가속기 비교 기사에서 확인할 수 있습니다.
SBC에 가속기를 장착하는 것이 Jetson보다 나을까요? 2026년 벤치마킹 논문
2026년 4월에 발표된 "Cloud to Edge: Benchmarking LLM Inference on Hardware-Accelerated Single-Board Computers"(Renney, Trad, Mattarock, Evetts, Wood) 논문에서는 엣지 SBC에서 대규모 언어 모델(LLM) 추론을 실행하는 것에 대해 연구했습니다. 이 논문에서는 네 가지 구성(CPU만 탑재한 Raspberry Pi 5, AI HAT+(Hailo-10H NPU 탑재)를 장착한 Raspberry Pi 5, CPU와 GPU를 각각 탑재한 Jetson Orin Nano Super, AX630C NPU를 탑재한 M5Stack LLM 모듈)의 전력 소모량과 처리량을 비교했습니다. 연구 결과, Raspberry Pi 5에 Hailo NPU를 추가하면 CPU만 탑재한 구성 대비 와트당 토큰 생성 효율이 9.57배에서 39.97배까지 향상되었으며, 메가토큰당 에너지 소비량은 27~77메가줄에서 0.88~5.51메가줄로 감소했습니다. 순수 처리량 측면에서 Jetson Orin Nano의 GPU 구성이 초당 9~10개의 토큰으로 가장 빨랐지만, Raspberry Pi 5 + Hailo 구성은 전력 소모는 절반 수준이고 크기도 더 작으면서 Jetson의 CPU 전용 구성과 동일한 처리량을 보여주었습니다. 이는 "범용 SoC와 전용 ASIC" 조합이 전력 효율성 측면에서 독립형 GPU 통합 컴퓨터와 대등한 성능을 낼 수 있다는 주장을 뒷받침하는 데이터입니다.
성능을 결정하는 요소
- TOPS/W(효율): 배터리로 작동하는 소형 로봇 및 드론의 경우, 절대적인 성능보다 와트당 성능이 더 중요한 경우가 많습니다. Hailo-8은 26 TOPS/2.5W(약 10.4 TOPS/W)로 뛰어난 성능을 보여주는 반면, Jetson Orin Nano Super는 MAXN Super 모드에서 약 2.7 TOPS/W(67 TOPS/25W)에 그칩니다. 단, 이는 고정된 그래프로 제한되는 전용 ASIC과 달리 임의의 CUDA 모델을 실행할 수 있는 다용도성을 포기해야 한다는 점에 유의해야 합니다.
- 메모리 대역폭: 매 프레임마다 대규모 가중치 행렬을 다시 읽는 신경망 추론의 경우, 순수 연산 능력보다 메모리 대역폭이 속도 제한 요소가 되는 경우가 더 많습니다. Jetson Orin Nano Super의 LPDDR5(102GB/s)는 Raspberry Pi 5의 LPDDR4X(~17.1GB/s)보다 약 6배 빠르며, 이 차이가 카탈로그 TOPS 수치 중 실제로 활용할 수 있는 부분을 결정합니다.
- 기존 소프트웨어와의 호환성: Raspberry Pi 5는 표준 Linux 배포판과 ROS 2를 그대로 실행할 수 있는 반면, Coral/Hailo와 같은 ASIC 가속기는 미리 양자화되고 컴파일된 고정 그래프만 실행할 수 있습니다. 최적의 조합은 모델이 자주 변경되는 개발 단계에 있는지, 아니면 최종 추론만 실행하는 프로덕션 단계에 있는지에 따라 달라집니다.
- 공급 위험 및 로드맵 지속성: 공급업체가 사실상 투자를 중단한 Coral과 같은 제품은 커뮤니티의 호의에 의존하여 생존하는데, 이는 장기 프로젝트에서 신규 도입에 실질적인 위험 요소입니다. 반면 Jetson은 AGX Orin의 자동차 등급 ISO 26262 ASIL-D 인증과 같이 로드맵 지속성을 위해 구축된 제품 라인을 유지합니다.
- 시장 외부 요인으로 인한 가격 변동: 2026년 Raspberry Pi 가격 인상에서 볼 수 있듯이, SBC 가격은 AI 데이터센터 수요와 같이 특정 프로젝트와는 전혀 무관한 요인으로 인해 급격하게 변동할 수 있습니다. 장기 구축을 위한 조달 계획에서는 공급 안정성과 단가를 모두 고려해야 합니다.
- 확장 인터페이스 가용성: Raspberry Pi 5의 PCIe 2.0 x1 레인은 AI HAT+와 같은 가속기를 최대 사양으로 구동하기에는 너무 좁으며, 경우에 따라 Hailo-8의 기본 성능(PCIe Gen3, 2레인 지원)을 완전히 활용하지 못할 수도 있습니다. 이는 모든 볼트온 가속기 구성에서 고려해야 할 실질적인 제약 조건입니다.
- 인클로저 크기 및 열 설계: 54×54×13mm의 초소형 M5Stack LLM 모듈과 같은 모듈은 절대적인 성능은 다소 떨어지더라도 단위 부피당 처리량 밀도에서 우위를 점할 수 있습니다. 이는 Jetson AGX Orin과 같이 방열판에 의존하는 모듈과는 근본적으로 다른 고려 사항이며, 어떤 기체나 섀시에 장착할 수 있는지에 대한 제약을 수반합니다. 드론이나 소형 로봇 팔처럼 장착 공간과 무게에 제약이 있는 경우, 단위 부피당 성능은 TOPS 및 TOPS/W와 함께 중요한 선택 기준이 됩니다.
더 빠른 CPU가 카메라 처리 병목 현상을 방지할 수 있나요?
메모리 대역폭, I/O, 전력 및 냉각이 처리량을 제한할 수 있습니다.
실제 주변 장치를 사용하여 지속적인 작동을 측정하십시오.참고 자료
- Raspberry Pi 5 제품 페이지
- Raspberry Pi 5 제품 개요 PDF
- 1GB Raspberry Pi 5, 현재 45달러에 판매 중, 메모리 용량 증가에 따른 가격 상승 (Raspberry Pi)
- 메모리 용량 증가에 따른 가격 상승 심화 (Raspberry Pi)
- AI 부족으로 Raspberry Pi 5 가격 급등 (Tom's Hardware)
- NVIDIA Jetson Orin 제품 페이지
- Jetson Orin Nano Super 개발자 키트 (NVIDIA)
- Nvidia의 새로운 249달러짜리 AI 개발 보드, 67 TOPS 성능 약속 (Tom's Hardware)
- NVIDIA JetPack 6.2, Jetson Orin Nano 및 Orin NX에 슈퍼 모드 제공 (NVIDIA 개발자 블로그)
- Jetson TK1: 모바일 임베디드 슈퍼컴퓨터, CUDA를 어디든 사용 가능하게 하다 (NVIDIA 기술 블로그)
- Coral USB 가속기 데이터시트 (Coral)
- Edge TPU 성능 벤치마크 (Coral)
- Coral TPU, 아마도 개발 중단 (Frigate GitHub 토론)
- TPU 2개 사용 시 TPU 1개 사용 시보다 추론 속도 향상 (Frigate GitHub) 토론)
- 객체 탐지기 (Frigate 문서)
- Raspberry Pi AI HAT+ 제품 페이지 (Raspberry Pi)
- Hailo-8 AI 가속기 (Hailo)
- Hailo-8 M.2 제품 개요 (Hailo PDF)
- BBC Micro와 Raspberry Pi (Raspberry Pi)
- Pi의 삶: Raspberry Pi 10년 (케임브리지 대학교)
- 클라우드에서 엣지로: 하드웨어 가속 단일 보드 컴퓨터에서 LLM 추론 벤치마킹 (arXiv:2604.24785)
댓글
먼저 로그인해 주세요.
아직 데이터가 없습니다.