Contents — find the section you need
एक एसबीसी (सिंगल बोर्ड कंप्यूटर) एक कॉम्पैक्ट कंप्यूटर है जो एक ही बोर्ड पर सीपीयू, मेमोरी, स्टोरेज इंटरफेस और विभिन्न इनपुट/आउटपुट को एकीकृत करता है। स्वायत्त मोबाइल रोबोट या ड्रोन में, यह स्व-स्थान निर्धारण, पथ नियोजन और सेंसर प्रोसेसिंग के पीछे का "मस्तिष्क" होता है। महज एक छोटे पीसी से कहीं अधिक, जीपीयू या एनपीयू (न्यूरल प्रोसेसिंग यूनिट) क्षमता को एकीकृत करने के डिजाइन दर्शन अब उत्पाद श्रृंखला के अनुसार काफी भिन्न हैं, और तीन धाराएँ समानांतर रूप से चल रही हैं: रास्पबेरी पाई का सामान्य-उद्देश्यीय लिनक्स एसओसी, एनवीडिया जेटसन का जीपीयू-एकीकृत एआई कंप्यूटर और गूगल कोरल का समर्पित एएसआईसी एक्सेलेरेटर।
 Raspberry Pi 5
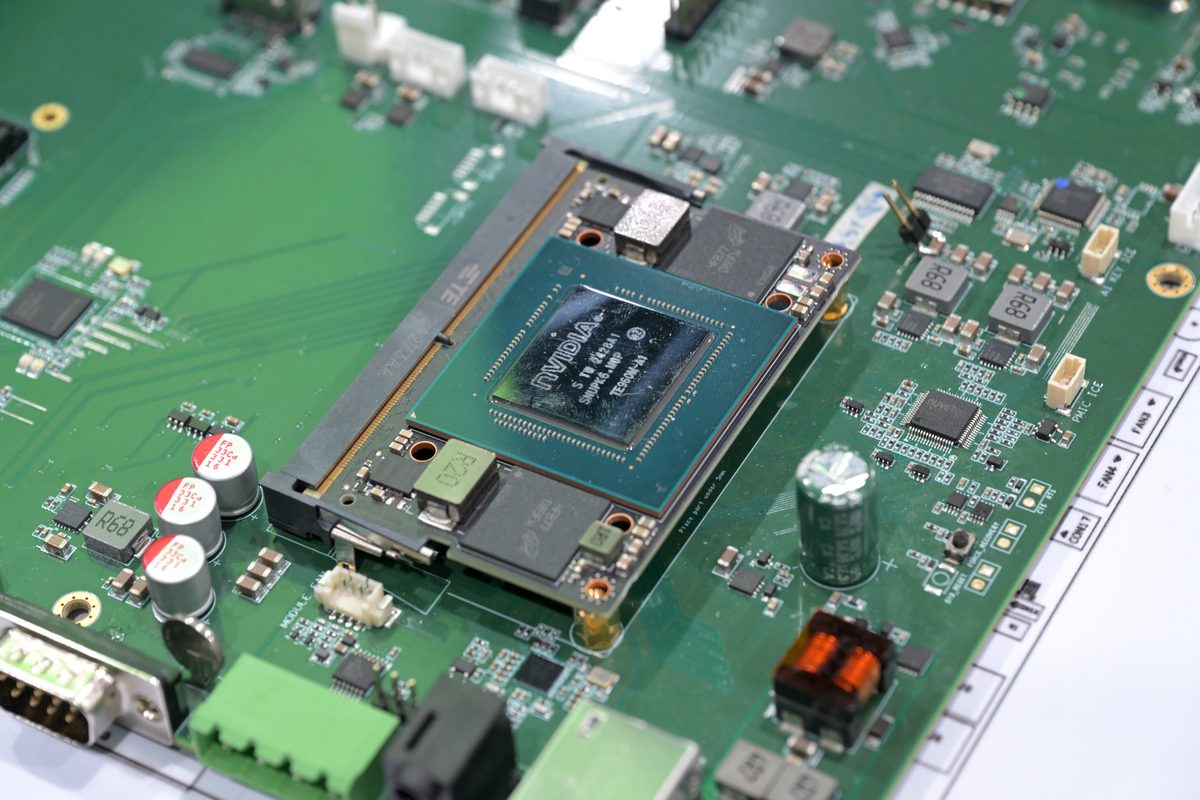 NVIDIA Jetson Orin NX (Computex 2025)
चित्र: Raspberry Pi 5 Board (SimonWaldherr, CC BY-SA 4.0) / Nvidia Jetson Orin NX on a motherboard Computex 2025 (4300streetcar, CC BY 4.0), दोनों Wikimedia Commons से लिए गए हैं। यह वही Jetson Orin Nano Super नहीं है जिसकी तुलना लेख में की गई है, बल्कि यह उसी Orin पीढ़ी और Ampere आर्किटेक्चर का Orin NX मॉड्यूल है। Google Coral (Dev Board/USB Accelerator) की कोई स्पष्ट तस्वीर Wikimedia Commons पर नहीं मिली, इसलिए इस लेख में इसकी कोई उत्पाद तस्वीर शामिल नहीं की गई है।


सिद्धांत: TOPS मेट्रिक और "मेमोरी वॉल"
SBC के प्रदर्शन की बात करते समय, केवल CPU क्लॉक स्पीड ही पर्याप्त नहीं होती। न्यूरल नेटवर्क इन्फरेंस के लिए विशेषीकृत GPU/NPU का प्रदर्शन प्रति सेकंड निष्पादित क्वांटाइज्ड पूर्णांक संक्रियाओं (आमतौर पर INT8) की संख्या के रूप में व्यक्त किया जाता है, जिसे TOPS (टेरा ऑपरेशंस प्रति सेकंड - एक ट्रिलियन संक्रियाएं प्रति सेकंड) की इकाई में मापा जाता है। TOPS का अनुमान समानांतर मल्टीप्लाई-एक्यूमुलेट (MAC) इकाइयों की संख्या और क्लॉक फ़्रीक्वेंसी से लगाया जा सकता है:
मल्टीप्लाई-एक्यूमुलेट में दो ऑपरेशन होते हैं — एक गुणा और एक जोड़ — इसलिए इसमें 2 का गुणक शामिल है। उदाहरण के लिए, NVIDIA का Jetson Orin Nano Super लगभग 1.7GHz पर 1024 CUDA कोर और 32 Tensor कोर संचालित करता है, और अपने पावर-सीलिंग-बढ़ाए गए "MAXN Super" मोड (25W) में 67 TOPS तक पहुँचता है।
इस TOPS के अधिकांश आंकड़े 32-बिट फ़्लोटिंग पॉइंट (FP32) के बजाय 8-बिट पूर्णांक (INT8) अंकगणित पर आधारित हैं। इन्फ़रेंस से पहले प्रशिक्षण के दौरान उपयोग किए जाने वाले FP32 भारों को INT8 में क्वांटाइज़ करने से सैद्धांतिक रूप से मॉडल का आकार और आवश्यक मेमोरी बैंडविड्थ एक चौथाई तक कम हो जाती है, जिससे समान कंप्यूटिंग इकाइयाँ अधिक समानांतर ऑपरेशन कर सकती हैं। यह एक ऐसा डिज़ाइन है जो सीमित पावर और मेमोरी बैंडविड्थ बजट के भीतर अधिकतम थ्रूपुट के लिए अनुमान सटीकता का त्याग करता है — और जेटसन, हैलो और कोरल सभी कैटलॉग TOPS आंकड़े उद्धृत करते हैं जो इस INT8 क्वांटाइजेशन को मानते हैं।
हालांकि, पीक कैटलॉग TOPS स्वतः ही प्रभावी प्रदर्शन में परिवर्तित नहीं होता है। कंप्यूट यूनिट कितनी भी तेज़ क्यों न हों, यदि आवश्यक डेटा (वज़न, मध्यवर्ती विशेषताएँ) मेमोरी से तेज़ी से प्राप्त नहीं किया जा सकता है, तो वे निष्क्रिय पड़ी रहती हैं। रूफलाइन मॉडल इसे दर्शाता है: प्रभावी प्रदर्शन P पीक कंप्यूट थ्रूपुट P_{peak} और मेमोरी बैंडविड्थ BW को अंकगणितीय तीव्रता (प्रति बाइट संचालन) AI से गुणा करने पर प्राप्त मान में से जो भी कम हो, उस पर सीमित है।
32-बिट बस पर चलने वाली Raspberry Pi 5 की LPDDR4X-4267 की सैद्धांतिक बैंडविड्थ लगभग 17.1GB/s है, जबकि Jetson Orin Nano Super की LPDDR5 की बैंडविड्थ 102GB/s है — लगभग 6 गुना। CPU-आधारित कार्यभार में यह अंतर शायद ही कभी महसूस होता है, लेकिन न्यूरल नेटवर्क इन्फरेंस के लिए, जो हर फ्रेम में बड़े वेट मैट्रिक्स को दोबारा पढ़ता है, यह बैंडविड्थ अंतर ही वह कारक बन जाता है जो यह निर्धारित करता है कि कैटलॉग TOPS आंकड़े का कितना हिस्सा वास्तव में निकाला जा सकता है।
तीन डिज़ाइन सिद्धांत: सामान्य-उद्देश्य SoC, GPU-एकीकृत, समर्पित ASIC
"SBC" कहे जाने वाले उत्पाद, AI इन्फरेंस को संभालने के तरीके के आधार पर मोटे तौर पर तीन श्रेणियों में विभाजित होते हैं।
सामान्य प्रयोजन SoC (रास्पबेरी पाई) में एक CPU, GPU और विभिन्न I/O नियंत्रक एकीकृत होते हैं, लेकिन इसमें न्यूरल नेटवर्क इन्फरेंस के लिए कोई समर्पित NPU नहीं होता है। यह एक पूर्ण लिनक्स वितरण पर चलता है, और इसकी सबसे बड़ी खूबी यह है कि यह लगभग सभी मौजूदा सॉफ़्टवेयर स्टैक — जिसमें ROS 2 भी शामिल है — का उपयोग कर सकता है; इसका डिज़ाइन यह मानता है कि जब भी इन्फरेंस प्रदर्शन की आवश्यकता होती है, एक बाहरी एक्सेलेरेटर (उदाहरण के लिए, नीचे चर्चा किया गया हैलो) उस कमी को पूरा करता है।
GPU-एकीकृत AI कंप्यूटर (NVIDIA जेटसन) में उच्च-बैंडविड्थ मेमोरी के साथ एक ही पैकेज में CUDA-प्रोग्रामेबल GPU और टेंसर कोर एकीकृत होते हैं। एक समर्पित ASIC के विपरीत, जो केवल पूर्व-क्वांटाइज़्ड, निश्चित गणना ग्राफ़ को ही प्रोसेस कर सकता है, यह किसी भी CUDA कर्नेल और PyTorch/TensorRT मॉडल को सीधे चलाने की बहुमुखी प्रतिभा को बरकरार रखता है, साथ ही कहीं अधिक समानांतर कंप्यूटिंग क्षमता प्रदान करता है। ऑटोमोटिव-ग्रेड विश्वसनीयता के लिए भी उत्पाद श्रृंखलाएं मौजूद हैं, जैसे कि AGX Orin, जिसे स्वायत्त ड्राइविंग और रोबोटिक्स के लिए ISO 26262 ASIL-D कार्यात्मक सुरक्षा प्रमाणन प्राप्त है।
समर्पित ASIC एक्सेलेरेटर (Google Coral / Hailo) एक निश्चित-कार्यक्षमता वाले ASIC के रूप में होता है जो पूरी तरह से क्वांटाइज्ड न्यूरल नेटवर्क इन्फरेंस के लिए विशेषीकृत होता है, जिसे USB या M.2 के माध्यम से होस्ट SBC में जोड़ा जाता है। बहुमुखी प्रतिभा का त्याग करने के बदले में, यह अन्य दो तरीकों की तुलना में कहीं अधिक दक्षता (TOPS प्रति वाट) प्राप्त कर सकता है।
ये तीनों श्रेणियां परस्पर अनन्य नहीं हैं, और वास्तविक रोबोट परियोजनाएं अक्सर इन्हें संयोजित करती हैं। Raspberry Pi 5 जैसे सामान्य-उद्देश्य वाले SoC को ASIC एक्सेलेरेटर (AI HAT+) के साथ जोड़ना एक ऐसा समझौता है जिसका उद्देश्य Linux/ROS 2 सॉफ़्टवेयर स्टैक की व्यापकता और ASIC पर इन्फरेंस को ऑफलोड करने की बिजली दक्षता दोनों को प्राप्त करना है - और, जैसा कि नीचे चर्चा किए गए बेंचमार्किंग पेपर से पता चलता है, यह संयोजन एक स्टैंडअलोन GPU-एकीकृत कंप्यूटर की दक्षता के करीब पहुंच सकता है।
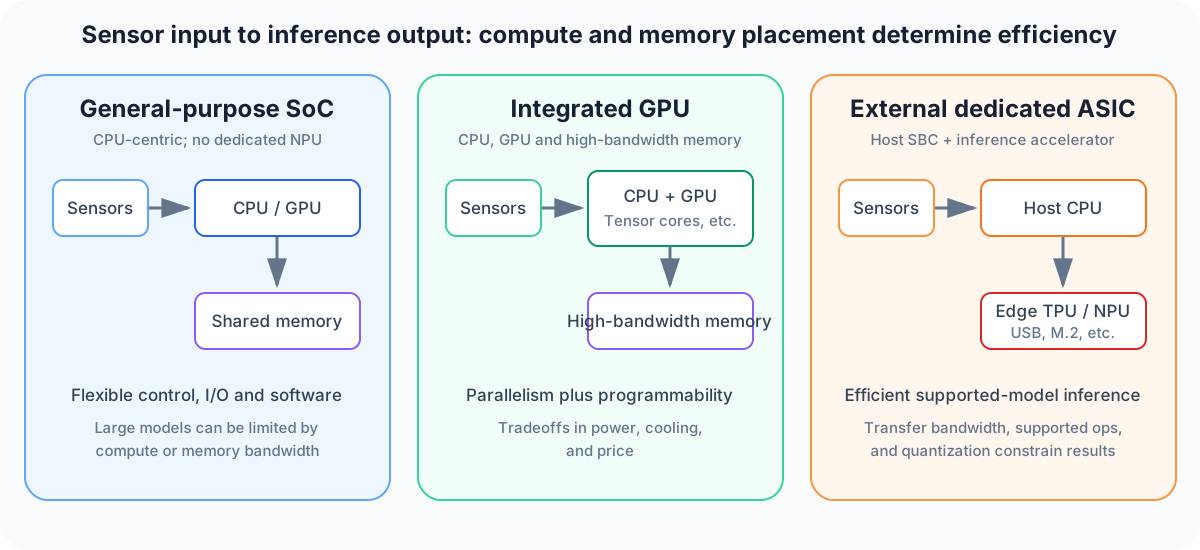
आरेख: डस्ककॉइल। यह एक वैचारिक लेआउट है, उत्पाद गति रैंकिंग नहीं। प्रभावी प्रदर्शन मॉडल, परिशुद्धता, सॉफ़्टवेयर, मेमोरी बैंडविड्थ और पावर कॉन्फ़िगरेशन पर निर्भर करता है।
प्रमुख उत्पाद विनिर्देश तुलना
| उत्पाद | प्रकार | कंप्यूट कोर | AI प्रदर्शन | मेमोरी | पावर | कीमत |
|---|---|---|---|---|---|---|
| रास्पबेरी पाई 5 (16GB) | सामान्य प्रयोजन SoC (NPU रहित) | कॉर्टेक्स-A76 4-कोर, 2.4GHz | — (बाहरी मेमोरी आवश्यक) | LPDDR4X 16GB (~17.1GB/s) | 5V/5A सप्लाई (25W अधिकतम) | $305 (अप्रैल 2026 तक) |
| Raspberry Pi AI HAT+ (Hailo-8) | समर्पित ASIC (RPi5 ऐड-ऑन HAT) | Hailo-8 NPU | 26 TOPS (INT8) | — | ~2.5W | $110 |
| Google Coral USB एक्सेलेरेटर | समर्पित ASIC (USB) | Edge TPU | 4 TOPS (INT8) | — | 2W | ~$75–99 |
| NVIDIA Jetson Orin Nano Super | GPU-एकीकृत AI कंप्यूटर | Cortex-A78AE 6-कोर, 1.7GHz + Ampere GPU, 1024 कोर/32 टेन्सर कोर | 67 TOPS (INT8, MAXN सुपर मोड) | LPDDR5 8GB (102GB/s) | 7–25W (परिवर्तनीय) | $249 |
NVIDIA Jetson AGX Orin (64GB) | GPU-एकीकृत AI कंप्यूटर (फ्लैगशिप) | Cortex-A78AE 12-कोर + Ampere GPU, 2048 कोर/64 टेन्सर कोर | 275 TOPS (INT8) | LPDDR5 64GB, 256-बिट | 15–60W (परिवर्तनीय) | — |
Raspberry Pi 5 वह मॉडल है जिसका उपयोग newbot प्रोजेक्ट अपने मुख्य नियंत्रण कंप्यूटर के रूप में करता है, जो स्व-स्थान निर्धारण, सुरक्षा निगरानी और सेंसर अधिग्रहण जैसी एज-साइड प्रोसेसिंग को संभालता है। क्योंकि न्यूबॉट का लिडार-इनर्टियल ओडोमेट्री (फास्ट-एलआईओ) एक एल्गोरिदम है जो पूरी तरह से सीपीयू पर चलता है, और सिस्टम को लगातार बड़े पैमाने पर न्यूरल नेटवर्क इन्फरेंस चलाने की आवश्यकता नहीं होती है, इसलिए बिना किसी समर्पित एनपीयू के एक सामान्य-उद्देश्यीय एसओसी इसकी आवश्यकताओं को पूरा करने के लिए पर्याप्त है। इसके विपरीत, कैमरा फीड से रीयल-टाइम ऑब्जेक्ट डिटेक्शन या सेगमेंटेशन पर आधारित रोबोट को जेटसन जैसे एकीकृत जीपीयू, या हैलो/कोरल-क्लास के बाहरी एक्सेलेरेटर की आवश्यकता होगी। जेटसन ओरिन नैनो सुपर का इतिहास भी अनोखा है: दिसंबर 2024 में "सुपर मोड" नामक एक सॉफ्टवेयर अपडेट ने इसकी पावर क्षमता को बढ़ा दिया और इसे पिछली पीढ़ी के 499 डॉलर वाले 40 टॉप्स से 249 डॉलर वाले 67 टॉप्स तक पहुंचा दिया - यानी आधी कीमत पर अधिक प्रदर्शन।
इतिहास: बीबीसी माइक्रो के लिए पुरानी यादें, और एक गेमिंग जीपीयू निर्माता का नया दृष्टिकोण
रैस्पबेरी पाई: कैम्ब्रिज में दाखिलों में गिरावट से प्रेरित — रैस्पबेरी पाई फाउंडेशन के संस्थापक एबेन अप्टन को 1988 में 10 साल की उम्र में एक पुराना बीबीसी माइक्रो (एक घरेलू कंप्यूटर जिसे बीबीसी ने 1980 के दशक में शिक्षा के लिए इस्तेमाल किया था) मिला, और यह बेसिक में प्रोग्रामिंग का उनका पहला अनुभव था। बाद में, लगभग 2006 में कैम्ब्रिज विश्वविद्यालय में कंप्यूटर विज्ञान के अध्ययन निदेशक के रूप में काम करते हुए, उन्होंने देखा कि कम प्रोग्रामिंग अनुभव वाले आवेदकों की संख्या में अचानक वृद्धि हुई है, साथ ही कंप्यूटर साइंस ट्रिपोस में आवेदनों में भी गिरावट आई है। बीबीसी माइक्रो जैसे "चालू करो और प्रोग्रामिंग शुरू करो" कंप्यूटरों के घरों से गायब होने को एक कारण मानते हुए, अप्टन ने 2006 से 2011 तक शाम और सप्ताहांत में ब्रॉडकॉम में अपनी दिन की नौकरी के साथ-साथ एक कम लागत वाला एसबीसी विकसित करने में बिताया। Raspberry Pi फाउंडेशन की औपचारिक स्थापना 2009 में "35 डॉलर से कम कीमत में एक प्रोग्रामेबल कंप्यूटर" बनाने के लक्ष्य के साथ की गई थी। 2011 में, फाउंडेशन के सदस्यों ने BBC को एक प्रोटोटाइप दिखाया, इस उम्मीद में कि वे इसे "BBC Micro" नाम से आगे बढ़ाएंगे, लेकिन कानूनी परिस्थितियों के कारण ऐसा नहीं हो सका। हालांकि, BBC के एक पत्रकार ने प्रोटोटाइप का एक डेमो वीडियो प्रकाशित किया जो वायरल हो गया, जिससे आधिकारिक लॉन्च से पहले ही इसकी भारी मांग साबित हो गई।
जेटसन: गेमिंग GPU निर्माता ने 2014 में रोबोटिक्स में कदम रखा — मार्च 2014 में, NVIDIA के CEO जेन्सेन हुआंग ने GTC (GPU टेक्नोलॉजी कॉन्फ्रेंस) में अपने मुख्य भाषण में जेटसन TK1 का अनावरण किया। इसमें मोबाइल-ओरिएंटेड टेग्रा K1 चिप को 192-कोर केप्लर-आर्किटेक्चर GPU के साथ जोड़ा गया था, जो 326 GFLOPS की क्षमता प्रदान करता था — उस समय के किसी एम्बेडेड डिवाइस के लिए यह एक असाधारण आंकड़ा था — और इसके साथ ही इसमें CUDA प्रोग्रामिंग मॉडल भी शामिल था। शुरुआत से ही, रोबोट नेविगेशन और ड्रोन बाधा निवारण जैसे उपयोग के उदाहरण इसके प्रचार का हिस्सा थे, जो गेमिंग और डेटासेंटर जीपीयू में मुख्य रूप से प्रतिस्पर्धा कर रही एनवीडिया की एम्बेडेड रोबोटिक्स बाजार में वास्तविक पैठ का प्रतीक थे।
जेटसन लाइनअप ने लगभग हर दूसरी पीढ़ी में अपने जीपीयू आर्किटेक्चर को अपडेट किया: 2017 में TX2 आया, जिसमें 256-कोर पास्कल जीपीयू था जो TK1 की तुलना में 2 गुना अधिक प्रदर्शन देता था; 2018-2020 में वोल्टा आर्किटेक्चर वाली जेवियर पीढ़ी आई, जिसने TX2 की तुलना में 20 गुना से अधिक प्रदर्शन और 10 गुना से अधिक बिजली दक्षता देने का दावा किया; और 2022 में एम्पीयर आर्किटेक्चर वाली ओरिन पीढ़ी आई। लगातार पैटर्न यह है कि गेमिंग जीपीयू बाजार में पहले पेश किए गए आर्किटेक्चर को कुछ वर्षों बाद एम्बेडेड उपयोग के लिए पुन: तैयार किया जाता है - एक ऐसी संरचना जिसमें एनवीडिया के डेटासेंटर और पीसी जीपीयू व्यवसाय का तकनीकी संचय सीधे उसके एम्बेडेड रोबोटिक्स उत्पादों के प्रदर्शन में सुधार लाता है, और यही जेटसन की मुख्य ताकत है।
एक वास्तविक प्रयोग: एक होम एनवीआर द्वारा कई कोरल एज टीपीयू का संचालन
एक समर्पित एएसआईसी एक्सेलेरेटर को एक साथ कई चलाने का एक प्रतिनिधि उदाहरण फ्रिगेट एनवीआर है, जो एक ओपन-सोर्स रिकॉर्डिंग और ऑब्जेक्ट-डिटेक्शन पैकेज है। फ्रिगेट निगरानी कैमरा फीड का वास्तविक समय में विश्लेषण करता है और व्यक्ति/वाहन का पता लगाने का कार्य कोरल एज टीपीयू को सौंप देता है। इसकी वास्तुकला प्रत्येक टीपीयू के लिए एक समर्पित प्रक्रिया निर्धारित करती है और कई कैमरों से प्राप्त डिटेक्शन अनुरोधों को एक साझा कतार के माध्यम से उन प्रक्रियाओं में वितरित करती है।
माना जाता है कि एक एकल कोरल यूएसबी एक्सेलेरेटर (4 टीओपीएस) लगभग दो से चार 1080p स्ट्रीम के लिए वास्तविक समय में डिटेक्शन का कार्य स्वयं संभाल सकता है; रिपोर्ट के अनुसार, दो 8-टीओपीएस कोरल डुअल एज टीपीयू (एम.2) कार्डों के संयोजन ने 20 से अधिक कैमरों को एक साथ संभाला है, जबकि चिप का उपयोग लगभग 12% रहा। दूसरी ओर, यह भी ज्ञात है कि कई USB एक्सेलेरेटर को एक साथ उपयोग करने से होस्ट की USB बस बैंडविड्थ एक बाधा बन सकती है, इसलिए प्रदर्शन डिवाइसों की संख्या के साथ रैखिक रूप से नहीं बढ़ता है। कैमरों की संख्या बढ़ाने के लिए एक ही NVR सर्वर में कई समर्पित ASIC जोड़ना एक आदर्श परिनियोजन पैटर्न है जो प्रति TOPS कम लागत और कम बिजली खपत का लाभ उठाता है।
AI-डेटासेंटर की बढ़ती मांग ने शौकिया SBC की कीमतों को कैसे बढ़ाया
2026 में, Raspberry Pi को अपने नियंत्रण से बाहर के कारणों से बार-बार कीमतें बढ़ानी पड़ीं। इसका कारण AI डेटासेंटरों से बढ़ती मांग के कारण मेमोरी बाजार में आई मंदी थी - Raspberry Pi फाउंडेशन के CEO एबेन अप्टन ने स्वयं कंपनी के ब्लॉग पर खुलासा किया कि Raspberry Pi 4/5 में उपयोग की जाने वाली LPDDR4 DRAM की खरीद लागत एक ही वर्ष में सात गुना बढ़ गई थी। दिसंबर 2025 में मूल्य वृद्धि के बाद, 2026 की पहली छमाही में कई और वृद्धियों की घोषणा की गई, और अप्रैल 2026 में 16GB मॉडल की कीमत में 100 की वृद्धि हुई, जिससे इसकी कीमत305 हो गई — जो लॉन्च के समय (अक्टूबर 2024, जब 16GB मॉडल 120 में लॉन्च हुआ था) की कीमत से 2.5 गुना से भी अधिक है। विडंबना यह है कि इस मूल्य वृद्धि के साथ ही, फाउंडेशन ने 2026 में केवल45 की कीमत पर एक नया 1GB मॉडल भी पेश किया — यह एक ऐसा उदाहरण है जहां उच्च-प्रदर्शन AI मेमोरी की मांग एक पूरी तरह से असंबंधित बाजार: शौकिया एम्बेडेड कंप्यूटरों की मूल्य संरचना तक पहुंच गई।
गूगल द्वारा परित्यक्त, समुदाय द्वारा जीवित रखा गया कोरल
कोरल के भीतर एज टीपीयू उसी "सिस्टोलिक ऐरे" कंप्यूट आर्किटेक्चर का अनुसरण करता है जिसे गूगल ने अपने डेटासेंटर टीपीयू के लिए विकसित किया था — यह प्रभावी रूप से एक लघु संस्करण है। जहां डेटासेंटर-स्केल TPU v1 एक विशाल 256×256 सिस्टोलिक ऐरे के साथ ट्रेनिंग और इन्फरेंस को संभालता है, वहीं एज TPU उस ऐरे को काफी छोटा कर देता है और बिजली की खपत को सिंगल-डिजिट वाट तक कम कर देता है, जिससे यह सीमित बिजली खपत वाले एम्बेडेड डिवाइसों में भी चल सकता है। Google ने 2019 में इस एज TPU (4 TOPS, 2W) को एक देव बोर्ड और एक USB एक्सेलेरेटर के साथ कोरल लॉन्च किया था, और इसने Raspberry Pi जैसे मौजूदा SBCs के लिए एक बोल्ट-ऑन एक्सेलेरेटर के रूप में लोकप्रियता हासिल की, क्योंकि इसकी बिजली-कुशल इन्फरेंस क्षमता MobileNet v2 को लगभग 400 फ्रेम प्रति सेकंड पर चला सकती थी। हालांकि, तब से Google ने कोई उल्लेखनीय नया हार्डवेयर जारी किए बिना इस उत्पाद श्रृंखला में निवेश करना बंद कर दिया है, और अधिकांश सहायक लाइब्रेरी को 2022 के बाद से अपडेट नहीं किया गया है। PCIe से कनेक्टेड कोरल डिवाइसों के लिए आवश्यक GASKET ड्राइवर वर्तमान Linux कर्नेल पर समर्थित नहीं है। कोरल को पूरी तरह से अप्रचलित होने से बचाने का कारण यह है कि Google ने इसके ड्राइवर और फर्मवेयर को ओपन-सोर्स कर दिया है; उपर्युक्त फ्रिगेट एनवीआर जैसी परियोजनाओं ने स्वयं ही इसके समर्थन का भार उठाया है और इसे उत्पादन में चालू रखा है - यह एक ऐसा उदाहरण है जहां आधिकारिक समर्थन समाप्ति और वास्तविक दुनिया में इसका निरंतर उपयोग साथ-साथ मौजूद हैं, जो हार्डवेयर उत्पाद चक्रों और ओपन-सोर्स सॉफ़्टवेयर के जीवनकाल के बीच बेमेल को दर्शाता है। एज टीपीयू का INT8 क्वांटाइजेशन सिद्धांत, और इसकी डिज़ाइन फिलॉसफी की तुलना इंटेल मोविडियस (मायरियाड एक्स) से कैसे की जाती है - एक और चिप जिसे बाद में बंद कर दिया गया - इस पर एज एआई एक्सेलेरेटर तुलना लेख में अधिक विस्तार से चर्चा की गई है।
क्या एसबीसी पर एक्सेलेरेटर लगाना जेटसन से बेहतर है? 2026 का एक बेंचमार्किंग शोध पत्र
अप्रैल 2026 में प्रकाशित "क्लाउड टू एज: बेंचमार्किंग एलएलएम इन्फरेंस ऑन हार्डवेयर-एक्सेलरेटेड सिंगल-बोर्ड कंप्यूटर्स" (रेनी, ट्रेड, मैटरॉक, एवेट्स, वुड) नामक शोध पत्र में एज एसबीसी पर लार्ज लैंग्वेज मॉडल (एलएलएम) इन्फरेंस चलाने के बारे में बताया गया है। इसमें चार कॉन्फ़िगरेशन में बिजली की खपत और थ्रूपुट की तुलना की गई है: एक साधारण रास्पबेरी पाई 5 (केवल सीपीयू), एक रास्पबेरी पाई 5 जिसमें एआई हैट+ (हैलो-10एच एनपीयू) लगा है, एक जेटसन ओरिन नैनो सुपर (सीपीयू और जीपीयू कॉन्फ़िगरेशन अलग-अलग), और एक एम5स्टैक एलएलएम मॉड्यूल (एएक्स630सी एनपीयू)। परिणाम: Raspberry Pi 5 में Hailo NPU जोड़ने से CPU-आधारित कॉन्फ़िगरेशन की तुलना में टोकन-प्रति-वॉट दक्षता में 9.57 गुना से 39.97 गुना तक सुधार हुआ, जिससे प्रति मेगाटोकन ऊर्जा खपत 27-77 मेगाजूल से घटकर 0.88-5.51 मेगाजूल हो गई। रॉ थ्रूपुट में, Jetson Orin Nano का GPU कॉन्फ़िगरेशन 9-10 टोकन प्रति सेकंड की दर से सबसे तेज़ था, लेकिन Raspberry Pi 5 + Hailo कॉन्फ़िगरेशन ने लगभग आधी बिजली खपत और छोटे आकार में Jetson के CPU-आधारित कॉन्फ़िगरेशन के थ्रूपुट के बराबर प्रदर्शन किया। ये आंकड़े इस दावे का समर्थन करते हैं कि "सामान्य-उद्देश्य SoC और समर्पित ASIC" का संयोजन बिजली दक्षता के मामले में एक स्टैंडअलोन GPU-एकीकृत कंप्यूटर के बराबर प्रदर्शन कर सकता है।
प्रदर्शन निर्धारित करने वाले पैरामीटर
- TOPS/W (दक्षता): बैटरी से चलने वाले छोटे रोबोट और ड्रोन के लिए, प्रति वाट प्रदर्शन अक्सर निरपेक्ष प्रदर्शन से अधिक मायने रखता है। Hailo-8 26 TOPS/2.5W (लगभग 10.4 TOPS/W) के साथ उत्कृष्ट प्रदर्शन करता है, जबकि Jetson Orin Nano Super अपने MAXN सुपर मोड में केवल लगभग 2.7 TOPS/W (67 TOPS/25W) ही हासिल कर पाता है। हालांकि, ध्यान दें कि यह किसी भी CUDA मॉडल को चलाने की बहुमुखी प्रतिभा के बदले में है, जबकि एक समर्पित ASIC निश्चित ग्राफ़ तक सीमित होता है।
- मेमोरी बैंडविड्थ: न्यूरल नेटवर्क इन्फरेंस के लिए जो प्रत्येक फ्रेम में बड़े वेट मैट्रिक्स को पुनः पढ़ता है, मेमोरी बैंडविड्थ अक्सर रॉ कंप्यूट की तुलना में दर-सीमित कारक बन जाता है। जेटसन ओरिन नैनो सुपर की LPDDR5 (102GB/s) क्षमता रास्पबेरी पाई 5 की LPDDR4X (~17.1GB/s) से लगभग 6 गुना अधिक है, और यह अंतर निर्धारित करता है कि कैटलॉग TOPS आंकड़े का कितना हिस्सा वास्तव में प्राप्त किया जा सकता है।
- मौजूदा सॉफ़्टवेयर के साथ संगतता: रास्पबेरी पाई 5 मानक लिनक्स वितरण और ROS 2 को बिना किसी बदलाव के चला सकता है, जबकि कोरल/हैलो जैसे ASIC एक्सेलेरेटर केवल पूर्व-क्वांटाइज़्ड, पूर्व-संकलित निश्चित ग्राफ़ को ही निष्पादित कर सकते हैं। कौन सा संयोजन इष्टतम है, यह इस बात पर निर्भर करता है कि आप विकास के चरण में हैं जहाँ मॉडल बार-बार बदलते हैं, या उत्पादन चरण में हैं जहाँ केवल अंतिम रूप से तैयार किए गए अनुमान ही चल रहे हैं।
- आपूर्ति जोखिम और रोडमैप निरंतरता: कोरल जैसा उत्पाद, जिसमें विक्रेता ने प्रभावी रूप से निवेश करना बंद कर दिया है, समुदाय की सद्भावना पर निर्भर करता है - एक दीर्घकालिक परियोजना में नए अपनाने के लिए यह एक वास्तविक जोखिम है। इसके विपरीत, जेटसन रोडमैप की निरंतरता के लिए निर्मित उत्पाद श्रृंखलाओं को बनाए रखता है, जैसे कि AGX ओरिन का ऑटोमोटिव-ग्रेड ISO 26262 ASIL-D प्रमाणन।
- बाजार के बाहर से कीमतों में उतार-चढ़ाव: जैसा कि 2026 में रास्पबेरी पाई की कीमतों में हुई वृद्धि से पता चलता है, एसबीसी की कीमतें किसी परियोजना से पूरी तरह से बाहर के कारकों के कारण तेजी से बदल सकती हैं - जैसे कि एआई-डेटासेंटर की मांग। दीर्घकालिक तैनाती के लिए खरीद योजना बनाते समय आपूर्ति स्थिरता के साथ-साथ इकाई मूल्य का भी ध्यान रखना आवश्यक है।
- विस्तार इंटरफेस की उपलब्धता: Raspberry Pi 5 की PCIe 2.0 x1 लेन AI HAT+ जैसे एक्सेलेरेटर को पूर्ण क्षमता पर चलाने के लिए बहुत संकीर्ण है, और कुछ मामलों में Hailo-8 के कैटलॉग प्रदर्शन (PCIe Gen3, 2 लेन के लिए रेटेड) को पूरी तरह से प्राप्त नहीं कर पाती है - किसी भी बोल्ट-ऑन एक्सेलेरेटर सेटअप के लिए यह एक व्यावहारिक बाधा है जिस पर विचार करना आवश्यक है।
- एनक्लोजर का आकार और थर्मल डिज़ाइन: M5Stack LLM मॉड्यूल जैसा एक अति-कॉम्पैक्ट मॉड्यूल, 54×54×13 मिमी आकार का होने के बावजूद, प्रति इकाई आयतन थ्रूपुट घनत्व में बेहतर प्रदर्शन कर सकता है, भले ही वह पूर्ण प्रदर्शन में पीछे रह जाए। यह Jetson AGX Orin जैसे हीटसिंक-निर्भर मॉड्यूल से बिल्कुल अलग है, क्योंकि यह इस बात पर निर्भर करता है कि यह किस एयरफ्रेम या चेसिस में फिट होता है। ड्रोन या छोटे रोबोटिक आर्म्स के लिए, जहां माउंटिंग स्पेस और वजन सीमित होते हैं, वहां TOPS और TOPS/W के साथ-साथ प्रति यूनिट वॉल्यूम परफॉर्मेंस भी एक महत्वपूर्ण चयन मानदंड बन जाता है।
क्या तेज़ CPU कैमरा प्रोसेसिंग में आने वाली बाधाओं को दूर करता है?
मेमोरी बैंडविड्थ, I/O, पावर और कूलिंग थ्रूपुट को सीमित कर सकते हैं।
वास्तविक परिधीय उपकरणों के साथ निरंतर संचालन को मापें।संदर्भ
- रास्पबेरी पाई 5 उत्पाद पृष्ठ
- रास्पबेरी पाई 5 उत्पाद संक्षिप्त विवरण PDF
- 1GB रास्पबेरी पाई 5 अब $45 में उपलब्ध है, और मेमोरी-आधारित कीमतों में वृद्धि (रास्पबेरी पाई)
- मेमोरी-आधारित कीमतों में और वृद्धि (रास्पबेरी पाई)
- एआई की कमी के कारण रास्पबेरी पाई 5 की कीमतों में भारी वृद्धि (टॉम्स हार्डवेयर)
- एनवीडिया जेटसन ओरिन उत्पाद पृष्ठ
- जेटसन ओरिन नैनो सुपर डेवलपर किट (एनवीडिया)
- एनवीडिया का नया $249 एआई डेवलपमेंट बोर्ड 67 TOPS का वादा करता है (टॉम्स हार्डवेयर)
- एनवीडिया जेटपैक 6.2 जेटसन ओरिन नैनो और ओरिन एनएक्स में सुपर मोड लाता है (एनवीडिया डेवलपर ब्लॉग)
- जेटसन टीके1: मोबाइल एम्बेडेड सुपरकंप्यूटर CUDA को हर जगह ले जाता है (एनवीडिया तकनीकी ब्लॉग)
- कोरल यूएसबी एक्सेलेरेटर डेटाशीट (कोरल)
- एज टीपीयू प्रदर्शन बेंचमार्क (कोरल)
- कोरल टीपीयू शायद बंद हो गया है (फ्रिगेट गिटहब चर्चा)
- बढ़ोतरी 2 टीपीयू बनाम 1 टीपीयू के साथ अनुमान गति में (फ्रिगेट गिटहब चर्चा)
- ऑब्जेक्ट डिटेक्टर (फ्रिगेट दस्तावेज़ीकरण)
- रास्पबेरी पाई एआई हैट+ उत्पाद पृष्ठ (रास्पबेरी पाई)
- हैलो-8 एआई एक्सेलेरेटर (हैलो)
- हैलो-8 एम.2 उत्पाद संक्षिप्त विवरण (हैलो पीडीएफ)
- बीबीसी माइक्रो और रास्पबेरी पाई (रास्पबेरी पाई)
- पाई का जीवन: रास्पबेरी पाई के दस वर्ष (कैम्ब्रिज विश्वविद्यालय)
- [क्लाउड से एज: एलएलएम अनुमान का बेंचमार्किंग] हार्डवेयर-एक्सेलरेटेड सिंगल-बोर्ड कंप्यूटर (arXiv:2604.24785)](https://arxiv.org/abs/2604.24785)
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।