Contents — find the section you need
Un SBC (Single Board Computer) è un computer compatto che integra CPU, memoria, interfacce di archiviazione e vari I/O su un'unica scheda. In un robot mobile autonomo o in un drone, rappresenta il "cervello" alla base di funzioni come l'autolocalizzazione, la pianificazione del percorso e l'elaborazione dei dati dei sensori. Ben lungi dall'essere un semplice PC di piccole dimensioni, la filosofia progettuale relativa all'integrazione di GPU o NPU (Neural Processing Unit) per l'inferenza varia notevolmente a seconda della linea di prodotti, e tre filoni di ricerca procedono in parallelo: il SoC Linux per uso generico di Raspberry Pi, il computer per l'intelligenza artificiale con GPU integrata di NVIDIA Jetson e l'acceleratore ASIC dedicato di Google Coral.
 Raspberry Pi 5
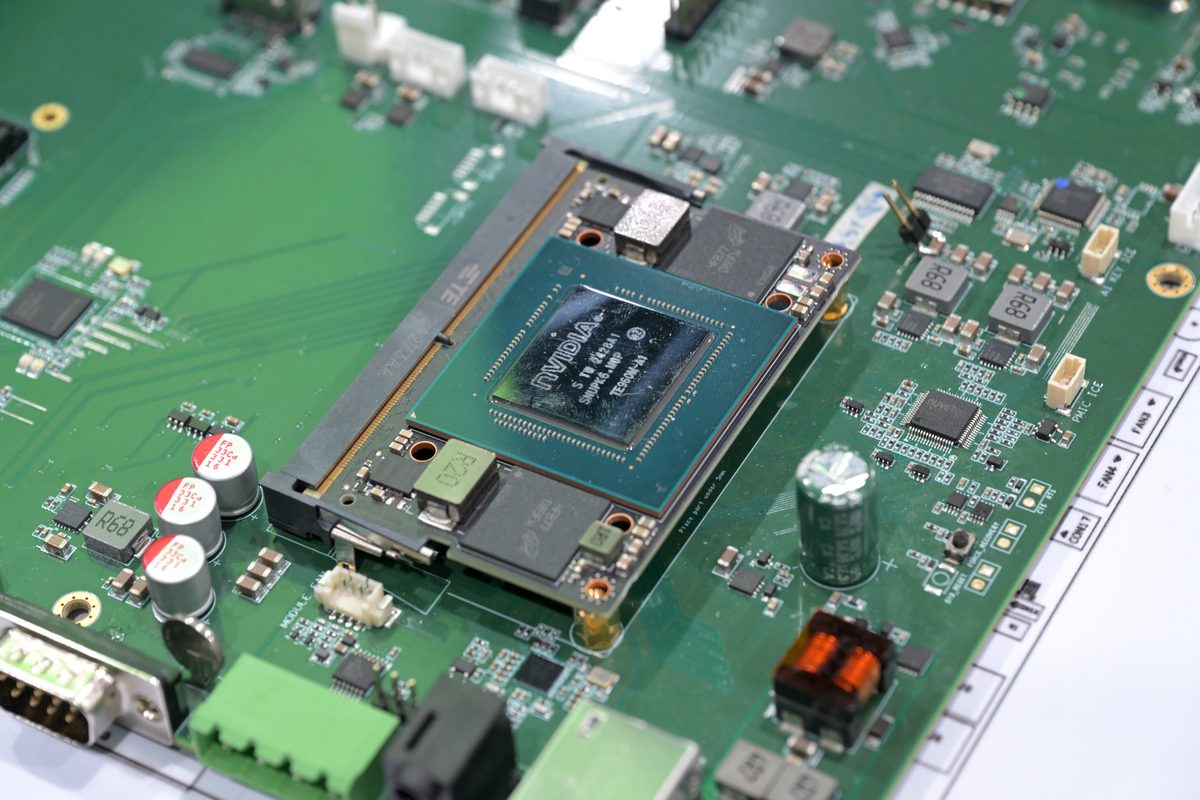 NVIDIA Jetson Orin NX (Computex 2025)
Immagini: Raspberry Scheda Pi 5 (SimonWaldherr, CC BY-SA 4.0) / Nvidia Jetson Orin NX su una scheda madre Computex 2025 (4300streetcar, CC BY 4.0), entrambi da Wikimedia Commons. Non si tratta esattamente del Jetson Orin Nano Super confrontato nel testo, ma di un modulo Orin NX della stessa generazione Orin e con architettura Ampere. Non è stata trovata alcuna foto nitida di Google Coral (Dev Board/USB Accelerator) su Wikimedia Commons, quindi non è inclusa alcuna foto del prodotto in questo articolo.


Principio: la metrica TOPS e il "muro della memoria"
Quando si parla di prestazioni di un SBC, la sola velocità di clock della CPU non è più sufficiente. Le prestazioni di una GPU/NPU specializzata per l'inferenza di reti neurali sono espresse come numero di operazioni intere quantizzate (solitamente INT8) eseguite al secondo, in unità di TOPS (Tera Operations Per Second - un trilione di operazioni al secondo). Il valore TOPS può essere stimato approssimativamente in base al numero di unità di moltiplicazione-accumulazione (MAC) parallele N_{MAC} e alla frequenza di clock f:
Un'operazione di moltiplicazione-accumulazione equivale a due operazioni: una moltiplicazione e una somma, da cui il fattore 2. La Jetson Orin Nano Super di NVIDIA, ad esempio, gestisce 1024 core CUDA e 32 core Tensor a circa 1,7 GHz, raggiungendo 67 TOPS nella sua modalità "MAXN Super" (25 W) con potenza massima elevata.
La maggior parte di questo valore TOPS si basa sull'aritmetica a 8 bit interi (INT8) anziché a virgola mobile a 32 bit (FP32). La quantizzazione dei pesi FP32 utilizzati durante l'addestramento fino a INT8 prima dell'inferenza riduce teoricamente le dimensioni del modello e la larghezza di banda di memoria richiesta a un quarto, consentendo alle stesse unità di calcolo di eseguire un maggior numero di operazioni in parallelo. Si tratta di un'architettura che sacrifica la precisione dell'inferenza a favore della massima velocità di elaborazione entro un budget limitato di potenza e larghezza di banda di memoria. Jetson, Hailo e Coral citano tutti valori TOPS di catalogo che presuppongono questa quantizzazione INT8.
Detto questo, il valore TOPS di catalogo massimo non si traduce automaticamente in prestazioni effettive. Per quanto veloci siano le unità di calcolo, queste rimangono inattive se i dati di cui hanno bisogno (pesi, caratteristiche intermedie) non possono essere recuperati dalla memoria abbastanza velocemente. Il modello roofline cattura questo concetto: le prestazioni effettive P sono limitate al valore minore tra la velocità di elaborazione massima P_{peak} e la larghezza di banda di memoria BW moltiplicata per l'intensità aritmetica (operazioni per byte) AI.
La LPDDR4X-4267 del Raspberry Pi 5, su un bus a 32 bit, raggiunge una larghezza di banda teorica massima di circa 17,1 GB/s, contro i 102 GB/s della LPDDR5 del Jetson Orin Nano Super, circa 6 volte superiore. Questa differenza raramente si percepisce nei carichi di lavoro che dipendono dalla CPU, ma per l'inferenza di reti neurali che rilegge grandi matrici di pesi a ogni frame, questo divario di larghezza di banda diventa il fattore limitante che determina quanta parte del valore TOPS del catalogo è effettivamente possibile estrarre.
Tre filosofie di progettazione: SoC per uso generico, GPU integrata, ASIC dedicato
I prodotti chiamati "SBC" si dividono in tre categorie principali in base a come gestiscono l'inferenza AI.
SoC per uso generico (Raspberry Pi) integra una CPU, una GPU e vari controller I/O, ma non include una NPU dedicata per l'inferenza di reti neurali. Esegue una distribuzione Linux completa e il suo punto di forza principale è la capacità di utilizzare quasi l'intero stack software esistente, incluso ROS 2, così com'è; il design presuppone che, quando è necessaria una maggiore potenza di inferenza, un acceleratore esterno (Hailo, di cui si parlerà più avanti) colmi la lacuna.
Il computer AI integrato con GPU (NVIDIA Jetson) integra una GPU programmabile tramite CUDA e core Tensor nello stesso package della memoria ad alta larghezza di banda. A differenza di un ASIC dedicato che può gestire solo grafi di calcolo pre-quantizzati e fissi, mantiene la versatilità di eseguire direttamente kernel CUDA arbitrari e modelli PyTorch/TensorRT, offrendo al contempo una capacità di calcolo parallelo di gran lunga superiore. Esistono anche linee di prodotti con affidabilità di livello automobilistico, come l'AGX Orin, che possiede la certificazione di sicurezza funzionale ISO 26262 ASIL-D per la guida autonoma e la robotica.
Gli acceleratori ASIC dedicati (Google Coral/Hailo) si presentano sotto forma di ASIC a funzione fissa, specializzato esclusivamente per l'inferenza di reti neurali quantizzate, e vengono aggiunti a una scheda host (SBC) tramite USB o M.2. A scapito della versatilità, possono raggiungere un'efficienza (TOPS per watt) di gran lunga superiore rispetto agli altri due approcci.
Queste tre categorie non si escludono a vicenda e i progetti robotici reali spesso le combinano. Abbinare un SoC generico come il Raspberry Pi 5 a un acceleratore ASIC (AI HAT+) è un compromesso volto a ottenere sia l'ampiezza dello stack software Linux/ROS 2 sia l'efficienza energetica derivante dall'offload dell'inferenza a un ASIC. Come dimostra il documento di benchmarking discusso di seguito, questa combinazione può avvicinarsi all'efficienza di un computer standalone con GPU integrata.
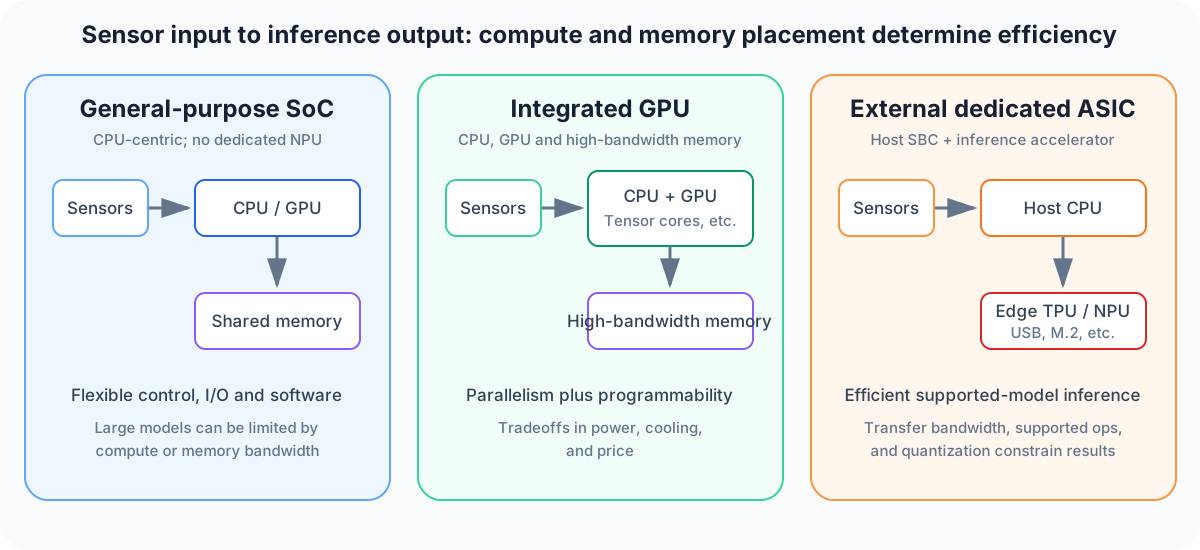
Diagramma: Duskcoil. Questo è uno schema concettuale, non una classifica delle prestazioni del prodotto. Le prestazioni effettive dipendono dal modello, dalla precisione, dal software, dalla larghezza di banda della memoria e dalla configurazione di alimentazione.
Confronto delle specifiche chiave del prodotto
| Prodotto | Tipo | Core di calcolo | Prestazioni AI | Memoria | Consumo energetico | Prezzo |
|---|---|---|---|---|---|---|
| Raspberry Pi 5 (16 GB) | SoC generico (senza NPU) | Cortex-A76 quad-core, 2,4 GHz | — (necessario ASIC esterno) | LPDDR4X 16 GB (~17,1 GB/s) | Alimentazione 5 V/5 A (25 W max) | $305 (a partire da aprile 2026) |
Raspberry Pi AI HAT+ (Hailo-8) | ASIC dedicato (HAT aggiuntivo per Raspberry Pi 5) | NPU Hailo-8 | 26 TOPS (INT8) | — | ~2,5 W | $110 |
Acceleratore USB Google Coral | ASIC dedicato (USB) | TPU Edge | 4 TOPS (INT8) | — | 2 W | ~$75–99 |
NVIDIA Jetson Orin Nano Super | Computer AI con GPU integrata | Cortex-A78AE 6-core, 1,7 GHz + GPU Ampere, 1024 core/32 Tensor core | 67 TOPS (INT8, modalità MAXN Super) | LPDDR5 8 GB (102 GB/s) | 7–25 W (variabile) | $249 |
NVIDIA Jetson AGX Orin (64 GB) | Computer AI con GPU integrata (flagship) | Cortex-A78AE 12-core + GPU Ampere, 2048 core/64 Tensor core | 275 TOPS (INT8) | LPDDR5 64GB, 256-bit | 15–60W (variabile) | — |
Il Raspberry Pi 5 è il modello utilizzato dal progetto newbot come computer di controllo principale, per la gestione dell'elaborazione edge-side come l'autolocalizzazione, la supervisione della sicurezza e l'acquisizione dei dati dai sensori. Poiché l'algoritmo di odometria inerziale LiDAR (FAST-LIO) di newbot viene eseguito interamente sulla CPU e il sistema non necessita di eseguire costantemente inferenze di reti neurali su larga scala, un SoC generico senza NPU dedicata è sufficiente a soddisfare i requisiti. Al contrario, un robot progettato per il rilevamento o la segmentazione di oggetti in tempo reale da flussi video di telecamere richiederebbe in genere una GPU integrata come Jetson, o un acceleratore esterno di classe Hailo/Coral. Il Jetson Orin Nano Super ha anche una storia insolita: un aggiornamento software del dicembre 2024 chiamato "Super Mode" ha innalzato il limite di potenza, portandolo dai 40 TOPS a 499 dollari della generazione precedente a 67 TOPS a 249 dollari, ovvero più prestazioni a metà prezzo.
Storia: nostalgia per il BBC Micro e la svolta di un produttore di GPU per il gaming
Raspberry Pi: innescato da un calo delle ammissioni a Cambridge — Il fondatore della Raspberry Pi Foundation, Eben Upton, mise le mani su un BBC Micro di seconda mano (un computer domestico che la BBC utilizzò per scopi didattici negli anni '80) all'età di 10 anni nel 1988, e fu il suo primo approccio alla programmazione in BASIC. Successivamente, mentre ricopriva il ruolo di Direttore degli Studi di Informatica all'Università di Cambridge intorno al 2006, notò un'impennata di candidati con poca esperienza di programmazione, parallelamente a un calo delle iscrizioni al corso di laurea triennale in Informatica (Computer Science Tripos). Considerando la scomparsa dalle case di computer "pronti all'uso" come il BBC Micro come una delle cause, Upton dedicò serate e fine settimana, dal 2006 al 2011, allo sviluppo di una scheda a singolo circuito (SBC) a basso costo, parallelamente al suo lavoro presso Broadcom. La Raspberry Pi Foundation fu formalmente fondata nel 2009, con l'obiettivo di creare un "computer programmabile a meno di 35 dollari". Nel 2011, alcuni membri della Fondazione presentarono un prototipo alla BBC, sperando di poter continuare a utilizzare il nome "BBC Micro", cosa che, per ragioni legali, fu impossibile. Tuttavia, un giornalista della BBC pubblicò un video dimostrativo del prototipo che divenne virale, a dimostrazione della forte domanda ben prima del lancio ufficiale.
Jetson: un produttore di GPU per il gaming entra nel mondo della robotica nel 2014 — Nel marzo 2014, il CEO di NVIDIA, Jensen Huang, presentò personalmente il Jetson TK1 durante un keynote al GTC (GPU Technology Conference). Il dispositivo combinava il chip Tegra K1, orientato al mobile, con una GPU a 192 core basata sull'architettura Kepler, offrendo 326 GFLOPS — una cifra incredibile per un dispositivo embedded all'epoca — e introduceva il modello di programmazione CUDA. Fin da subito, casi d'uso come la navigazione robotica e l'evitamento degli ostacoli da parte dei droni furono parte integrante della presentazione, segnando il vero ingresso di NVIDIA nel mercato della robotica embedded da un'azienda che, fino ad allora, aveva operato principalmente nel settore delle GPU per il gaming e i data center.
La linea Jetson ha continuato ad aggiornare la propria architettura GPU all'incirca ogni due generazioni: il TX2 del 2017, con una GPU Pascal a 256 core che offriva prestazioni doppie rispetto al TK1; La generazione Xavier con architettura Volta (2018-2020), che prometteva prestazioni oltre 20 volte superiori e un'efficienza energetica più di 10 volte maggiore rispetto al TX2; e la generazione Orin con architettura Ampere (2022). Il modello ricorrente è che le architetture, inizialmente lanciate sul mercato delle GPU per il gaming, vengono riadattate per l'uso embedded qualche anno dopo: una struttura in cui l'esperienza tecnologica di NVIDIA nel settore delle GPU per data center e PC si traduce direttamente in miglioramenti prestazionali per i suoi prodotti di robotica embedded, e questo è il punto di forza di Jetson.
Un esempio concreto: un NVR domestico che gestisce più TPU Coral Edge
Un caso rappresentativo di un acceleratore ASIC dedicato utilizzato "in parallelo" è Frigate NVR, un pacchetto open source per la registrazione e il rilevamento di oggetti. Frigate analizza i flussi video delle telecamere di sorveglianza in tempo reale e delega il rilevamento di persone e veicoli alle TPU Coral Edge, con un'architettura che assegna un processo dedicato a ciascuna TPU e distribuisce le richieste di rilevamento provenienti da più telecamere attraverso una coda condivisa a tali processi.
Si stima che un singolo acceleratore USB Coral (4 TOPS) sia in grado di gestire autonomamente il rilevamento in tempo reale di circa due o quattro flussi a 1080p; una configurazione che combina due schede Coral Dual Edge TPU (M.2) da 8 TOPS ha gestito contemporaneamente oltre 20 telecamere, mantenendo un utilizzo del chip intorno al 12%. D'altro canto, è noto che l'utilizzo di più acceleratori USB in parallelo può causare un collo di bottiglia a causa della larghezza di banda del bus USB dell'host, pertanto le prestazioni non scalano linearmente con il numero di dispositivi. L'aggiunta di diversi ASIC dedicati a un singolo server NVR per aumentare il numero di telecamere è una soluzione di implementazione standard che sfrutta il basso costo e il ridotto consumo energetico per TOPS.
Come la domanda dei data center per l'IA ha fatto lievitare i prezzi delle schede SBC per hobbisti
Nel 2026, Raspberry Pi si è trovata a dover aumentare ripetutamente i prezzi per ragioni completamente al di fuori del suo controllo. La causa era una crisi del mercato delle memorie, dovuta all'impennata della domanda da parte dei data center per l'IA: lo stesso CEO della Raspberry Pi Foundation, Eben Upton, ha rivelato sul blog aziendale che il costo di approvvigionamento della DRAM LPDDR4 utilizzata nel Raspberry Pi 4/5 era aumentato di sette volte in un solo anno. Dopo un aumento di prezzo nel dicembre 2025, sono stati annunciati diversi altri aumenti nella prima metà del 2026, e un ulteriore aumento nell'aprile 2026 ha aggiunto 100 dollari al modello da 16 GB, portandolo a 305 dollari, oltre 2,5 volte il suo prezzo di lancio (ottobre 2024, quando il modello da 16 GB debuttò a 120 dollari). Ironicamente, in concomitanza con questo aumento dei prezzi, la Fondazione ha anche introdotto un nuovo modello da 1 GB nel 2026 al prezzo di soli 45 dollari: un caso in cui la domanda di memoria AI ad alte prestazioni ha raggiunto la struttura dei prezzi di un mercato completamente diverso, quello dei computer embedded per hobbisti.
Coral, abbandonato da Google, tenuto in vita dalla community
L'Edge TPU all'interno di Coral segue la stessa architettura di calcolo "systolic array" sviluppata da Google per le sue TPU per data center: si tratta in pratica di una versione miniaturizzata. Mentre la TPU v1 per data center gestisce l'addestramento e l'inferenza con un enorme array sistolico 256×256, l'Edge TPU riduce drasticamente le dimensioni di tale array e il consumo energetico a pochi watt, consentendone l'esecuzione all'interno di dispositivi embedded con budget energetici limitati. Google ha lanciato Coral nel 2019 con questa Edge TPU (4 TOPS, 2W) all'interno di una Dev Board e un acceleratore USB, e si è guadagnato un seguito come acceleratore aggiuntivo per schede SBC esistenti come Raspberry Pi, grazie all'inferenza a basso consumo energetico in grado di eseguire MobileNet v2 a circa 400 fotogrammi al secondo. Da allora, tuttavia, Google ha di fatto smesso di investire nella linea di prodotti senza rilasciare alcun nuovo hardware degno di nota, e la maggior parte delle librerie di supporto non è stata aggiornata dal 2022 circa. Il driver GASKET richiesto dai dispositivi Coral collegati tramite PCIe non è ancora supportato dai kernel Linux attuali. Ciò che ha impedito a Coral di cadere completamente in disuso è stato il fatto che Google ha reso open source i suoi driver e firmware; progetti come il già citato Frigate NVR si sono assunti l'onere del supporto e lo hanno mantenuto in produzione: un caso in cui la fine ufficiale del supporto e il continuo utilizzo nel mondo reale coesistono, illustrando la discrepanza tra i cicli di vita dei prodotti hardware e la durata del software open source. Il principio di quantizzazione INT8 dell'Edge TPU e il confronto della sua filosofia di progettazione con Intel Movidius (Myriad X) – un altro chip ora fuori produzione – sono trattati in modo più approfondito nell'articolo di confronto sugli acceleratori AI edge (/it/blog/posts/sensor-edge-ai.html).
L'integrazione di un acceleratore su una scheda SBC è superiore a Jetson? Un documento di benchmarking del 2026
Un documento dell'aprile 2026 sull'esecuzione dell'inferenza di modelli linguistici di grandi dimensioni (LLM) su SBC edge, intitolato "Cloud to Edge: Benchmarking LLM Inference on Hardware-Accelerated Single-Board Computers" (Renney, Trad, Mattarock, Evetts, Wood), ha confrontato il consumo energetico e il throughput su quattro configurazioni: un Raspberry Pi 5 senza NPU (solo CPU), un Raspberry Pi 5 con AI HAT+ (NPU Hailo-10H), un Jetson Orin Nano Super (configurazioni CPU e GPU separate) e un modulo LLM M5Stack (NPU AX630C). I risultati: l'aggiunta di una NPU Hailo al Raspberry Pi 5 ha migliorato l'efficienza dei token generati per watt da 9,57 a 39,97 volte rispetto alla configurazione con sola CPU, riducendo il consumo energetico per megatoken da 27-77 megajoule a 0,88-5,51 megajoule. In termini di throughput grezzo, la configurazione GPU del Jetson Orin Nano è risultata la più veloce con 9-10 token al secondo, ma la configurazione Raspberry Pi 5 + Hailo ha eguagliato il throughput della configurazione Jetson basata solo su CPU, consumando circa la metà dell'energia e occupando meno spazio: dati che confermano l'affermazione secondo cui una combinazione di "SoC generico e ASIC dedicato" può competere alla pari con un computer standalone con GPU integrata in termini di efficienza energetica.
Parametri che determinano le prestazioni
- TOPS/W (efficienza): Per i piccoli robot e droni alimentati a batteria, le prestazioni per watt sono spesso più importanti delle prestazioni assolute. L'Hailo-8 si distingue con 26 TOPS/2,5W (circa 10,4 TOPS/W), mentre il Jetson Orin Nano Super raggiunge solo circa 2,7 TOPS/W nella sua modalità MAXN Super (67 TOPS/25W). Si noti, tuttavia, che questo va a scapito della versatilità derivante dalla possibilità di eseguire modelli CUDA arbitrari, a differenza di un ASIC dedicato limitato a grafi fissi.
- Larghezza di banda della memoria: per l'inferenza di reti neurali che rilegge grandi matrici di pesi a ogni frame, la larghezza di banda della memoria diventa il fattore limitante più spesso della potenza di calcolo pura. La LPDDR5 del Jetson Orin Nano Super (102 GB/s) è circa 6 volte superiore alla LPDDR4X del Raspberry Pi 5 (~17,1 GB/s), e questo divario determina quanto del valore TOPS del catalogo può essere effettivamente estratto.
- Compatibilità con il software esistente: un Raspberry Pi 5 può eseguire una distribuzione Linux standard e ROS 2 così come sono, mentre gli acceleratori ASIC come Coral/Hailo possono eseguire solo grafi fissi pre-quantizzati e precompilati. La combinazione ottimale dipende dal fatto che ci si trovi in una fase di sviluppo, in cui i modelli cambiano frequentemente, o in una fase di produzione in cui vengono eseguite solo inferenze finalizzate.
- Rischio di fornitura e continuità della roadmap: un prodotto come Coral, in cui il fornitore ha di fatto smesso di investire, sopravvive grazie alla buona volontà della community, un rischio reale per la nuova adozione in un progetto di lunga data. Jetson, al contrario, mantiene linee di prodotto progettate per garantire la continuità della roadmap, come la certificazione ASIL-D ISO 26262 di livello automobilistico dell'AGX Orin.
- Fluttuazioni di prezzo provenienti dall'esterno del mercato: come dimostrano gli aumenti di prezzo del Raspberry Pi del 2026, i prezzi delle schede a singolo circuito (SBC) possono subire forti oscillazioni a causa di fattori completamente esterni a un determinato progetto, come la domanda di data center per l'IA. La pianificazione degli approvvigionamenti per implementazioni a lungo termine deve valutare la stabilità della fornitura oltre al prezzo unitario.
- Disponibilità di interfacce di espansione: la corsia PCIe 2.0 x1 del Raspberry Pi 5 è troppo stretta per far funzionare un acceleratore come l'AI HAT+ a pieno regime e, in alcuni casi, non è in grado di sfruttare appieno le prestazioni dichiarate dell'Hailo-8 (valutato per PCIe Gen3, 2 corsie): un limite pratico da considerare per qualsiasi configurazione di acceleratore aggiuntivo.
- Dimensioni dell'involucro e progettazione termica: un modulo ultracompatto come il modulo M5Stack LLM, con dimensioni di 54×54×13 mm, può risultare superiore in termini di densità di throughput per unità di volume, pur essendo inferiore in termini di prestazioni assolute, e questa è una proposta fondamentalmente diversa rispetto a un modulo dipendente dal dissipatore di calore come il Jetson AGX Orin, in termini di compatibilità con la struttura o lo chassis del dispositivo. Per droni o piccoli bracci robotici con limitazioni di spazio di montaggio e peso, le prestazioni per unità di volume diventano un criterio di selezione fondamentale, al pari di TOPS e TOPS/W.
Una CPU più veloce previene i colli di bottiglia nell'elaborazione delle immagini della fotocamera?
La larghezza di banda della memoria, l'I/O, l'alimentazione e il raffreddamento possono limitare la velocità di elaborazione.
Misurare il funzionamento continuo con le periferiche effettive. ## Riferimenti - [Pagina del prodotto Raspberry Pi 5](https://www.raspberrypi.com/products/raspberry-pi-5/) - [Scheda prodotto Raspberry Pi 5 in PDF](https://datasheets.raspberrypi.com/rpi5/raspberry-pi-5-product-brief.pdf) - [Raspberry Pi 5 da 1 GB ora disponibile a $45, e aumenti di prezzo dovuti alla memoria (Raspberry Pi)](https://www.raspberrypi.com/news/1gb-raspberry-pi-5-now-available-at-45-and-memory-driven-price-rises/) - [Ulteriori aumenti di prezzo dovuti alla memoria (Raspberry Pi)](https://www.raspberrypi.com/news/more-memory-driven-price-rises/) - [Il prezzo del Raspberry Pi 5 aumenta drasticamente a causa della carenza di IA (Tom's Hardware)](https://www.tomshardware.com/raspberry-pi/raspberry-pi-5-price-increases-drastically-as-ai-shortage-bites-16gb-version-now-usd205-second-price-increase-in-three-months-over-70-percent-more-expensive-than-original-msrp) - [Pagina del prodotto NVIDIA Jetson Orin](https://www.nvidia.com/en-us/autonomous-machines/embedded-systems/jetson-orin/) - [Kit di sviluppo Jetson Orin Nano Super] (NVIDIA)](https://www.nvidia.com/en-us/autonomous-machines/embedded-systems/jetson-orin/nano-super-developer-kit/) - [La nuova scheda di sviluppo AI di Nvidia da 249 dollari promette 67 TOPS (Tom's Hardware)](https://www.tomshardware.com/tech-industry/artificial-intelligence/nvidia-launches-new-usd249-ai-development-board-that-does-67-tops) - [NVIDIA JetPack 6.2 porta la Super Mode su Jetson Orin Nano e Orin NX (Blog per sviluppatori NVIDIA)](https://developer.nvidia.com/blog/nvidia-jetpack-6-2-brings-super-mode-to-nvidia-jetson-orin-nano-and-jetson-orin-nx-modules) - [Jetson TK1: il supercomputer mobile embedded porta CUDA ovunque (Blog tecnico NVIDIA)](https://developer.nvidia.com/blog/jetson-tk1-mobile-embedded-supercomputer-cuda-everywhere/) - [Scheda tecnica dell'acceleratore USB Coral (Coral)](https://www.coral.ai/static/files/Coral-USB-Accelerator-datasheet.pdf) - [Benchmark delle prestazioni di Edge TPU (Coral)](https://www.coral.ai/docs/edgetpu/benchmarks/) - [Probabilmente abbandonato per Coral TPU (Discussione su Frigate GitHub)](https://github.com/blakeblackshear/frigate/discussions/18564) - [Aumento della velocità di inferenza con 2 TPU rispetto a 1 TPU (Discussione Frigate su GitHub)](https://github.com/blakeblackshear/frigate/discussions/4125) - [Rilevatori di oggetti (Documentazione Frigate)](https://docs.frigate.video/configuration/object_detectors/) - [Pagina del prodotto Raspberry Pi AI HAT+ (Raspberry Pi)](https://www.raspberrypi.com/news/raspberry-pi-ai-hat/) - [Acceleratore AI Hailo-8 (Hailo)](https://hailo.ai/products/ai-accelerators/hailo-8-ai-accelerator/) - [Breve presentazione del prodotto Hailo-8 M.2 (PDF Hailo)](https://hailo.ai/wp-content/uploads/2023/12/hailo8_product_brief_3.23.pdf) - [BBC Micro e Raspberry Pi (Raspberry Pi)](https://www.raspberrypi.com/news/the-bbc-micro-and-raspberry-pi/) - [La vita di Pi: dieci anni di Raspberry Pi (Università di Cambridge)](https://www.cam.ac.uk/stories/raspberrypi) - [Cloud to Edge: benchmarking dell'inferenza LLM su computer a scheda singola con accelerazione hardware (arXiv:2604.24785)](https://arxiv.org/abs/2604.24785) - -
Commenti
Accedi per continuare.
Nessun dato disponibile.