Contents — find the section you need
Um SBC (Single Board Computer) é um computador compacto que integra CPU, memória, interfaces de armazenamento e várias E/S em uma única placa — em um robô móvel autônomo ou drone, ele é o "cérebro" por trás da autolocalização, planejamento de trajetória e processamento de sensores. Longe de ser um mero PC pequeno, a filosofia de design sobre como incorporar recursos de GPU ou NPU (Unidade de Processamento Neural) para inferência varia bastante de acordo com a linha de produtos, e três correntes correm em paralelo: o SoC Linux de propósito geral do Raspberry Pi, o computador de IA com GPU integrada NVIDIA Jetson e o acelerador ASIC dedicado do Google Coral.
 Raspberry Pi 5
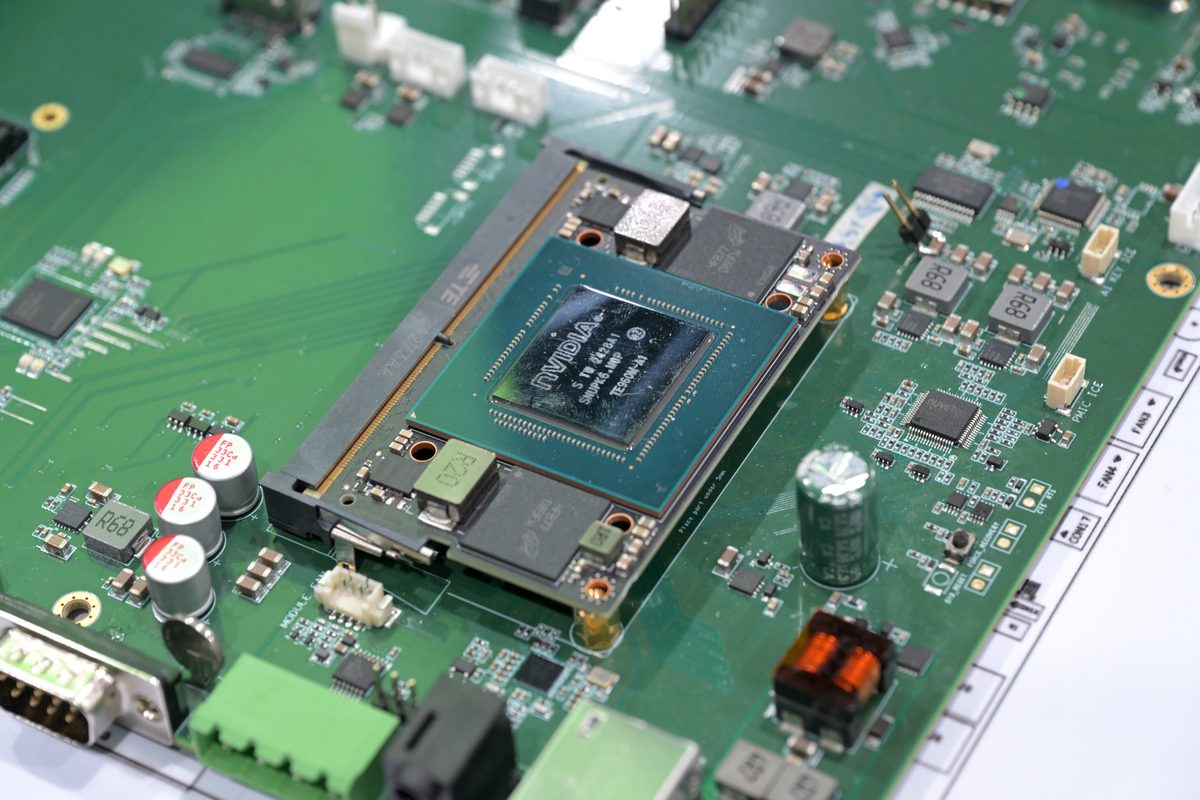 NVIDIA Jetson Orin NX (Computex 2025)
Imagens: Raspberry Placa Pi 5 (SimonWaldherr, CC BY-SA 4.0) / Nvidia Jetson Orin NX em uma placa-mãe Computex 2025 (4300streetcar, CC BY 4.0), Ambas as imagens são do Wikimedia Commons. Não se trata exatamente do Jetson Orin Nano Super comparado no texto, mas sim de um módulo Orin NX da mesma geração Orin e arquitetura Ampere. Não foi encontrada nenhuma foto nítida do Google Coral (placa de desenvolvimento/acelerador USB) no Wikimedia Commons, portanto, nenhuma foto do produto foi incluída neste artigo.


Princípio: a métrica TOPS e o "limite de memória"
Ao discutir o desempenho de um SBC (Small Board Computer), a velocidade do clock da CPU por si só não conta toda a história. O desempenho de uma GPU/NPU especializada em inferência de redes neurais é expresso como o número de operações inteiras quantizadas (geralmente INT8) executadas por segundo, em unidades de TOPS (Tera Operações por Segundo — um trilhão de operações por segundo). O desempenho TOPS pode ser estimado aproximadamente a partir do número de unidades de multiplicação-acumulação (MAC) paralelas N_{MAC} e da frequência do clock f:
Uma operação de multiplicação-acumulação conta como duas operações — uma multiplicação mais uma adição — daí o fator 2. O NVIDIA Jetson Orin Nano Super, por exemplo, utiliza 1024 núcleos CUDA e 32 núcleos Tensor a cerca de 1,7 GHz, atingindo 67 TOPS em seu modo "MAXN Super" com limite de potência elevado (25 W).
A maior parte desse valor de TOPS pressupõe aritmética de inteiros de 8 bits (INT8) em vez de ponto flutuante de 32 bits (FP32). A quantização dos pesos FP32 usados durante o treinamento para INT8 antes da inferência, teoricamente, reduz o tamanho do modelo e a largura de banda de memória necessária para um quarto, permitindo que as mesmas unidades de computação executem mais operações paralelas. É um projeto que prioriza a taxa de transferência máxima em detrimento da precisão de inferência, dentro de um orçamento limitado de energia e largura de banda de memória — e Jetson, Hailo e Coral citam valores de TOPS de catálogo que pressupõem essa quantização INT8.
Dito isso, o pico de TOPS de catálogo não se traduz automaticamente em desempenho efetivo. Por mais rápidas que sejam as unidades de computação, elas ficam ociosas se os dados de que precisam (pesos, características intermediárias) não puderem ser buscados na memória com rapidez suficiente. O modelo roofline captura isso: o desempenho efetivo P é limitado ao menor valor entre o pico de taxa de transferência de computação P_{peak} e a largura de banda de memória BW multiplicada pela intensidade aritmética (operações por byte) AI.
A memória LPDDR4X-4267 do Raspberry Pi 5, em um barramento de 32 bits, atinge uma largura de banda teórica máxima de cerca de 17,1 GB/s, em comparação com os 102 GB/s da LPDDR5 do Jetson Orin Nano Super — aproximadamente 6 vezes maior. Essa diferença raramente se reflete em cargas de trabalho que exigem muito da CPU, mas para inferência de redes neurais que relê grandes matrizes de pesos a cada quadro, essa diferença de largura de banda se torna o fator limitante que determina a quantidade de TOPS (pontos por segundo) do catálogo que você pode realmente extrair.
Três filosofias de design: SoC de propósito geral, GPU integrada e ASIC dedicado
Produtos chamados de "SBCs" (Single Board Computers - Computadores de Placa Única) são amplamente divididos em três categorias com base em como lidam com a inferência de IA.
SoC de propósito geral (Raspberry Pi) integra uma CPU, uma GPU e vários controladores de E/S, mas não inclui uma NPU (Unidade de Processamento Neural) dedicada para inferência de redes neurais. Executa uma distribuição Linux completa e seu maior ponto forte é a capacidade de usar praticamente toda a pilha de software existente — incluindo o ROS 2 — tal como está; o projeto pressupõe que, sempre que o desempenho de inferência for necessário, um acelerador externo (Hailo, discutido abaixo, por exemplo) supre a lacuna.
O computador de IA com GPU integrada (NVIDIA Jetson) integra uma GPU programável por CUDA e núcleos Tensor no mesmo pacote, juntamente com memória de alta largura de banda. Ao contrário de um ASIC dedicado que só pode processar grafos de computação fixos e pré-quantizados, ele mantém a versatilidade para executar kernels CUDA arbitrários e modelos PyTorch/TensorRT diretamente, oferecendo ao mesmo tempo muito mais poder computacional paralelo. Existem também linhas de produtos com confiabilidade de nível automotivo, como o AGX Orin, que possui certificação de segurança funcional ISO 26262 ASIL-D para direção autônoma e robótica.
Acelerador ASIC dedicado (Google Coral / Hailo) consiste em um ASIC de função fixa especializado exclusivamente em inferência de redes neurais quantizadas, adicionado a um SBC (Single Board Computer) host via USB ou M.2. Em troca de sacrificar a versatilidade, ele pode alcançar uma eficiência (TOPS por watt) que supera em muito as outras duas abordagens.
Essas três categorias não são mutuamente exclusivas, e projetos reais de robótica frequentemente as combinam. A combinação de um SoC de uso geral, como o Raspberry Pi 5, com um acelerador ASIC (AI HAT+) é um compromisso que visa obter tanto a abrangência da pilha de software Linux/ROS 2 quanto a eficiência energética de descarregar a inferência para um ASIC — e, como mostra o artigo de benchmark discutido abaixo, essa combinação pode se aproximar da eficiência de um computador independente com GPU integrada.
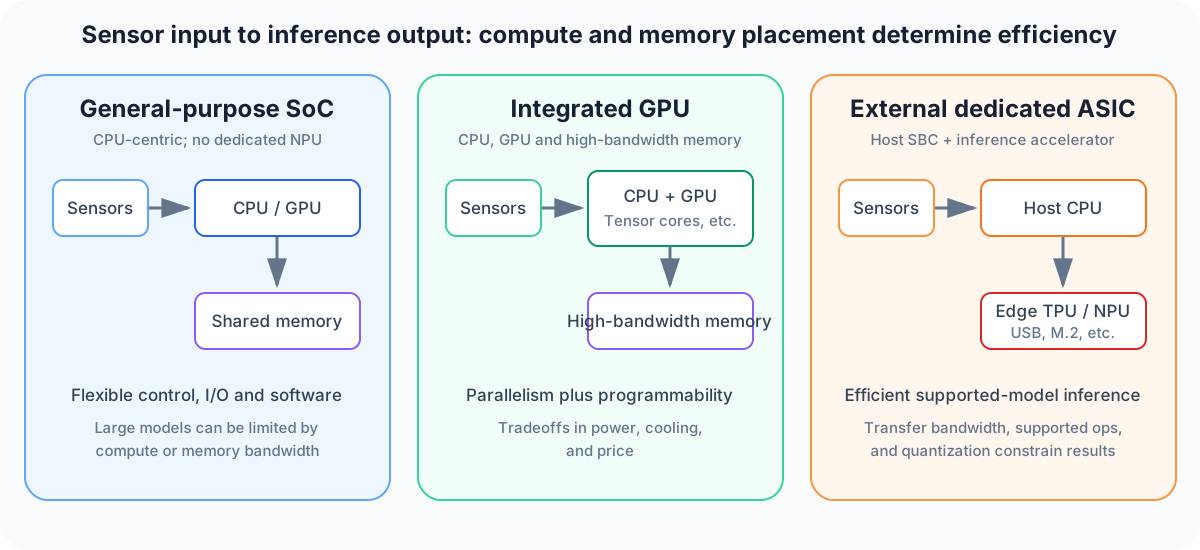
Diagrama: Duskcoil. Este é um layout conceitual, não uma classificação de velocidade do produto. O desempenho efetivo depende do modelo, da precisão, do software, da largura de banda da memória e da configuração de energia.
Comparação das principais especificações do produto
| Produto | Tipo | Núcleos de computação | Desempenho de IA | Memória | Energia | Preço |
|---|---|---|---|---|---|---|
| Raspberry Pi 5 (16 GB) | SoC de uso geral (sem NPU) | Cortex-A76 quad-core, 2,4 GHz | — (externo necessário) | LPDDR4X 16 GB (~17,1 GB/s) | Fonte de alimentação 5 V/5 A (25 W máx.) | US$ 305 (em abril de 2026) |
| Raspberry Pi AI HAT+ (Hailo-8) | ASIC dedicado (HAT adicional para RPi5) | NPU Hailo-8 | 26 TOPS (INT8) | — | ~2,5 W | US$ 110 |
| Acelerador USB Google Coral | ASIC dedicado (USB) | Edge TPU | 4 TOPS (INT8) | — | 2 W | ~US$ 75–99 |
| NVIDIA Jetson Orin Nano Super | Computador de IA com GPU integrada | Cortex-A78AE de 6 núcleos, 1,7 GHz + GPU Ampere, 1024 núcleos/32 núcleos Tensor | 67 TOPS (INT8, modo MAXN Super) | LPDDR5 8 GB (102 GB/s) | 7–25 W (variável) | US$ 249 |
| NVIDIA Jetson AGX Orin (64 GB) | Computador de IA com GPU integrada (carro-chefe) | Cortex-A78AE de 12 núcleos + GPU Ampere, 2048 núcleos/64 núcleos Tensor | 275 TOPS (INT8) | LPDDR5 64 GB, 256 bits | 15–60 W (variável) | — |
O Raspberry Pi 5 é o modelo usado pelo projeto newbot como seu computador de controle principal, responsável pelo processamento na borda, como autolocalização, supervisão de segurança e aquisição de dados por sensores. Como o algoritmo de Odometria Inercial por LiDAR (FAST-LIO) do newbot é executado inteiramente na CPU, e o sistema não precisa executar inferência de redes neurais em larga escala constantemente, um SoC de uso geral sem NPU dedicada é suficiente para atender aos seus requisitos. Por outro lado, um robô projetado para detecção ou segmentação de objetos em tempo real a partir de imagens de câmeras geralmente requer uma GPU integrada como a Jetson, ou um acelerador externo do tipo Hailo/Coral. O Jetson Orin Nano Super também tem uma história peculiar: uma atualização de software de dezembro de 2024, chamada "Super Mode", elevou o limite de potência, passando dos 40 TOPS da geração anterior (US499) para 67 TOPS (US 249) — mais desempenho pela metade do preço.
História: nostalgia pelo BBC Micro e a mudança de rumo de um fabricante de GPUs para jogos
Raspberry Pi: impulsionado por uma queda nas admissões em Cambridge — O fundador da Raspberry Pi Foundation, Eben Upton, teve seu primeiro contato com um BBC Micro usado (um computador doméstico que a BBC utilizava para fins educacionais na década de 1980) aos 10 anos de idade, em 1988, e essa foi sua primeira experiência com programação em BASIC. Mais tarde, enquanto atuava como Diretor de Estudos de Ciência da Computação na Universidade de Cambridge, por volta de 2006, ele notou um aumento no número de candidatos com pouca experiência em programação, juntamente com um declínio nas inscrições para o próprio curso de Ciência da Computação. Considerando o desaparecimento dos computadores "ligar e começar a programar", como o BBC Micro, das casas, como uma das causas, Upton dedicou suas noites e fins de semana, de 2006 a 2011, ao desenvolvimento de um SBC (Single Board Computer) de baixo custo, paralelamente ao seu trabalho na Broadcom. A Fundação Raspberry Pi foi formalmente estabelecida em 2009, com o objetivo de criar um "computador programável por menos de US$ 35". Em 2011, membros da Fundação levaram um protótipo à BBC, na esperança de manter o nome "BBC Micro", o que foi impedido por circunstâncias legais — mas um jornalista da BBC publicou um vídeo de demonstração do protótipo que viralizou, comprovando a forte demanda muito antes do lançamento oficial.
Jetson: fabricante de GPUs para jogos entra no mercado de robótica em 2014 — Em março de 2014, o CEO da NVIDIA, Jensen Huang, apresentou pessoalmente o Jetson TK1 em um discurso na GTC (GPU Technology Conference). Ele combinava o chip Tegra K1, voltado para dispositivos móveis, com uma GPU de arquitetura Kepler de 192 núcleos, oferecendo 326 GFLOPS — um número impressionante para um dispositivo embarcado na época — e trouxe consigo o modelo de programação CUDA. Desde o início, casos de uso como navegação robótica e desvio de obstáculos para drones faziam parte da proposta, marcando a entrada real da NVIDIA no mercado de robótica embarcada, vinda de um setor que, até então, atuava principalmente em GPUs para jogos e data centers.
A linha Jetson continuou a atualizar sua arquitetura de GPU aproximadamente a cada duas gerações: o TX2 de 2017, com uma GPU Pascal de 256 núcleos, oferecia o dobro do desempenho do TK1; A geração Xavier, com arquitetura Volta (2018–2020), promete desempenho mais de 20 vezes superior e eficiência energética mais de 10 vezes superior à TX2; e a geração Orin, com arquitetura Ampere (2022). O padrão consistente é o de arquiteturas que estrearam primeiro no mercado de GPUs para jogos sendo reaproveitadas para uso embarcado alguns anos depois — uma estrutura na qual o acúmulo técnico dos negócios de GPUs para data centers e PCs da NVIDIA alimenta diretamente os ganhos de desempenho de seus produtos de robótica embarcada, e essa é a principal força do Jetson.
Uma implementação real: um NVR doméstico controlando várias TPUs Coral Edge
Um caso representativo de um acelerador ASIC dedicado sendo executado "várias vezes simultaneamente" é o Frigate NVR, um pacote de código aberto para gravação e detecção de objetos. O Frigate analisa feeds de câmeras de vigilância em tempo real e delega a detecção de pessoas/veículos para TPUs Coral Edge, com uma arquitetura que atribui um processo dedicado por TPU e distribui solicitações de detecção de várias câmeras por meio de uma fila compartilhada para esses processos. Um único acelerador USB Coral (4 TOPS) é capaz de lidar com a detecção em tempo real de cerca de duas a quatro transmissões de 1080p; uma configuração com duas placas Coral Dual Edge TPU (M.2) de 8 TOPS teria conseguido lidar com mais de 20 câmeras simultaneamente, com uma utilização do chip em torno de 12%. Por outro lado, sabe-se que o empilhamento de múltiplos aceleradores USB pode sobrecarregar a largura de banda do barramento USB do host, fazendo com que o desempenho não cresça linearmente com o número de dispositivos. Adicionar vários ASICs dedicados a um único servidor NVR para aumentar o número de câmeras é um padrão de implementação clássico que aproveita o baixo custo e o baixo consumo de energia por TOPS.
Como a demanda por data centers com IA impulsionou os preços dos SBCs para entusiastas
Em 2026, a Raspberry Pi se viu obrigada a aumentar seus preços repetidamente por razões totalmente alheias à sua vontade. A causa foi uma crise no mercado de memória, impulsionada pela crescente demanda de data centers de IA — o próprio CEO da Fundação Raspberry Pi, Eben Upton, revelou no blog da empresa que o custo de aquisição da memória DRAM LPDDR4 usada no Raspberry Pi 4/5 aumentou sete vezes em um único ano. Após um aumento de preço em dezembro de 2025, vários outros aumentos foram anunciados no primeiro semestre de 2026, e um aumento em abril de 2026 adicionou US100 ao modelo de 16 GB, elevando-o para US 305 — mais de 2,5 vezes o preço de lançamento (outubro de 2024, quando o modelo de 16 GB estreou por US120). Ironicamente, acompanhando esse aumento de preço, a Fundação também lançou um novo modelo de 1 GB em 2026 com preço de apenas US 45 — um caso em que a demanda por memória de IA de alto desempenho atingiu a estrutura de preços de um mercado completamente diferente: o de computadores embarcados para entusiastas.
Coral, abandonado pelo Google, mantido vivo pela comunidade
O Edge TPU dentro do Coral segue a mesma arquitetura de computação de "matriz sistólica" que o Google desenvolveu para seus TPUs de data center — é efetivamente uma versão miniaturizada. Enquanto o TPU v1 de escala de data center lida com treinamento e inferência com uma enorme matriz sistólica de 256×256, o Edge TPU reduz drasticamente essa matriz e diminui o consumo de energia para um dígito de watts, permitindo que ele seja executado em dispositivos embarcados com orçamentos de energia limitados. O Google lançou o Coral em 2019 com este Edge TPU (4 TOPS, 2W) dentro de uma placa de desenvolvimento e um acelerador USB, e ele conquistou seguidores como um acelerador complementar para placas de desenvolvimento existentes, como o Raspberry Pi, graças à inferência com baixo consumo de energia que podia executar o MobileNet v2 a aproximadamente 400 quadros por segundo. Desde então, porém, o Google praticamente parou de investir na linha de produtos sem lançar nenhum hardware novo e relevante, e a maioria das bibliotecas de suporte não é atualizada desde 2022. O driver GASKET, necessário para dispositivos Coral conectados via PCIe, continua sem suporte nos kernels Linux atuais. O que impediu o Coral de cair completamente em desuso foi o fato de o Google ter disponibilizado seus drivers e firmware como código aberto; projetos como o já mencionado Frigate NVR assumiram a responsabilidade pelo suporte e o mantiveram em produção — um caso em que o fim oficial do suporte e o uso contínuo no mundo real coexistem, ilustrando a discrepância entre os ciclos de vida dos produtos de hardware e a vida útil do software de código aberto. O princípio de quantização INT8 do Edge TPU e como sua filosofia de design se compara à do Intel Movidius (Myriad X) — outro chip que já foi descontinuado — são abordados com mais detalhes no artigo de comparação de aceleradores de IA de borda.
Será que acoplar um acelerador a um SBC supera o Jetson? Um artigo de benchmark de 2026
Um artigo de abril de 2026 sobre a execução de inferência de modelos de linguagem (LLM) em SBCs de borda, "Cloud to Edge: Benchmarking LLM Inference on Hardware-Accelerated Single-Board Computers" (Renney, Trad, Mattarock, Evetts, Wood), comparou o consumo de energia e a taxa de transferência em quatro configurações: um Raspberry Pi 5 sem processador (apenas CPU), um Raspberry Pi 5 com um AI HAT+ (NPU Hailo-10H), um Jetson Orin Nano Super (configurações de CPU e GPU separadamente) e um módulo LLM M5Stack (NPU AX630C). Resultados: a adição de uma NPU Hailo ao Raspberry Pi 5 melhorou a eficiência de geração de tokens por watt em 9,57x a 39,97x em comparação com a configuração somente com CPU, reduzindo o consumo de energia por megatoken de 27–77 megajoules para 0,88–5,51 megajoules. Em termos de taxa de transferência bruta, a configuração com GPU do Jetson Orin Nano foi a mais rápida, com 9–10 tokens por segundo, mas a configuração Raspberry Pi 5 + Hailo igualou a taxa de transferência da configuração somente com CPU do Jetson com aproximadamente metade do consumo de energia e em um formato menor — dados que comprovam a afirmação de que uma combinação de "SoC de uso geral mais ASIC dedicado" pode competir de igual para igual com um computador independente com GPU integrada em termos de eficiência energética.
Parâmetros que determinam o desempenho
- TOPS/W (eficiência): Para pequenos robôs e drones alimentados por bateria, o desempenho por watt geralmente importa mais do que o desempenho absoluto. O Hailo-8 se destaca com 26 TOPS/2,5W (cerca de 10,4 TOPS/W), enquanto o Jetson Orin Nano Super atinge apenas cerca de 2,7 TOPS/W em seu modo MAXN Super (67 TOPS/25W). Observe, no entanto, que isso representa uma contrapartida em relação à versatilidade de poder executar modelos CUDA arbitrários, ao contrário de um ASIC dedicado limitado a grafos fixos.
- Largura de banda da memória: Para inferência de redes neurais que relê grandes matrizes de pesos a cada quadro, a largura de banda da memória se torna o fator limitante da taxa com mais frequência do que a capacidade computacional bruta. A memória LPDDR5 (102 GB/s) do Jetson Orin Nano Super é aproximadamente 6 vezes mais rápida que a LPDDR4X (~17,1 GB/s) do Raspberry Pi 5, e essa diferença determina quanto do valor TOPS do catálogo pode ser efetivamente extraído.
- Compatibilidade com software existente: Um Raspberry Pi 5 pode executar uma distribuição Linux padrão e o ROS 2 sem problemas, enquanto aceleradores ASIC como Coral/Hailo só podem executar grafos fixos pré-quantizados e pré-compilados. A combinação ideal depende se você está em uma fase de desenvolvimento, onde os modelos mudam frequentemente, ou em uma fase de produção, executando apenas inferências finalizadas.
- Risco de fornecimento e continuidade do roadmap: Um produto como o Coral, cujo fornecedor efetivamente parou de investir, sobrevive graças à boa vontade da comunidade — um risco real para a adoção em um projeto de longa duração. A Jetson, por outro lado, mantém linhas de produtos construídas para continuidade do roadmap, como a certificação ASIL-D ISO 26262 de nível automotivo da AGX Orin.
- Variações de preço externas ao mercado: Como mostram os aumentos de preço do Raspberry Pi em 2026, os preços dos SBCs podem variar drasticamente devido a fatores totalmente externos a um determinado projeto — como a demanda por data centers de IA. O planejamento de aquisições para implantações de longa duração precisa ponderar a estabilidade do fornecimento juntamente com o preço unitário.
- Disponibilidade de interfaces de expansão: A via PCIe 2.0 x1 do Raspberry Pi 5 é muito estreita para executar um acelerador como o AI HAT+ em sua especificação completa e, em alguns casos, não consegue extrair totalmente o desempenho de catálogo do Hailo-8 (classificado para PCIe Gen3, 2 vias) — uma limitação prática que vale a pena considerar para qualquer configuração de acelerador acoplável.
- Tamanho do gabinete e design térmico: Um módulo ultracompacto como o M5Stack LLM Module, com 54×54×13mm, pode apresentar melhor densidade de transferência por unidade de volume, mesmo ficando atrás em desempenho absoluto, e essa é uma proposta fundamentalmente diferente de um módulo dependente de dissipador de calor como o Jetson AGX Orin em termos de qual estrutura ou chassi ele se encaixa. Para drones ou pequenos braços robóticos com restrições de espaço de montagem e peso, o desempenho por unidade de volume torna-se um critério de seleção tão importante quanto TOPS e TOPS/W.
Um processador mais rápido evita gargalos no processamento da câmera?
Largura de banda da memória, E/S, energia e refrigeração podem limitar a taxa de transferência. Meça a operação contínua com os periféricos reais.
Referências
- Página do produto Raspberry Pi 5
- PDF de resumo do produto Raspberry Pi 5
- Raspberry Pi 5 de 1 GB agora disponível por US$ 45 e aumentos de preço impulsionados pela memória (Raspberry Pi)
- Mais aumentos de preço impulsionados pela memória (Raspberry Pi)
- Preço do Raspberry Pi 5 aumenta drasticamente com a escassez de IA (Tom's Hardware)
- Página do produto NVIDIA Jetson Orin
- Kit de desenvolvimento Jetson Orin Nano Super (NVIDIA)
- Nova placa de desenvolvimento de IA da Nvidia, de US$ 249, promete 67 TOPS (Tom's Hardware)
- NVIDIA JetPack 6.2 traz o Super Modo para Jetson Orin Nano e Orin NX (Blog de Desenvolvedores da NVIDIA)
- Jetson TK1: Supercomputador móvel embarcado leva CUDA para todos os lugares (Blog Técnico da NVIDIA)
- Ficha técnica do acelerador USB Coral (Coral)
- Benchmarks de desempenho do Edge TPU (Coral)
- Coral TPU provavelmente abandonado (Discussão no GitHub da Frigate)
- Aumento na velocidade de inferência com 2 TPUs vs 1 TPU (Discussão no GitHub do Frigate)
- Detectores de Objetos (Documentação do Frigate)
- Página do produto Raspberry Pi AI HAT+ (Raspberry Pi)
- Acelerador de IA Hailo-8 (Hailo)
- Resumo do produto Hailo-8 M.2 (PDF da Hailo)
- O BBC Micro e o Raspberry Pi (Raspberry Pi)
- A vida do Pi: Dez anos de Raspberry Pi (Universidade de Cambridge)
- Da Nuvem à Borda: Avaliação comparativa da inferência LLM em computadores de placa única acelerados por hardware (arXiv:2604.24785)
Comentários
Entre na sua conta para continuar.
Ainda não há dados.