Contents — find the section you need
Un SBC (Single Board Computer) es un ordenador compacto que integra una CPU, memoria, interfaces de almacenamiento y diversas entradas/salidas en una sola placa. En un robot móvil autónomo o un dron, es el "cerebro" que controla la autolocalización, la planificación de rutas y el procesamiento de sensores. Lejos de ser un simple PC pequeño, la filosofía de diseño para integrar la capacidad de GPU o NPU (Unidad de Procesamiento Neuronal) para la inferencia varía notablemente según la línea de productos, y existen tres enfoques principales: el SoC Linux de propósito general de Raspberry Pi, el ordenador de IA con GPU integrada de NVIDIA Jetson y el acelerador ASIC dedicado de Google Coral.
 Raspberry Pi 5
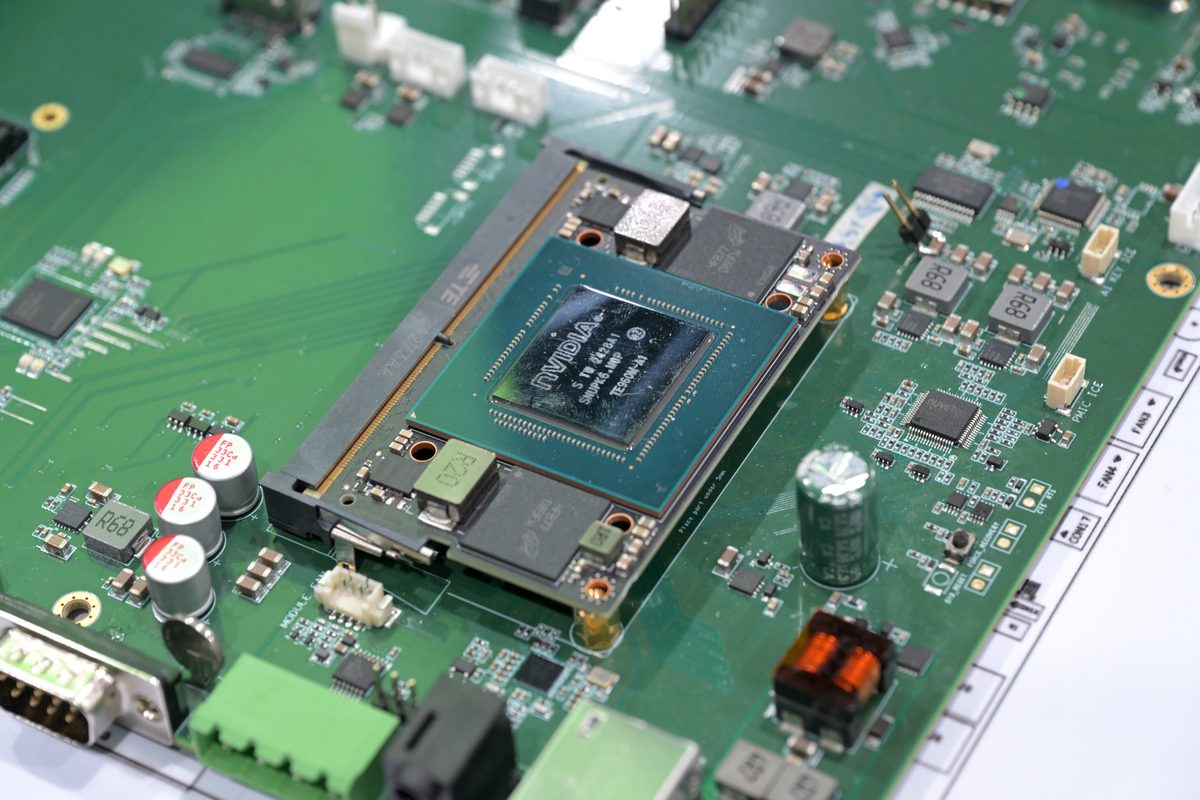 NVIDIA Jetson Orin NX (Computex 2025)
Imágenes: Raspberry Placa Pi 5 (SimonWaldherr, CC BY-SA 4.0) / Nvidia Jetson Orin NX en una placa base Computex 2025 (4300streetcar, CC BY 4.0), ambas de Wikimedia Wikimedia Commons. No se trata del Jetson Orin Nano Super exacto comparado en el texto, sino de un módulo Orin NX de la misma generación Orin y arquitectura Ampere. No se encontró ninguna foto nítida del Google Coral (placa de desarrollo/acelerador USB) en Wikimedia Commons, por lo que no se incluye ninguna foto del producto en este artículo.


Principio: la métrica TOPS y el "límite de memoria"
Al hablar del rendimiento de las placas de desarrollo, la velocidad de reloj de la CPU por sí sola ya no es suficiente. El rendimiento de una GPU/NPU especializada en inferencia de redes neuronales se expresa como el número de operaciones enteras cuantificadas (normalmente INT8) ejecutadas por segundo, en unidades de TOPS (Tera Operaciones por Segundo: un billón de operaciones por segundo). El rendimiento TOPS se puede estimar aproximadamente a partir del número de unidades de multiplicación-acumulación (MAC) paralelas (N_{MAC}) y la frecuencia de reloj (f):
Una multiplicación-acumulación cuenta como dos operaciones (una multiplicación más una suma), de ahí el factor de 2. Por ejemplo, la Jetson Orin Nano Super de NVIDIA utiliza 1024 núcleos CUDA y 32 núcleos Tensor a aproximadamente 1,7 GHz, alcanzando 67 TOPS en su modo "MAXN Super" (25 W), que aumenta el límite de potencia.
La mayor parte de esta cifra de TOPS se basa en aritmética de enteros de 8 bits (INT8) en lugar de punto flotante de 32 bits (FP32). Cuantizar los pesos FP32 utilizados durante el entrenamiento a INT8 antes de la inferencia reduce teóricamente el tamaño del modelo y el ancho de banda de memoria requerido a una cuarta parte, lo que permite que las mismas unidades de cómputo realicen más operaciones paralelas. Se trata de un diseño que prioriza el máximo rendimiento sobre la precisión de la inferencia, dentro de un presupuesto limitado de potencia y ancho de banda de memoria. Jetson, Hailo y Coral citan cifras TOPS de catálogo que asumen esta cuantización INT8.
Dicho esto, el TOPS máximo del catálogo no se traduce automáticamente en un rendimiento efectivo. Por muy rápidas que sean las unidades de cómputo, permanecen inactivas si los datos que necesitan (pesos, características intermedias) no se pueden obtener de la memoria con la suficiente rapidez. El modelo de límite superior refleja esto: el rendimiento efectivo P está limitado al menor de los siguientes valores: el rendimiento máximo de cómputo P_{peak} y el ancho de banda de memoria BW multiplicado por la intensidad aritmética (operaciones por byte) AI.
La memoria LPDDR4X-4267 de la Raspberry Pi 5, con un bus de 32 bits, alcanza un ancho de banda teórico máximo de aproximadamente 17,1 GB/s, frente a los 102 GB/s de la LPDDR5 de la Jetson Orin Nano Super, lo que supone una diferencia de aproximadamente 6 veces. Esta diferencia rara vez se percibe en cargas de trabajo que dependen en gran medida de la CPU, pero para la inferencia de redes neuronales, que relee grandes matrices de pesos en cada fotograma, esta brecha de ancho de banda se convierte en el factor limitante que determina la cantidad de la cifra TOPS del catálogo que realmente se puede extraer.
Tres filosofías de diseño: SoC de propósito general, GPU integrada, ASIC dedicado
Los productos denominados "SBC" se dividen en tres categorías principales según cómo gestionan la inferencia de IA.
El SoC de propósito general (Raspberry Pi) integra una CPU, una GPU y varios controladores de E/S, pero no incluye una NPU dedicada para la inferencia de redes neuronales. Ejecuta una distribución completa de Linux, y su mayor ventaja reside en la capacidad de utilizar prácticamente todo el software existente —incluido ROS 2— tal cual. El diseño parte de la base de que, cuando se requiere un mayor rendimiento de inferencia, un acelerador externo (como Hailo, que se describe más adelante) cubre la necesidad.
El ordenador de IA con GPU integrada (NVIDIA Jetson) integra una GPU programable con CUDA y núcleos Tensor en el mismo paquete que la memoria de alto ancho de banda. A diferencia de un ASIC dedicado, que solo puede procesar grafos de computación precuantizados y fijos, conserva la versatilidad para ejecutar directamente kernels CUDA arbitrarios y modelos PyTorch/TensorRT, a la vez que ofrece una capacidad de computación paralela mucho mayor. También existen líneas de productos con fiabilidad de nivel automotriz, como el AGX Orin, que cuenta con la certificación de seguridad funcional ISO 26262 ASIL-D para conducción autónoma y robótica.
El acelerador ASIC dedicado (Google Coral / Hailo) consiste en un ASIC de función fija especializado exclusivamente en la inferencia de redes neuronales cuantizadas, que se añade a una placa SBC host mediante USB o M.2. A cambio de sacrificar versatilidad, puede alcanzar una eficiencia (TOPS por vatio) muy superior a la de los otros dos enfoques.
Estas tres categorías no son mutuamente excluyentes, y los proyectos de robótica reales suelen combinarlas. Combinar un SoC de propósito general como la Raspberry Pi 5 con un acelerador ASIC (AI HAT+) es una solución intermedia que busca aprovechar tanto la amplitud del conjunto de software Linux/ROS 2 como la eficiencia energética de delegar la inferencia a un ASIC. Como muestra el artículo de evaluación comparativa que se analiza a continuación, esta combinación puede alcanzar una eficiencia similar a la de un ordenador con GPU integrada.
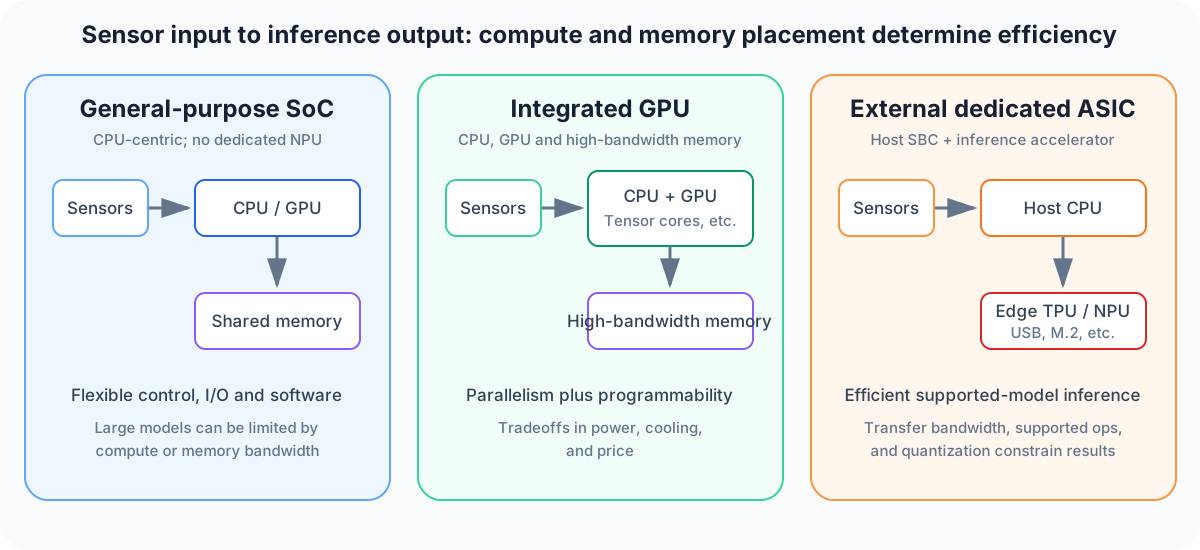
Diagrama: Duskcoil. Este es un esquema conceptual, no una clasificación de velocidad del producto. El rendimiento efectivo depende del modelo, la precisión, el software, el ancho de banda de la memoria y la configuración de energía.
Comparación de especificaciones clave del producto
| Producto | Tipo | Núcleos de procesamiento | Rendimiento de IA | Memoria | Energía | Precio |
|---|---|---|---|---|---|---|
| Raspberry Pi 5 (16 GB) | SoC de propósito general (sin NPU) | Cortex-A76 de 4 núcleos, 2,4 GHz | — (se necesita externa) | LPDDR4X de 16 GB (~17,1 GB/s) | Fuente de alimentación de 5 V/5 A (25 W máx.) | $305 (a partir de abril de 2026) |
| Raspberry Pi AI HAT+ (Hailo-8) | ASIC dedicado (HAT adicional para RPi5) | NPU Hailo-8 | 26 TOPS (INT8) | — | ~2,5 W | $110 |
| Acelerador USB Google Coral | ASIC dedicado (USB) | Edge TPU | 4 TOPS (INT8) | — | 2 W | ~$75–99 |
| NVIDIA Jetson Orin Nano Super | Computadora de IA con GPU integrada | Cortex-A78AE de 6 núcleos, 1,7 GHz + GPU Ampere, 1024 núcleos/32 núcleos Tensor | 67 TOPS (INT8, modo MAXN Super) | LPDDR5 de 8 GB (102 GB/s) | 7–25 W (variable) | $249 |
| NVIDIA Jetson AGX Orin (64 GB) | Computadora de IA con GPU integrada (modelo insignia) | Cortex-A78AE de 12 núcleos + GPU Ampere, 2048 núcleos/64 núcleos Tensor | 275 TOPS (INT8) | LPDDR5 de 64 GB, 256 bits | 15–60 W (variable) | — |
La Raspberry Pi 5 es el modelo que el proyecto newbot utiliza como su computadora de control principal, gestionando el procesamiento en el borde, como la autolocalización, la supervisión de seguridad y la adquisición de datos de sensores. Dado que la odometría inercial LiDAR de newbot (FAST-LIO) es un algoritmo que se ejecuta completamente en la CPU, y el sistema no necesita ejecutar constantemente inferencias de redes neuronales a gran escala, un SoC de propósito general sin NPU dedicada es suficiente para cumplir con sus requisitos. Por el contrario, un robot diseñado para la detección o segmentación de objetos en tiempo real a partir de imágenes de cámara requeriría una GPU integrada como la de Jetson, o un acelerador externo de la clase Hailo/Coral. El Jetson Orin Nano Super también tiene una historia peculiar: una actualización de software de diciembre de 2024, denominada "Super Mode", aumentó su potencia máxima, pasando de los 40 TOPS de la generación anterior (a 499 ) a 67 TOPS (a 249), lo que se traduce en un mayor rendimiento a la mitad de precio.
Historia: nostalgia por el BBC Micro y el giro estratégico de un fabricante de GPU para juegos
Raspberry Pi: impulsada por una caída en las admisiones a Cambridge — Eben Upton, fundador de la Fundación Raspberry Pi, consiguió un BBC Micro de segunda mano (un ordenador doméstico que la BBC utilizó con fines educativos en la década de 1980) a los 10 años, en 1988, y fue su primer contacto con la programación en BASIC. Más tarde, mientras ejercía como Director de Estudios de Informática en la Universidad de Cambridge alrededor de 2006, notó un aumento repentino de solicitantes con poca experiencia en programación, junto con una disminución en las solicitudes para el propio programa de Informática. Al ver la desaparición de los hogares de ordenadores "listos para encender y programar" como el BBC Micro como una de las causas, Upton dedicó tardes y fines de semana desde 2006 hasta 2011 al desarrollo de un SBC de bajo coste, compaginándolo con su trabajo en Broadcom. La Fundación Raspberry Pi se estableció formalmente en 2009, con el objetivo de crear un "ordenador programable por menos de 35 dólares". En 2011, miembros de la Fundación llevaron un prototipo a la BBC con la esperanza de mantener el nombre "BBC Micro", lo cual fue descartado por circunstancias legales. Sin embargo, un periodista de la BBC publicó un vídeo de demostración del prototipo que se viralizó, demostrando que existía una gran demanda mucho antes del lanzamiento oficial.
Jetson: un fabricante de GPU para juegos entra en la robótica en 2014 — En marzo de 2014, el CEO de NVIDIA, Jensen Huang, presentó personalmente la Jetson TK1 en una conferencia magistral en la GTC (GPU Technology Conference). Esta combinaba el chip Tegra K1, orientado a dispositivos móviles, con una GPU de arquitectura Kepler de 192 núcleos, que ofrecía 326 GFLOPS —una cifra extraordinaria para un dispositivo integrado en aquel momento— e incorporaba el modelo de programación CUDA. Desde el principio, se presentaron casos de uso como la navegación de robots y la evitación de obstáculos en drones, marcando la entrada de NVIDIA en el mercado de la robótica integrada, un sector que hasta entonces se había centrado principalmente en las GPU para juegos y centros de datos.
La línea Jetson renovó su arquitectura de GPU aproximadamente cada dos generaciones: la TX2 de 2017, con una GPU Pascal de 256 núcleos, ofrecía el doble de rendimiento que la TK1; La generación Xavier con arquitectura Volta (2018-2020) prometía un rendimiento más de 20 veces superior y una eficiencia energética más de 10 veces mayor que la TX2; y la generación Orin con arquitectura Ampere (2022). La tendencia constante es que las arquitecturas lanzadas inicialmente en el mercado de GPU para juegos se adaptan para su uso en sistemas embebidos pocos años después. Esta estructura permite que la experiencia técnica de NVIDIA en el negocio de GPU para centros de datos y PC se traduzca directamente en mejoras de rendimiento para sus productos de robótica embebida, y esta es la principal fortaleza de Jetson.
Un ejemplo real: un NVR doméstico controlando múltiples TPU de Coral Edge
Un caso representativo de un acelerador ASIC dedicado que se ejecuta simultáneamente es Frigate NVR, un paquete de código abierto para grabación y detección de objetos. Frigate analiza las transmisiones de las cámaras de vigilancia en tiempo real y delega la detección de personas y vehículos a las TPU de Coral Edge, con una arquitectura que asigna un proceso dedicado a cada TPU y distribuye las solicitudes de detección de múltiples cámaras a través de una cola compartida entre dichos procesos.
Se estima que un único acelerador USB Coral (4 TOPS) puede gestionar la detección en tiempo real de entre dos y cuatro transmisiones 1080p por sí solo; una configuración con dos tarjetas Coral Dual Edge TPU (M.2) de 8 TOPS ha gestionado más de 20 cámaras simultáneamente, manteniendo la utilización del chip en torno al 12 %. Por otro lado, también se sabe que apilar varios aceleradores USB puede generar un cuello de botella en el ancho de banda del bus USB del host, por lo que el rendimiento no aumenta linealmente con el número de dispositivos. Añadir varios ASIC dedicados a un único servidor NVR para aumentar el número de cámaras es un patrón de implementación estándar que aprovecha el bajo coste y el bajo consumo energético por TOPS.
Cómo la demanda de los centros de datos de IA disparó los precios de las placas SBC para aficionados
En 2026, Raspberry Pi se vio obligada a subir los precios repetidamente por razones totalmente ajenas a su control. La causa fue una escasez en el mercado de memorias, impulsada por la creciente demanda de los centros de datos de IA. El propio Eben Upton, CEO de la Fundación Raspberry Pi, reveló en el blog de la compañía que el coste de adquisición de la memoria DRAM LPDDR4 utilizada en la Raspberry Pi 4/5 se había multiplicado por siete en un solo año. Tras una subida de precio en diciembre de 2025, se anunciaron varios aumentos más en la primera mitad de 2026, y una subida en abril de 2026 añadió 100 dólares al modelo de 16 GB, elevándolo a 305 dólares, más de 2,5 veces su precio de lanzamiento (octubre de 2024, cuando el modelo de 16 GB debutó a 120 dólares). Irónicamente, en consonancia con este aumento de precios, la Fundación también presentó un nuevo modelo de 1 GB en 2026 a tan solo 45 dólares, un caso en el que la demanda de memoria de IA de alto rendimiento se extendió hasta la estructura de precios de un mercado completamente ajeno: el de los ordenadores integrados para aficionados.
Coral, abandonada por Google, mantenida viva por la comunidad
La Edge TPU de Coral sigue la misma arquitectura de computación de "matriz sistólica" que Google desarrolló para sus TPU de centros de datos; es, en esencia, una versión miniaturizada. Mientras que la TPU v1, a escala de centro de datos, gestiona el entrenamiento y la inferencia con una enorme matriz sistólica de 256 × 256, la Edge TPU reduce drásticamente esa matriz y minimiza el consumo energético a unos pocos vatios, lo que le permite funcionar en dispositivos integrados con presupuestos energéticos ajustados. Google lanzó Coral en 2019 con este Edge TPU (4 TOPS, 2 W) integrado en una placa de desarrollo y un acelerador USB, y se ganó popularidad como acelerador adicional para SBC existentes como Raspberry Pi, gracias a su inferencia de bajo consumo que podía ejecutar MobileNet v2 a aproximadamente 400 fotogramas por segundo. Sin embargo, desde entonces, Google ha dejado de invertir en la línea de productos sin lanzar ningún hardware nuevo destacable, y la mayoría de las bibliotecas de soporte no se han actualizado desde alrededor de 2022. El controlador GASKET requerido por los dispositivos Coral conectados por PCIe sigue sin ser compatible con los kernels de Linux actuales. Lo que ha evitado que Coral caiga completamente en desuso es que Google liberó el código fuente de sus controladores y firmware; proyectos como el mencionado Frigate NVR se han hecho cargo del soporte y lo han mantenido en producción, un caso donde coexisten el fin oficial del soporte y el uso continuo en el mundo real, lo que ilustra la discrepancia entre los ciclos de vida de los productos de hardware y la vida útil del software de código abierto. El principio de cuantización INT8 de Edge TPU y su filosofía de diseño en comparación con Intel Movidius (Myriad X) —otro chip que ya no se fabrica— se analizan con mayor profundidad en el artículo comparativo de aceleradores de IA para Edge AI (Sensor-edge-ai).
¿Es mejor integrar un acelerador en una placa de desarrollo que Jetson? Artículo de evaluación comparativa de 2026
Un artículo de abril de 2026 sobre la ejecución de inferencia de modelos de lenguaje (LLM) a gran escala en SBC de borde, titulado "Cloud to Edge: Benchmarking LLM Inference on Hardware-Accelerated Single-Board Computers" (Renney, Trad, Mattarock, Evetts, Wood), comparó el consumo de energía y el rendimiento en cuatro configuraciones: una Raspberry Pi 5 básica (solo CPU), una Raspberry Pi 5 con un AI HAT+ (NPU Hailo-10H), una Jetson Orin Nano Super (configuraciones de CPU y GPU por separado) y un módulo LLM M5Stack (NPU AX630C). Los resultados mostraron que añadir una NPU Hailo a la Raspberry Pi 5 mejoró la eficiencia de generación de tokens por vatio entre 9,57 y 39,97 veces en comparación con la configuración solo con CPU, reduciendo el consumo de energía por megatoken de 27-77 megajulios a 0,88-5,51 megajulios. En términos de rendimiento bruto, la configuración con GPU del Jetson Orin Nano fue la más rápida, con 9-10 tokens por segundo, pero la configuración Raspberry Pi 5 + Hailo igualó el rendimiento de la configuración solo con CPU del Jetson con aproximadamente la mitad de consumo energético y en un tamaño menor. Estos datos respaldan la afirmación de que una combinación de "SoC de propósito general más ASIC dedicado" puede competir en eficiencia energética con un ordenador con GPU integrada independiente.
Parámetros que determinan el rendimiento
- TOPS/W (eficiencia): Para robots y drones pequeños alimentados por batería, el rendimiento por vatio suele ser más importante que el rendimiento absoluto. El Hailo-8 destaca con 26 TOPS/2,5 W (aproximadamente 10,4 TOPS/W), mientras que el Jetson Orin Nano Super solo alcanza unos 2,7 TOPS/W en su modo MAXN Super (67 TOPS/25 W). Sin embargo, cabe destacar que esto implica una desventaja en comparación con la versatilidad de poder ejecutar modelos CUDA arbitrarios, a diferencia de un ASIC dedicado limitado a grafos fijos.
- Ancho de banda de memoria: Para la inferencia de redes neuronales que relee grandes matrices de pesos en cada fotograma, el ancho de banda de la memoria se convierte en el factor limitante de la velocidad con mayor frecuencia que la capacidad de cómputo bruta. La LPDDR5 de la Jetson Orin Nano Super (102 GB/s) es aproximadamente 6 veces mayor que la LPDDR4X de la Raspberry Pi 5 (~17,1 GB/s), y esta diferencia determina cuánto del valor TOPS del catálogo se puede extraer realmente.
- Compatibilidad con software existente: Una Raspberry Pi 5 puede ejecutar una distribución Linux estándar y ROS 2 sin problemas, mientras que los aceleradores ASIC como Coral/Hailo solo pueden ejecutar grafos fijos precuantizados y precompilados. La combinación óptima depende de si te encuentras en una fase de desarrollo donde los modelos cambian con frecuencia, o en una fase de producción donde solo se ejecuta la inferencia finalizada.
- Riesgo de suministro y continuidad de la hoja de ruta: Un producto como Coral, donde el proveedor prácticamente ha dejado de invertir, sobrevive gracias a la buena voluntad de la comunidad, lo que representa un riesgo real para su adopción en un proyecto de larga duración. Jetson, por el contrario, mantiene líneas de productos diseñadas para garantizar la continuidad de la hoja de ruta, como la certificación ISO 26262 ASIL-D de grado automotriz del AGX Orin.
- Fluctuaciones de precios externas al mercado: Como demuestran las subidas de precio de la Raspberry Pi en 2026, el precio de las SBC puede fluctuar drásticamente debido a factores completamente ajenos a un proyecto determinado, como la demanda de centros de datos de IA. La planificación de adquisiciones para despliegues a largo plazo debe sopesar la estabilidad del suministro junto con el precio unitario.
- Disponibilidad de interfaces de expansión: El carril PCIe 2.0 x1 de la Raspberry Pi 5 es demasiado estrecho para ejecutar un acelerador como el AI HAT+ a su máxima capacidad, y en algunos casos no puede extraer completamente el rendimiento del catálogo del Hailo-8 (clasificado para PCIe Gen3, 2 carriles), una limitación práctica que conviene considerar para cualquier configuración de acelerador adicional.
- Tamaño de la carcasa y diseño térmico: Un módulo ultracompacto como el M5Stack LLM Module, de 54 × 54 × 13 mm, puede ofrecer una mayor densidad de transferencia por unidad de volumen, incluso si su rendimiento absoluto es inferior. Esta es una propuesta fundamentalmente diferente a la de un módulo que depende de un disipador de calor, como el Jetson AGX Orin, en términos del chasis o la estructura en la que se adapta. Para drones o pequeños brazos robóticos con limitaciones de espacio y peso, el rendimiento por unidad de volumen se convierte en un criterio de selección junto con TOPS y TOPS/W.
¿Una CPU más rápida evita los cuellos de botella en el procesamiento de la cámara?
El ancho de banda de la memoria, la E/S, la alimentación y la refrigeración pueden limitar el rendimiento.
Mida el funcionamiento continuo con los periféricos reales.Referencias
- Página del producto Raspberry Pi 5
- PDF del resumen del producto Raspberry Pi 5
- Raspberry Pi 5 de 1 GB ya disponible por $45, y aumento de precio debido a la memoria (Raspberry Pi)
- Más aumentos de precio debido a la memoria (Raspberry Pi)
- El precio de la Raspberry Pi 5 aumenta drásticamente debido a la escasez de IA (Tom's Hardware)
- Página del producto NVIDIA Jetson Orin
- Kit de desarrollo Jetson Orin Nano Super (NVIDIA) - La nueva placa de desarrollo de IA de Nvidia, de 249 dólares, promete 67 TOPS (Tom's Hardware)
- NVIDIA JetPack 6.2 incorpora el Modo Super a Jetson Orin Nano y Orin NX (Blog para desarrolladores de NVIDIA)
- Jetson TK1: La supercomputadora móvil integrada lleva CUDA a todas partes (Blog técnico de NVIDIA)
- Hoja de datos del acelerador USB Coral (Coral)
- Pruebas de rendimiento de Edge TPU (Coral)
- Probablemente se abandonó Coral TPU (Discusión en GitHub de Frigate)
- Aumento de la velocidad de inferencia con 2 TPU frente a 1 TPU
- [Aumento de la velocidad de inferencia con 2 TPU frente a 1 TPU]( https://www.coral.ai/static/files/Coral-USB-Accelerator-datasheet.pdfDiscusión de Frigate en GitHub
- Detectores de objetos (documentación de Frigate)
- Página del producto Raspberry Pi AI HAT+ (Raspberry Pi)
- Acelerador de IA Hailo-8 (Hailo)
- Informe del producto Hailo-8 M.2 (PDF de Hailo)
- BBC Micro y Raspberry Pi (Raspberry Pi)
- La vida de Pi: Diez años de Raspberry Pi (Universidad de Cambridge)
- De la nube al borde: Evaluación comparativa de la inferencia LLM en ordenadores de placa única acelerados por hardware
- De la nube al borde: Evaluación comparativa de la inferencia LLM en ordenadores de placa única acelerados por hardware (arXiv:2604.24785)](https://arxiv.org/abs/2604.24785)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.