Contents — find the section you need
Um acelerador de inferência de IA é um chip projetado especificamente para executar a etapa de "inferência" de uma rede neural treinada — apenas o cálculo direto — com uma eficiência energética muito maior do que uma CPU ou GPU. O princípio físico fundamental é simples: converter pesos treinados em ponto flutuante de 32 bits (FP32) em uma representação de menor precisão, como inteiros de 8 bits (INT8) — quantização — permite que as mesmas unidades de computação e a mesma largura de banda de memória realizem muito mais operações paralelas. Este artigo não compara SBCs (computadores de placa única) como sistemas completos; em vez disso, concentra-se na filosofia de design e no princípio de quantização por trás dos chips aceleradores dedicados exclusivamente à inferência: Google Coral (Edge TPU), Intel Movidius (Myriad X) e NVIDIA Jetson Orin NX.
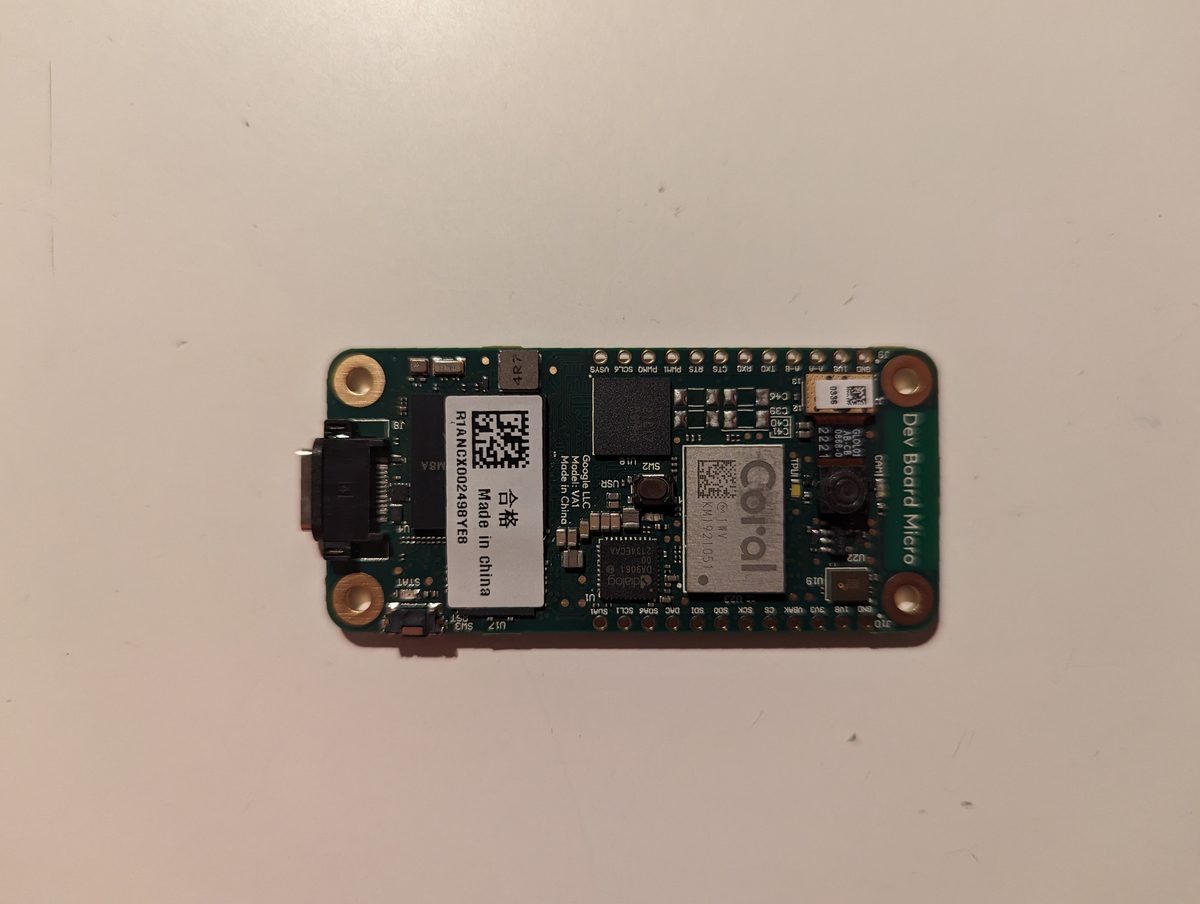 Google Coral Dev Board Micro
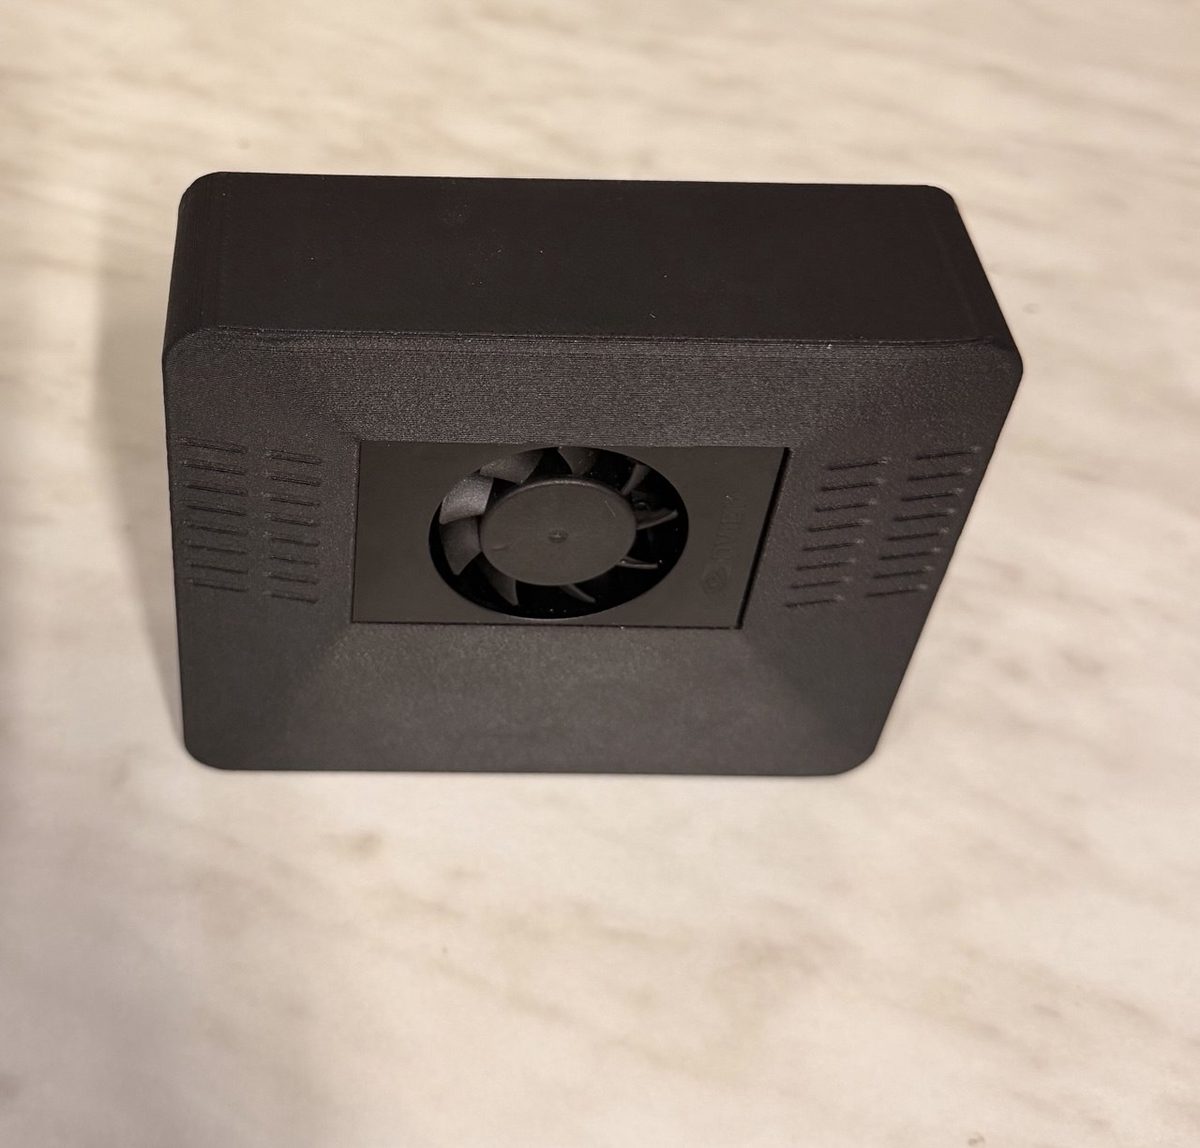 "ClawBox," construído em um NVIDIA Jetson Orin Nano (2026, ID Robots)
Imagens: Hardware PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA 2.0) / Dispositivo assistente de IA ClawBox (2026) - frente(Kkralev, CC BY-SA 4.0), ambos via Wikimedia Commons.
.jpg)
_-_front.jpg)
Princípio: o que a quantização INT8 realmente faz
A maneira mais comum de compactar pesos e ativações FP32 em inteiros de 8 bits é a quantização linear (afim). A fórmula que converte um valor real x em um inteiro q é:
Aqui, s é a escala (a largura em valor real de um passo inteiro), z é o ponto zero (o deslocamento que indica qual passo inteiro corresponde ao zero real) e b é a largura em bits (8 para INT8). No momento da inferência, o valor é aproximadamente recuperado como x \approx s(q-z). O que essa quantização significa na prática é que o quão estreitamente a distribuição de valores pode ser limitada determina diretamente quanta precisão é perdida. Com os mesmos 256 passos (INT8), uma faixa de valores estreita mantém a largura de cada passo — o erro de quantização — pequena; Uma amplitude ampliada por valores discrepantes se torna 256 passos mais estreita, tornando a representação dos valores típicos que compõem a maior parte da distribuição menos precisa.
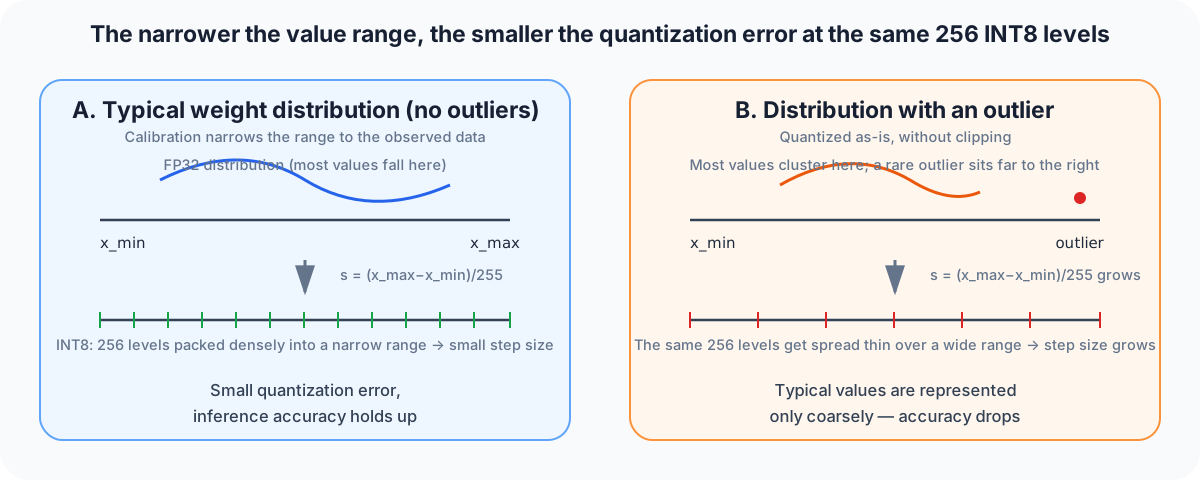
Diagrama: Duskcoil. Ilustra como a presença ou ausência de "calibração" — delimitando a faixa de valores usando dados reais medidos — afeta significativamente o erro de quantização, mesmo com a mesma largura de bits.
Decidir essa faixa de valores é a etapa de calibração, e a quantização segue, de forma geral, duas abordagens. Quantização Pós-Treinamento (PTQ) simplesmente executa uma pequena quantidade de dados representativos através do modelo FP32 treinado e calcula a escala s a partir da faixa de saída observada de cada camada — uma abordagem leve, mas propensa a uma maior perda de precisão em modelos com muitos outliers. Treinamento com Consciência de Quantização (QAT) simula o O erro de arredondamento introduzido pela quantização durante o próprio treinamento atualiza os pesos de acordo; isso suprime a degradação da precisão ao custo de uma nova passagem de treinamento. O Edge TPU Compiler, o TensorRT e o OpenVINO suportam ambas as abordagens, mas como a maioria dos chips de inferência de borda cita seu desempenho de catálogo (TOPS) assumindo INT8, a decisão prática é se o PTQ produz precisão suficiente ou se é necessário mudar para o QAT.
Há também uma complicação adicional: as VPUs (Unidades de Processamento de Visão) projetadas por volta de 2017, como o Movidius Myriad X, usavam FP16 (ponto flutuante de meia precisão) em vez de INT8 como sua precisão de computação primária. O FP16 reduz pela metade a pegada de memória e a demanda de largura de banda em relação ao FP32, enquanto — por manter um campo de expoente — representa uma ampla faixa dinâmica sem a necessidade de calibração de faixa no estilo INT8. No entanto, ele não atinge o paralelismo que o INT8 pode alcançar, o que é uma das razões pelas quais o Coral Edge TPU e o Tensor do Jetson posteriores usam FP16. Os núcleos, ambos construídos em torno de caminhos de dados dedicados com prioridade para INT8, apresentam desempenho TOPS/W várias vezes superior.
Princípio: o compilador de grafos como um segundo eixo de aceleração de inferência
Além da quantização, o que um modelo treinado gera com o conjunto de instruções de um chip específico é o outro fator principal no desempenho real. Um modelo exportado do TensorFlow Lite ou ONNX é, por si só, um grafo genérico executado camada por camada em sequência em uma CPU. O compilador de cada fornecedor aplica aproximadamente três tipos de otimização a esse grafo.
-
Fusão de operadores: Uma sequência como Convolução→Normização em lote→ReLU é mesclada em um único kernel fundido, mantendo os resultados intermediários em registradores em vez de gravá-los de volta na memória, reduzindo o número de acessos à memória.
-
Transformação de layout: O layout NCHW (canal primeiro), preferido pela CPU, e o layout NHWC (canal por último), preferido pela unidade vetorial, são selecionados novamente para corresponder. o padrão real de acesso à memória do hardware de destino.
- Compilação para um grafo fixo: Alguns compiladores, como o Coral Edge TPU Compiler, aceitam apenas um grafo totalmente fixo construído inteiramente a partir de operadores suportados, proibindo completamente formas dinâmicas ou operações não suportadas. Se mesmo um único operador não suportado aparecer no modelo, a execução se divide entre a CPU e o Edge TPU ao redor dele, e o custo resultante de transferência de dados bidirecional pode reduzir substancialmente a velocidade.
O TensorRT da NVIDIA e o OpenVINO da Intel adotam uma abordagem mais flexível de "descarregamento parcial" — recorrendo aos operadores não suportados para a CPU enquanto descarregam o restante para o acelerador — enquanto o Coral Edge TPU Compiler se aproxima mais de uma escolha do tipo "tudo ou nada" entre um grafo totalmente suportado e nenhuma aceleração. Essa distinção não aparece em métricas de hardware como as compensações TOPS/largura de banda de memória abordadas no artigo de comparação de SBC — é uma diferença em A filosofia de design da pilha de software afeta substancialmente o custo real da portabilidade de um modelo.
Comparação dos principais chips: Coral, Movidius, Jetson
| Produto | Precisão | Desempenho em IA | Consumo de energia | Interface | Preço |
|---|---|---|---|---|---|
| Google Coral Edge TPU (Acelerador USB) | Somente INT8 | 4 TOPS (2 TOPS/W) | 2W | USB 3.0 | ~US$ 75–99 (lançamento em 2019) |
| Intel Movidius Myriad X (Neural Compute Stick 2) | Principalmente FP16 | Equivalente a ~4 TOPS (sem valor oficial divulgado) | ~1,5–2,5W | USB 3.0 | ~US$ 79–99 (lançamento em 2018, descontinuado) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10,4 TOPS/W) | ~2,5 W | M.2/PCIe | ~$ 110 |
| NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (modo MAXN Super) | 7–25 W | SoM (módulo integrado) | $ 249 |
| NVIDIA Jetson Orin NX (16 GB) | INT8 | 100 TOPS | 10–25 W | SoM (módulo integrado) | $ 599 |
A página oficial de especificações do Intel Movidius Myriad X não indica um valor exato de TOPS, mas diversas análises o descrevem como capaz de realizar "mais de 4 trilhões de operações por segundo" no total, e a própria Intel afirmou que o Myriad X é mais de 10 vezes mais rápido que o Myriad 2 (100–150 GFLOPS). A combinação de 16 núcleos programáveis do processador vetorial SHAVE com o Neural Compute Engine — um bloco dedicado que estreou com o Myriad X — foi projetada para processar seis câmeras em 720p (três pares estéreo) a 60 fps simultaneamente. O Hailo-8 e o Jetson Orin Nano Super/NX são abordados com mais detalhes no artigo de comparação de SBC, portanto, este texto se limita às entradas da tabela acima para evitar repetição.
A linha Coral também inclui o Dev Board Micro, um derivado posterior do Acelerador USB mencionado acima. Em vez de um processador de aplicativos compatível com Linux, ele combina o coprocessador Edge TPU com uma placa de microcontrolador (MCU) de baixo consumo e sempre ativa, voltada diretamente para casos de uso do TinyML alimentados por bateria, como detecção de voz ou vibração sempre ativa. Enquanto o Dev Board/Acelerador USB combina um SoC de uso geral com um Edge TPU externo, o Dev Board Micro visa um caso de uso completamente diferente: um gatilho de detecção sempre ativo.
História: uma filosofia de design de VPU nascida da aquisição da Movidius pela Intel
A Movidius era uma startup sediada em San Mateo que projetava chips de baixo consumo especializados para processamento de visão computacional, adquirida pela Intel em setembro de 2016. Sua VPU (Unidade de Processamento de Visão) Myriad 2, anterior à aquisição, não possuía um design de CPU de uso geral; em vez disso, combinava blocos de hardware dedicados à visão computacional com 12 núcleos de processador vetorial personalizados (SHAVE). Após a aquisição, passou a ser utilizada em dispositivos de produção, incluindo a câmera de registro de vida "Clips" do Google, a câmera termográfica "Firefly" da FLIR, o drone "Phantom 4" da DJI e o "DeepGaze" da Tencent. Sua sucessora, Myriad X, foi anunciada em 2017, expandindo a contagem de núcleos SHAVE para 16 e adicionando — pela primeira vez — um bloco de hardware dedicado para inferência de redes neurais, o Neural Compute Engine, atingindo mais de 10 vezes o desempenho da Myriad 2 e um pico superior a 1 teraFLOPS. O Neural Compute Stick 2 (NCS2) mencionado acima é um dispositivo USB com uma única unidade Myriad X, lançado no quarto trimestre de 2018. A própria página de especificações do produto da Intel agora o marca como "Descontinuado" — um chip VPU que outrora representou os primórdios da IA de borda, tendo cedido o mercado para os ASICs dedicados a INT8 e os chips com GPU integrada que o sucederam.
Juntamente com essa aquisição, a Intel lançou a primeira versão de seu kit de ferramentas OpenVINO em 16 de maio de 2018, como uma pilha de software destinada a lidar com quantização e otimização de grafos de forma uniforme em seu próprio hardware. O componente NNCF (Neural Network Compression Framework) do OpenVINO lida com quantização INT8 e compressão de modelos, e foi projetado para otimizar e implantar modelos por meio de um único fluxo de trabalho que abrange não apenas VPUs da família Movidius, mas também CPUs Intel e GPUs integradas — o fato de ter sobrevivido como uma cadeia de ferramentas, em vez de estar vinculado a um único chip acelerador, ilustra uma estratégia de sobrevivência em um campo onde as gerações de hardware se renovam rapidamente.
História: Edge TPU, herdeiro da linhagem TPU de data center
O Edge TPU dentro dos produtos Google Coral é um projeto que A arquitetura de computação "systolic array" que o Google criou para suas TPUs (Unidades de Processamento de Tensores) de classe datacenter foi adaptada para dispositivos embarcados com restrições de energia. Uma systolic array organiza um grande número de unidades de multiplicação e acumulação em uma grade e transmite dados em uma única direção, passando-os apenas entre unidades adjacentes. Ao contrário de uma CPU de uso geral, que precisa acessar registradores e memória para cada instrução, isso permite realizar grandes multiplicações de matrizes com altíssima eficiência energética. As TPUs de datacenter do Google constroem essa grade em escala enorme, montando vários chips em uma placa equipada com dissipadores de calor de cobre resfriados a líquido (a foto abaixo, divulgada pelo Google, mostra uma placa TPU v3 com quatro chips visivelmente conectados por tubos de resfriamento líquido). A Edge TPU mantém essa mesma ideia fundamental, mas reduz drasticamente a grade e o consumo de energia para um dígito de watts, permitindo que ela opere dentro do orçamento de energia de um barramento USB ou de um slot M.2.
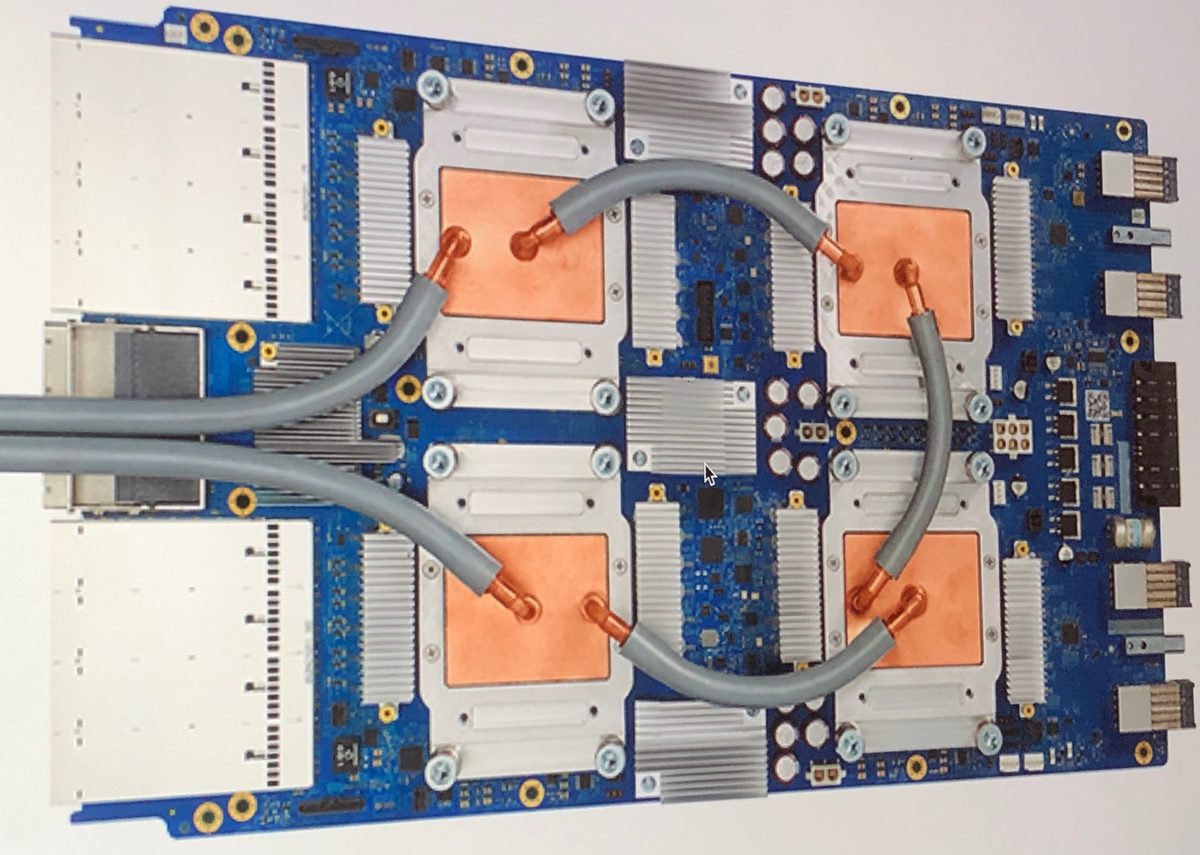
Imagem: Tensor Processing Unit 3.0(Zinskauf, CC BY-SA 4.0), Wikimedia Commons. Uma foto da placa do TPU v3 de classe datacenter — não o próprio Edge TPU, mas uma referência mostrando a escala do "pai" do datacenter que compartilha a mesma abordagem de matriz sistólica.

Em 2019, o Google lançou a placa de desenvolvimento e o acelerador USB com este Edge TPU (4 TOPS, 2W), que atraiu seguidores como um acelerador adicional para SBCs existentes, como o Raspberry Pi, com suporte para inferência de baixo consumo de energia que podia executar o MobileNet v2 a aproximadamente 400 quadros por segundo. Desde então, no entanto, o Google efetivamente parou de investir na linha de produtos sem lançar nenhum hardware novo notável e, a partir de 2026, seu coral.ai oficial O site redireciona para uma página genérica do Google Developers. O motivo pelo qual os produtos Coral não caíram completamente em desuso, apesar disso, é que o Google liberou os drivers e o firmware como código aberto, permitindo que projetos da comunidade, como o software de vigilância com detecção de objetos Frigate NVR, recebessem suporte e mantivessem o hardware em produção (detalhado no artigo de comparação de SBC).
Exemplo prático: nove redes neurais rodando simultaneamente em um único Jetson TX2 a bordo de um drone Skydio X2
Um exemplo notável de um único chip acelerador executando múltiplas redes neurais em paralelo é o drone voador autônomo Skydio X2/X2D. O X2 possui um NVIDIA Tegra X2 — o mesmo SoC encontrado no Jetson TX2 — como seu chip de computação principal, processando feeds de seis câmeras integradas (três pares estéreo, uma configuração trinocular) para executar nove redes neurais profundas personalizadas simultaneamente, tudo integrado. Usando essas saídas de inferência, ele pode rastrear até 20 objetos simultâneos. interesse — obstáculos, objetos como pessoas ou veículos — enquanto constrói um modelo 3D do mundo atualizado a uma taxa superior a um milhão de pontos por segundo, e o ciclo de decisão que transforma esse modelo do mundo em comandos de voo é executado a uma taxa de 500 Hz. A razão pela qual ele pode voar rapidamente por florestas densas ou espaços internos, evitando obstáculos sem depender de GPS, é que todo esse processo é concluído em um único Tegra X2 a bordo, em vez de ser descarregado para a nuvem.
 Skydio X2D inspecionando um KC-10 Extender (Base Aérea de Dover)
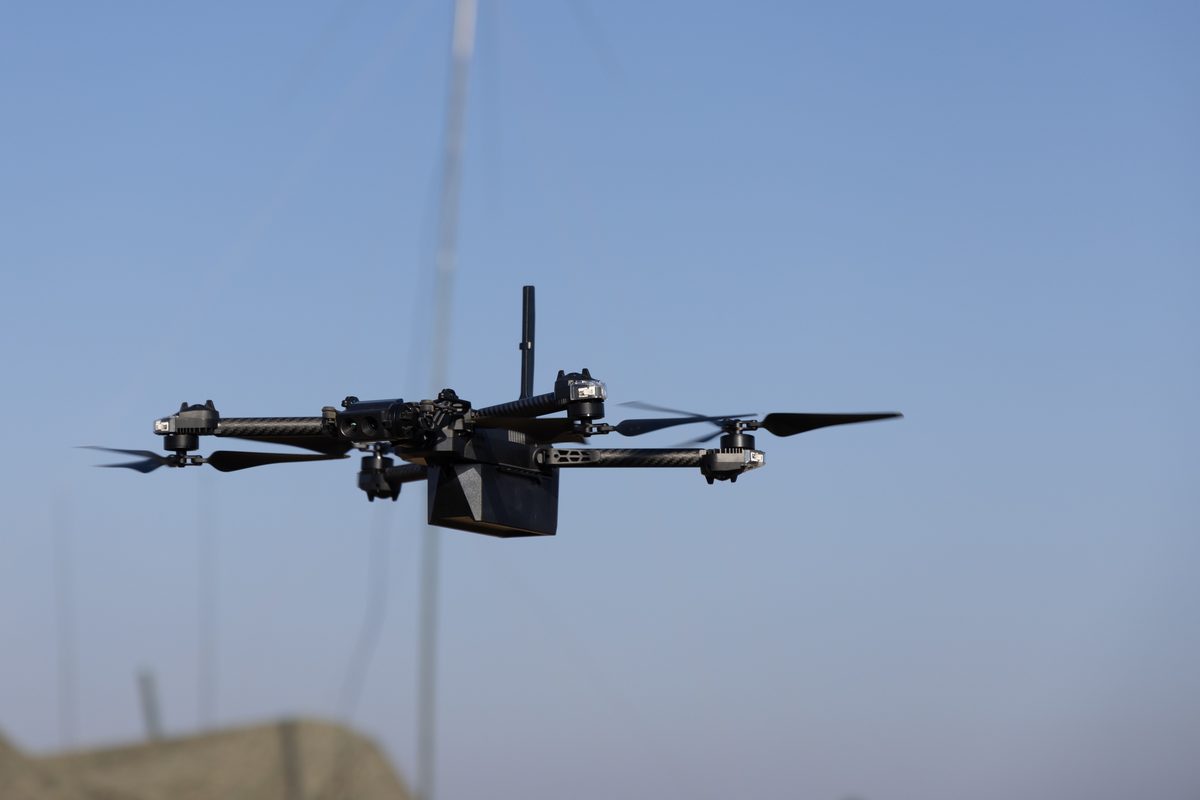 Um Skydio X2D voando durante treinamento (Camp Schwab, Okinawa)
Imagens: Skydio X2D inspecionando aeronave(Mauricio Campino, Domínio público) / Fuzileiros Navais dos EUA praticam operações com UAS (9269101)(Domínio público, Corpo de Fuzileiros Navais dos EUA), ambas via Wikimedia Commons.

.jpg)
A designação X2D refere-se à variante do Departamento de Defesa, e implantações reais registradas em fotos divulgadas publicamente pelo Departamento de Defesa dos EUA incluem o 436º Grupo de Geração de Missão na Base Aérea de Dover, Delaware, usando um X2D para inspecionar a integridade estrutural de uma aeronave de reabastecimento aéreo KC-10 Extender. (Novembro de 2022), assim como a 5ª Companhia de Ligação de Artilharia Aérea e Naval (5ª ANGLICO) treinando em Camp Schwab, Okinawa, e a 10ª Divisão de Montanha treinando na Área de Treinamento de Hohenfels, na Alemanha, ambas operando o Skydio X2D como um pequeno sistema aéreo não tripulado (sUAS). Seu sucessor, o X10, migra do Tegra X2 para um SoC da geração Jetson Orin e atualiza suas câmeras de navegação para 32 megapixels — uma boa ilustração de como um salto no TOPS por chip entre gerações se traduz diretamente em ganhos operacionais reais: mais redes neurais rodando simultaneamente a bordo, mais objetos rastreados simultaneamente e um ciclo de decisão de maior frequência.
De um "aparelho de IA" para entusiastas à fronteira do treinamento em dispositivos
Aceleradores integrados a GPUs, antes focados em robótica e aplicações de defesa, começaram, em 2026, a alcançar também desenvolvedores individuais e de pequena escala. O "ClawBox", construído pela ID Robots da Bulgária, é um dispositivo de hardware para assistente de IA que utiliza um NVIDIA Jetson Orin Nano, alojado em um gabinete do tamanho da palma da mão com um ventilador de resfriamento e ventilação lateral — reutilizando, sem alterações, o mesmo SoM originalmente projetado para cargas de trabalho de robótica. O fato de um chip projetado para ser o "cérebro" de um drone ou robô industrial poder ser inserido diretamente em um produto comercializado em centenas ou até milhares de unidades, fabricado por uma pequena startup, ressalta a força da generalidade dos aceleradores integrados à GPU — ao contrário de um ASIC dedicado, eles podem executar modelos CUDA arbitrários sem alterações.
Uma segunda tendência relacionada é a pesquisa que impulsiona o que antes era um acelerador de borda puramente inferencial para o treinamento no próprio dispositivo — o re-treinamento de um modelo diretamente no dispositivo. Um artigo publicado em julho de 2026, "Empowering On-Device Model Adaptation with an Edge AI Inference Accelerator" (Piechocki, Capotondi, Kraft, arXiv:2607.18101), propõe um pipeline usando o Hailo-8L (um modelo inferior ao Hailo-8 discutido anteriormente) que divide o trabalho de inferência e treinamento entre chips diferentes: a inferência da arquitetura quantizada é executada no Hailo-8L, enquanto apenas as camadas finais, mais leves, são otimizadas incrementalmente em FP32 na CPU. O artigo relata um aumento de velocidade de até 15,4 vezes no tempo de execução do treinamento no dispositivo em comparação com um Raspberry Pi 5 sozinho — um vislumbre de uma fronteira de pesquisa onde a própria premissa de "apenas inferência" está começando a se dissipar, construída sobre a mesma pilha de tecnologia subjacente de quantização e compilação de grafos.
Parâmetros que determinam o desempenho
- Eficiência TOPS/W versus flexibilidade de precisão: O Coral Edge TPU é altamente eficiente, com 2 TOPS/W, mas isso tem a limitação de executar apenas grafos fixos pré-quantizados para INT8. O Jetson Orin NX, por outro lado, pode executar modelos CUDA arbitrários em uma combinação de FP16/INT8, ao custo de não atingir o mesmo desempenho TOPS/W do Coral. A quantidade de flexibilidade que um projeto pode abrir mão geralmente é o primeiro fator decisivo na escolha do chip.
- Rigidez do compilador: Um compilador totalmente baseado em grafos fixos, como o Coral Edge TPU Compiler, que não permite nenhum operador não suportado, força o projeto do modelo a ser restrito a operadores suportados desde o início. Compiladores de descarregamento parcial, como TensorRT/OpenVINO, oferecem mais flexibilidade de portabilidade, mas é fácil ignorar a penalidade de velocidade que aparece quando um fallback para CPU é acionado.
- Escolha do método de quantização (PTQ vs. QAT): O PTQ, que precisa apenas de uma pequena quantidade de dados representativos, é barato de desenvolver, mas propenso a uma maior perda de precisão em modelos com muitos outliers. O QAT custa uma passagem de retreinamento, mas suprime essa degradação. As VPUs da geração Movidius Myriad X, construídas principalmente em torno de FP16, evitam completamente o esforço de calibração da quantização por design.
- Largura de banda da interface: Dispositivos conectados via USB, como o Coral USB Accelerator ou o NCS2, podem atingir um gargalo de largura de banda do barramento USB do host quando várias unidades são combinadas (detalhado no caso do Frigate NVR no artigo de comparação de SBC). Dispositivos conectados via M.2/PCIe, como o Hailo-8, ou Jetsons com SoM integrado, são menos expostos a essa limitação.
- Continuidade de fornecimento e roteiro: O Movidius NCS2 da Intel está explicitamente marcado como "Descontinuado" em sua própria página de especificações, e o site oficial da Coral agora redireciona para outro lugar, enquanto a linha Jetson continua lançando novas gerações. Para um projeto de longa duração, a continuidade do fornecimento em si torna-se um fator de risco que vai além de uma simples comparação de TOPS por dólar.
- **Relação custo-benefício (US/TOPS)**: Com base em uma simples comparação de US/TOPS, o Jetson Orin Nano Super (US249/67 TOPS ≈ US 3,7/TOPS) e o Jetson Orin NX (US599/100 TOPS ≈ US 6/TOPS) podem parecer mais baratos que o Hailo-8 (US110/26 TOPS ≈ US 4,2/TOPS) ou o Coral (US75–99/4 TOPS ≈ US 19–25/TOPS) — mas a escolha final ainda depende do equilíbrio entre o tamanho do chassi e o orçamento de energia que um determinado produto pode realmente acomodar, e não apenas do desempenho bruto e do preço unitário.
O dobro do TOPS significa o dobro da velocidade do aplicativo?
Precisão, memória, operadores suportados, transferências e pré-processamento afetam a velocidade. Meça a latência de ponta a ponta no modelo real.
Referências
- Neural Network Compression Framework (NNCF) — OpenVINO oficial
- OpenVINO (Wikipedia)
- Intel Neural Compute Stick 2 — Especificações do produto (Intel oficial)
- Análise: Intel Neural Compute Stick 2 para IA de borda (viso.ai)
- Intel adquire a empresa de visão computacional Movidius (Road to VR)
- Intel anuncia o Movidius Myriad X (Notebookcheck)
- Google Coral Edge TPU / Dev Placa — Software CNX
- Placa de desenvolvimento Coral TPU (NXP)
- Arquitetura do sistema Cloud TPU (Google Cloud oficial)
- Análise do módulo NVIDIA Jetson Orin NX de 16 GB (ThinkRobotics)
- Ficha técnica da série NVIDIA Jetson Orin NX (NVIDIA Developer)
- Kit de desenvolvimento Jetson Orin Nano Super (NVIDIA oficial)
- Destaque Inception: Drone Skydio 2 com NVIDIA Jetson (Blog técnico da NVIDIA)
- Comparação Skydio X10 vs X2 (O FUTURO 3D)
- Capacitando a adaptação de modelos em dispositivos com um acelerador de inferência de IA de borda (arXiv:2607.18101)
- Inferência LLM sustentável para IA de borda (arXiv:2504.03360)
- Hardware PXL 20231201 152957218 (53388218926) — Wikimedia Commons
- Unidade de Processamento de Tensores 3.0 — Wikimedia Commons
- [Dispositivo assistente de IA ClawBox (2026) - frente — Wikimedia Commons
- Skydio X2D inspecionando aeronaves — Wikimedia Commons
- Fuzileiros Navais dos EUA praticam operações com UAS (9269101) — Wikimedia Commons


Comentários
Entre na sua conta para continuar.
Ainda não há dados.