Contents — find the section you need
Akselerator inferensi AI adalah chip yang dirancang khusus untuk menjalankan proses "inferensi" dari jaringan saraf terlatih — hanya komputasi maju — dengan efisiensi energi yang jauh lebih tinggi daripada CPU atau GPU. Prinsip fisik intinya sederhana: mengubah bobot yang dilatih dalam floating point 32-bit (FP32) menjadi representasi presisi lebih rendah seperti bilangan bulat 8-bit (INT8) — kuantisasi — memungkinkan unit komputasi yang sama dan bandwidth memori yang sama untuk menjalankan operasi paralel yang jauh lebih banyak. Artikel ini tidak membandingkan SBC (komputer papan tunggal) sebagai sistem keseluruhan; sebaliknya, artikel ini berfokus sepenuhnya pada filosofi desain dan prinsip kuantisasi di balik chip akselerator yang didedikasikan murni untuk inferensi: Google Coral (Edge TPU), Intel Movidius (Myriad X), dan NVIDIA Jetson Orin NX.
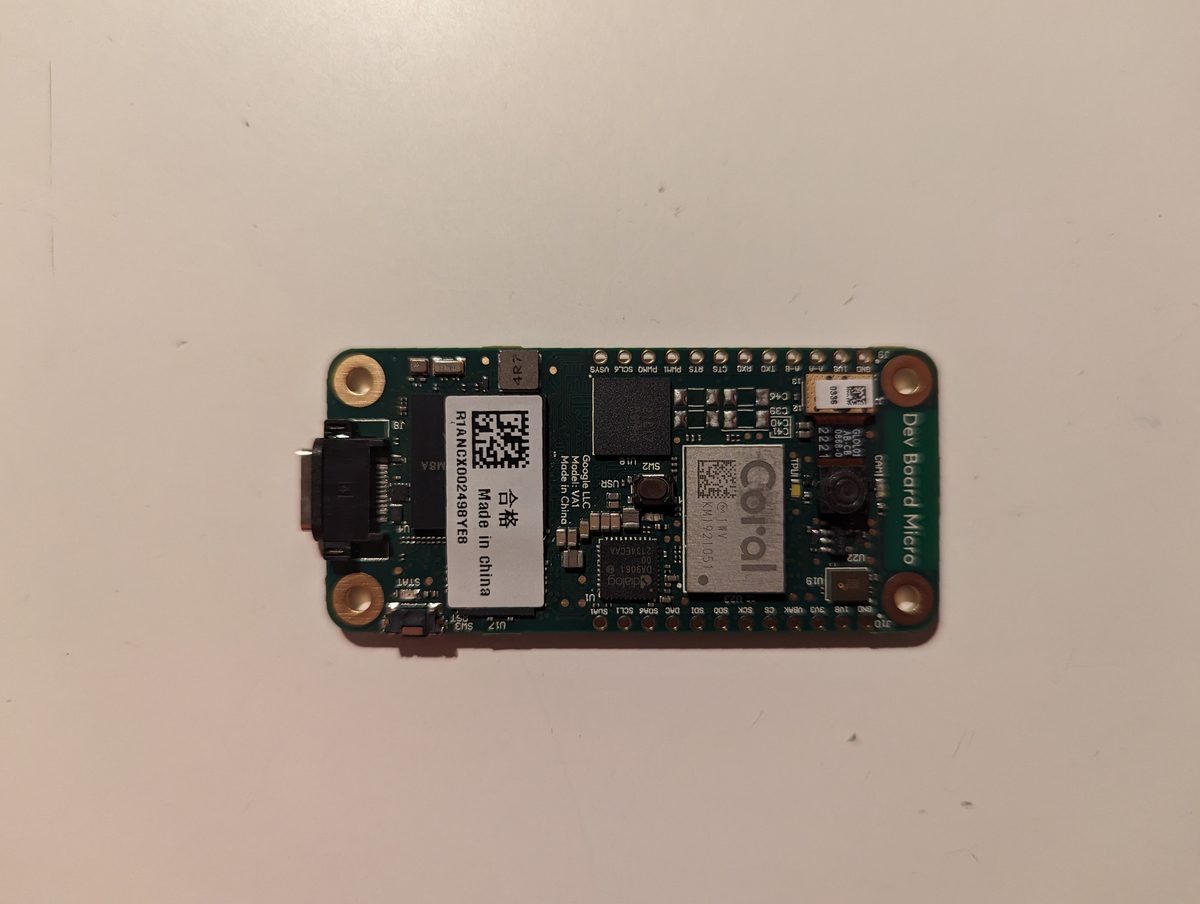 Google Coral Dev Board Micro
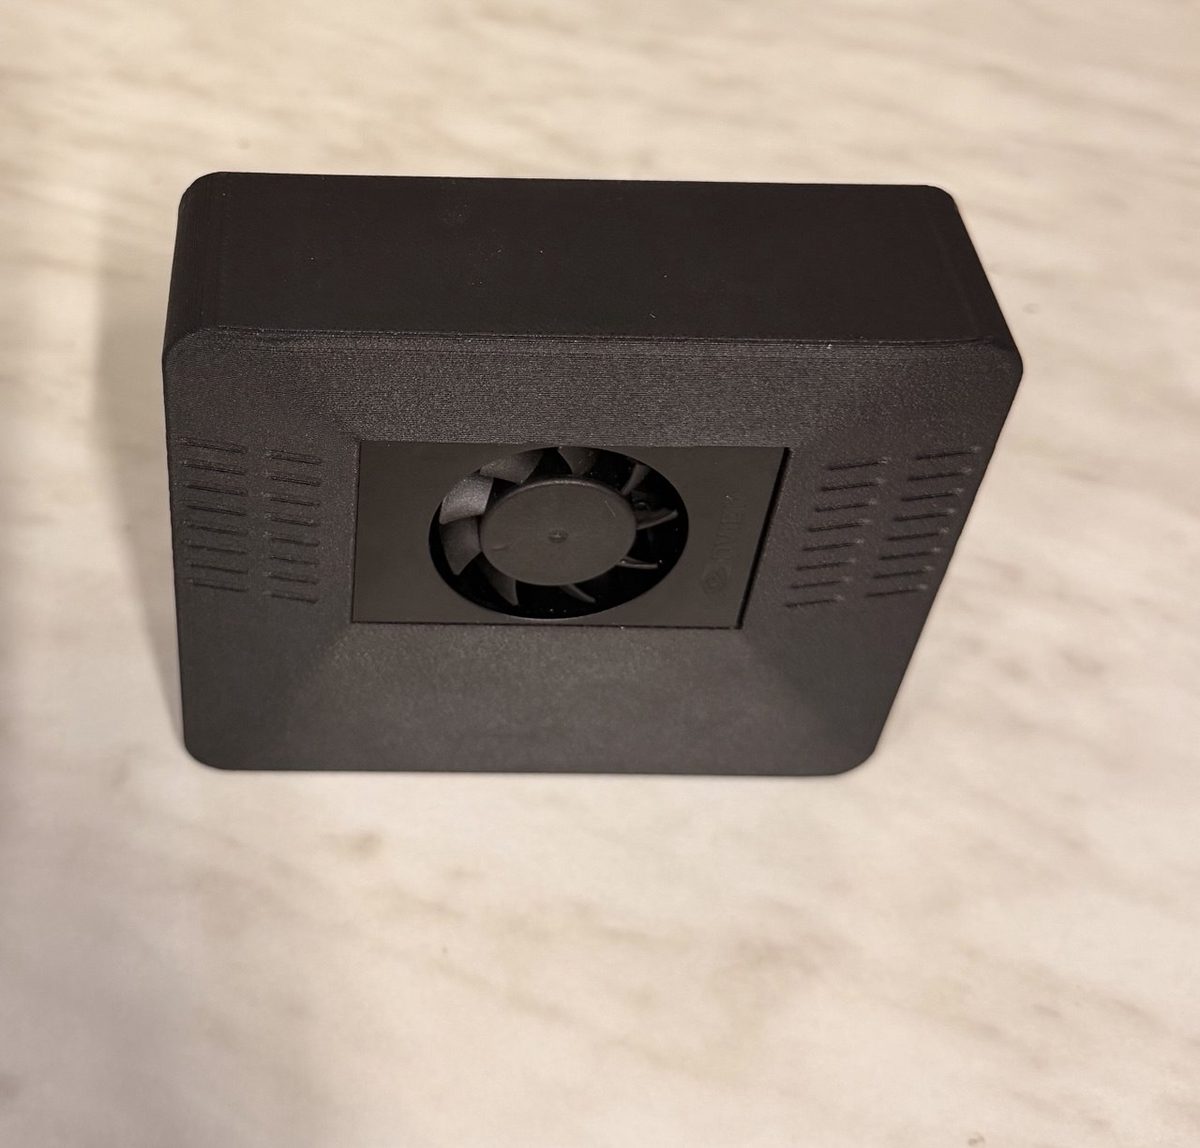 "ClawBox," dibangun di atas NVIDIA Jetson Orin Nano (2026, ID Robots)
Gambar: Hardware PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA 2.0) / Perangkat asisten AI ClawBox (2026) - depan(Kkralev, CC BY-SA 4.0), keduanya melalui Wikimedia Commons.
.jpg)
_-_front.jpg)
Prinsip: apa yang sebenarnya dilakukan kuantisasi INT8
Cara paling umum untuk memadatkan bobot dan aktivasi FP32 ke dalam bilangan bulat 8-bit adalah kuantisasi linier (affine). Rumus yang mengubah nilai riil x menjadi bilangan bulat q adalah:
Di sini s adalah skala (lebar bernilai riil dari satu langkah bilangan bulat), z adalah titik nol (offset yang menunjukkan langkah bilangan bulat mana yang sesuai dengan nol riil), dan b adalah lebar bit (8 untuk INT8). Pada saat inferensi, nilai tersebut kira-kira diperoleh kembali sebagai x \approx s(q-z). Dalam praktiknya, kuantisasi ini berarti bahwa seberapa ketat distribusi nilai dapat dibatasi secara langsung menentukan seberapa banyak akurasi yang hilang. Dengan 256 langkah yang sama (INT8), rentang nilai yang sempit menjaga lebar setiap langkah — kesalahan kuantisasi — tetap kecil; rentang yang diperluas oleh outlier menyebarkan 256 langkah yang sama menjadi lebih tipis, memperhalus representasi nilai-nilai tipikal yang membentuk sebagian besar distribusi.
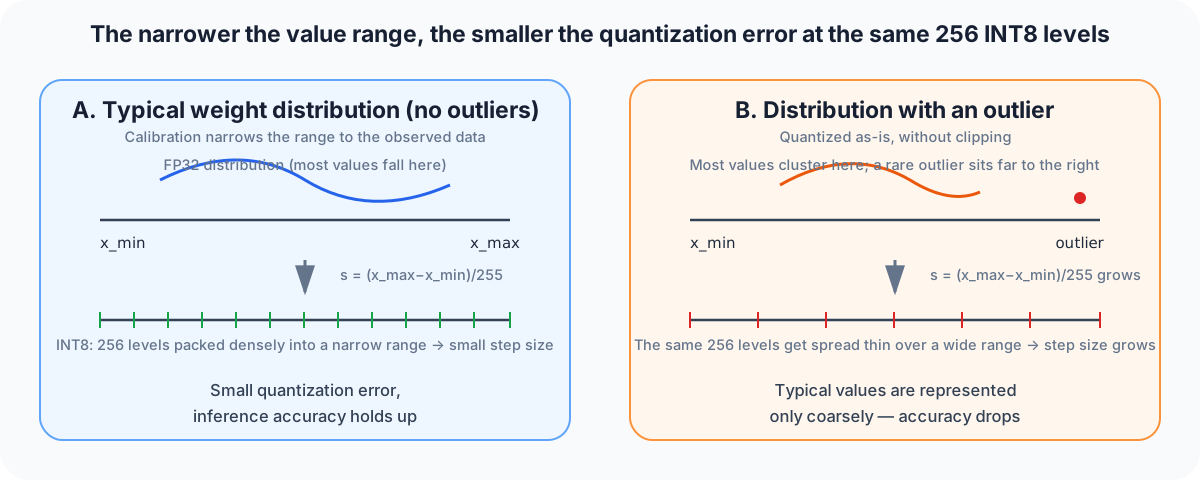
Diagram: Duskcoil. Mengilustrasikan bagaimana keberadaan atau ketiadaan "kalibrasi" — membatasi rentang nilai menggunakan data terukur nyata — secara signifikan memengaruhi kesalahan kuantisasi bahkan pada lebar bit yang sama.
Menentukan rentang nilai ini adalah langkah kalibrasi, dan kuantisasi secara umum mengikuti dua pendekatan. Kuantisasi Pasca-Pelatihan (PTQ) hanya menjalankan sejumlah kecil data representatif melalui model FP32 yang telah dilatih dan menghitung skala s dari rentang output yang diamati setiap lapisan — pendekatan yang ringan, tetapi rentan terhadap kehilangan akurasi yang lebih besar pada model dengan banyak outlier. Pelatihan Sadar Kuantisasi (QAT) mensimulasikan kesalahan pembulatan yang diperkenalkan oleh kuantisasi selama Pelatihan itu sendiri, memperbarui bobot sesuai kebutuhan; ini menekan penurunan akurasi dengan mengorbankan satu kali pelatihan ulang. Edge TPU Compiler, TensorRT, dan OpenVINO semuanya mendukung kedua pendekatan tersebut, tetapi karena sebagian besar chip inferensi edge mengutip kinerja katalog (TOPS) mereka dengan asumsi INT8, pilihan praktisnya adalah apakah PTQ menghasilkan akurasi yang cukup atau apakah perlu beralih ke QAT.
Ada juga masalah lain: VPU (Vision Processing Unit) yang dirancang sekitar tahun 2017, seperti Movidius Myriad X, menggunakan FP16 (floating point presisi setengah) daripada INT8 sebagai presisi komputasi utama mereka. FP16 mengurangi separuh jejak memori dan kebutuhan bandwidth relatif terhadap FP32 sementara — karena mempertahankan bidang eksponen — mewakili rentang dinamis yang luas tanpa memerlukan kalibrasi rentang gaya INT8. Namun, ia tidak mencapai paralelisme yang dapat dicapai INT8, yang merupakan salah satu alasan mengapa Coral Edge TPU dan Tensor Core Jetson yang lebih baru, keduanya dibangun di sekitar INT8-pertama yang didedikasikan. jalur data, beberapa kali TOPS/W.
Prinsip: kompiler grafik sebagai sumbu kedua percepatan inferensi
Selain kuantisasi, apa yang dihasilkan dari kompilasi model terlatih untuk set instruksi chip tertentu adalah faktor utama lainnya dalam throughput dunia nyata. Model yang diekspor dari TensorFlow Lite atau ONNX, dengan sendirinya, adalah grafik generik yang dieksekusi lapis demi lapis secara berurutan pada CPU. Kompiler setiap vendor menerapkan sekitar tiga jenis optimasi pada grafik ini.
- Penggabungan operator: Urutan seperti Konvolusi→BatchNorm→ReLU digabungkan menjadi satu kernel gabungan, menyimpan hasil sementara dalam register daripada menuliskannya kembali ke memori, mengurangi jumlah akses memori.
-
Transformasi tata letak: Tata letak NCHW (channel-first) yang disukai CPU dan tata letak NHWC (channel-last) yang disukai unit vektor dipilih ulang agar sesuai dengan pola akses memori aktual dari perangkat keras target.
-
Kompilasi ke grafik tetap: Beberapa kompiler, seperti Coral Edge TPU Compiler, hanya menerima grafik yang sepenuhnya tetap yang dibangun seluruhnya dari operator yang didukung, melarang bentuk dinamis atau operator yang tidak didukung sama sekali. Jika bahkan satu operator yang tidak didukung muncul dalam model, eksekusi akan terbagi antara CPU dan Edge TPU di sekitarnya, dan biaya transfer data dua arah yang dihasilkan dapat secara substansial mengurangi kecepatan.
TensorRT NVIDIA dan OpenVINO Intel mengambil pendekatan "offload parsial" yang lebih fleksibel — mengembalikan operator yang tidak didukung ke CPU sementara sisanya dialihkan ke akselerator — sedangkan Coral Edge TPU Compiler lebih mendekati pilihan semua atau tidak sama sekali antara grafik yang sepenuhnya didukung dan tanpa akselerasi sama sekali. Perbedaan ini tidak muncul dalam metrik perangkat keras seperti trade-off TOPS/bandwidth memori yang dibahas dalam artikel perbandingan SBC — ini adalah perbedaan dalam filosofi desain tumpukan perangkat lunak, dan secara substansial memengaruhi biaya sebenarnya dari porting model.
Utama Perbandingan chip: Coral, Movidius, Jetson
| Produk | Presisi | Performa AI | Daya | Antarmuka | Harga |
|---|---|---|---|---|---|
| Google Coral Edge TPU (Akselerator USB) | Hanya INT8 | 4 TOPS (2 TOPS/W) | 2W | USB 3.0 | ~$75–99 (peluncuran 2019) |
| Intel Movidius Myriad X (Neural Compute Stick 2) | Sebagian besar FP16 | Setara ~4 TOPS (tidak ada angka resmi yang dipublikasikan) | ~1,5–2,5W | USB 3.0 | ~$79–99 (peluncuran 2018, sekarang dihentikan) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10,4 TOPS/W) | ~2,5W | M.2/PCIe | ~$110 |
| NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (mode MAXN Super) | 7–25W | SoM (modul terintegrasi) | $249 |
| NVIDIA Jetson Orin NX (16GB) | INT8 | 100 TOPS | 10–25W | SoM (modul terintegrasi) | $599 |
Halaman spesifikasi resmi Intel Movidius Myriad X tidak menyebutkan angka TOPS yang tepat, tetapi beberapa ulasan menggambarkannya sebagai memberikan "lebih dari 4 triliun operasi per detik" secara total, dan Intel sendiri telah mengatakan Myriad X lebih dari 10x lebih cepat daripada Myriad 2 (100–150 GFLOPS). Kombinasi 16 inti prosesor vektor SHAVE yang dapat diprogram dengan Neural Compute Engine — blok khusus yang memulai debutnya dengan Myriad X — Dirancang untuk memproses enam kamera pada resolusi 720p (tiga pasang stereo) pada 60 fps secara bersamaan. Hailo-8 dan Jetson Orin Nano Super/NX dibahas lebih mendalam dalam artikel perbandingan SBC, jadi tulisan ini membatasi diri pada entri tabel di atas untuk menghindari pengulangan.
Jajaran Coral juga mencakup Dev Board Micro, turunan terbaru dari USB Accelerator yang tercantum di atas. Alih-alih prosesor aplikasi yang mampu menjalankan Linux, ia memasangkan koprosesor Edge TPU dengan papan kelas mikrokontroler (MCU) berdaya rendah yang selalu aktif, yang ditujukan langsung untuk kasus penggunaan TinyML bertenaga baterai seperti deteksi suara atau getaran yang selalu aktif. Di mana Dev Board/USB Accelerator memasangkan SoC tujuan umum dengan Edge TPU eksternal, Dev Board Micro menargetkan kasus penggunaan yang sama sekali berbeda: pemicu deteksi yang selalu aktif.
Sejarah: filosofi desain VPU yang lahir dari akuisisi Movidius oleh Intel
Movidius adalah perusahaan yang berbasis di San Mateo Perusahaan rintisan yang merancang chip hemat daya khusus untuk pemrosesan visi komputer, diakuisisi oleh Intel pada September 2016. Sebelum akuisisi, Myriad 2 VPU (Vision Processing Unit) tidak memiliki desain seperti CPU serbaguna; sebaliknya, ia menggabungkan blok perangkat keras visi komputer khusus dengan 12 inti prosesor vektor yang dirancang khusus (SHAVE), dan setelah akuisisi, ia terus dipasarkan dalam perangkat produksi termasuk kamera perekam kehidupan Google "Clips," kamera pencitraan termal FLIR "Firefly," drone DJI "Phantom 4," dan Tencent "DeepGaze." Penerusnya, Myriad X, diumumkan pada tahun 2017, memperluas jumlah inti SHAVE menjadi 16 dan menambahkan — untuk pertama kalinya — blok perangkat keras khusus untuk inferensi jaringan saraf, Neural Compute Engine, mencapai lebih dari 10 kali kinerja Myriad 2 dan puncak lebih dari 1 teraFLOPS. Neural Compute Stick 2 (NCS2) yang disebutkan di atas adalah produk USB-stick yang membawa satu Myriad X, diluncurkan Pada kuartal keempat tahun 2018; halaman spesifikasi produk Intel sendiri sekarang menandainya sebagai "Dihentikan" — sebuah chip VPU yang pernah mewakili masa-masa awal AI edge, setelah menyerahkan pasar kepada ASIC khusus INT8 dan chip terintegrasi GPU yang mengikutinya.
Bersamaan dengan akuisisi ini, Intel merilis versi pertama dari toolkit OpenVINO pada 16 Mei 2018, sebagai tumpukan perangkat lunak yang dimaksudkan untuk menangani kuantisasi dan optimasi grafik secara seragam di seluruh perangkat kerasnya sendiri. Komponen NNCF (Neural Network Compression Framework) OpenVINO menangani kuantisasi INT8 dan kompresi model, dan dirancang untuk mengoptimalkan dan menerapkan model melalui alur kerja tunggal yang mencakup tidak hanya VPU keluarga Movidius tetapi juga CPU Intel dan GPU terintegrasi — fakta bahwa ia bertahan sebagai toolchain daripada terikat pada satu chip akselerator menggambarkan salah satu strategi bertahan hidup di bidang di mana generasi perangkat keras berganti dengan cepat.
Sejarah: Edge TPU, penerus garis keturunan TPU pusat data
Edge TPU di dalam Google Produk Coral adalah desain yang memperkecil skala, untuk perangkat tertanam dengan keterbatasan daya, arsitektur komputasi "array sistolik" yang sama yang dibangun Google untuk TPU (Tensor Processing Unit) kelas pusat datanya. Array sistolik mengatur sejumlah besar unit perkalian-akumulasi dalam sebuah grid dan mengalirkan data dalam satu arah, hanya meneruskannya antar unit yang berdekatan — tidak seperti CPU tujuan umum, yang harus mengakses register dan memori untuk setiap instruksi, ini memungkinkannya untuk memproses perkalian matriks besar dengan efisiensi energi yang sangat tinggi. TPU pusat data Google membangun grid ini dalam skala yang sangat besar, memasang beberapa chip pada papan yang dilengkapi dengan penyebar panas tembaga berpendingin cairan (foto di bawah, yang dirilis oleh Google, menunjukkan papan TPU v3 dengan empat chip yang terlihat terhubung oleh tabung pendingin cairan). Edge TPU mempertahankan ide dasar yang sama tetapi mengecilkan grid secara drastis dan mengurangi konsumsi daya hingga watt satu digit, sehingga dapat berjalan dalam anggaran daya bus USB atau slot M.2.
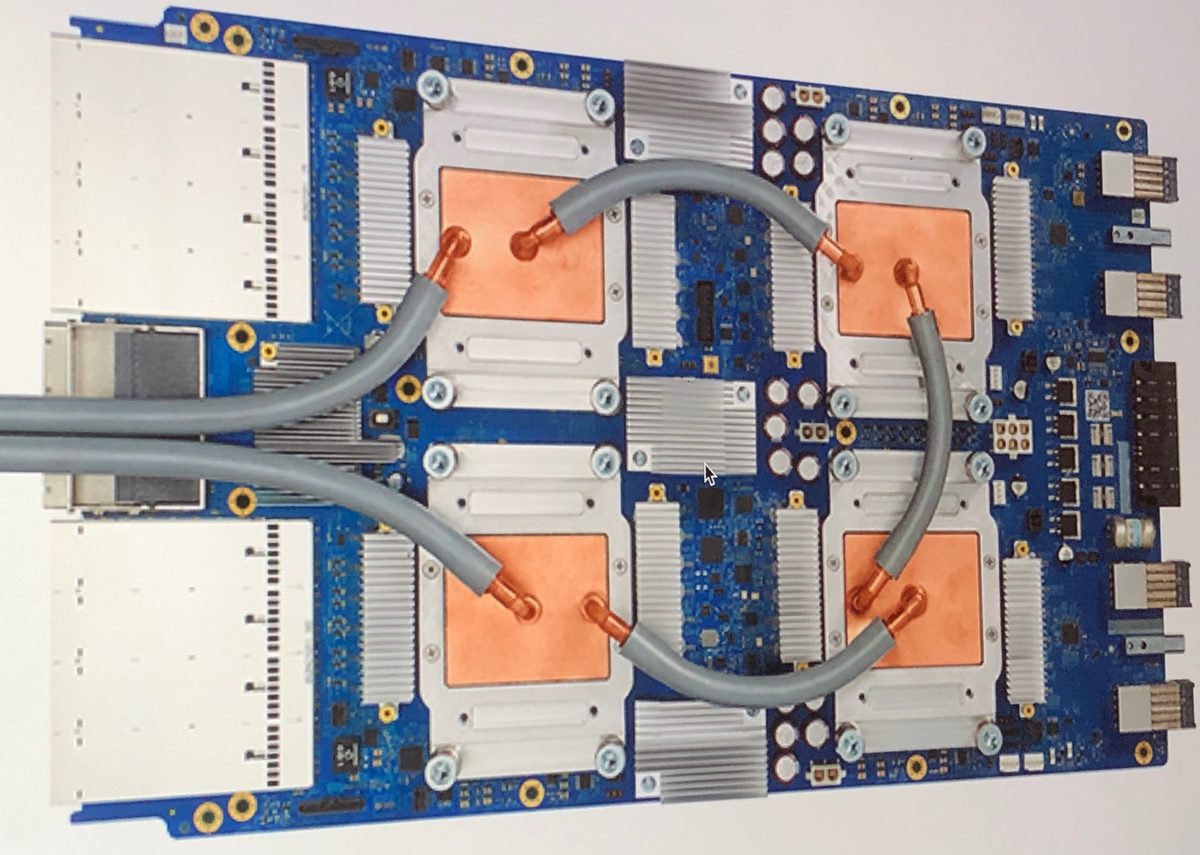
Gambar: Tensor Processing Unit 3.0(Zinskauf, CC BY-SA 4.0), Wikimedia Commons. Foto papan TPU v3 kelas pusat data — bukan Edge TPU itu sendiri, tetapi referensi yang menunjukkan skala "induk" pusat data yang memiliki pendekatan array sistolik yang sama.

Pada tahun 2019, Google meluncurkan Dev Board dan USB Accelerator yang membawa Edge TPU ini (4 TOPS, 2W), dan menarik perhatian sebagai akselerator tambahan untuk SBC yang ada seperti Raspberry Pi, didukung oleh inferensi hemat daya yang dapat menjalankan MobileNet v2 sekitar 400 frame per detik. Namun sejak itu, Google secara efektif berhenti berinvestasi dalam lini produk tanpa mengirimkan perangkat keras baru yang signifikan, dan pada tahun 2026 situs resmi coral.ai mengalihkan ke Halaman Pengembang Google generik. Alasan produk Coral belum sepenuhnya ditinggalkan meskipun demikian adalah karena Google merilis driver dan firmware sebagai sumber terbuka, memungkinkan proyek komunitas seperti perangkat lunak pengawasan deteksi objek Frigate NVR untuk mendapatkan dukungan dan menjaga perangkat keras tetap aktif dalam produksi (dirinci lebih lanjut dalam artikel perbandingan SBC).
Contoh dunia nyata: sembilan jaringan saraf berjalan secara bersamaan pada satu Jetson TX2 di atas drone Skydio X2
Contoh utama dari satu chip akselerator yang menjalankan beberapa jaringan saraf secara paralel adalah drone terbang otonom Skydio X2/X2D. X2 membawa NVIDIA Tegra X2 — SoC yang sama yang ditemukan di Jetson TX2 — sebagai chip komputasi utamanya, memproses umpan dari enam kamera onboard (tiga pasang stereo, konfigurasi trinokular) untuk menjalankan sembilan jaringan saraf dalam yang dirancang khusus secara bersamaan, sepenuhnya di dalam pesawat. Dengan menggunakan output inferensi ini, ia dapat melacak hingga 20 objek yang diminati secara bersamaan — rintangan, subjek seperti orang atau kendaraan — sambil membangun model dunia 3D yang diperbarui dengan kecepatan melebihi satu juta titik per detik, dan loop keputusan yang mengubah model dunia tersebut menjadi perintah penerbangan berjalan dengan kecepatan 500 Hz. Alasan mengapa drone ini dapat terbang cepat melalui hutan lebat atau ruang dalam ruangan menghindari rintangan tanpa bergantung pada GPS adalah karena seluruh alur kerja ini diselesaikan pada satu Tegra X2 di dalam pesawat, alih-alih dialihkan ke cloud.
 Skydio X2D memeriksa KC-10 Extender (Pangkalan Angkatan Udara Dover)
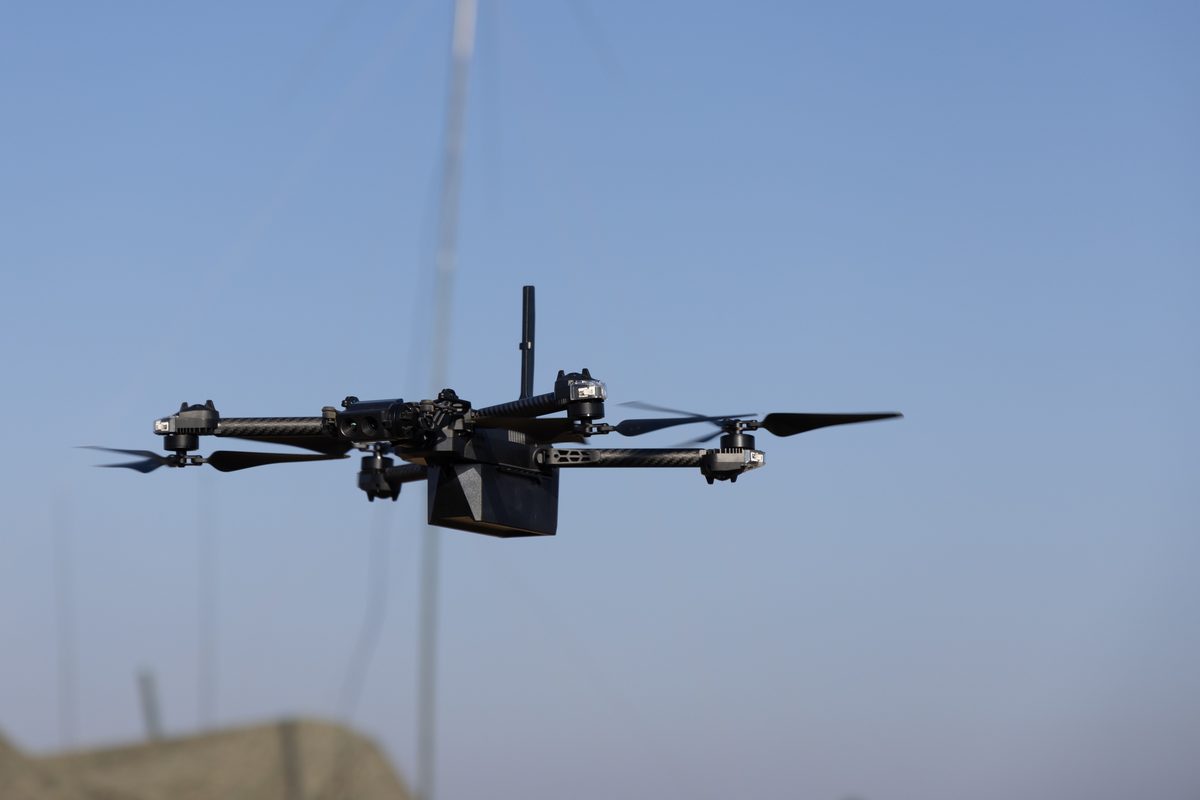 Sebuah Skydio X2D terbang selama pelatihan (Camp Schwab, Okinawa)
Gambar: Skydio X2D memeriksa pesawat(Mauricio Campino, Domain publik) / Marinir AS Berlatih Operasi UAS (9269101)(Domain publik, Korps Marinir AS), keduanya melalui Wikimedia Commons.

.jpg)
Penamaan X2D mengacu pada varian Departemen Pertahanan, dan penempatan nyata yang tercatat dalam foto-foto Departemen Pertahanan AS yang dirilis secara publik termasuk Grup Generasi Misi ke-436 di Pangkalan Angkatan Udara Dover, Delaware, menggunakan X2D untuk memeriksa integritas struktural pesawat pengisian bahan bakar udara KC-10 Extender (November 2022), serta Kompi Penghubung Tembakan Udara-Angkatan Laut ke-5 (5th ANGLICO) yang berlatih di Camp Schwab, Okinawa, dan Divisi Gunung ke-10 yang berlatih di Area Latihan Hohenfels di Jerman, keduanya mengoperasikan Skydio X2D sebagai sistem pesawat tanpa awak kecil (sUAS). Penerusnya, X10, beralih dari Tegra X2 ke SoC generasi Jetson Orin dan meningkatkan kamera navigasinya menjadi 32 megapiksel — ilustrasi yang baik tentang bagaimana peningkatan TOPS per chip di berbagai generasi secara langsung menghasilkan keuntungan operasional nyata: lebih banyak jaringan saraf yang berjalan secara bersamaan di dalam pesawat, lebih banyak objek yang dilacak secara bersamaan, dan loop pengambilan keputusan dengan frekuensi lebih tinggi.
Dari "perangkat AI" hobiis hingga batas pelatihan di perangkat
Akselerator terintegrasi GPU yang dulunya berpusat pada aplikasi robotika dan pertahanan, pada tahun 2026, telah mulai menjangkau pengembang individu dan skala kecil juga. "ClawBox," yang dibangun oleh ID Robots dari Bulgaria, adalah perangkat keras asisten AI yang membawa NVIDIA Jetson Orin Nano, ditempatkan dalam wadah seukuran telapak tangan dengan kipas pendingin dan ventilasi samping — menggunakan kembali, apa adanya, SoM yang awalnya dirancang untuk beban kerja robotika. Fakta bahwa chip yang dirancang untuk menjadi "otak" drone atau robot industri dapat langsung dimasukkan ke dalam produk yang dikirim dalam jumlah ratusan atau ribuan unit, yang dibuat oleh perusahaan rintisan kecil, menggarisbawahi kekuatan generalitas akselerator terintegrasi GPU — tidak seperti ASIC khusus, mereka dapat menjalankan model CUDA apa pun apa adanya.
Tren kedua yang terkait adalah penelitian yang mendorong apa yang dulunya merupakan akselerator tepi yang hanya berfokus pada inferensi menuju pelatihan di perangkat — melatih ulang model langsung di perangkat. Sebuah makalah yang diterbitkan pada Juli 2026, "Memberdayakan Adaptasi Model di Perangkat dengan Akselerator Inferensi AI Edge" (Piechocki, Capotondi, Kraft, arXiv:2607.18101), mengusulkan sebuah pipeline menggunakan Hailo-8L (saudara kandung tingkat bawah dari Hailo-8 yang dibahas di atas) yang memisahkan pekerjaan inferensi dan pelatihan di berbagai chip: inferensi backbone terkuantisasi berjalan di Hailo-8L, sementara hanya lapisan akhir yang ringan yang disempurnakan secara bertahap dalam FP32 pada CPU. Makalah tersebut melaporkan peningkatan kecepatan hingga 15,4x untuk pelatihan di perangkat dibandingkan dengan Raspberry Pi 5 saja — sekilas tentang bidang penelitian di mana premis "hanya inferensi" mulai terkikis, dibangun di atas tumpukan teknologi yang sama yaitu kuantisasi dan kompilasi grafik.
Parameter yang menentukan kinerja
- Efisiensi TOPS/W versus fleksibilitas presisi: Coral Edge TPU sangat efisien dengan 2 TOPS/W, tetapi hal itu disertai dengan batasan hanya menjalankan grafik tetap yang telah dikuantisasi ke INT8. Jetson Orin NX, sebaliknya, dapat menjalankan model CUDA sembarang dalam campuran FP16/INT8, dengan biaya yang lebih rendah daripada TOPS/W Coral. Seberapa besar fleksibilitas yang dapat dikorbankan oleh suatu proyek biasanya menjadi pertimbangan pertama dalam pemilihan chip.
- Ketelitian kompiler: Kompiler grafik tetap sepenuhnya seperti Coral Edge TPU Compiler, yang tidak mengizinkan operator yang tidak didukung sama sekali, memaksa desain model untuk dibatasi pada operator yang didukung sejak awal. Compiler dengan offload parsial seperti TensorRT/OpenVINO menawarkan fleksibilitas porting yang lebih besar, tetapi mudah untuk mengabaikan penalti kecepatan yang muncul ketika fallback CPU dipicu.
- Pilihan metode kuantisasi (PTQ vs. QAT): PTQ, yang hanya membutuhkan sedikit data representatif, murah untuk dikembangkan tetapi rentan terhadap kehilangan akurasi yang lebih besar pada model dengan banyak outlier. QAT membutuhkan pelatihan ulang tetapi menekan degradasi tersebut. VPU dari generasi Movidius Myriad X, yang dibangun terutama di sekitar FP16, sepenuhnya menghindari upaya kalibrasi kuantisasi berdasarkan desainnya.
- Bandwidth antarmuka: Perangkat yang terhubung melalui USB seperti Coral USB Accelerator atau NCS2 dapat mengalami hambatan bandwidth bus USB sisi host ketika beberapa unit digabungkan (dirinci dalam kasus Frigate NVR di artikel perbandingan SBC). Perangkat yang terhubung melalui M.2/PCIe seperti Hailo-8, atau Jetson yang terintegrasi dengan SoM, kurang rentan terhadap kendala ini.
- Kontinuitas pasokan dan peta jalan: Movidius NCS2 dari Intel secara eksplisit ditandai "Dihentikan" pada halaman spesifikasinya sendiri, dan situs resmi Coral sekarang mengarahkan ke tempat lain, sementara lini Jetson terus mengirimkan generasi baru. Untuk proyek jangka panjang, kontinuitas pasokan itu sendiri menjadi faktor risiko di luar perbandingan TOPS per dolar sekali pakai.
- Harga-terhadap-kinerja ($/TOPS): Berdasarkan $/TOPS sederhana, Jetson Orin Nano Super ($249/67 TOPS ≈ $3,7/TOPS) dan Jetson Orin NX ($599/100 TOPS ≈ $6/TOPS) mungkin terlihat lebih murah daripada Hailo-8 ($110/26 TOPS ≈ $4,2/TOPS) atau Coral ($75–99/4 TOPS ≈ $19–25/TOPS) — tetapi pilihan akhir tetap bergantung pada keseimbangan terhadap ukuran sasis dan anggaran daya yang sebenarnya dapat ditampung oleh produk tertentu, bukan hanya kinerja mentah dan harga satuan saja.
Apakah dua kali lipat TOPS berarti dua kali lipat kecepatan aplikasi?
Presisi, memori, operator yang didukung, transfer, dan pra-pemrosesan memengaruhi kecepatan. Ukur latensi ujung-ke-ujung pada model sebenarnya.
Referensi
- Kerangka Kerja Kompresi Jaringan Saraf (NNCF) — OpenVINO resmi
- OpenVINO (Wikipedia)
- Intel Neural Compute Stick 2 — Spesifikasi Produk (Intel resmi)
- Ulasan: Intel Neural Compute Stick 2 untuk Edge AI (viso.ai)
- Intel akan mengakuisisi perusahaan visi komputer Movidius (Road to VR)
- Intel mengumumkan Movidius Myriad X (Notebookcheck)
- Google Coral Edge TPU / Dev Board — CNX Software
- Papan Pengembangan Coral TPU (NXP)
- Arsitektur sistem Cloud TPU (resmi Google Cloud)
- Ulasan Modul NVIDIA Jetson Orin NX 16GB (ThinkRobotics)
- Lembar Data Seri NVIDIA Jetson Orin NX (Pengembang NVIDIA)
- Kit Pengembang Super Jetson Orin Nano (resmi NVIDIA)
- Sorotan Inception: Drone Skydio 2 yang Didukung oleh NVIDIA Jetson (Blog Teknis NVIDIA)
- Perbandingan Skydio X10 vs X2 (THE FUTURE 3D) )
- Memberdayakan Adaptasi Model di Perangkat dengan Akselerator Inferensi Edge AI (arXiv:2607.18101)
- Inferensi LLM Berkelanjutan untuk Edge AI (arXiv:2504.03360)
- Hardware PXL 20231201 152957218 (53388218926) — Wikimedia Commons
- Tensor Processing Unit 3.0 — Wikimedia Commons
- Perangkat asisten AI ClawBox (2026) - depan — Wikimedia Commons
- [Skydio X2D memeriksa pesawat terbang — Wikimedia Commons
- Marinir AS Berlatih Operasi UAS (9269101) — Wikimedia Commons


Komentar
Silakan masuk terlebih dahulu.
Belum ada data.