Contents — find the section you need
Un accélérateur d'inférence IA est une puce conçue spécifiquement pour exécuter la phase d'inférence d'un réseau neuronal entraîné (le calcul direct uniquement) avec une efficacité énergétique bien supérieure à celle d'un CPU ou d'un GPU. Le principe physique de base est simple : la conversion des poids entraînés en virgule flottante 32 bits (FP32) en une représentation de plus faible précision, comme les entiers 8 bits (INT8) (la quantification), permet aux mêmes unités de calcul et à la même bande passante mémoire d'effectuer un nombre beaucoup plus important d'opérations parallèles. Cet article ne compare pas les SBC (ordinateurs monocartes) en tant que systèmes complets ; il se concentre plutôt sur la philosophie de conception et le principe de quantification des puces d'accélération dédiées exclusivement à l'inférence : Google Coral (Edge TPU), Intel Movidius (Myriad X) et NVIDIA Jetson Orin NX.
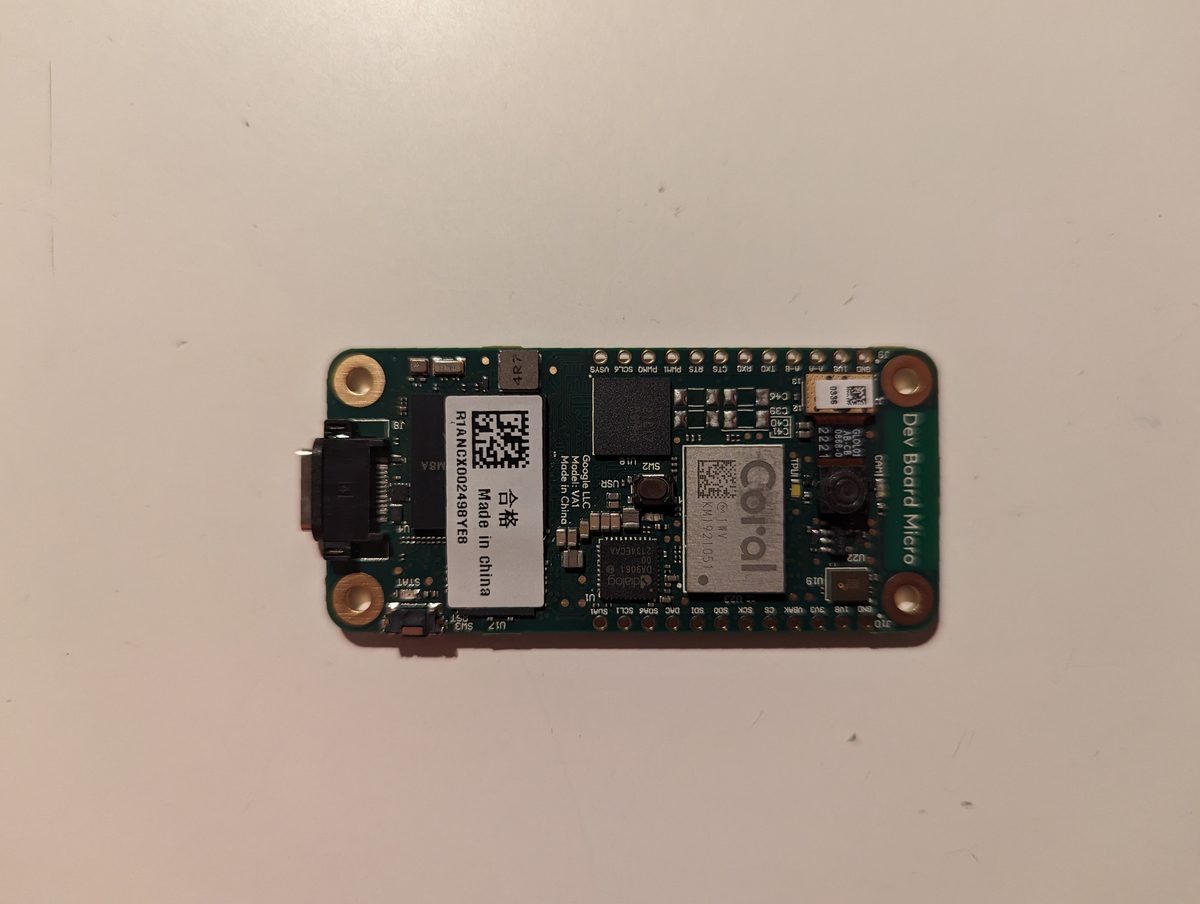 Carte de développement Google Coral Micro
 "ClawBox", basé sur un NVIDIA Jetson Orin Nano (2026, ID Robots)
Images : Hardware PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA 2.0) / ClawBox, assistant IA (2026) - face (Kkralev, CC BY-SA 4.0), tous deux via Wikimedia Commons.
.jpg)
_-_front.jpg)
Principe : fonctionnement de la quantification INT8
La méthode la plus courante pour convertir les poids et activations FP32 en entiers 8 bits est la quantification linéaire (affine). La formule de conversion d’une valeur réelle x en un entier q est :
Ici, s représente l’échelle (la largeur réelle d’un pas entier), z le point zéro (le décalage indiquant quel pas entier correspond à zéro réel) et b la largeur en bits (8 pour INT8). Lors de l’inférence, la valeur est approximativement récupérée sous la forme x \approx s(q-z). En pratique, cette quantification signifie que la précision avec laquelle la distribution des valeurs est délimitée détermine directement la perte de précision. Avec 256 pas (INT8), une plage de valeurs étroite maintient la largeur de chaque pas (l'erreur de quantification) faible ; une plage élargie par des valeurs aberrantes réduit la taille des 256 pas, ce qui dégrade la représentation des valeurs typiques qui constituent la majeure partie de la distribution.
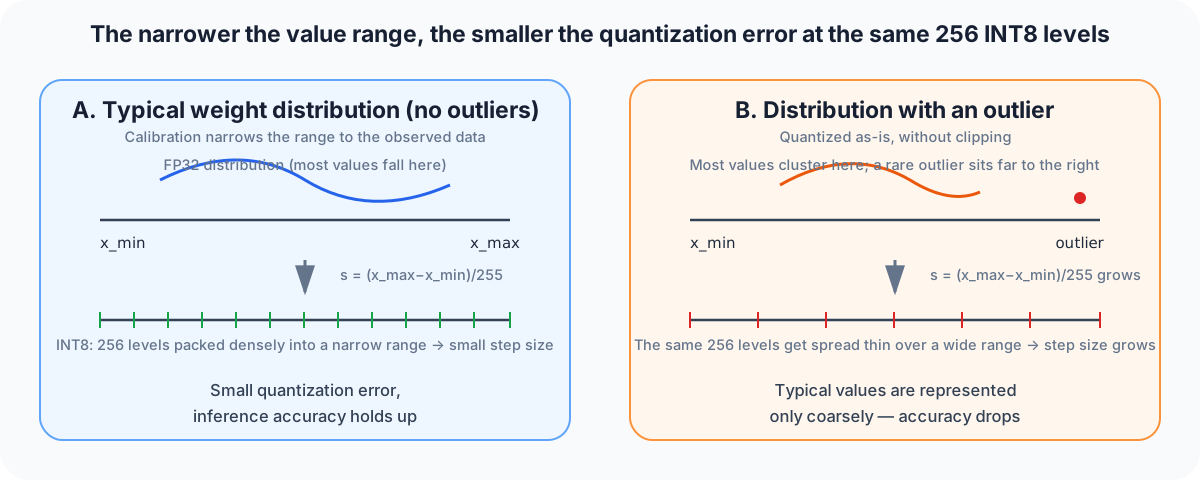
Diagramme : Duskcoil. Illustre comment la présence ou l'absence d'« étalonnage » (définition de la plage de valeurs à l'aide de données mesurées réelles) affecte significativement l'erreur de quantification, même à largeur de bits identique.
La définition de cette plage de valeurs constitue l'étape d'étalonnage, et la quantification suit globalement deux approches. Quantification post-entraînement (PTQ) consiste simplement à traiter un petit volume de données représentatives avec le modèle FP32 entraîné et à calculer l'échelle s à partir de la plage de sortie observée de chaque couche. Cette approche légère est toutefois susceptible d'entraîner une perte de précision plus importante sur les modèles comportant de nombreuses valeurs aberrantes. Entraînement prenant en compte la quantification (QAT) simule l'erreur d'arrondi introduite par la quantification lors de l'entraînement. L'entraînement s'effectue automatiquement, avec une mise à jour des poids en conséquence ; cela limite la dégradation de la précision au prix d'une nouvelle passe d'entraînement. Le compilateur Edge TPU, TensorRT et OpenVINO prennent en charge les deux approches, mais comme la plupart des puces d'inférence embarquées indiquent leurs performances (TOPS) en supposant une précision INT8, le choix pratique consiste à déterminer si PTQ offre une précision suffisante ou s'il est nécessaire de passer à QAT.
Il y a aussi une autre difficulté : les VPU (unités de traitement de la vision) conçues vers 2017, comme la Movidius Myriad X, utilisaient la virgule flottante demi-précision (FP16) plutôt que l'INT8 comme précision de calcul principale. La FP16 réduit de moitié l'empreinte mémoire et la bande passante requise par rapport à la FP32 tout en représentant une large plage dynamique sans nécessiter d'étalonnage de plage comme avec l'INT8, grâce à la conservation du champ d'exposants. Elle n'atteint cependant pas le même parallélisme que l'INT8, ce qui explique notamment pourquoi les Coral Edge TPU et les cœurs Tensor de Jetson, plus récents, sont basés sur cette précision. Chemins de données dédiés INT8 en premier, performances TOPS/W plusieurs fois supérieures.
Principe : le compilateur de graphes comme second axe d'accélération de l'inférence
Outre la quantification, le format de compilation d'un modèle entraîné pour le jeu d'instructions d'une puce donnée est l'autre facteur majeur du débit réel. Un modèle exporté de TensorFlow Lite ou ONNX est, en soi, un graphe générique exécuté couche par couche séquentiellement sur un processeur. Le compilateur de chaque fournisseur applique généralement trois types d'optimisation à ce graphe.
-
Fusion d'opérateurs : Une séquence telle que Convolution→BatchNorm→ReLU est fusionnée en un seul noyau, conservant les résultats intermédiaires dans les registres plutôt que de les réécrire en mémoire, ce qui réduit le nombre d'accès mémoire.
-
Transformation de l'agencement : L'agencement NCHW (canal en premier), privilégié par le processeur, et l'agencement NHWC (canal en dernier), privilégié par l'unité vectorielle, sont réorganisés pour correspondre au schéma d'accès mémoire réel du matériel cible.
-
Compilation vers un graphe fixe : Certains compilateurs, comme le compilateur Coral Edge TPU, n'acceptent qu'un graphe entièrement fixe, construit exclusivement à partir d'opérateurs pris en charge, interdisant d'emblée les formes dynamiques ou les opérations non prises en charge. Si un seul opérateur non pris en charge apparaît dans le modèle, l'exécution est répartie entre le CPU et l'Edge TPU environnant, et le coût de transfert de données bidirectionnel qui en résulte peut considérablement réduire la vitesse.
TensorRT de NVIDIA et OpenVINO d'Intel adoptent une approche de « déchargement partiel » plus flexible : les opérateurs non pris en charge sont réexécutés par le CPU tandis que le reste est déchargé sur l'accélérateur. Le compilateur Coral Edge TPU, quant à lui, propose un choix plus binaire : soit un graphe entièrement pris en charge, soit aucune accélération. Cette distinction n'apparaît pas dans les métriques matérielles, comme les compromis TOPS/bande passante mémoire abordés dans l'article de comparaison des SBC ; il s'agit d'une différence dans la philosophie de conception de la pile logicielle. Cela affecte considérablement le coût réel du portage d'un modèle.
Comparaison des principales puces : Coral, Movidius, Jetson
| Produit | Précision | Performances IA | Consommation | Interface | Prix |
|---|---|---|---|---|---|
| Google Coral Edge TPU (accélérateur USB) | INT8 uniquement | 4 TOPS (2 TOPS/W) | 2 W | USB 3.0 | ~75–99 $ (lancement en 2019) |
| Intel Movidius Myriad X (Neural Compute Stick 2) | Principalement FP16 | ~4 TOPS équivalent (chiffre non publié officiellement) | ~1,5–2,5 W | USB 3.0 | ~79–99 $ (lancement en 2018, désormais abandonné) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10,4 TOPS/W) | ~2,5 W | M.2/PCIe | ~110 $ |
| NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (mode MAXN Super) | 7–25 W | SoM (module intégré) | 249 $ |
| NVIDIA Jetson Orin NX (16 Go) | INT8 | 100 TOPS | 10–25 W | SoM (module intégré) | 599 $ |
La page de spécifications officielle du Movidius Myriad X d'Intel n'indique pas de valeur TOPS précise, mais plusieurs tests décrivent une capacité de « plus de 4 billions d'opérations par seconde » au total. Intel affirme d'ailleurs que le Myriad X est plus de 10 fois plus rapide que le Myriad 2 (100–150 GFLOPS). L'association de 16 cœurs de processeur vectoriel SHAVE programmables et du Neural Compute Engine (un bloc dédié inauguré avec le Myriad X) a été conçue pour traiter simultanément le flux de six caméras en 720p (trois paires stéréo) à 60 images par seconde. Hailo-8 et Les Jetson Orin Nano Super/NX sont traités plus en détail dans l'article de comparaison des SBC (SoC-Bucket-Based Processing) article de comparaison des SBC. Cet article se limite donc aux entrées du tableau ci-dessus afin d'éviter les répétitions.
La gamme Coral comprend également la Dev Board Micro, une version plus récente de l'accélérateur USB mentionnée précédemment. Au lieu d'un processeur d'applications compatible Linux, elle associe le coprocesseur Edge TPU à une carte de type microcontrôleur (MCU) basse consommation toujours active, conçue spécifiquement pour les cas d'utilisation TinyML alimentés par batterie, tels que l'écoute vocale permanente ou la détection de vibrations. Alors que la Dev Board/accélérateur USB associe un SoC à usage général à un Edge TPU externe, la Dev Board Micro vise un cas d'utilisation totalement différent : un déclencheur de détection toujours actif.
Historique : une philosophie de conception VPU née de l'acquisition de Movidius par Intel
Movidius était une start-up basée à San Mateo, spécialisée dans la conception de puces basse consommation pour le traitement de la vision par ordinateur. Elle a été acquise par Intel en septembre 2016. Avant son acquisition… Le VPU Myriad 2 (unité de traitement de la vision) ne possédait pas une conception de type CPU généraliste ; il combinait des blocs matériels dédiés à la vision par ordinateur avec 12 cœurs de processeur vectoriel (SHAVE) conçus sur mesure. Après son acquisition, il a été intégré à des appareils de production tels que la caméra de suivi de vie « Clips » de Google, la caméra thermique « Firefly » de FLIR, le drone « Phantom 4 » de DJI et « DeepGaze » de Tencent. Son successeur, le Myriad X, a été annoncé en 2017, portant le nombre de cœurs SHAVE à 16 et ajoutant – pour la première fois – un bloc matériel dédié à l’inférence des réseaux neuronaux, le Neural Compute Engine, atteignant des performances plus de 10 fois supérieures à celles du Myriad 2 et une puissance de calcul de pointe supérieure à 1 téraFLOPS. Le Neural Compute Stick 2 (NCS2) mentionné précédemment est une clé USB contenant un seul Myriad X, lancée au quatrième trimestre 2018 ; la page de spécifications produit d’Intel indique désormais qu’il est « abandonné » – une puce VPU qui fut jadis… Cette acquisition a marqué les débuts de l'IA en périphérie, avant de céder le marché aux ASIC dédiés à l'architecture INT8 et aux puces intégrant GPU qui ont suivi.
Parallèlement à cette acquisition, Intel a lancé la première version de son kit d'outils OpenVINO le 16 mai 2018. Cette suite logicielle est conçue pour gérer la quantification et l'optimisation des graphes de manière uniforme sur son propre matériel. Le composant NNCF (Neural Network Compression Framework) d'OpenVINO gère la quantification INT8 et la compression des modèles. Il a été conçu pour optimiser et déployer des modèles via un flux de travail unique, compatible non seulement avec les VPU de la famille Movidius, mais aussi avec les CPU Intel et les GPU intégrés. Le fait qu'il ait perduré en tant que chaîne d'outils plutôt que d'être lié à une seule puce d'accélération illustre une stratégie de survie dans un secteur où les générations de matériel se succèdent rapidement.
Historique : Edge TPU, héritier de la lignée des TPU pour centres de données
L'Edge TPU intégré aux produits Google Coral est une conception qui adapte, pour les appareils embarqués à faible consommation, l'architecture de calcul « systolic array » que Google a développée pour ses systèmes embarqués. TPU (Tensor Processing Unit) de classe centre de données. Un réseau systolique organise un grand nombre d'unités de multiplication-accumulation en grille et transmet les données dans une seule direction, uniquement entre unités adjacentes. Contrairement à un processeur classique, qui doit accéder aux registres et à la mémoire pour chaque instruction, cela lui permet d'effectuer des multiplications matricielles complexes avec une efficacité énergétique extrêmement élevée. Les TPU des centres de données de Google construisent cette grille à très grande échelle, en montant plusieurs puces sur une carte équipée de dissipateurs thermiques en cuivre refroidis par liquide (la photo ci-dessous, publiée par Google, montre une carte TPU v3 avec quatre puces visiblement reliées par des tubes de refroidissement liquide). L'Edge TPU conserve cette même idée de base, mais réduit considérablement la taille de la grille et la consommation d'énergie à quelques watts seulement, ce qui lui permet de fonctionner dans les limites de consommation d'un bus USB ou d'un emplacement M.2.
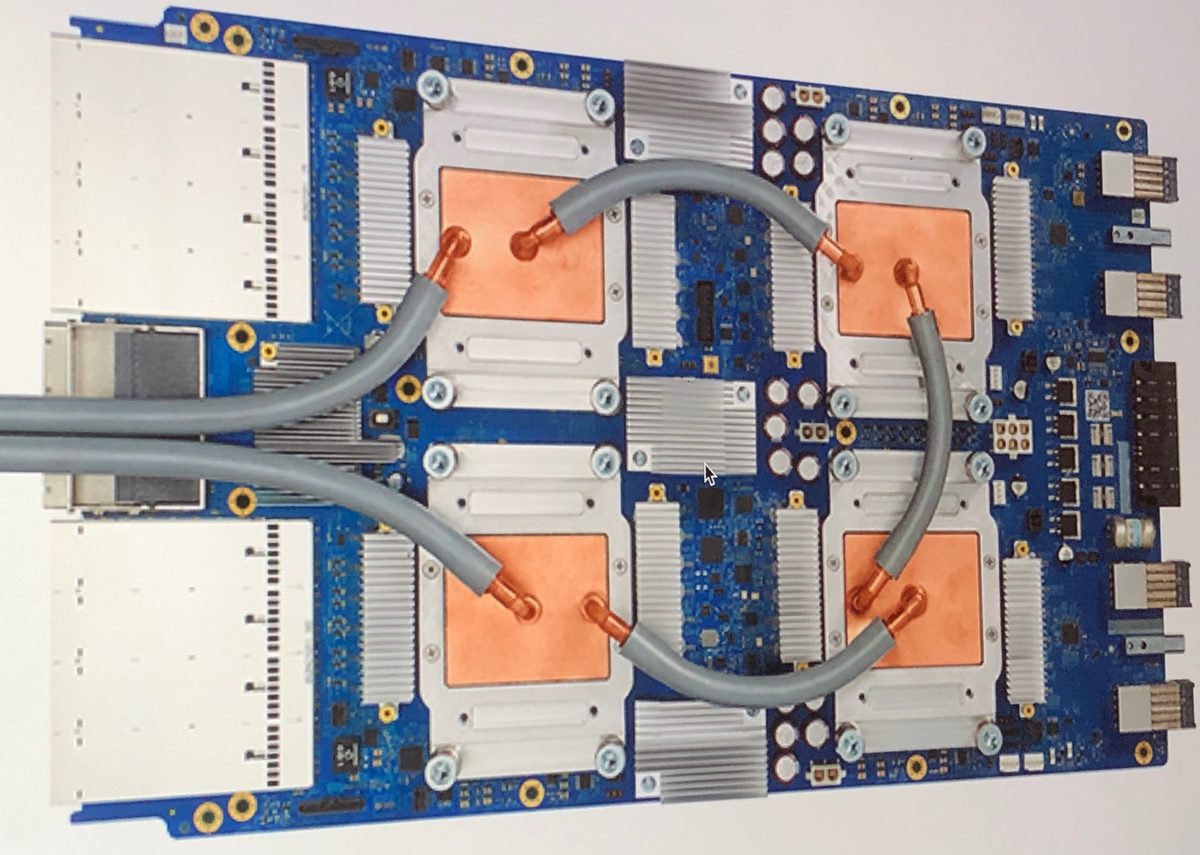
Image : Tensor Processing Unit 3.0 (Zinskauf, CC BY-SA 4.0), Wikimedia Commons. Photo de la carte TPU v3 de classe centre de données — il ne s'agit pas de l'Edge TPU elle-même, mais d'une référence illustrant l'échelle du « parent » du centre de données qui partage la même approche de réseau systolique.

En 2019, Google a lancé la carte de développement et l'accélérateur USB intégrant cet Edge TPU (4 TOPS, 2 W). Ce dernier a rencontré un certain succès en tant qu'accélérateur additionnel pour les SBC existants comme le Raspberry Pi, grâce à une inférence économe en énergie capable d'exécuter MobileNet v2 à environ 400 images par seconde. Depuis, cependant, Google a pratiquement cessé d'investir dans cette gamme de produits sans commercialiser de nouveau matériel notable, et, depuis 2026, son site officiel coral.ai redirige vers une page Google Developers générique. Si les produits Coral n'ont pas complètement disparu malgré cela, c'est parce que Google a publié les pilotes. Le firmware étant open source, des projets communautaires tels que le logiciel de surveillance à détection d'objets Frigate NVR peuvent bénéficier de son support et assurer la continuité de la production du matériel (voir l'article de comparaison des SBC [en/blog/posts/sensor-sbc.html] pour plus de détails).
Exemple concret : neuf réseaux neuronaux fonctionnant simultanément sur un Jetson TX2 embarqué sur un drone Skydio X2
Le drone autonome Skydio X2/X2D est un exemple éloquent de puce d'accélération unique exécutant plusieurs réseaux neuronaux en parallèle. Le X2 embarque une puce NVIDIA Tegra X2 (le même SoC que celui du Jetson TX2) comme processeur principal. Cette puce traite les flux de six caméras embarquées (trois paires stéréo et une configuration trinoculaire) pour exécuter simultanément neuf réseaux neuronaux profonds personnalisés, entièrement embarqués. Grâce à ces inférences, il peut suivre jusqu'à 20 objets d'intérêt simultanés (obstacles, personnes ou véhicules) tout en construisant un modèle 3D du monde mis à jour à une fréquence supérieure à un million de points par seconde. Deuxièmement, la boucle de décision qui transforme ce modèle du monde en commandes de vol fonctionne à une fréquence de 500 Hz. La raison pour laquelle il peut voler rapidement à travers des forêts denses ou des espaces intérieurs en évitant les obstacles sans dépendre du GPS est que l'ensemble de ce processus est exécuté sur un seul processeur Tegra X2 embarqué, au lieu d'être déporté vers le cloud.
 Skydio X2D inspectant un KC-10 Extender (base aérienne de Dover)
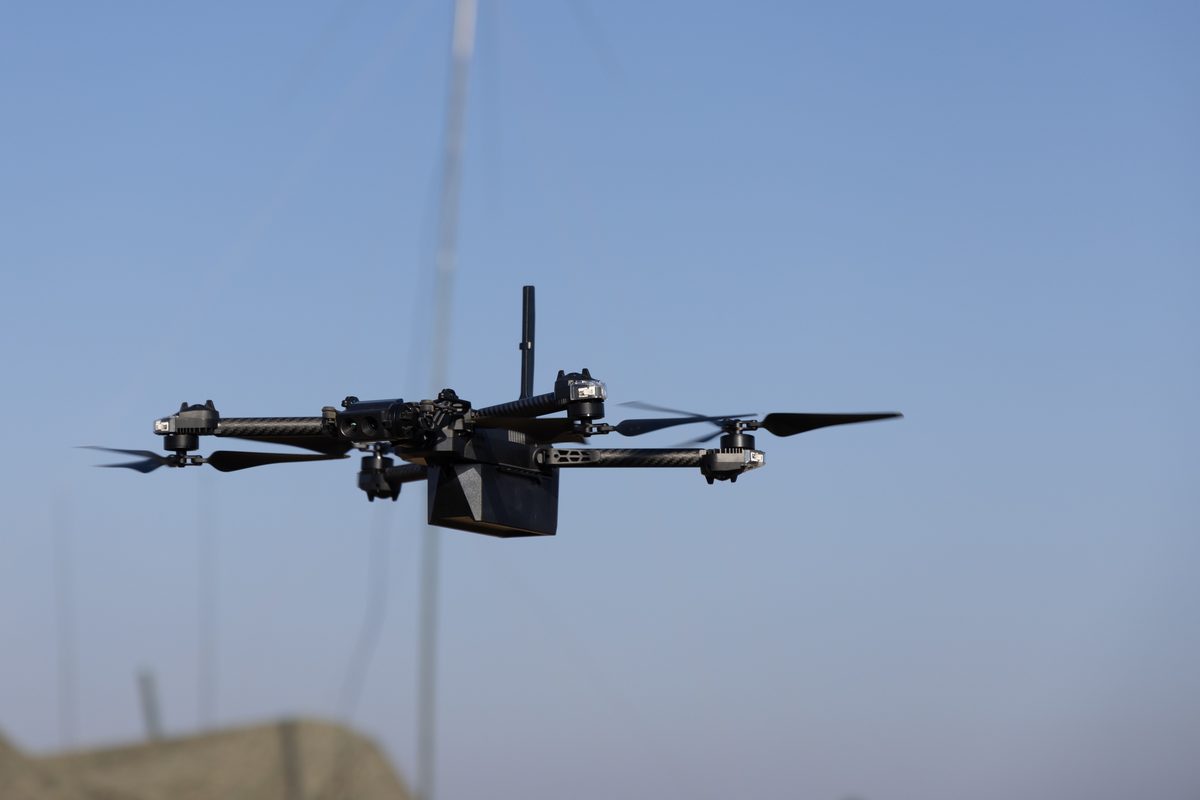
Images : Skydio X2D inspectant un aéronef (Mauricio Campino, domaine public) / U.S. Marines Practice UAS Operations (9269101) (Domaine public, Corps des Marines des États-Unis), toutes deux via Wikimedia Commons.

.jpg)
La désignation X2D fait référence à la version du Département de la Défense. Parmi les déploiements réels documentés par des photos publiques du Département de la Défense américain, on peut citer le 436e Groupe de génération de mission de la base aérienne de Dover, dans le Delaware, utilisant un X2D pour inspecter l'intégrité structurelle d'un avion ravitailleur KC-10 Extender (novembre 2022), ainsi que le 5e escadron de tir aéro-naval. La compagnie de liaison (5e ANGLICO) s'entraîne au camp Schwab, à Okinawa, et la 10e division de montagne s'entraîne au champ de tir de Hohenfels, en Allemagne. Toutes deux utilisent le Skydio X2D comme petit système d'aéronef sans pilote (sUAS). Son successeur, le X10, abandonne le Tegra X2 au profit d'un SoC de génération Jetson Orin et améliore ses caméras de navigation à 32 mégapixels. Ceci illustre parfaitement comment un gain de puissance de calcul par puce (TOPS) d'une génération à l'autre se traduit directement par des gains opérationnels concrets : davantage de réseaux neuronaux fonctionnant simultanément à bord, un plus grand nombre d'objets suivis simultanément et une boucle de décision plus rapide.


Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.