Contents — find the section you need
Un acceleratore di inferenza AI è un chip progettato specificamente per eseguire la fase di "inferenza" di una rete neurale addestrata (solo il calcolo diretto) con un'efficienza energetica di gran lunga superiore a quella di una CPU o GPU. Il principio fisico alla base è semplice: convertire i pesi addestrati in virgola mobile a 32 bit (FP32) in una rappresentazione a precisione inferiore, come gli interi a 8 bit (INT8) (quantizzazione), consente alle stesse unità di calcolo e alla stessa larghezza di banda della memoria di eseguire un numero di operazioni in parallelo di gran lunga superiore. Questo articolo non confronta i computer a scheda singola (SBC) come sistemi completi; si concentra invece sulla filosofia di progettazione e sul principio di quantizzazione alla base dei chip acceleratori dedicati esclusivamente all'inferenza: Google Coral (Edge TPU), Intel Movidius (Myriad X) e NVIDIA Jetson Orin NX.
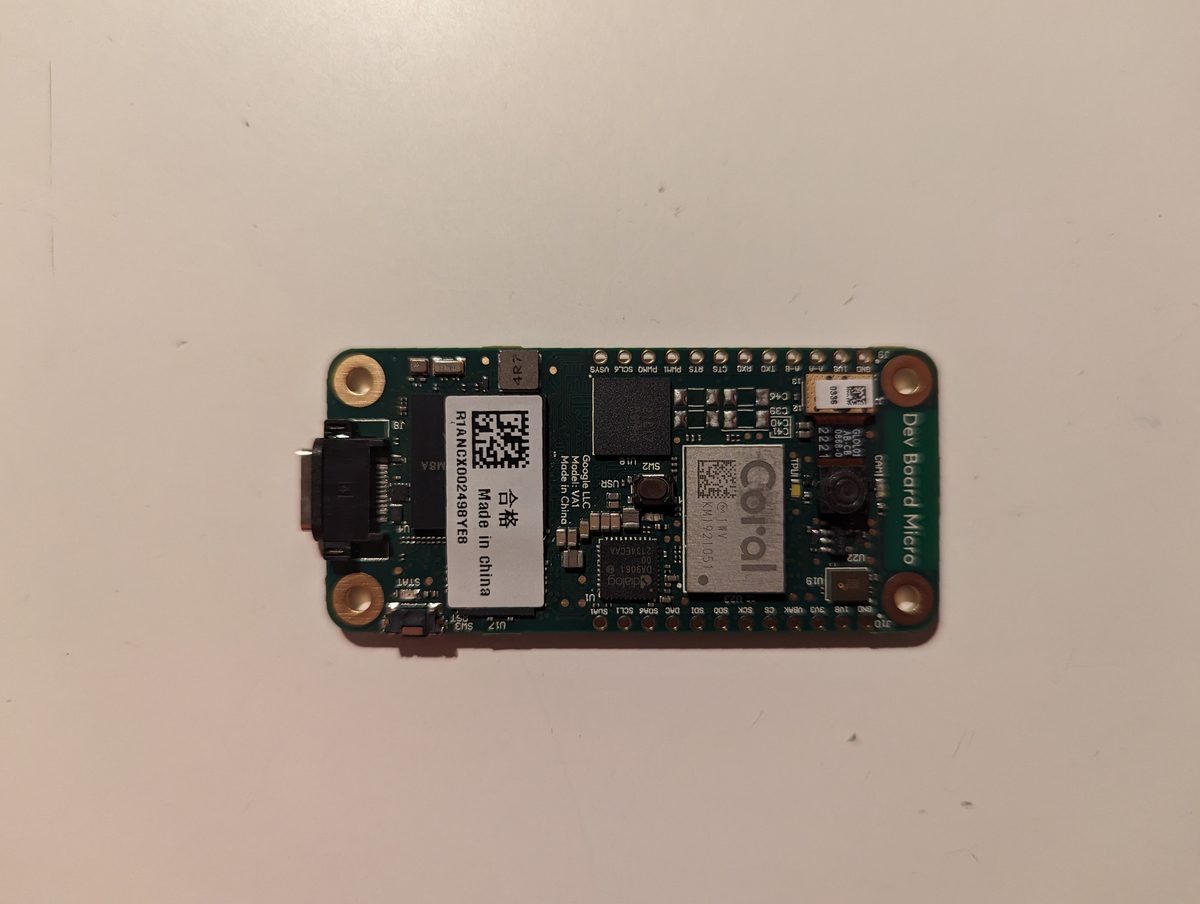 Google Coral Dev Board Micro
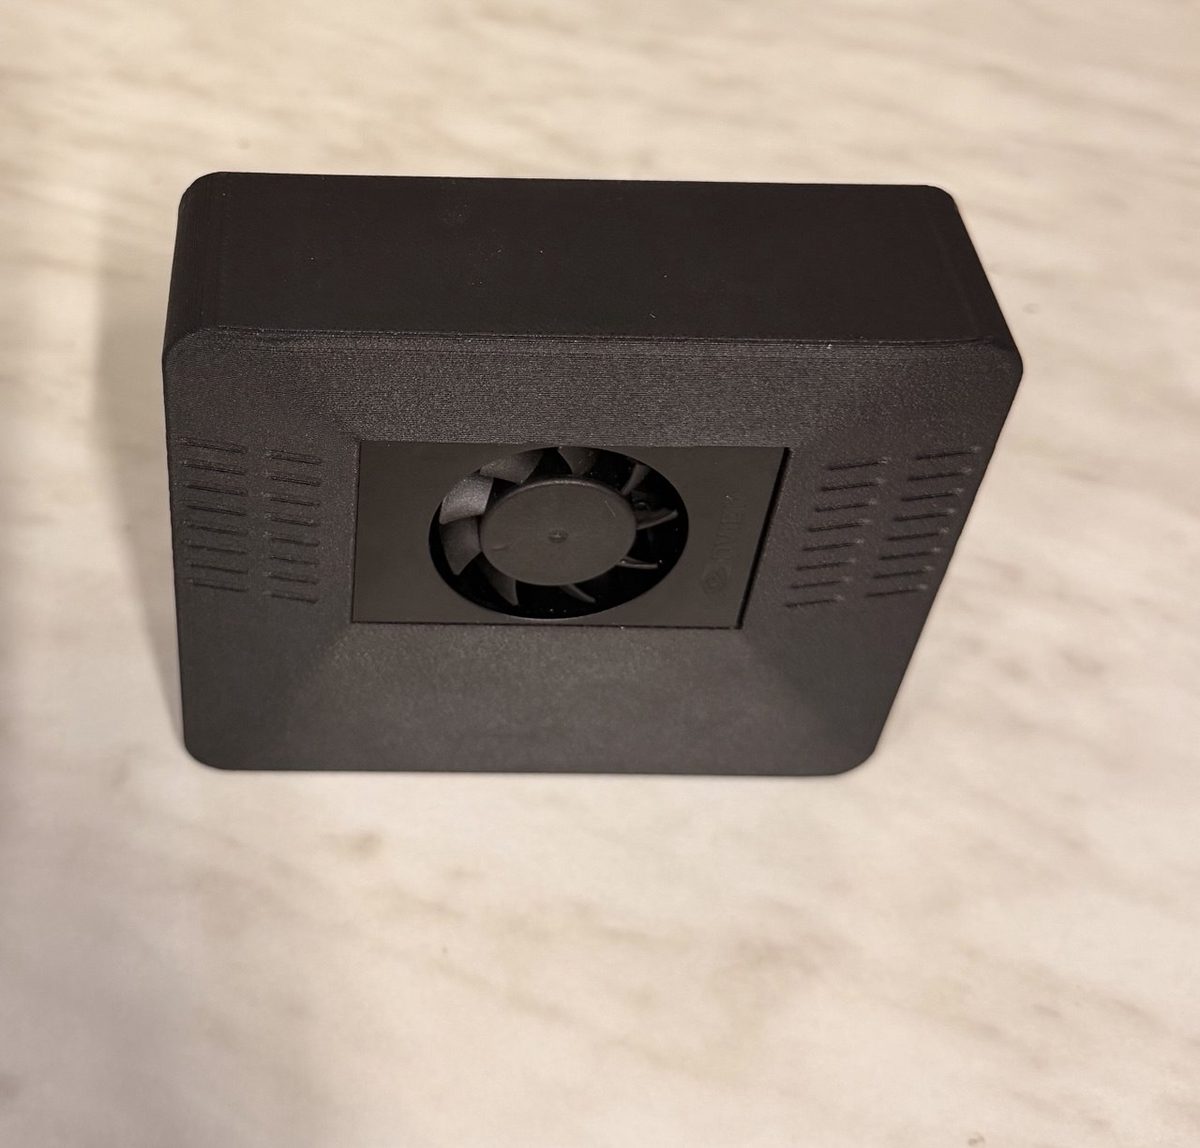 "ClawBox", basato su NVIDIA Jetson Orin Nano (2026, ID Robots)
Immagini: Hardware PXL 20231201 152957218 (53388218926)(Thomas Amberg, CC BY-SA 2.0) / Dispositivo assistente AI ClawBox (2026) - fronte(Kkralev, CC BY-SA 4.0), entrambi tramite Wikimedia Commons.
.jpg)
_-_front.jpg)
Principio: cosa fa effettivamente la quantizzazione INT8
Il metodo più comune per comprimere pesi e attivazioni FP32 in interi a 8 bit è la quantizzazione lineare (affine). La formula che converte un valore reale x in un intero q è:
Qui s è la scala (l'ampiezza reale di un passo intero), z è il punto zero (l'offset che indica quale passo intero corrisponde allo zero reale) e b è la larghezza in bit (8 per INT8). In fase di inferenza, il valore viene approssimativamente recuperato come x \approx s(q-z). In pratica, questa quantizzazione significa che quanto strettamente può essere limitata la distribuzione dei valori determina direttamente quanta precisione viene persa. Con gli stessi 256 passi (INT8), un intervallo di valori ristretto mantiene piccola l'ampiezza di ciascun passo, ovvero l'errore di quantizzazione; Un intervallo ampliato dai valori anomali si restringe di 256 passi, rendendo meno nitida la rappresentazione dei valori tipici che costituiscono la maggior parte della distribuzione.
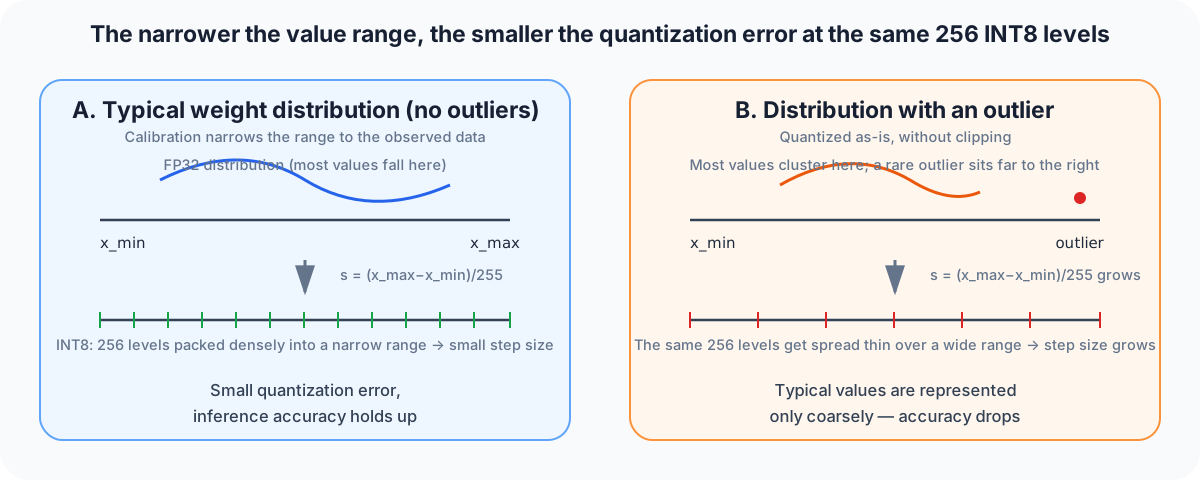
Diagramma: Duskcoil. Illustra come la presenza o l'assenza di "calibrazione" — che delimita l'intervallo di valori utilizzando dati reali misurati — influisca significativamente sull'errore di quantizzazione anche alla stessa larghezza di bit.
La decisione su questo intervallo di valori è la fase di calibrazione e la quantizzazione segue in linea di massima due approcci. La Quantizzazione Post-Training (PTQ) esegue semplicemente una piccola quantità di dati rappresentativi attraverso il modello FP32 addestrato e calcola la scala s dall'intervallo di output osservato di ogni livello: un approccio leggero, ma soggetto a una maggiore perdita di precisione su modelli con molti valori anomali. L'Addestramento Consapevole della Quantizzazione (QAT) simula la L'errore di arrotondamento introdotto dalla quantizzazione durante l'addestramento stesso viene corretto, aggiornando di conseguenza i pesi; questo sopprime il degrado della precisione a costo di un passaggio di riaddestramento. Edge TPU Compiler, TensorRT e OpenVINO supportano entrambi gli approcci, ma poiché la maggior parte dei chip di inferenza edge dichiara le proprie prestazioni di catalogo (TOPS) presupponendo INT8, il dilemma pratico è se PTQ fornisca una precisione sufficiente o se sia necessario passare a QAT.
C'è anche un'ulteriore complicazione: le VPU (Vision Processing Unit) progettate intorno al 2017, come la Movidius Myriad X, utilizzavano FP16 (virgola mobile a mezza precisione) anziché INT8 come precisione di calcolo primaria. FP16 dimezza l'ingombro di memoria e la richiesta di larghezza di banda rispetto a FP32, mentre – poiché mantiene un campo esponenziale – rappresenta un'ampia gamma dinamica senza la necessità di calibrazione della gamma in stile INT8. Non raggiunge però il parallelismo che INT8 può ottenere, il che è uno dei motivi per cui i successivi Coral Edge TPU e Jetson Tensor I core, entrambi basati su percorsi dati dedicati INT8-first, registrano valori TOPS/W di gran lunga superiori.
Principio: il compilatore di grafi come secondo asse di accelerazione dell'inferenza
Oltre alla quantizzazione, il modo in cui un modello addestrato viene compilato per il set di istruzioni di un determinato chip è l'altro fattore principale che influenza il throughput nel mondo reale. Un modello esportato da TensorFlow Lite o ONNX è, di per sé, un grafo generico eseguito strato per strato in sequenza su una CPU. Il compilatore di ciascun fornitore applica approssimativamente tre tipi di ottimizzazione a questo grafo.
-
Fusione degli operatori: una sequenza come Convoluzione→BatchNorm→ReLU viene unita in un singolo kernel fuso, mantenendo i risultati intermedi nei registri anziché riscriverli in memoria, riducendo il numero di accessi alla memoria.
-
Trasformazione del layout: il layout NCHW (channel-first) preferito dalla CPU e il layout NHWC (channel-last) preferito dalle unità vettoriali vengono riselezionati per adattarsi al modello di accesso alla memoria effettivo. l'hardware di destinazione.
-
Compilazione su un grafo fisso: Alcuni compilatori, come il Coral Edge TPU Compiler, accettano solo un grafo completamente fisso costruito interamente con operatori supportati, escludendo forme dinamiche o operatori non supportati. Se anche un solo operatore non supportato compare nel modello, l'esecuzione si divide tra la CPU e l'Edge TPU circostante, e il conseguente costo di trasferimento dati bidirezionale può erodere sostanzialmente la velocità.
TensorRT di NVIDIA e OpenVINO di Intel adottano un approccio più flessibile di "offload parziale", affidando gli operatori non supportati alla CPU e scaricando il resto sull'acceleratore, mentre il Coral Edge TPU Compiler è più vicino a una scelta del tipo "tutto o niente" tra un grafo completamente supportato e nessuna accelerazione. Questa distinzione non si riflette nelle metriche hardware come i compromessi TOPS/larghezza di banda della memoria trattati nell'articolo di confronto SBC: è una differenza nella filosofia di progettazione dello stack software e Influisce in modo sostanziale sul costo reale del porting di un modello.
Confronto tra i principali chip: Coral, Movidius, Jetson
| Prodotto | Precisione | Prestazioni AI | Consumo energetico | Interfaccia | Prezzo |
|---|---|---|---|---|---|
| Google Coral Edge TPU (acceleratore USB) | Solo INT8 | 4 TOPS (2 TOPS/W) | 2W | USB 3.0 | ~$75–99 (lancio 2019) |
| Intel Movidius Myriad X (Neural Compute Stick 2) | Principalmente FP16 | Equivalente a circa 4 TOPS (nessun dato ufficiale pubblicato) | ~1,5–2,5W | USB 3.0 | ~$79–99 (lancio 2018, ora fuori produzione) |
| Hailo-8 (M.2) | INT8 | 26 TOPS (10,4 TOPS/W) | ~2,5W | M.2/PCIe | Circa 110 $ |
| NVIDIA Jetson Orin Nano Super | INT8 | 67 TOPS (modalità MAXN Super) | 7–25 W | SoM (modulo integrato) | 249 $ |
| NVIDIA Jetson Orin NX (16 GB) | INT8 | 100 TOPS | 10–25 W | SoM (modulo integrato) | 599 $ |
La pagina ufficiale delle specifiche di Intel per Movidius Myriad X non riporta un valore TOPS preciso, ma diverse recensioni descrivono una capacità di "oltre 4 trilioni di operazioni al secondo" in totale, e Intel stessa ha affermato che Myriad X è più di 10 volte più veloce di Myriad 2 (100–150 GFLOPS). La combinazione di 16 core di elaborazione vettoriale SHAVE programmabili con il Neural Compute Engine, un blocco dedicato che ha debuttato con Myriad X, è stata progettata per elaborare sei telecamere a 720p (tre coppie stereo) a 60 fps. fps simultanei. Hailo-8 e Jetson Orin Nano Super/NX sono trattati in modo più approfondito nell'articolo di confronto SBC, quindi questo articolo si limita alle voci della tabella sopra per evitare ripetizioni.
La linea Coral include anche la Dev Board Micro, una versione successiva dell'acceleratore USB menzionato sopra. Invece di un processore per applicazioni compatibile con Linux, abbina il coprocessore Edge TPU a una scheda di classe microcontrollore (MCU) a basso consumo e sempre attiva, pensata specificamente per casi d'uso TinyML alimentati a batteria, come il rilevamento vocale o delle vibrazioni sempre in ascolto. Mentre la Dev Board/USB Accelerator abbina un SoC generico a un Edge TPU esterno, la Dev Board Micro si rivolge a un caso d'uso completamente diverso: un trigger di rilevamento sempre attivo.
Storia: una filosofia di progettazione VPU nata dall'acquisizione di Movidius da parte di Intel
Movidius era una startup con sede a San Mateo che progettava chip a basso consumo specializzati nell'elaborazione della visione artificiale, acquisita da Intel nel Settembre 2016. La sua VPU (Vision Processing Unit) Myriad 2 pre-acquisizione non aveva un design generico simile a una CPU; combinava invece blocchi hardware dedicati alla visione artificiale con 12 core di elaborazione vettoriale personalizzati (SHAVE) e, dopo l'acquisizione, è stata integrata in dispositivi di produzione tra cui la videocamera per la registrazione della vita quotidiana "Clips" di Google, la termocamera "Firefly" di FLIR, il drone "Phantom 4" di DJI e "DeepGaze" di Tencent. Il suo successore, Myriad X, è stato annunciato nel 2017, espandendo il numero di core SHAVE a 16 e aggiungendo, per la prima volta, un blocco hardware dedicato all'inferenza delle reti neurali, il Neural Compute Engine, raggiungendo prestazioni oltre 10 volte superiori a quelle di Myriad 2 e un picco di oltre 1 teraFLOPS. Il Neural Compute Stick 2 (NCS2) menzionato sopra è un prodotto USB con un singolo Myriad X, lanciato nel quarto trimestre del 2018; pagina delle specifiche del prodotto Intel Ora è contrassegnato come "Discontinued" (fuori produzione): un chip VPU che un tempo rappresentava gli albori dell'IA edge, avendo ceduto il mercato ai successivi ASIC dedicati a INT8 e ai chip con GPU integrata.
Contemporaneamente a questa acquisizione, Intel ha rilasciato la prima versione del suo toolkit OpenVINO il 16 maggio 2018, uno stack software progettato per gestire la quantizzazione e l'ottimizzazione dei grafi in modo uniforme sul proprio hardware. Il componente NNCF (Neural Network Compression Framework) di OpenVINO gestisce la quantizzazione INT8 e la compressione dei modelli ed è stato progettato per ottimizzare e implementare i modelli attraverso un unico flusso di lavoro che si estende non solo alle VPU della famiglia Movidius, ma anche alle CPU Intel e alle GPU integrate. Il fatto che sia sopravvissuto come toolchain anziché essere legato a un singolo chip acceleratore illustra una strategia di sopravvivenza in un settore in cui le generazioni hardware cambiano rapidamente.
Storia: Edge TPU, erede della linea di TPU per data center
L'Edge TPU presente nei prodotti Google Coral è un design scalabile, per sistemi embedded con risorse energetiche limitate. I dispositivi utilizzano la stessa architettura di calcolo "systolic array" che Google ha creato per le sue TPU (Tensor Processing Unit) di classe data center. Un systolic array dispone un gran numero di unità di moltiplicazione-accumulazione in una griglia e trasmette i dati in un'unica direzione, passandoli solo tra unità adiacenti. A differenza di una CPU generica, che deve accedere a registri e memoria per ogni istruzione, questo permette di eseguire grandi moltiplicazioni di matrici con un'efficienza energetica estremamente elevata. Le TPU per data center di Google costruiscono questa griglia su scala enorme, montando più chip su una scheda dotata di dissipatori di calore in rame raffreddati a liquido (la foto qui sotto, rilasciata da Google, mostra una scheda TPU v3 con quattro chip visibilmente collegati da tubi di raffreddamento a liquido). L'Edge TPU mantiene la stessa idea di base, ma riduce drasticamente le dimensioni della griglia e il consumo energetico a pochi watt, in modo da poter funzionare entro il limite di potenza di un bus USB o di uno slot M.2.
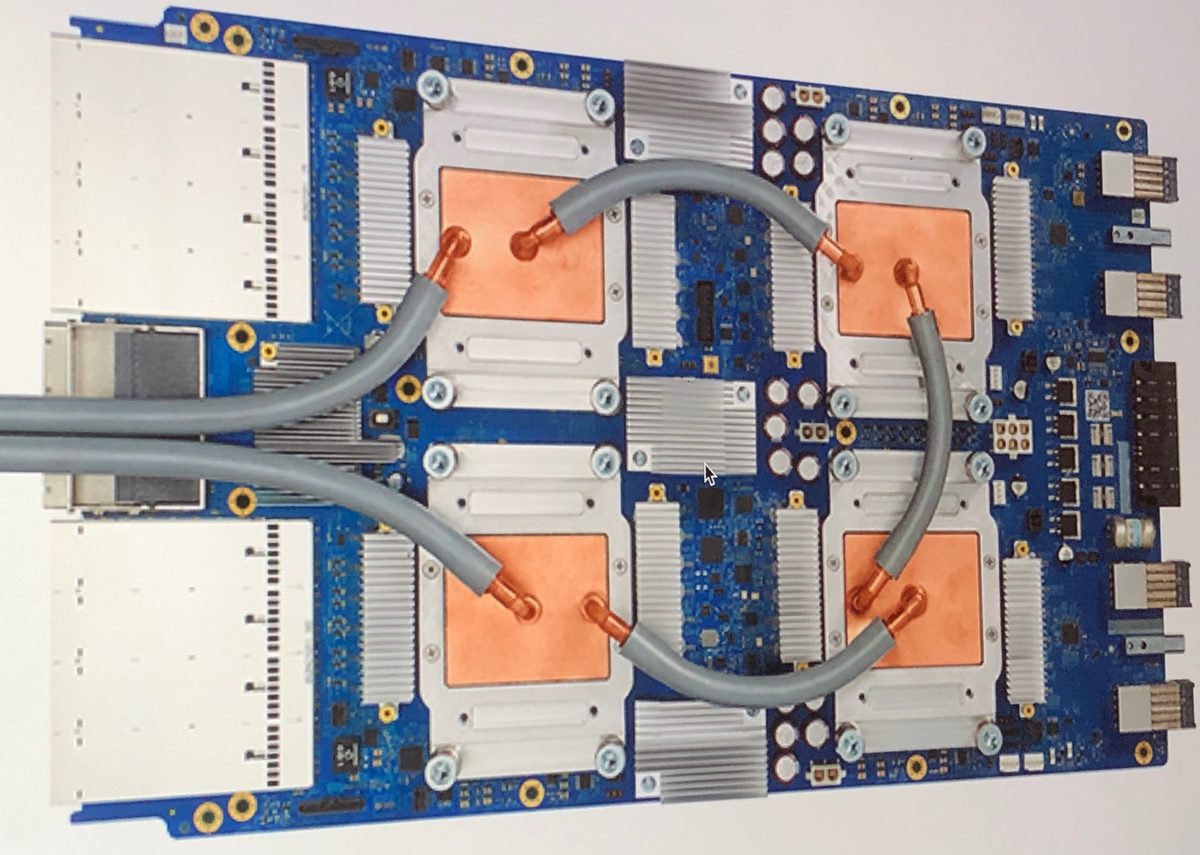
Immagine: Tensor Processing Unit 3.0(Zinskauf, CC BY-SA 4.0), Wikimedia Commons. Una foto della scheda TPU v3 di classe data center, non della Edge TPU stessa, ma un riferimento che mostra le dimensioni del "genitore" data center che condivide lo stesso approccio con array sistolico.

Nel 2019, Google ha lanciato la Dev Board e l'acceleratore USB con questa Edge TPU (4 TOPS, 2W), che ha riscosso successo come acceleratore aggiuntivo per SBC esistenti come il Raspberry Pi, supportato da un'inferenza a basso consumo energetico in grado di eseguire MobileNet v2 a circa 400 fotogrammi al secondo. Da allora, tuttavia, Google ha di fatto smesso di investire nella linea di prodotti senza rilasciare alcun nuovo hardware degno di nota e, a partire dal 2026, il suo sito ufficiale coral.ai reindirizza a un sito generico di Google Developers. pagina. Il motivo per cui i prodotti Coral non sono caduti completamente in disuso nonostante ciò è che Google ha rilasciato i driver e il firmware come open source, consentendo a progetti della community come il software di sorveglianza con rilevamento di oggetti Frigate NVR di ottenere supporto e mantenere l'hardware in produzione (ulteriori dettagli nell'articolo di confronto SBC)(/it/blog/posts/sensor-sbc.html).
Esempio reale: nove reti neurali in esecuzione simultanea su un singolo Jetson TX2 a bordo di un drone Skydio X2
Un esempio di spicco di un singolo chip acceleratore che esegue più reti neurali in parallelo è il drone volante autonomo Skydio X2/X2D. L'X2 monta un NVIDIA Tegra X2, lo stesso SoC presente nel Jetson TX2, come chip di elaborazione principale, che elabora i flussi video provenienti da sei telecamere di bordo (tre coppie stereo, una configurazione trinoculare) per eseguire contemporaneamente nove reti neurali profonde progettate su misura, interamente a bordo. Utilizzando questi output di inferenza, può tracciare fino a 20 oggetti di interesse simultaneamente, come ostacoli, soggetti, ecc. come persone o veicoli, mentre si costruisce un modello 3D del mondo aggiornato a una velocità superiore a un milione di punti al secondo, e il ciclo decisionale che trasforma quel modello del mondo in comandi di volo funziona a una frequenza di 500 Hz. Il motivo per cui può volare velocemente attraverso fitte foreste o spazi interni evitando ostacoli senza fare affidamento sul GPS è che l'intera pipeline viene completata su un singolo Tegra X2 a bordo, anziché essere scaricata sul cloud.
 Skydio X2D che ispeziona un KC-10 Extender (Base aerea di Dover)
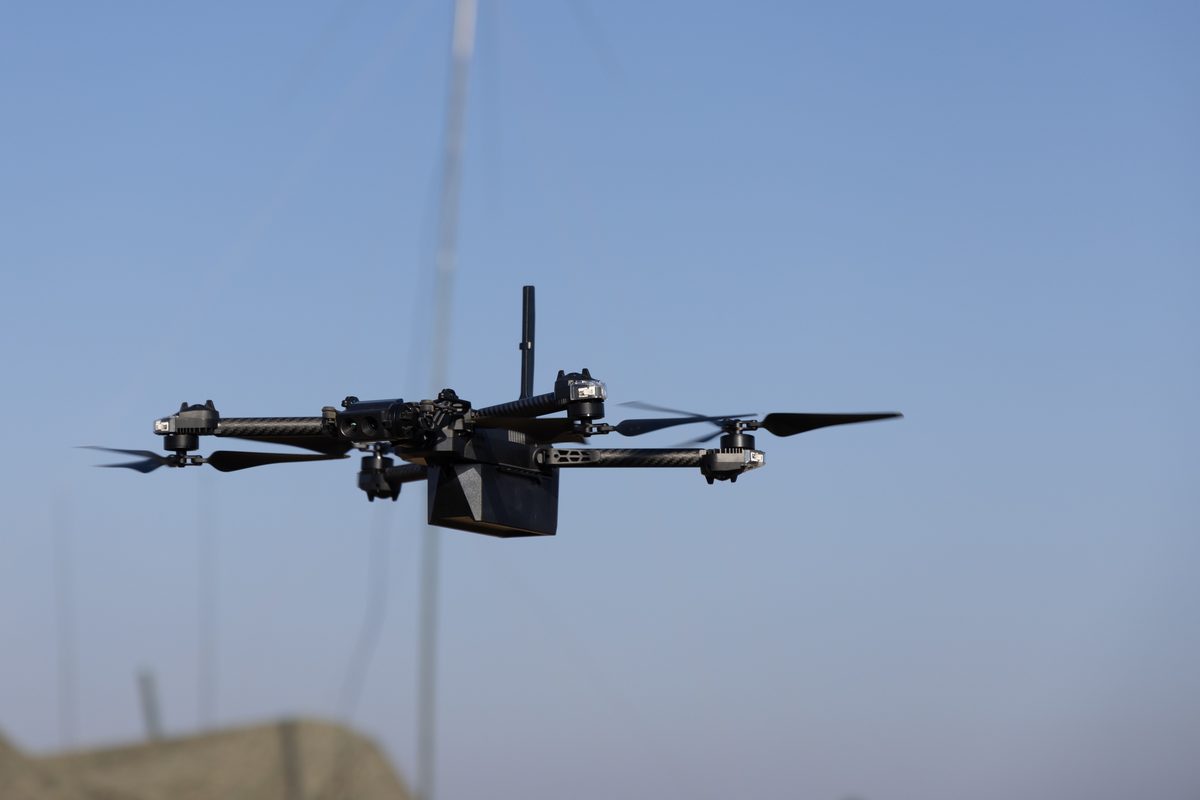
Immagini: Skydio X2D che ispeziona un aereo(Mauricio Campino, dominio pubblico) / I Marines statunitensi si esercitano nelle operazioni con UAS (9269101)(dominio pubblico, Corpo dei Marines degli Stati Uniti), entrambe tramite Wikimedia Commons.
La designazione X2D si riferisce alla variante del Dipartimento della Difesa e tra le missioni reali registrate nelle foto del Dipartimento della Difesa degli Stati Uniti pubblicate pubblicamente figurano il 436° Mission Generation Group presso la base aerea di Dover, nel Delaware. L'utilizzo di un X2D per ispezionare l'integrità strutturale di un aereo cisterna KC-10 Extender (novembre 2022), così come l'addestramento della 5ª Compagnia di Collegamento per il Supporto di Tiro Aeronavale (5ª ANGLICO) a Camp Schwab, Okinawa, e dell'addestramento della 10ª Divisione da Montagna presso l'area di addestramento di Hohenfels, in Germania, hanno entrambi impiegato lo Skydio X2D come piccolo sistema aereo a pilotaggio remoto (sUAS). Il suo successore, l'X10, passa dal Tegra X2 a un SoC di generazione Jetson Orin e aggiorna le sue telecamere di navigazione a 32 megapixel: un buon esempio di come un salto di prestazioni per chip tra le generazioni si traduca direttamente in reali vantaggi operativi: più reti neurali in esecuzione simultanea a bordo, più oggetti tracciati simultaneamente e un ciclo decisionale a frequenza più elevata.
.jpg)
Da un "dispositivo AI" per hobbisti alla frontiera dell'addestramento on-device
Gli acceleratori integrati con GPU, un tempo concentrati su applicazioni robotiche e di difesa, entro il 2026 hanno iniziato a raggiungere anche sviluppatori individuali e su piccola scala. "ClawBox", realizzato dall'azienda bulgara ID Robots, è un dispositivo hardware per assistenti AI che integra un NVIDIA Jetson Orin Nano, alloggiato in un contenitore delle dimensioni di un palmo con ventola di raffreddamento e ventilazione laterale, riutilizzando, così com'è, lo stesso SoM originariamente progettato per carichi di lavoro robotici. Il fatto che un chip progettato per essere il "cervello" di un drone o di un robot industriale possa essere inserito direttamente in un prodotto commercializzato in centinaia o poche migliaia di unità, realizzato da una piccola startup, sottolinea la versatilità degli acceleratori integrati con GPU: a differenza di un ASIC dedicato, possono eseguire modelli CUDA arbitrari senza bisogno di configurazioni aggiuntive.
Una seconda tendenza correlata è la ricerca che spinge quello che un tempo era un acceleratore edge puramente dedicato all'inferenza verso l'addestramento on-device, ovvero il riaddestramento di un modello direttamente sul dispositivo. Un articolo pubblicato nel luglio 2026, "Empowering On-Device Model Adaptation with an Edge AI Inference Accelerator" (Piechocki, Capotondi, Kraft, arXiv:2607.18101), propone una pipeline che utilizza l'Hailo-8L (una versione di livello inferiore dell'Hailo-8 discusso in precedenza) che suddivide il lavoro di inferenza e addestramento su chip: l'inferenza del backbone quantizzato viene eseguita sull'Hailo-8L, mentre solo i livelli finali più leggeri vengono ottimizzati in modo incrementale in FP32 sulla CPU. L'articolo riporta un'accelerazione del tempo di esecuzione fino a 15,4 volte superiore per l'addestramento su dispositivo rispetto a un Raspberry Pi 5 da solo: un esempio di una frontiera della ricerca in cui il presupposto stesso dell'inferenza "sola" sta iniziando a vacillare, pur basandosi sullo stesso stack tecnologico di quantizzazione e compilazione di grafi.
Parametri che determinano le prestazioni
- Efficienza TOPS/W vs. flessibilità di precisione: Coral Edge TPU è altamente efficiente con 2 TOPS/W, ma ciò comporta la limitazione di poter eseguire solo grafi fissi pre-quantizzati a INT8. Jetson Orin NX, al contrario, può eseguire modelli CUDA arbitrari in una combinazione di FP16/INT8, a costo di non raggiungere le prestazioni TOPS/W di Coral. La flessibilità a cui un progetto può rinunciare è solitamente il primo fattore determinante nella scelta del chip.
- Rigidità del compilatore: un compilatore a grafo fisso completo come il Coral Edge TPU Compiler, che non consente alcun operatore non supportato, obbliga fin dall'inizio la progettazione del modello a essere vincolata agli operatori supportati. I compilatori con offload parziale come TensorRT/OpenVINO offrono maggiore flessibilità di porting, ma è facile trascurare la penalizzazione in termini di velocità che si verifica quando viene attivato un fallback della CPU.
- Scelta del metodo di quantizzazione (PTQ vs. QAT): PTQ, che richiede solo una piccola quantità di dati rappresentativi, è economico da sviluppare ma soggetto a una maggiore perdita di accuratezza su modelli con molti outlier. QAT richiede un passaggio di riaddestramento ma sopprime tale degrado. Le VPU della generazione Movidius Myriad X, basate principalmente su FP16, evitano completamente la calibrazione della quantizzazione per impostazione predefinita.
- Larghezza di banda dell'interfaccia: i dispositivi con connessione USB, come il Coral USB Accelerator o l'NCS2, possono subire un collo di bottiglia nella larghezza di banda del bus USB lato host quando vengono combinate diverse unità (come descritto nel caso Frigate NVR nell'articolo di confronto SBC). I dispositivi con connessione M.2/PCIe, come Hailo-8 o Jetson con integrazione SoM, sono meno soggetti a questo vincolo.
- Continuità di fornitura e roadmap: l'Intel Movidius NCS2 è esplicitamente contrassegnato come "Fuori produzione" nella sua pagina delle specifiche e il sito ufficiale di Coral ora reindirizza altrove, mentre la linea Jetson continua a fornire nuove generazioni. Per un progetto di lunga durata, la continuità della fornitura stessa diventa un fattore di rischio che va oltre un semplice confronto una tantum TOPS-per-dollaro.
- **Rapporto prezzo-prestazioni (/TOPS)**: In base al semplice rapporto/TOPS, Jetson Orin Nano Super (249 /67 TOPS ≈ 3,7/TOPS) e Jetson Orin NX (599 /100 TOPS ≈ 6/TOPS) possono sembrare più economici di Hailo-8 (110 /26 TOPS ≈ 4,2/TOPS) o Coral (75-99 /4 TOPS ≈ 19-25/TOPS), ma la scelta finale dipende comunque dal bilanciamento tra le dimensioni dello chassis e il budget di potenza che un determinato prodotto può effettivamente supportare, non solo dalle prestazioni pure e dal prezzo unitario.
Il doppio dei TOPS significa il doppio della velocità dell'applicazione?
Precisione, memoria, operatori supportati, trasferimenti e preelaborazione influiscono sulla velocità. Misura la latenza end-to-end sul modello reale.
Riferimenti
- Neural Network Compression Framework (NNCF) — OpenVINO ufficiale
- OpenVINO (Wikipedia)
- Intel Neural Compute Stick 2 — Specifiche del prodotto (Intel ufficiale)
- Recensione: Intel Neural Compute Stick 2 per Edge AI (viso.ai)
- Intel acquisirà l'azienda di Computer Vision Movidius (Road to VR)
- Intel annuncia Movidius Myriad X (Notebookcheck)
- [Google Coral Edge TPU / Scheda di sviluppo — CNX Software
- Scheda di sviluppo Coral TPU (NXP)
- Architettura di sistema Cloud TPU (Google Cloud ufficiale)
- Recensione del modulo NVIDIA Jetson Orin NX da 16 GB (ThinkRobotics)
- Scheda tecnica della serie NVIDIA Jetson Orin NX (NVIDIA Developer)
- Kit di sviluppo Jetson Orin Nano Super (NVIDIA ufficiale)
- Inception Spotlight: drone Skydio 2 alimentato da NVIDIA Jetson (Blog tecnico NVIDIA)
- Skydio Confronto X10 vs X2 (IL FUTURO 3D)
- Potenziamento dell'adattamento del modello sul dispositivo con un acceleratore di inferenza AI edge (arXiv:2607.18101)
- Inferenza LLM sostenibile per l'IA edge (arXiv:2504.03360)
- Hardware PXL 20231201 152957218 (53388218926) — Wikimedia Commons
- Unità di elaborazione tensoriale 3.0 — Wikimedia Commons
- [Dispositivo assistente AI ClawBox (2026) - fronte — Wikimedia Commons
- Skydio X2D che ispeziona un aereo — Wikimedia Commons
- Marines statunitensi si esercitano nelle operazioni con UAS (9269101) — Wikimedia Commons


Commenti
Accedi per continuare.
Nessun dato disponibile.