Contents — find the section you need
Prima che un robot possa "raccogliere la tazza sul tavolo" o "evitare il pedone davanti a sé", deve innanzitutto capire, a partire da un'immagine ripresa da una telecamera, cosa c'è e dove. Questa comprensione è compito del rilevamento di oggetti e della segmentazione semantica. I due concetti vengono spesso menzionati insieme, ma differiscono fondamentalmente, sia per il livello di dettaglio del loro output, sia per il modo in cui viene inquadrato il problema di base. Questo articolo li illustra entrambi partendo dalle basi, attraverso le loro controparti 3D e un chiaro confronto diretto.
 Telecamera di percezione del veicolo
Immagine: Car telecamera per finestrino del sistema Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Una telecamera di input rappresentativa, non un'affermazione sulle ultime specifiche del prodotto.

0. Cosa tratta questo articolo
- Cosa producono effettivamente il rilevamento di oggetti e la segmentazione semantica
- La pipeline su cui si basa il rilevamento (estrazione delle caratteristiche → testina di rilevamento)
- La storia degli algoritmi di riferimento, da R-CNN a YOLO, DETR e DINO, e le differenze nelle loro filosofie di progettazione
- Il compromesso tra due fasi e una fase, e dove si collocano i rilevatori basati su Transformer
- Come si sono evoluti gli algoritmi di segmentazione da FCN a Mask2Former
- Una singola tabella che chiarisce le differenze tra rilevamento, segmentazione semantica, di istanza e panottica
- Le basi del rilevamento di oggetti 3D e della segmentazione semantica 3D su nuvole di punti
- Come scegliere la tecnologia giusta per robotica, guida autonoma, sorveglianza e realtà aumentata
1. La risposta breve: cosa sono il rilevamento e la segmentazione
In una frase: Il rilevamento di oggetti risponde alla domanda "dove si trova cosa nell'immagine" con un rettangolo (un La segmentazione semantica**, che colora i pixel come la segmentazione semantica, risponde alla domanda "cos'è ogni pixel" colorando l'immagine. Entrambe condividono lo stesso obiettivo di base: comprendere un'immagine, ma lo fanno a risoluzioni completamente diverse.
A partire da questa coppia, si basano altri due compiti. La segmentazione per istanze colora i pixel come la segmentazione semantica, ma distingue anche i singoli oggetti della stessa classe (ad esempio, tre persone diverse in un'immagine). La segmentazione panottica unifica la segmentazione per istanze con la segmentazione semantica necessaria per gli elementi di sfondo "non numerabili" come strade o cielo, in un unico output completo. La Sezione 9, di seguito, illustra la relazione tra questi quattro metodi in una tabella.
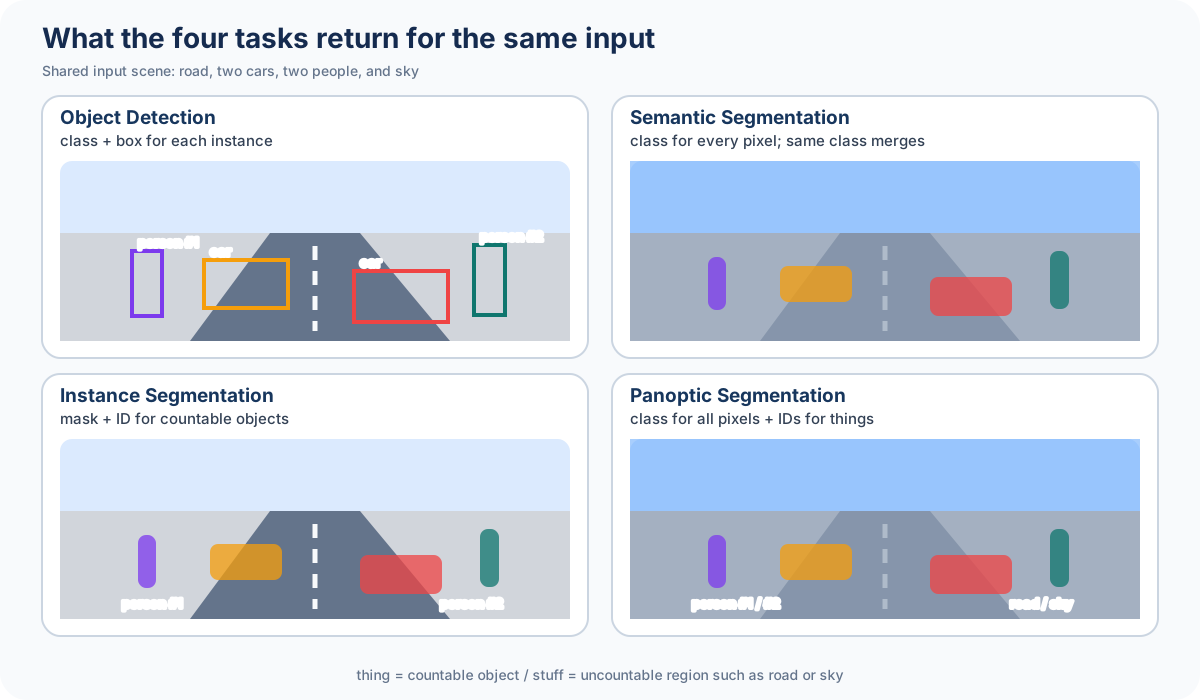
Figura: Duskcoil. Generata da una scena schematica e geometria condivisa; non si tratta di un output di un modello misurato.
2. Cos'è il rilevamento di oggetti? (Classe / Riquadro di delimitazione / Affidabilità)
Per una singola immagine, il Rilevamento di oggetti restituisce una serie di triple, una per ogni oggetto:
- Classe: la categoria dell'oggetto (una di un insieme predefinito di categorie, ad esempio "persona", "auto", "sedia" e così via)
- Riquadro di delimitazione: il rettangolo che racchiude l'oggetto, solitamente indicato con un punto centrale, larghezza e altezza (x, y, w, h), oppure con gli angoli in alto a sinistra e in basso a destra (x_1, y_1, x_2, y_2)
- Affidabilità: un punteggio (0-1) che indica quanto il modello sia sicuro di quella particolare combinazione riquadro-classe
La Classificazione delle immagini restituisce una singola risposta: "di cosa si tratta in questa immagine", mentre il Rilevamento di oggetti deve rispondere contemporaneamente a "quanti oggetti ci sono, dove si trovano e di che tipo". Questa proprietà, per cui "il conteggio stesso è sconosciuto", rende il Rilevamento di oggetti fondamentalmente più difficile della Classificazione. Un'immagine data può contenere zero oggetti o cento: il fatto stesso che il numero di output sia variabile è il vincolo di progettazione che guida essenzialmente ogni trucco discusso di seguito.
3. Come viene effettivamente eseguito il rilevamento?
Di fronte a questo problema del numero variabile di output, praticamente ogni algoritmo di rilevamento moderno segue la stessa pipeline a due fasi: estrarre una mappa di caratteristiche dall'intera immagine, suddividere tale mappa di caratteristiche con un gran numero di posizioni candidate (anchor box o le "query" del Transformer di cui si parlerà più avanti) e per ogni candidato decidere "oggetto o sfondo" e, se oggetto, "quale classe e qual è la posizione precisa".
Figura 2 — L'estrattore di caratteristiche (backbone) comprime l'immagine in una mappa di caratteristiche, e la testa di rilevamento esegue simultaneamente la classificazione e la regressione del riquadro su di essa.
All'interno della testa di rilevamento, due problemi di regressione/classificazione vengono risolti efficacemente in una sola volta: "c'è un oggetto in questa posizione candidata e, in caso affermativo, di quale classe?" e "di quanto dovrebbe essere spostato questo candidato (ancora) per allinearsi con l'oggetto reale?". La combinazione di questi in un'unica funzione di perdita a somma ponderata è la funzione di perdita multi-task ampiamente utilizzata a partire da Fast R-CNN.
Qui p rappresenta la probabilità di classe prevista, p^{*} la classe reale, t la correzione del riquadro prevista e t^{*} la correzione del target derivata dal riquadro reale. L'indicatore \mathbb{1}[p^{*} > 0] significa "calcola l'errore di regressione della posizione solo per i candidati che contengono effettivamente un oggetto, non per lo sfondo" — un candidato di sfondo non ha un riquadro reale verso cui regredire, quindi questa restrizione è naturale. \lambda regola il peso da attribuire al termine di regressione rispetto alla classificazione.
4. Algoritmi di rilevamento di punti di riferimento
L'evoluzione degli algoritmi di rilevamento è più facile da seguire lungo due assi: "come vengono ristrette le regioni candidate" e "come viene previsto il riquadro stesso".
R-CNN (Girshick et al., 2014) ha estratto circa 2.000 regioni candidate da un'immagine utilizzando il classico algoritmo di elaborazione delle immagini Selective Search, per poi elaborarle singolarmente tramite una CNN per la classificazione. Un metodo accurato, ma estremamente lento, poiché la CNN doveva essere eseguita una volta per ogni regione candidata.
Fast R-CNN (Girshick, 2015) ha elaborato l'intera immagine tramite una CNN una sola volta per costruire una singola mappa di caratteristiche, per poi ritagliare le regioni candidate da quella mappa di caratteristiche (RoI Pooling), eliminando così il calcolo ridondante per ogni regione.
Faster R-CNN (Ren, He, Girshick, Sun, 2015) si è spinto oltre, sostituendo la generazione delle regioni candidate con una piccola Region Proposal Network (RPN), integrando generazione delle proposte, classificazione e regressione in un'unica rete. Queste tre fasi insieme costituiscono l'evoluzione di quello che viene definito rilevatore a due stadi.
Ren, He, Girshick, Sun, 2015 SSD (Liu et al., 2016) e YOLO (Redmon et al., 2015–2016) sono stati i pionieri dei rilevatori a una fase, eliminando completamente la fase di selezione delle regioni candidate e prevedendo la classe e il riquadro direttamente da ogni posizione sulla mappa delle caratteristiche. La velocità è aumentata drasticamente, sebbene le prime versioni di YOLO fossero inferiori ai rilevatori a due fasi in termini di accuratezza sugli oggetti di piccole dimensioni.
RetinaNet (Lin et al., 2017) ha affrontato il problema dello squilibrio di classe che affliggeva i rilevatori a una fase — i candidati di sfondo sono di gran lunga più numerosi dei candidati oggetto e l'addestramento viene dominato da questi ultimi — con una nuova funzione di perdita, la Focal Loss, dimostrando che i rilevatori a una fase potevano effettivamente raggiungere l'accuratezza dei rilevatori a due fasi.
FCOS (Tian et al., 2019) è completamente senza anchor box: invece di predefinire un set di anchor box di varie dimensioni e rapporti d'aspetto, calcola la distanza di ciascun pixel della mappa delle caratteristiche direttamente al contorno dell'oggetto, evitando la necessità di ottimizzare gli iperparametri richiesti dalla progettazione degli anchor box.
DETR, Deformable DETR e DINO riformulano il rilevamento con Transformer come un problema di predizione di insiemi, argomento della prossima sezione.
5. Rilevamento a due fasi vs. a una fase
I rilevatori a due fasi e a una fase si dividono su un unico quesito: la restrizione della regione candidata esiste come fase indipendente?
| Aspetto | A due fasi (ad es. Faster R-CNN) | A una fase (ad es. YOLO) |
|---|---|---|
| Flusso | Generazione di proposte (RPN) → classificazione e regressione per regione | Classificazione e regressione diretta in ogni punto della mappa delle caratteristiche |
Accuratezza | Generalmente elevata, soprattutto su oggetti piccoli/densi | Le generazioni più recenti colmano gran parte del divario |
Velocità di inferenza | Relativamente lenta (rimane il lavoro per ogni candidato) | Veloce, adatta al tempo reale |
Costo computazionale | Scalabile con il numero di candidati | Approssimativamente proporzionale alla dimensione dell'immagine, prevedibile |
Difficoltà di implementazione/ottimizzazione | Più fasi, più complessa | Pipeline più semplice |
Applicazioni | Elaborazione offline, ispezione/analisi con priorità all'accuratezza | Percezione in tempo reale in veicoli e robot |
Entrambe le famiglie si sono a lungo affidate alla soppressione non massima (NMS) come post-elaborazione per ridurre il numero di candidati sovrapposti. Tra le diverse caselle candidate generate per un oggetto, quella la cui sovrapposizione (IoU: Intersezione su Unione) con un'altra supera una determinata soglia viene scartata, secondo questa definizione:
A e B sono le regioni occupate dalle due caselle; dividendo la loro area di sovrapposizione per la loro area di unione si ottiene un punteggio compreso tra 0 e 1. Un valore IoU elevato indica che le due caselle probabilmente puntano allo stesso oggetto, quindi quella con minore affidabilità viene scartata. NMS funziona, ma può fallire su oggetti densamente raggruppati: una debolezza che la famiglia DETR, di cui parleremo in seguito, elimina completamente.
6. Rilevamento nell'era dei Transformer (DETR / DETR deformabile / DINO)
DETR (Carion et al., 2020, Facebook AI) ha cambiato radicalmente il modo in cui viene formulato il rilevamento. Senza anchor box e senza NMS, il modello elabora le caratteristiche dell'immagine tramite un codificatore Transformer e passa un numero fisso di "query" (vettori apprendibili che rappresentano gli oggetti candidati) attraverso un decodificatore, producendo direttamente esattamente lo stesso numero di coppie box-classe. Durante l'addestramento, il set previsto e il set di ground truth vengono abbinati uno a uno tramite l'algoritmo ungherese e la funzione di perdita viene calcolata rispetto a tale abbinamento.
y_i è l'oggetto di ground truth i, \hat{y}_{\sigma(i)} è la previsione assegnatagli in base alla permutazione \sigma e \mathfrak{S}_N è l'insieme di tutte le permutazioni degli elementi N. Questo significa: trovare la permutazione \hat{\sigma} che assegna le previsioni alle verità di base in modo uno a uno con il minimo costo totale — solo una volta stabilita tale assegnazione è possibile calcolare le normali perdite di classificazione e regressione. Poiché a nessun oggetto può mai essere assegnata più di una previsione, NMS diventa superfluo per costruzione.
DETR presentava tuttavia uno svantaggio: l'attenzione completa sull'intera immagine è costosa e il modello necessitava di un numero enorme di epoche di addestramento per convergere. Deformable DETR (Zhu et al., 2020) ha introdotto un meccanismo di attenzione deformabile in cui ogni query si concentra solo su un piccolo insieme appreso di punti di campionamento anziché sull'intera immagine, riducendo i costi computazionali e accelerando notevolmente la convergenza. DINO (Zhang et al., 2022; "DETR with Improved DeNoising Anchor Boxes") ha introdotto accorgimenti come query di denoising contrastive per una maggiore stabilità dell'addestramento e la selezione di query miste per inizializzare le query a partire dalla mappa delle caratteristiche, raggiungendo all'epoca la migliore accuratezza tra i rilevatori della famiglia DETR. I rilevatori basati su Transformer si affiancano ora alla famiglia YOLO come una delle due principali direzioni di applicazione in produzione.
7. Cos'è la segmentazione semantica?
La segmentazione semantica predice, per ogni pixel di un'immagine, a quale classe appartiene. Il suo output non è un riquadro di delimitazione, bensì una "mappa delle classi" alla stessa risoluzione dell'immagine di input, in cui ogni pixel ha un ID di classe.
Mentre il rilevamento di oggetti approssima un oggetto con un rettangolo grossolano, la segmentazione semantica può rappresentare il contorno effettivo dell'oggetto alla risoluzione dei pixel: un vero punto di forza per forme sottili e allungate come un marciapiede o contorni complessi come i rami degli alberi. Il compromesso: anche quando in un fotogramma compaiono più istanze della stessa classe, la segmentazione semantica non le distingue: tutti i pixel "persona" vengono colorati allo stesso modo e il conteggio degli individui viene perso. Colmare questa lacuna è esattamente lo scopo della segmentazione per istanze, descritta più avanti.
8. Algoritmi di segmentazione basati su punti di riferimento
FCN (Fully Convolutional Network; Long, Shelhamer, Darrell, 2015) ha rimosso gli strati completamente connessi da una CNN per la classificazione delle immagini, lasciando solo gli strati convoluzionali, in modo che la rete potesse produrre previsioni a livello di pixel direttamente per input di qualsiasi dimensione. È il punto di partenza del settore: il primo progetto a stabilire la segmentazione semantica come una singola rete addestrabile end-to-end.
U-Net (Ronneberger et al., 2015), proposto per la segmentazione di immagini mediche, dispone un encoder (che effettua il downsampling durante l'estrazione delle caratteristiche) simmetricamente rispetto a un decoder (che effettua l'upsampling durante la ricostruzione) e collega direttamente i layer dell'encoder e del decoder a risoluzione corrispondente tramite "skip connections". Questa architettura, che preserva i dettagli dei contorni pur producendo un output ad alta risoluzione, è diventata uno standard e si è diffusa ben oltre il campo medico.
SegNet (Badrinarayanan et al.) memorizza, durante il pooling dell'encoder, la posizione esatta in cui si trova il valore massimo ("indici di pooling"), riutilizzando poi tale informazione durante l'upsampling del decoder, ripristinando i contorni in modo efficiente in termini di memoria. PSPNet (Zhao et al., 2017) ha introdotto un modulo di Pyramid Pooling che calcola la media delle caratteristiche su regioni a diverse scale, catturando il contesto dell'intera immagine che un campo recettivo ristretto da solo non riuscirebbe a cogliere.
La serie DeepLab (Chen et al.) ha costruito il suo nucleo attorno alla convoluzione dilatata (atrosa), allargando gli spazi tra i punti di campionamento del kernel per ampliare il campo recettivo senza sacrificare la risoluzione, evolvendosi dalla versione 1 alla versione 3+ (2018). HRNet (Wang et al., 2019) ha invertito l'approccio usuale: invece di ridurre la risoluzione e poi ripristinarla, mantiene un flusso di caratteristiche ad alta risoluzione attivo in parallelo in tutta la rete, scambiando continuamente informazioni tra le diverse risoluzioni.
SegFormer (Xie et al., 2021) ha abbinato un codificatore Transformer gerarchico a un decodificatore leggero basato esclusivamente su MLP, ottenendo elevata precisione ed efficienza con un design sorprendentemente semplice. Mask2Former (Cheng et al., 2022) ha riformulato la segmentazione come "un numero fisso di query, ognuna delle quali predice una maschera e una classe", limitando l'attenzione di ciascuna query alla regione della maschera predetta nello strato precedente tramite "attenzione mascherata", garantendo sia una convergenza rapida che un'unica architettura in grado di gestire la segmentazione semantica, di istanza e panottica.
9. Confronto tra rilevamento, segmentazione semantica, di istanza e panottica
I quattro compiti introdotti finora diventano chiari una volta organizzati lungo due assi: distingue le singole istanze della stessa classe e gestisce lo "sfondo", ovvero elementi non numerabili come strade, cielo o muri?
| Compito | Unità di output | Distingue le istanze | Gestisce lo sfondo | Algoritmi di punti di riferimento | Metrica chiave |
|---|---|---|---|---|---|
Rilevamento oggetti | Bounding box | Sì (un box per istanza) | No | Faster R-CNN, YOLO, DETR | mAP |
Segmentazione semantica | Etichetta di classe per pixel | No (la stessa classe viene fusa in un unico colore) | Sì | FCN, DeepLab, SegFormer | mIoU |
Segmentazione per istanze | Maschera per pixel | Sì (maschera separata per ogni istanza) | No | Mask R-CNN, Mask2Former | AP (basato su mask-IoU) |
Segmentazione panottica | Classe per pixel + ID istanza | Sì (solo primo piano) | Sì (solo classe, nessun ID istanza) | Panoptic FPN, Mask2Former | PQ (Qualità Panottica) |
Come si evince dalla tabella, la segmentazione panottica (proposta da Kirillov et al., 2019) rappresenta il "meglio di entrambi i mondi" tra segmentazione per istanze e segmentazione semantica. Gli oggetti in primo piano, ovvero elementi numerabili come persone e automobili, vengono distinti per ogni istanza, come nella segmentazione per istanze; Lo sfondo — elementi non numerabili come strade e cielo — riceve solo un'etichetta di classe, come nella segmentazione semantica. Se si cerca di descrivere in modo completo ed esaustivo una singola immagine, si arriva esattamente a questa forma panottica: un modo utile per vedere come sono correlate tutte e quattro le attività.
La metrica di valutazione mIoU (Mean Intersection over Union) calcola, per ogni classe c, l'IoU tra la regione di riferimento G_c e la regione prevista P_c, quindi ne calcola la media su tutte le classi.
Mentre il punteggio mAP del rilevamento valuta la concordanza a livello di riquadri, il punteggio mIoU valuta la concordanza a livello di pixel: questa differenza nella metrica rispecchia esattamente la differenza in ciò che ciascuna attività considera "corretto".
10. Rilevamento di oggetti 3D
I veicoli autonomi e i robot spesso necessitano di rilevare la posizione, le dimensioni e l'orientamento 3D di un oggetto direttamente dalle nuvole di punti LiDAR, non solo dalle immagini 2D. Una nuvola di punti non ha la struttura a griglia di un'immagine 2D, quindi una CNN non può elaborarla così com'è: trasformare questi dati irregolari in qualcosa di regolare è la principale sfida progettuale nel rilevamento di oggetti 3D.
SECOND (Yan et al., 2018) divide una nuvola di punti in voxel 3D (celle cubiche) e utilizza la convoluzione sparsa per saltare la grande frazione di voxel che non contengono punti, riducendo drasticamente il costo computazionale delle CNN 3D. PointPillars (Lang et al., 2019) ha ulteriormente semplificato questo processo, aggregando i punti in "pilastri" verticali invece che in voxel, in modo che la rete possa elaborarli con una normale convoluzione 2D anziché 3D, aumentando significativamente la velocità. PV-RCNN (Shi et al., 2020) ha combinato l'efficienza dell'elaborazione basata sui voxel con la localizzazione precisa derivante dall'elaborazione diretta dei punti (stile PointNet), in un design ibrido Point-Voxel. CenterPoint (Yin et al., 2021) ha introdotto un approccio senza punti di ancoraggio per il rilevamento 3D: rileva un oggetto come un singolo punto centrale, quindi ne stima larghezza, altezza, profondità e orientamento a partire da esso, abbinandolo a backbone di tipo PointPillars o VoxelNet per una maggiore precisione.
Molti di questi metodi condividono un'ulteriore idea progettuale: proiettare le informazioni della nuvola di punti in una vista a volo d'uccello (Bird's-Eye View, BEV) – una mappa di caratteristiche 2D vista dall'alto – prima di eseguire il rilevamento. La compressione delle informazioni sull'altezza comporta una perdita di dettaglio in cambio della capacità di gestire "dove si trova questo oggetto sulla superficie stradale" – la relazione più importante per la guida – all'interno dello stesso framework di un normale rilevatore 2D.
11. Segmentazione semantica 3D
La segmentazione semantica 3D assegna un'etichetta di classe a ogni punto in una nuvola di punti (o a ogni segnale laser di ritorno da un LiDAR). Ancora una volta, la gestione dei dati irregolari delle nuvole di punti è ciò che distingue i principali approcci.
PointNet++ (Qi et al., 2017) alimenta la rete con i punti così come sono, senza voxelizzazione o altre conversioni, raggruppando i punti vicini e aggregando le caratteristiche in modo gerarchico, ponendo le basi per i metodi basati sui punti. RandLA-Net (Hu et al., 2020) ha affrontato il collo di bottiglia della ricerca dei vicini che rendeva costose le nuvole di punti su larga scala, combinando il campionamento casuale con un modulo di aggregazione locale delle caratteristiche che compensa le informazioni che il campionamento casuale altrimenti perderebbe, raggiungendo velocità pratiche anche su nuvole di punti a scala urbana.
RangeNet++ (Milioto et al., 2019) salta completamente l'elaborazione 3D: proietta la nuvola di punti, utilizzando l'ordine di scansione del LiDAR, in un'immagine di distanza 2D, esegue una normale CNN 2D su di essa e proietta il risultato nuovamente in 3D, sfruttando la maturità degli strumenti CNN 2D per la velocità. Cylinder3D (Zhu et al., 2021) ha notato che le nuvole di punti LiDAR in ambienti esterni si irradiano dal sensore e le ha voxelizzate in coordinate cilindriche anziché cartesiane per gestire il conseguente decadimento della densità con la distanza. SPVNAS (Tang et al., 2020) ha fuso l'elaborazione basata su punti e quella basata su voxel tramite la convoluzione Sparse Point-Voxel, applicando poi la ricerca di architetture neurali (NAS) per trovare automaticamente configurazioni con un forte compromesso tra precisione e velocità.
Come nel caso 2D, la storia della segmentazione semantica 3D può essere letta come un continuo alternarsi tra "mantieni i punti come punti" (basata sui punti) e "converti in una griglia regolare" (basata su voxel o immagini di intervallo), ognuna delle quali offre un diverso compromesso tra precisione, velocità e memoria.
12. Scegliere l'approccio giusto nella pratica
La scelta tra rilevamento e segmentazione, e quale algoritmo specifico utilizzare, dipende fortemente dal caso d'uso.
-
Bracci robotici / presa: conoscere il contorno esatto dell'oggetto da afferrare è fondamentale, quindi la segmentazione di istanza (ad esempio Mask2Former) è la soluzione migliore: un semplice riquadro di delimitazione non rivela la vera forma dell'oggetto né un punto di presa ottimale.
-
Guida autonoma: le prestazioni in tempo reale sono imprescindibili, quindi il rilevamento 2D si basa su rilevatori a stadio singolo (la famiglia YOLO), mentre il rilevamento 3D si affida a rilevatori 3D basati su veicoli elettrici a batteria (BEV) focalizzati sull'efficienza, come PointPillars o CenterPoint. La segmentazione semantica/panottica viene spesso sovrapposta per comprendere l'area percorribile.
-
Telecamere di sorveglianza/sicurezza: l'insieme delle classi di target (persone, veicoli) è solitamente limitato e la mancata rilevazione è più importante della velocità pura, aprendo la strada a rilevatori a due stadi o a quelli ad alta precisione basati su Transformer.
-
AR/VR: decidere dove ancorare un oggetto virtuale nel mondo reale significa in genere utilizzare la segmentazione semantica per identificare piani e regioni dell'oggetto, quindi applicare la fusione dei sensori (vedi l'articolo correlato) per un vero allineamento 3D.
Sui dispositivi edge con risorse limitate, velocità e ingombro di solito hanno la precedenza sulla precisione: varianti leggere di YOLO o una versione snella di SegFormer. Per analisi offline precise (immagini mediche, immagini satellitari), la precisione è fondamentale, favorendo i rilevatori a due stadi o i modelli di classe Mask2Former. In pratica, il compromesso tra prestazioni in tempo reale e precisione è il fattore più importante nella decisione.
Per gli ultimi sviluppi — architetture senza NMS, rilevamento a vocabolario aperto, modelli di base della famiglia Segment Anything — vedere Technology Trends in Object Detection e Technology Trends in Semantic Segmentation.
13. Riepilogo
Il rilevamento di oggetti cattura gli oggetti come rettangoli; la segmentazione semantica li cattura pixel per pixel: due attività di comprensione delle immagini che operano a risoluzioni diverse. La linea evolutiva del rilevamento va dai metodi a due fasi (Faster R-CNN) a quelli a una fase (YOLO) fino ai rilevatori basati su Transformer che eliminano completamente gli anchor e l'NMS (DETR/DINO); la segmentazione, invece, va da FCN a U-Net e DeepLab fino ai metodi basati su Transformer come SegFormer/Mask2Former. Su queste basi si collocano la segmentazione per istanze, che aggiunge la distinzione per singolo oggetto, la segmentazione panottica, che unifica entrambe, e le loro controparti 3D basate su nuvole di punti: la scelta del metodo più adatto dipende sempre dalla necessità di precisione o di velocità.
Quali output distinguono il rilevamento dalla segmentazione?
Il rilevamento in genere restituisce riquadri e classi; la segmentazione restituisce regioni di pixel.
Scegliere in base alle esigenze di localizzazione, contorni e identità dell'istanza.
Commenti
Accedi per continuare.
Nessun dato disponibile.