Contents — find the section you need
किसी रोबोट के लिए "टेबल पर रखा कप उठाना" या "आगे चल रहे पैदल यात्री से बचना" जैसे कार्यों के लिए, उसे कैमरे से प्राप्त छवि से यह समझना होगा कि वहां क्या है और कहां है। यह समझ ऑब्जेक्ट डिटेक्शन और सिमेंटिक सेगमेंटेशन का काम है। इन दोनों का ज़िक्र अक्सर एक साथ किया जाता है, लेकिन इनमें मूलभूत अंतर हैं - एक तो इनके आउटपुट की बारीकी में और दूसरा समस्या को समझने के तरीके में। यह लेख इनके 3D समकक्षों और एक स्पष्ट तुलनात्मक विश्लेषण के माध्यम से इन दोनों को शुरू से समझाता है।
 वाहन परसेप्शन कैमरा
छवि: Car Mobileye सिस्टम का विंडो कैमरा (Ranbar, CC BY-SA 4.0), विकिमीडिया कॉमन्स। यह एक प्रतिनिधि इनपुट कैमरा है, नवीनतम उत्पाद विशिष्टताओं का दावा नहीं है।

0. इस लेख में क्या शामिल है
- ऑब्जेक्ट डिटेक्शन और सिमेंटिक सेगमेंटेशन का वास्तविक आउटपुट क्या है
- डिटेक्शन जिस पाइपलाइन पर चलता है (फीचर एक्सट्रैक्शन → डिटेक्शन हेड)
- R-CNN से लेकर YOLO, DETR और DINO तक के प्रमुख एल्गोरिदम का इतिहास और उनकी डिज़ाइन फिलॉसफी में अंतर
- दो-चरण बनाम एक-चरण का ट्रेड-ऑफ और ट्रांसफॉर्मर-आधारित डिटेक्टरों की भूमिका
- सेगमेंटेशन एल्गोरिदम का FCN से Mask2Former तक का विकास
- एक ऐसी तालिका जो डिटेक्शन, सिमेंटिक, इंस्टेंस और पैनोप्टिक सेगमेंटेशन के बीच के अंतर को स्पष्ट करती है
- पॉइंट क्लाउड पर 3D ऑब्जेक्ट डिटेक्शन और 3D सिमेंटिक सेगमेंटेशन की मूल बातें
- रोबोटिक्स, ऑटोनॉमस ड्राइविंग, सर्विलांस और AR के लिए सही तकनीक का चुनाव कैसे करें
1. संक्षिप्त उत्तर: डिटेक्शन और सेगमेंटेशन क्या हैं
संक्षेप में: ऑब्जेक्ट डिटेक्शन एक आयत (बाउंडिंग बॉक्स) का उपयोग करके यह बताता है कि छवि में क्या है और कहाँ है, जबकि सिमेंटिक सेगमेंटेशन छवि को रंग देकर यह बताता है कि प्रत्येक पिक्सेल क्या है। दोनों का मूल लक्ष्य एक ही है - छवि को समझना - लेकिन वे बिल्कुल अलग-अलग स्तरों पर परिणाम देते हैं।
दो और कार्य इस जोड़ी पर आधारित हैं। इंस्टेंस सेगमेंटेशन सिमेंटिक सेगमेंटेशन की तरह पिक्सेल को रंग देता है, लेकिन साथ ही एक ही वर्ग की अलग-अलग वस्तुओं (जैसे, एक फ्रेम में तीन अलग-अलग व्यक्ति) को भी अलग करता है। पैनोप्टिक सेगमेंटेशन सड़क या आकाश जैसी "अगणनीय" पृष्ठभूमि सामग्री के लिए आवश्यक सिमेंटिक सेगमेंटेशन के साथ इंस्टेंस सेगमेंटेशन को एकीकृत करके एक पूर्ण आउटपुट प्रदान करता है। नीचे अनुभाग 9 में एक तालिका में बताया गया है कि ये चारों आपस में कैसे संबंधित हैं।
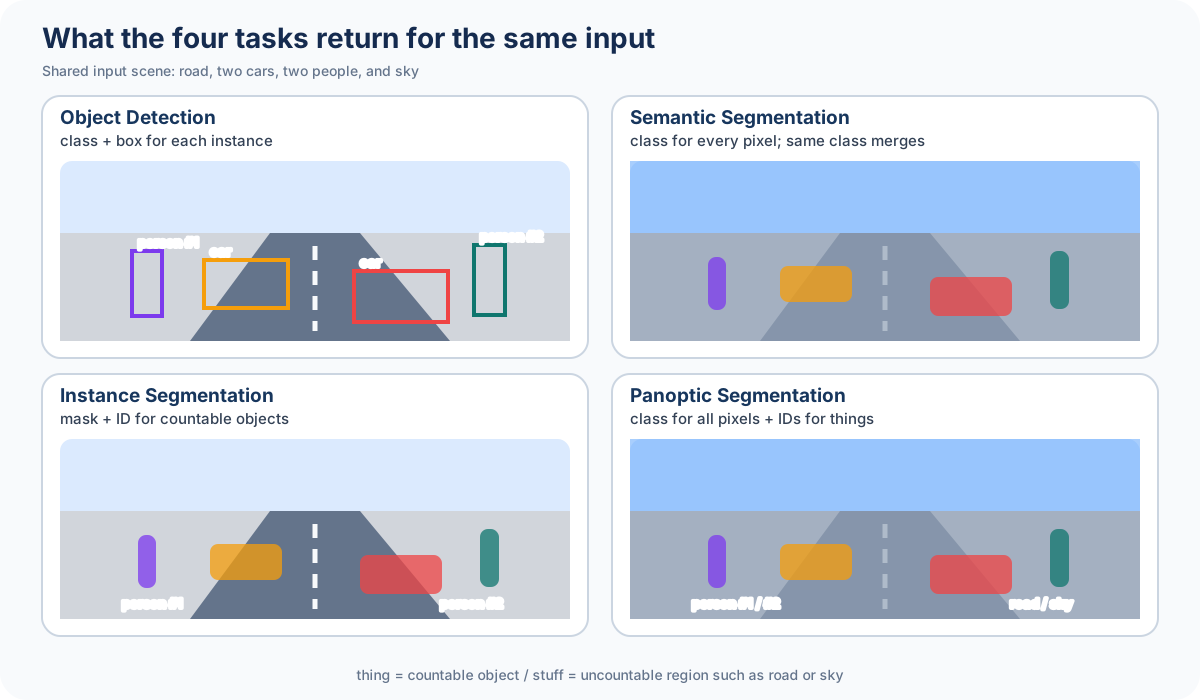
चित्र: डस्ककॉइल। एक योजनाबद्ध दृश्य और साझा ज्यामिति से उत्पन्न; मापा मॉडल आउटपुट नहीं।
2. वस्तु पहचान क्या है? (क्लास / बाउंडिंग बॉक्स / कॉन्फिडेंस)
एकल छवि के लिए, ऑब्जेक्ट डिटेक्शन तीन बिंदुओं का एक सेट आउटपुट करता है, प्रत्येक ऑब्जेक्ट के लिए एक:
- क्लास: ऑब्जेक्ट क्या है (पूर्वनिर्धारित श्रेणियों में से एक - "व्यक्ति," "कार," "कुर्सी," इत्यादि)
- बाउंडिंग बॉक्स: ऑब्जेक्ट को घेरने वाला आयत, आमतौर पर केंद्र बिंदु के साथ चौड़ाई और ऊंचाई (x, y, w, h) के रूप में, या ऊपरी-बाएँ/निचले-दाएँ कोनों (x_1, y_1, x_2, y_2) के रूप में दिया जाता है।
- कॉन्फिडेंस: एक स्कोर (0-1) जो यह बताता है कि मॉडल उस विशेष बॉक्स-क्लास युग्मन के बारे में कितना आश्वस्त है।
छवि वर्गीकरण एक ही उत्तर देता है - "यह चित्र किसका है" - लेकिन ऑब्जेक्ट डिटेक्शन को "कितने ऑब्जेक्ट हैं, कहाँ हैं और किस प्रकार के हैं" का उत्तर एक साथ देना होता है। "संख्या स्वयं अज्ञात है" यही विशेषता डिटेक्शन को वर्गीकरण से कहीं अधिक कठिन बनाती है। किसी दी गई छवि में शून्य वस्तुएँ हो सकती हैं, या सौ भी हो सकती हैं - आउटपुट की संख्या परिवर्तनशील होने का यही तथ्य वह डिज़ाइन बाधा है जो नीचे चर्चा की गई लगभग हर तकनीक को संचालित करती है।
3. वास्तव में पहचान कैसे की जाती है?
आउटपुट की परिवर्तनशील संख्या की इस समस्या का सामना करते हुए, लगभग हर आधुनिक पहचान एल्गोरिदम एक ही दो-चरणीय प्रक्रिया का अनुसरण करता है: पूरी छवि से एक फ़ीचर मैप निकालना, उस फ़ीचर मैप को बड़ी संख्या में संभावित स्थानों (एंकर बॉक्स, या बाद में चर्चा की गई ट्रांसफ़ॉर्मर "क्वेरी") से टाइल करना, और प्रत्येक संभावित स्थान के लिए "वस्तु या पृष्ठभूमि" का निर्णय लेना, और यदि वस्तु है, तो "किस वर्ग की है, और उसका सटीक स्थान क्या है।"
चित्र 2 — फ़ीचर एक्सट्रैक्टर (बैकबोन) छवि को एक फ़ीचर मैप में संपीड़ित करता है, और डिटेक्शन हेड इस पर एक साथ वर्गीकरण और बॉक्स रिग्रेशन करता है।
डिटेक्शन हेड के अंदर, दो रिग्रेशन/वर्गीकरण समस्याओं को एक साथ प्रभावी ढंग से हल किया जाता है: "क्या इस संभावित स्थान पर कोई वस्तु है, और यदि हाँ, तो किस वर्ग की," और "इस संभावित (एंकर) को वास्तविक वस्तु के साथ संरेखित करने के लिए कितना स्थानांतरित किया जाना चाहिए।" इन दोनों को एक भारित-योग हानि में संयोजित करना मल्टी-टास्क हानि है जिसका उपयोग फास्ट आर-सीएनएन के बाद से व्यापक रूप से किया जाता है।
यहाँ p अनुमानित वर्ग प्रायिकता है, p^{*} ग्राउंड-ट्रुथ वर्ग है, t अनुमानित बॉक्स करेक्शन है, और t^{*} ग्राउंड-ट्रुथ बॉक्स से प्राप्त लक्ष्य करेक्शन है। सूचक \mathbb{1}[p^{*} > 0] का अर्थ है "केवल उन उम्मीदवारों के लिए स्थान प्रतिगमन त्रुटि की गणना करें जिनमें वास्तव में कोई वस्तु हो, पृष्ठभूमि के लिए नहीं" - पृष्ठभूमि उम्मीदवार के पास प्रतिगमन के लिए कोई ग्राउंड-ट्रुथ बॉक्स नहीं होता है, इसलिए यह प्रतिबंध स्वाभाविक है। \lambda यह निर्धारित करता है कि वर्गीकरण के सापेक्ष प्रतिगमन पद को कितना भार दिया जाए।
4. लैंडमार्क डिटेक्शन एल्गोरिदम
डिटेक्शन एल्गोरिदम के वंश को दो अक्षों के साथ समझना सबसे आसान है: "उम्मीदवार क्षेत्रों को कैसे संकुचित किया जाता है" और "बॉक्स का स्वयं कैसे अनुमान लगाया जाता है।"
आर-सीएनएन (गिरशिक एट अल., 2014) ने क्लासिकल इमेज प्रोसेसिंग एल्गोरिदम सेलेक्टिव सर्च का उपयोग करके एक इमेज से लगभग 2,000 संभावित क्षेत्रों को अलग किया, फिर वर्गीकरण के लिए प्रत्येक क्षेत्र को अलग-अलग सीएनएन से गुजारा। यह विधि सटीक थी, लेकिन बेहद धीमी थी, क्योंकि सीएनएन को प्रत्येक संभावित क्षेत्र के लिए एक बार चलाना पड़ता था।
फास्ट आर-सीएनएन (गिरशिक, 2015) ने एक सिंगल फीचर मैप बनाने के लिए पूरी इमेज को केवल एक बार सीएनएन से गुजारा, फिर उस फीचर मैप से संभावित क्षेत्रों को क्रॉप किया (आरओआई पूलिंग) - जिससे प्रत्येक क्षेत्र के लिए अनावश्यक गणना समाप्त हो गई।
फास्टर आर-सीएनएन (रेन, हे, गिरशिक, सन, 2015) ने एक कदम आगे बढ़कर संभावित क्षेत्र निर्माण को ही एक छोटे रीजन प्रपोज़ल नेटवर्क (आरपीएन) से बदल दिया, जिससे प्रपोज़ल निर्माण, वर्गीकरण और रिग्रेशन एक ही नेटवर्क में समाहित हो गए। ये तीनों पीढ़ियाँ मिलकर दो-चरण डिटेक्टर कहलाने वाले सिस्टम की वंशावली बनाती हैं।
एसएसडी (लियू एट अल., 2016) और योलो (रेडमोन एट अल., 2015-2016) ने एक-चरण डिटेक्टरों का मार्ग प्रशस्त किया, जिसमें उम्मीदवार-क्षेत्र चरण को पूरी तरह से हटा दिया गया और फीचर मैप पर प्रत्येक स्थान से सीधे वर्ग और बॉक्स का अनुमान लगाया गया। गति में नाटकीय रूप से वृद्धि हुई, हालांकि प्रारंभिक योलो छोटे ऑब्जेक्ट की सटीकता में दो-चरण डिटेक्टरों से पीछे रहा।
रेटिनानेट (लिन एट अल., 2017) ने एक-चरण डिटेक्टरों में व्याप्त वर्ग असंतुलन की समस्या का समाधान किया - पृष्ठभूमि उम्मीदवारों की संख्या ऑब्जेक्ट उम्मीदवारों से कहीं अधिक होती है, और प्रशिक्षण पर उनका प्रभुत्व रहता है - एक नए हानि फ़ंक्शन, फोकल लॉस के साथ, यह दिखाते हुए कि एक-चरण डिटेक्टर अंततः दो-चरण डिटेक्टरों की सटीकता के बराबर हो सकते हैं।
FCOS (टियान एट अल., 2019) पूरी तरह से एंकर-मुक्त हो गया: विभिन्न आकारों और आस्पेक्ट रेशियो वाले एंकर बॉक्स के एक सेट को पहले से परिभाषित करने के बजाय, यह प्रत्येक फीचर-मैप पिक्सेल से ऑब्जेक्ट की सीमा तक की दूरी को सीधे रिग्रेस करता है, जिससे एंकर डिज़ाइन के लिए आवश्यक हाइपरपैरामीटर ट्यूनिंग की आवश्यकता समाप्त हो जाती है।
DETR, डिफॉर्मेबल DETR और DINO ट्रांसफॉर्मर के साथ डिटेक्शन को एक सेट-प्रेडिक्शन समस्या के रूप में पुनर्परिभाषित करते हैं - जो अगले अनुभाग का विषय है।
5. दो-चरणीय बनाम एक-चरणीय
दो-चरणीय और एक-चरणीय डिटेक्टर एक ही प्रश्न पर विभाजित होते हैं: क्या कैंडिडेट-रीजन नैरोइंग अपने आप में एक स्वतंत्र चरण के रूप में मौजूद है?
| आस्पेक्ट | दो-चरणीय (जैसे फास्टर आर-सीएनएन) | एक-चरणीय (जैसे YOLO) |
|---|---|---|
| फ्लो | प्रस्ताव निर्माण (RPN) → प्रति-क्षेत्र वर्गीकरण और प्रतिगमन | फ़ीचर मानचित्र पर प्रत्येक स्थान पर सीधे वर्गीकरण और प्रतिगमन |
सटीकता | सामान्यतः उच्च, विशेषकर छोटे/घने ऑब्जेक्ट्स पर | हाल की पीढ़ियों ने अधिकांश अंतर को कम कर दिया है |
अनुमान गति | अपेक्षाकृत धीमी (प्रति-उम्मीदवार कार्य शेष रहता है) | तेज़, वास्तविक समय के लिए उपयुक्त |
गणना लागत | उम्मीदवारों की संख्या के साथ बढ़ती है | छवि आकार के लगभग समानुपाती, पूर्वानुमान योग्य |
कार्यान्वयन/ट्यूनिंग कठिनाई | अधिक चरण, अधिक जटिल | सरल पाइपलाइन |
उपयोग | ऑफ़लाइन प्रसंस्करण, सटीकता-प्रथम निरीक्षण/विश्लेषण | वाहनों और रोबोटों में वास्तविक समय बोध |
दोनों परिवार लंबे समय से अतिव्यापी उम्मीदवारों को कम करने के लिए पोस्ट-प्रोसेसिंग के रूप में नॉन-मैक्सिमम सप्रेशन (NMS) पर निर्भर रहे हैं। किसी एक वस्तु के लिए उत्पन्न कई संभावित बॉक्सों में से, किसी भी बॉक्स का दूसरे बॉक्स के साथ ओवरलैप (IoU: इंटरसेक्शन ओवर यूनियन) एक निश्चित सीमा से अधिक होने पर उसे इस परिभाषा के अनुसार हटा दिया जाता है:
A और B वे क्षेत्र हैं जिनमें दो बॉक्स स्थित हैं; उनके ओवरलैप क्षेत्र को उनके यूनियन क्षेत्र से विभाजित करने पर 0 और 1 के बीच का स्कोर प्राप्त होता है। उच्च IoU यह संकेत देता है कि दोनों बॉक्स संभवतः एक ही वस्तु की ओर इशारा कर रहे हैं, इसलिए कम आत्मविश्वास वाले बॉक्स को हटा दिया जाता है। NMS काम करता है, लेकिन यह घनी वस्तुओं पर गलत परिणाम दे सकता है - यह एक कमजोरी है जिसे DETR परिवार, जिसकी चर्चा आगे की जाएगी, पूरी तरह से दूर करता है।
6. ट्रांसफॉर्मर युग में पहचान (DETR / डिफॉर्मेबल DETR / DINO)
DETR (कैरियन एट अल., 2020, फेसबुक AI) ने पहचान के मूल स्वरूप को ही बदल दिया। बिना एंकर और बिना एनएमएस के, यह इमेज फीचर्स को ट्रांसफॉर्मर एनकोडर से गुजारता है और एक निश्चित संख्या में "क्वेरी" (उम्मीदवार वस्तुओं के लिए सीखने योग्य वैक्टर) को डिकोडर से गुजारता है, जिससे सीधे उतनी ही बॉक्स-क्लास जोड़ियाँ आउटपुट होती हैं। प्रशिक्षण के दौरान, अनुमानित सेट और ग्राउंड-ट्रुथ सेट को हंगेरियन एल्गोरिदम के माध्यम से एक-से-एक मिलाया जाता है, और उस मिलान के आधार पर हानि की गणना की जाती है।
y_i i -वां ग्राउंड-ट्रुथ ऑब्जेक्ट है, \hat{y}_{\sigma(i)} क्रमचय \sigma के तहत इसे सौंपा गया अनुमान है, और \mathfrak{S}_N N तत्वों के सभी क्रमचयों का सेट है। इसका अर्थ है: न्यूनतम कुल लागत पर ग्राउंड ट्रुथ्स को एक-से-एक आधार प्रदान करने वाला क्रमचय \hat{\sigma} ज्ञात कीजिए — यह निर्धारण हो जाने के बाद ही सामान्य वर्गीकरण और प्रतिगमन हानियों की गणना की जा सकती है। चूंकि किसी भी वस्तु को एक से अधिक भविष्यवाणी नहीं दी जा सकती, इसलिए संरचना के अनुसार NMS अनावश्यक हो जाता है।
DETR की एक कमी थी: पूरी छवि पर पूर्ण स्व-ध्यान महंगा होता है, और मॉडल को अभिसरण के लिए बड़ी संख्या में प्रशिक्षण युगों की आवश्यकता होती थी। डिफॉर्मेबल DETR (ज़ू एट अल., 2020) ने एक डिफॉर्मेबल ध्यान तंत्र प्रस्तुत किया, जिसमें प्रत्येक क्वेरी पूरी छवि के बजाय केवल नमूना बिंदुओं के एक छोटे, सीखे हुए समूह पर ध्यान देती है, जिससे गणना लागत कम होती है और अभिसरण में तेजी आती है। DINO (झांग एट अल., 2022; "बेहतर डीनोइज़िंग एंकर बॉक्स के साथ DETR") ने प्रशिक्षण स्थिरता के लिए कंट्रास्टिव डीनोइज़िंग क्वेरी और फीचर मैप से सीड क्वेरी इनिशियलाइज़ेशन के लिए मिक्स्ड क्वेरी सिलेक्शन जैसी तकनीकें जोड़ीं, जिससे उस समय DETR-परिवार के डिटेक्टरों में सर्वश्रेष्ठ सटीकता प्राप्त हुई। ट्रांसफ़ॉर्मर-आधारित डिटेक्टर अब YOLO परिवार के साथ उत्पादन उपयोग में दो प्रमुख दिशाओं में से एक हैं।
7. सिमेंटिक सेगमेंटेशन क्या है?
सिमेंटिक सेगमेंटेशन किसी छवि के प्रत्येक पिक्सेल के लिए यह अनुमान लगाता है कि वह किस वर्ग से संबंधित है। इसका आउटपुट बाउंडिंग बॉक्स नहीं है - यह इनपुट छवि के समान रिज़ॉल्यूशन वाला एक "क्लास मैप" है, जहाँ प्रत्येक पिक्सेल एक क्लास ID रखता है।
जहाँ ऑब्जेक्ट डिटेक्शन किसी वस्तु को एक मोटे आयत से अनुमानित करता है, वहीं सिमेंटिक सेगमेंटेशन पिक्सेल रिज़ॉल्यूशन पर वस्तु की वास्तविक रूपरेखा को दर्शा सकता है - यह पतले, लंबे आकार जैसे फुटपाथ, या जटिल रूपरेखा जैसे पेड़ की शाखाओं के लिए एक वास्तविक ताकत है। इसका नुकसान यह है कि एक ही श्रेणी के कई उदाहरण एक फ्रेम में दिखाई देने पर भी, सिमेंटिक सेगमेंटेशन उन्हें अलग नहीं कर पाता — सभी "व्यक्ति" पिक्सेल एक ही रंग में रंगे जाते हैं, और व्यक्तियों की संख्या का पता नहीं चल पाता। इस अंतर को दूर करने के लिए ही इंस्टेंस सेगमेंटेशन का उपयोग किया जाता है, जिसके बारे में नीचे विस्तार से बताया गया है।
8. महत्वपूर्ण सेगमेंटेशन एल्गोरिदम
FCN (फुल्ली कनवोल्यूशनल नेटवर्क; लॉन्ग, शेलहैमर, डैरेल, 2015) ने एक इमेज-क्लासिफिकेशन CNN से फुल्ली-कनेक्टेड लेयर्स को हटा दिया, जिससे केवल कनवोल्यूशनल लेयर्स ही रह गईं, ताकि नेटवर्क किसी भी आकार के इनपुट के लिए सीधे पिक्सेल-वार भविष्यवाणियां कर सके। यह इस क्षेत्र का आरंभिक बिंदु है — सिमेंटिक सेगमेंटेशन को एक एकल, संपूर्ण प्रशिक्षण योग्य नेटवर्क के रूप में स्थापित करने वाला पहला डिज़ाइन।
मेडिकल इमेज सेगमेंटेशन के लिए प्रस्तावित U-Net (रोनबर्गर एट अल., 2015) में, एक एनकोडर (फीचर्स निकालते समय डाउनसैंपलिंग) को एक डिकोडर (रिकंस्ट्रक्शन करते समय अपसैंपलिंग) के साथ सममित रूप से व्यवस्थित किया जाता है, और समान रिज़ॉल्यूशन वाले एनकोडर और डिकोडर लेयर्स को "स्किप कनेक्शन" के माध्यम से सीधे जोड़ा जाता है। यह डिज़ाइन - बारीक बाउंड्री डिटेल्स को संरक्षित करते हुए भी उच्च-रिज़ॉल्यूशन आउटपुट प्रदान करता है - एक मानक आर्किटेक्चर बन गया जो चिकित्सा क्षेत्र से परे भी व्यापक रूप से फैल गया।
SegNet (बद्रिनारायणन एट अल.) एनकोडर पूलिंग के दौरान, ठीक उसी स्थिति को याद रखता है जिसमें अधिकतम मान था ("पूलिंग इंडेक्स"), फिर डिकोडर अपसैंपलिंग के दौरान उस रिकॉर्ड का पुन: उपयोग करता है, जिससे मेमोरी-कुशलता से बाउंड्रीज़ को पुनर्स्थापित किया जा सकता है। PSPNet* (झाओ एट अल., 2017) ने एक पिरामिड पूलिंग मॉड्यूल पेश किया जो कई पैमानों पर क्षेत्रों में फीचर्स का औसत निकालता है, जिससे संपूर्ण इमेज संदर्भ को कैप्चर किया जा सकता है जिसे केवल एक संकीर्ण रिसेप्टिव फील्ड से नहीं समझा जा सकता।
डीपलैब श्रृंखला (चेन एट अल.) ने अपने मूल स्वरूप को डायलेटेड (एट्रस) कनवोल्यूशन पर आधारित किया है — कर्नेल टैप के बीच के अंतराल को फैलाकर रिसेप्टिव फील्ड को बढ़ाया है, जिससे रिज़ॉल्यूशन में कोई कमी नहीं आती — और यह v1 से v3+ (2018) तक विकसित हुई है। एचआरनेट (वांग एट अल., 2019) ने सामान्य दृष्टिकोण को उलट दिया: डाउनसैंपलिंग और फिर रिज़ॉल्यूशन को बहाल करने के बजाय, यह पूरे नेटवर्क में समानांतर रूप से एक उच्च-रिज़ॉल्यूशन फीचर स्ट्रीम को सक्रिय रखता है, और लगातार विभिन्न रिज़ॉल्यूशन में जानकारी का आदान-प्रदान करता है।
सेगफॉर्मर (क्सी एट अल., 2021) ने एक पदानुक्रमित ट्रांसफॉर्मर एनकोडर को एक हल्के एमएलपी-ओनली डिकोडर के साथ जोड़ा, और बेहद सरल डिज़ाइन के साथ उच्च सटीकता और दक्षता हासिल की। Mask2Former (चेंग एट अल., 2022) ने सेगमेंटेशन को "निश्चित संख्या में क्वेरीज़, जिनमें से प्रत्येक एक मास्क और एक क्लास का अनुमान लगाती है" के रूप में पुनर्परिभाषित किया, और प्रत्येक क्वेरी के ध्यान को पिछली परत में अनुमानित मास्क क्षेत्र तक "मास्क्ड अटेंशन" के माध्यम से सीमित किया - जिससे तेज़ अभिसरण और एक ही आर्किटेक्चर मिलता है जो सिमेंटिक, इंस्टेंस और पैनोप्टिक सेगमेंटेशन को समान रूप से संभालता है।
9. डिटेक्शन / सिमेंटिक / इंस्टेंस / पैनोप्टिक की तुलना
अब तक बताए गए चार कार्य दो अक्षों पर व्यवस्थित करने पर स्पष्ट हो जाते हैं: क्या यह एक ही क्लास के अलग-अलग इंस्टेंस में अंतर कर पाता है, और क्या यह "बैकग्राउंड" - सड़क, आकाश या दीवार जैसी अनगिनत चीज़ों को संभाल पाता है।
| कार्य | आउटपुट इकाई | इंस्टेंस में अंतर | बैकग्राउंड को संभालना | लैंडमार्क एल्गोरिदम | मुख्य मीट्रिक |
|---|---|---|---|---|---|
| ऑब्जेक्ट डिटेक्शन | बाउंडिंग बॉक्स | हां (प्रति इंस्टेंस एक बॉक्स) | नहीं | फास्टर आर-सीएनएन, योलो, डीईटीआर | मैप |
सिमेंटिक सेगमेंटेशन | प्रति-पिक्सेल क्लास लेबल | नहीं (समान क्लास एक रंग में विलीन हो जाती है) | हां | एफसीएन, डीपलैब, सेगफॉर्मर | एमआईओयू |
इंस्टेंस सेगमेंटेशन | प्रति-पिक्सेल मास्क | हां (प्रति इंस्टेंस अलग मास्क) | नहीं | मास्क आर-सीएनएन, मास्क2फॉर्मर | एपी (मास्क-आईओयू आधारित) |
पैनोप्टिक सेगमेंटेशन | प्रति-पिक्सेल क्लास + इंस्टेंस आईडी | हां (केवल फोरग्राउंड) | हां (केवल क्लास, कोई इंस्टेंस आईडी नहीं) | पैनोप्टिक एफपीएन, मास्क2फॉर्मर | पीक्यू (पैनोप्टिक क्वालिटी) |
जैसा कि तालिका से स्पष्ट है, पैनोप्टिक सेगमेंटेशन (किरिलोव एट अल., 2019 द्वारा प्रस्तावित) इंस्टेंस और सिमेंटिक सेगमेंटेशन दोनों का "सर्वोत्तम संयोजन" है। अग्रभूमि वस्तुएँ — जैसे लोग और कारें, जिन्हें गिना जा सकता है — को इंस्टेंस सेगमेंटेशन की तरह प्रत्येक उदाहरण के आधार पर अलग-अलग किया जाता है; पृष्ठभूमि — जैसे सड़क और आकाश, जिन्हें गिना नहीं जा सकता — को सिमेंटिक सेगमेंटेशन की तरह केवल एक वर्ग लेबल दिया जाता है। यदि आप किसी एक छवि का पूर्ण और व्यापक वर्णन करने का प्रयास करते हैं, तो आप अंततः इसी व्यापक रूप में पहुँच जाते हैं — यह देखने का एक उपयोगी तरीका है कि चारों कार्य आपस में कैसे संबंधित हैं।
मूल्यांकन मीट्रिक mIoU (मीन इंटरसेक्शन ओवर यूनियन) प्रत्येक वर्ग c के लिए, ग्राउंड-ट्रुथ क्षेत्र G_c और अनुमानित क्षेत्र P_c के बीच IoU की गणना करता है, और फिर सभी वर्गों का औसत निकालता है।
जहाँ डिटेक्शन का mAP बॉक्स स्तर पर सहमति का आकलन करता है, वहीं mIoU पिक्सेल स्तर पर सहमति का आकलन करता है — मीट्रिक में यह अंतर ठीक उसी अंतर को दर्शाता है जिसे प्रत्येक कार्य "सही" मानता है।
10. 3D ऑब्जेक्ट डिटेक्शन
स्वायत्त वाहनों और रोबोटों को अक्सर किसी वस्तु की 3D स्थिति, आकार और अभिविन्यास का पता सीधे LiDAR पॉइंट क्लाउड से लगाने की आवश्यकता होती है, न कि केवल 2D छवियों से। एक पॉइंट क्लाउड में 2D छवि की तरह ग्रिड संरचना नहीं होती है, इसलिए एक CNN इसे सीधे तौर पर संसाधित नहीं कर सकता है - इस अनियमित डेटा को नियमित डेटा में परिवर्तित करना ही 3D ऑब्जेक्ट डिटेक्शन में केंद्रीय डिज़ाइन चुनौती है।
दूसरा (यान एट अल., 2018) एक पॉइंट क्लाउड को 3D वोक्सेल (घन कोशिकाओं) में विभाजित करता है और विरल कनवोल्यूशन का उपयोग करके उन वोक्सेल के बड़े हिस्से को छोड़ देता है जिनमें कोई बिंदु नहीं होते हैं, जिससे 3D CNN की गणना लागत में भारी कमी आती है। पॉइंटपिलर्स (लैंग एट अल., 2019) ने इसे और सरल बनाया, जिसमें बिंदुओं को वोक्सेल के बजाय ऊर्ध्वाधर "स्तंभों" में एकत्रित किया गया ताकि नेटवर्क उन्हें 3D के बजाय सामान्य 2D कनवोल्यूशन के साथ संसाधित कर सके, जिससे गति में उल्लेखनीय वृद्धि हुई।
पीवी-आरसीएनएन (शी एट अल., 2020) ने एक हाइब्रिड पॉइंट-वोक्सेल डिज़ाइन में वोक्सेल-आधारित प्रसंस्करण की दक्षता को सीधे बिंदुओं को संसाधित करने (पॉइंटनेट-शैली) से प्राप्त सटीक स्थानीयकरण के साथ संयोजित किया। सेंटरपॉइंट (यिन एट अल., 2021) ने 3D पहचान के लिए एक एंकर-मुक्त दृष्टिकोण प्रस्तुत किया: किसी वस्तु को एक एकल केंद्र बिंदु के रूप में पहचानें, फिर वहां से चौड़ाई, ऊंचाई, गहराई और अभिविन्यास का प्रतिगमन करें, और उच्च सटीकता के लिए इसे पॉइंटपिलर्स- या वोक्सेलनेट-शैली के बैकबोन के साथ जोड़ें।
इनमें से कई विधियों में एक और समान डिज़ाइन विचार है: डिटेक्शन हेड चलाने से पहले पॉइंट-क्लाउड जानकारी को बर्ड्स-आई व्यू (बीईवी) में प्रोजेक्ट करना — एक 2डी फीचर मैप जिसे सीधे ऊपर से देखा जाता है। ऊंचाई की जानकारी को संपीड़ित करने से कुछ विवरण कम हो जाते हैं, लेकिन इसके बदले में "यह वस्तु सड़क की सतह पर कहाँ स्थित है" — वह संबंध जो ड्राइविंग के लिए सबसे महत्वपूर्ण है — को एक साधारण 2डी डिटेक्टर के समान ढांचे के भीतर संभालने की क्षमता मिलती है।
11. 3डी सिमेंटिक सेगमेंटेशन
3डी सिमेंटिक सेगमेंटेशन पॉइंट क्लाउड के प्रत्येक बिंदु (या लिडार से प्राप्त प्रत्येक लेजर रिटर्न) को एक क्लास लेबल प्रदान करता है। एक बार फिर, अनियमित पॉइंट-क्लाउड डेटा को कैसे हैंडल किया जाए, यही मुख्य दृष्टिकोणों को अलग करता है।
पॉइंटनेट++ (क्यूई एट अल., 2017) बिंदुओं को बिना किसी वोक्सेलाइजेशन या अन्य रूपांतरण के सीधे नेटवर्क में फीड करता है, पड़ोसी बिंदुओं को समूहित करता है और विशेषताओं को पदानुक्रमित रूप से एकत्रित करता है — जो बिंदु-आधारित विधियों की नींव रखता है। RandLA-Net (हू एट अल., 2020) ने पड़ोसी-खोज की उस बाधा को दूर किया जिसके कारण बड़े पैमाने पर पॉइंट क्लाउड प्रोसेसिंग महंगी हो जाती थी। इसने रैंडम सैंपलिंग को एक स्थानीय फीचर-एग्रीगेशन मॉड्यूल के साथ जोड़ा, जो रैंडम सैंपलिंग के कारण खोई हुई जानकारी की भरपाई करता है, जिससे शहरी स्तर के पॉइंट क्लाउड पर भी व्यावहारिक गति प्राप्त होती है।
RangeNet++ (मिलियोटो एट अल., 2019) 3D प्रोसेसिंग को पूरी तरह से छोड़ देता है: यह LiDAR के अपने स्कैन ऑर्डरिंग का उपयोग करके पॉइंट क्लाउड को 2D "रेंज इमेज" में प्रोजेक्ट करता है, उस पर एक सामान्य 2D CNN चलाता है, और परिणाम को वापस 3D में प्रोजेक्ट करता है - गति के लिए 2D CNN टूलिंग की परिपक्वता का लाभ उठाते हुए। Cylinder3D (झू एट अल., 2021) ने पाया कि बाहरी LiDAR पॉइंट क्लाउड सेंसर से बाहर की ओर फैलते हैं, और रेंज में घनत्व में होने वाली गिरावट को संभालने के लिए कार्टेशियन निर्देशांक के बजाय बेलनाकार निर्देशांक में वोक्सेलाइज़ किया गया। SPVNAS (टैंग एट अल., 2020) ने स्पार्स पॉइंट-वोक्सेल कनवोल्यूशन के माध्यम से पॉइंट-आधारित और वोक्सेल-आधारित प्रोसेसिंग को एकीकृत किया, फिर न्यूरल आर्किटेक्चर सर्च (NAS) का उपयोग करके सटीकता/गति के बीच मजबूत संतुलन के साथ कॉन्फ़िगरेशन को स्वचालित रूप से खोजा।
2D मामले की तरह, 3D सिमेंटिक सेगमेंटेशन के इतिहास को "पॉइंट्स को पॉइंट्स के रूप में रखना" (पॉइंट-आधारित) और "नियमित ग्रिड में बदलना" (वोक्सेल- या रेंज-इमेज-आधारित) के बीच आगे-पीछे की प्रक्रिया के रूप में समझा जा सकता है, जिनमें से प्रत्येक सटीकता, गति और मेमोरी के बीच अलग-अलग संतुलन बनाती है।
12. व्यवहार में सही दृष्टिकोण का चयन
डिटेक्शन या सेगमेंटेशन में से किसका उपयोग करना है, और कौन सा विशिष्ट एल्गोरिदम, उपयोग के मामले पर बहुत अधिक निर्भर करता है।
-
रोबोटिक आर्म्स / पिकिंग: पकड़ने के लिए लक्ष्य की सटीक रूपरेखा जानना महत्वपूर्ण है, इसलिए इंस्टेंस सेगमेंटेशन (जैसे Mask2Former) सबसे उपयुक्त है — केवल बाउंडिंग बॉक्स से वस्तु का वास्तविक आकार या पकड़ने का सटीक बिंदु पता नहीं चलता।
-
स्वायत्त ड्राइविंग: वास्तविक समय का प्रदर्शन अनिवार्य है, इसलिए 2D के लिए वन-स्टेज डिटेक्टर (YOLO परिवार) और 3D के लिए दक्षता-केंद्रित BEV-आधारित 3D डिटेक्टर जैसे PointPillars या CenterPoint का उपयोग किया जाता है। ड्राइव करने योग्य क्षेत्र को समझने के लिए अक्सर सिमेंटिक/पैनोप्टिक सेगमेंटेशन को इसके ऊपर लागू किया जाता है।
-
निगरानी / सुरक्षा कैमरे: लक्ष्य श्रेणियों (लोग, वाहन) का समूह आमतौर पर सीमित होता है, और किसी भी डिटेक्शन का न होना कच्ची गति से कहीं अधिक महत्वपूर्ण होता है, जिससे टू-स्टेज डिटेक्टर या उच्च-सटीकता वाले ट्रांसफॉर्मर-आधारित डिटेक्टरों का उपयोग संभव हो पाता है।
-
AR/VR: वास्तविक दुनिया में किसी आभासी वस्तु को कहाँ स्थापित करना है, यह तय करने के लिए आमतौर पर प्लेन और ऑब्जेक्ट क्षेत्रों की पहचान करने हेतु सिमेंटिक सेगमेंटेशन का उपयोग किया जाता है, फिर सटीक 3D संरेखण के लिए सेंसर फ्यूजन (सहयोगी लेख देखें) लागू किया जाता है।
सीमित संसाधनों वाले एज डिवाइसों पर, गति और आकार आमतौर पर सटीकता से अधिक महत्वपूर्ण होते हैं — हल्के YOLO वेरिएंट या पतला SegFormer। सटीक ऑफ़लाइन विश्लेषण (चिकित्सा इमेजिंग, उपग्रह इमेजिंग) के लिए, सटीकता सर्वोपरि होती है, जिसके लिए दो-चरण डिटेक्टर या Mask2Former-श्रेणी के मॉडल उपयुक्त होते हैं। व्यवहार में, वास्तविक समय प्रदर्शन और सटीकता के बीच का यह संतुलन ही निर्णय लेने में सबसे महत्वपूर्ण कारक होता है।
नवीनतम विकासों के लिए — NMS-मुक्त आर्किटेक्चर, ओपन-वोकैबुलरी डिटेक्शन, सेगमेंट एनीथिंग परिवार के मूलभूत मॉडल — ऑब्जेक्ट डिटेक्शन में प्रौद्योगिकी रुझान और सिमेंटिक सेगमेंटेशन में प्रौद्योगिकी रुझान देखें।
13. सारांश
ऑब्जेक्ट डिटेक्शन वस्तुओं को आयतों के रूप में कैप्चर करता है; सिमेंटिक सेगमेंटेशन उन्हें पिक्सेल दर पिक्सेल कैप्चर करता है — दो छवि-समझने के कार्य जो अलग-अलग रिज़ॉल्यूशन पर काम करते हैं। डिटेक्शन का इतिहास दो-चरण (फास्टर आर-सीएनएन) से शुरू होकर एक-चरण (योलो) से होते हुए ट्रांसफ़ॉर्मर-आधारित डिटेक्टरों तक जाता है जो एंकर और NMS को पूरी तरह से हटा देते हैं (डीईटीआर/डीएनओ); सेगमेंटेशन का इतिहास एफसीएन से शुरू होकर यू-नेट और डीपलाब से होते हुए ट्रांसफ़ॉर्मर-आधारित सेगफ़ॉर्मर/मास्क2फ़ॉर्मर तक जाता है। उस आधार के ऊपर इंस्टेंस सेगमेंटेशन है, जो प्रति-वस्तु भेद प्रदान करता है, पैनोप्टिक सेगमेंटेशन है, जो दोनों को एकीकृत करता है, और उनके 3डी, पॉइंट-क्लाउड-आधारित समकक्ष हैं — और इनमें से किसे चुनना है, यह हमेशा इस बात पर निर्भर करता है कि उस समय सटीकता की आवश्यकता है या गति की।
डिटेक्शन और सेगमेंटेशन में क्या अंतर है?
डिटेक्शन आमतौर पर बॉक्स और क्लास लौटाता है; सेगमेंटेशन पिक्सेल क्षेत्र लौटाता है।
स्थान, रूपरेखा और उदाहरण-पहचान की आवश्यकताओं के अनुसार चुनें। ## संदर्भ - [COCO — Common Objects in Context](https://cocodataset.org/) - [Detectron2 (Facebook AI Research)](https://github.com/facebookresearch/detectron2) - [Carion et al., "End-to-End Object Detection with Transformers" (DETR)](https://arxiv.org/abs/2005.12872)
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।