Contents — find the section you need
Sebelum robot dapat "mengambil cangkir di atas meja" atau "menghindari pejalan kaki di depan," ia terlebih dahulu harus memahami, dari gambar kamera, apa yang ada di sana dan di mana letaknya. Pemahaman itu adalah tugas Deteksi Objek dan Segmentasi Semantik. Keduanya sering disebut bersamaan, tetapi keduanya berbeda secara mendasar — baik dalam seberapa detail outputnya maupun dalam bagaimana masalah yang mendasarinya dirumuskan. Artikel ini membangun keduanya dari dasar, melalui padanan 3D-nya dan perbandingan langsung yang jelas.
 Kamera persepsi kendaraan
Gambar: Car kamera jendela sistem Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Kamera input representatif, bukan klaim tentang spesifikasi produk terbaru.

0. Apa yang Dibahas Artikel Ini
- Apa yang sebenarnya dihasilkan oleh Deteksi Objek dan Segmentasi Semantik
- Alur kerja Deteksi (ekstraksi fitur → kepala deteksi)
- Garis keturunan algoritma penting dari R-CNN hingga YOLO, DETR, dan DINO, dan bagaimana filosofi desainnya berbeda
- Pertimbangan Dua Tahap vs. Satu Tahap, dan di mana detektor berbasis Transformer cocok
- Bagaimana algoritma Segmentasi berevolusi dari FCN ke Mask2Former
- Sebuah tabel tunggal yang membuat perbedaan antara Deteksi, Semantik, Instans, dan Segmentasi Panoptik menjadi jelas
- Dasar-dasar Deteksi Objek 3D dan Segmentasi Semantik 3D pada awan titik
- Cara memilih teknologi yang tepat untuk robotika, pengemudian otonom, pengawasan, dan AR
1. Jawaban Singkat: Apa Itu Deteksi dan Segmentasi
Dalam satu kalimat: Deteksi Objek menjawab "di mana dalam gambar apa" dengan persegi panjang (sebuah Segmentasi Instans (misalnya, segmentasi gambar dengan kotak pembatas), sedangkan Segmentasi Semantik menjawab "apa setiap piksel" dengan mewarnai gambar.** Keduanya memiliki tujuan mendasar yang sama — memahami gambar — tetapi menjawab pada resolusi yang sangat berbeda.
Dua tugas selanjutnya dibangun di atas pasangan ini. Segmentasi Instans mewarnai piksel seperti Segmentasi Semantik, tetapi juga membedakan objek individual dari kelas yang sama (misalnya, tiga orang terpisah dalam satu bingkai). Segmentasi Panoptik menyatukan Segmentasi Instans dengan Segmentasi Semantik yang dibutuhkan untuk hal-hal latar belakang yang "tak terhitung" seperti jalan atau langit, menjadi satu keluaran yang paling lengkap. Bagian 9 di bawah ini menjabarkan bagaimana keempatnya berhubungan dalam sebuah tabel.
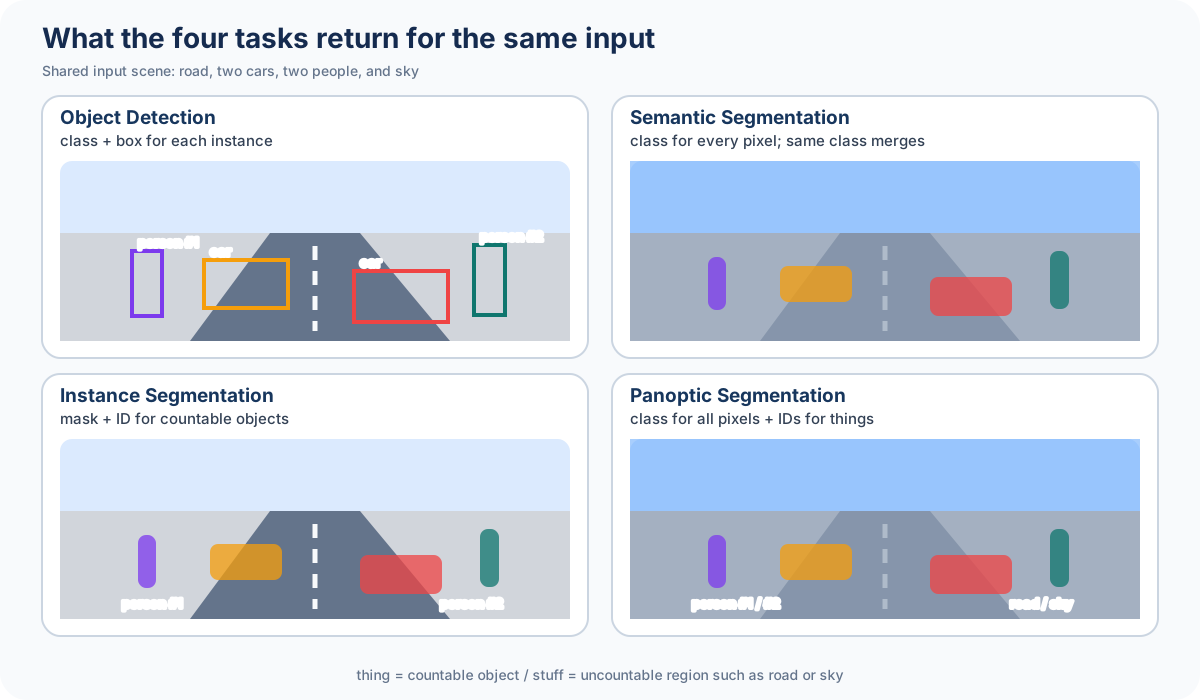
Gambar: Duskcoil. Dihasilkan dari satu adegan skematis dan geometri bersama; bukan output model terukur.
2. Apa Itu Deteksi Objek? (Kelas / Kotak Pembatas / Kepercayaan)
Untuk satu gambar, Deteksi Objek menghasilkan serangkaian triple, satu per objek:
- Kelas: jenis objek (salah satu dari serangkaian kategori yang telah ditentukan sebelumnya — "orang," "mobil," "kursi," dan sebagainya)
- Kotak Pembatas: persegi panjang yang mengelilingi objek, biasanya diberikan sebagai titik tengah ditambah lebar dan tinggi (x, y, w, h) , atau sebagai sudut kiri atas/kanan bawah (x_1, y_1, x_2, y_2)
- Kepercayaan: skor (0–1) untuk seberapa yakin model tersebut tentang pasangan kotak-kelas tertentu
Klasifikasi Gambar mengembalikan satu jawaban — "gambar apa ini" — tetapi Deteksi Objek harus menjawab "berapa banyak objek, di mana, dan jenis apa" sekaligus. Sifat "jumlahnya sendiri tidak diketahui" inilah yang membuat Deteksi pada dasarnya lebih sulit daripada klasifikasi. Suatu gambar mungkin berisi nol objek, atau seratus — fakta bahwa jumlah output bervariasi adalah batasan desain yang mendorong hampir semua trik yang dibahas di bawah ini.
3. Bagaimana Deteksi Sebenarnya Dilakukan?
Menghadapi masalah jumlah output yang bervariasi tersebut, pada dasarnya setiap algoritma Deteksi modern mengikuti alur kerja dua tahap yang sama: mengekstrak peta fitur dari seluruh gambar, menyusun peta fitur tersebut dengan sejumlah besar lokasi kandidat (kotak jangkar, atau "kueri" Transformer yang akan dibahas nanti), dan untuk setiap kandidat memutuskan "objek atau latar belakang," dan jika objek, "kelas mana, dan di mana lokasi tepatnya."
Gambar 2 — Ekstraktor fitur (backbone) mengompres gambar menjadi peta fitur, dan kepala deteksi melakukan klasifikasi dan regresi kotak di atasnya secara bersamaan.
Di dalam kepala deteksi, dua masalah regresi/klasifikasi secara efektif diselesaikan sekaligus: "apakah ada objek di lokasi kandidat ini, dan jika ya, kelas apa," dan "seberapa banyak kandidat ini (jangkar) harus digeser agar sejajar dengan objek sebenarnya." Menggabungkan ini menjadi satu kerugian penjumlahan berbobot adalah kerugian multi-tugas yang banyak digunakan mulai dari Fast R-CNN dan seterusnya.
Di sini p adalah probabilitas kelas yang diprediksi, p^{*} adalah kelas sebenarnya (ground-truth), t adalah koreksi kotak yang diprediksi, dan t^{*} adalah koreksi target yang berasal dari kotak sebenarnya. Indikator \mathbb{1}[p^{*} > 0] berarti "hanya hitung kesalahan regresi lokasi untuk kandidat yang benar-benar mengandung objek, bukan latar belakang" — kandidat latar belakang tidak memiliki kotak sebenarnya untuk diregresikan, jadi pembatasan ini wajar. \lambda menyesuaikan seberapa besar bobot yang diberikan pada istilah regresi relatif terhadap klasifikasi.
4. Algoritma Deteksi Landmark
Silsilah algoritma Deteksi paling mudah diikuti sepanjang dua sumbu: "bagaimana wilayah kandidat dipersempit" dan "bagaimana kotak itu sendiri diprediksi."
R-CNN (Girshick dkk., 2014) memotong sekitar 2.000 wilayah kandidat dari sebuah gambar menggunakan algoritma pemrosesan gambar klasik Selective Search, kemudian menjalankan masing-masing wilayah tersebut melalui CNN secara individual untuk klasifikasi. Akurat, tetapi sangat lambat, karena CNN harus dijalankan sekali untuk setiap wilayah kandidat.
Fast R-CNN (Girshick, 2015) menjalankan seluruh gambar melalui CNN hanya sekali untuk membangun peta fitur tunggal, kemudian memotong wilayah kandidat dari peta fitur itu (RoI Pooling) — menghilangkan komputasi per wilayah yang berlebihan.
Faster R-CNN (Ren, He, Girshick, Sun, 2015) melangkah lebih jauh dan mengganti pembangkitan wilayah kandidat itu sendiri dengan Region Proposal Network (RPN) kecil, menggabungkan pembangkitan proposal, klasifikasi, dan regresi ke dalam satu jaringan. Ketiga generasi ini bersama-sama membentuk garis keturunan dari apa yang disebut Detektor Dua Tahap.
SSD (Liu dkk., 2016) dan YOLO (Redmon dkk., 2015–2016) mempelopori detektor satu tahap, dengan menghilangkan tahap wilayah kandidat sepenuhnya dan memprediksi kelas dan kotak langsung dari setiap lokasi pada peta fitur. Kecepatan meningkat secara dramatis, meskipun YOLO awal tertinggal dari detektor dua tahap dalam akurasi objek kecil.
RetinaNet (Lin dkk., 2017) mengatasi masalah ketidakseimbangan kelas yang mengganggu detektor satu tahap — kandidat latar belakang jauh lebih banyak daripada kandidat objek, dan pelatihan didominasi olehnya — dengan fungsi kerugian baru, Focal Loss, menunjukkan bahwa detektor satu tahap pada akhirnya dapat menyamai akurasi detektor dua tahap.
FCOS (Tian dkk., 2019) sepenuhnya bebas anchor: alih-alih menentukan terlebih dahulu serangkaian anchor box dengan berbagai ukuran dan rasio aspek, ia meregresikan jarak dari setiap piksel feature-map langsung ke batas objek, menghindari penyetelan hyperparameter yang dibutuhkan oleh desain anchor.
DETR, Deformable DETR, dan DINO mengubah kerangka deteksi dengan Transformer sebagai masalah prediksi himpunan — subjek bagian selanjutnya.
5. Dua Tahap vs. Satu Tahap
Detektor dua tahap dan satu tahap terbagi tepat pada satu pertanyaan: apakah penyempitan wilayah kandidat ada sebagai tahap independennya sendiri?
| Aspek | Dua tahap (misalnya Faster R-CNN) | Satu tahap (misalnya YOLO) |
|---|---|---|
| Alur | Generasi proposal (RPN) → klasifikasi & regresi per wilayah | Klasifikasi & regresi langsung di setiap lokasi pada peta fitur |
| Akurasi | Umumnya tinggi, terutama pada objek kecil/padat | Generasi terbaru menutup sebagian besar kesenjangan |
| Kecepatan inferensi | Relatif lambat (pekerjaan per kandidat masih ada) | Cepat, cocok untuk waktu nyata |
| Biaya komputasi | Skala dengan jumlah kandidat | Kira-kira sebanding dengan ukuran gambar, dapat diprediksi |
| Kesulitan implementasi/penyetelan | Lebih banyak tahapan, lebih kompleks | Alur kerja yang lebih sederhana |
| Di mana ia cocok | Pemrosesan offline, inspeksi/analisis yang mengutamakan akurasi | Persepsi waktu nyata pada kendaraan dan robot |
Kedua keluarga tersebut telah lama mengandalkan Non-Maximum Suppression (NMS) sebagai pasca-pemrosesan untuk mengurangi kandidat yang tumpang tindih. Di antara beberapa kotak kandidat yang dihasilkan untuk satu objek, kotak mana pun yang tumpang tindih (IoU: Intersection over Union) dengan kotak lain melebihi ambang batas akan dibuang, sesuai definisi ini:
A dan B adalah wilayah yang ditempati oleh dua kotak; membagi area tumpang tindihnya dengan area gabungannya menghasilkan skor antara 0 dan 1. IoU yang tinggi menandakan kedua kotak kemungkinan menunjuk ke objek yang sama, sehingga kotak dengan kepercayaan diri yang lebih rendah akan dibuang. NMS berfungsi, tetapi dapat salah sasaran pada objek yang padat — kelemahan yang sepenuhnya dihilangkan oleh keluarga DETR, yang akan dibahas selanjutnya.
6. Deteksi di Era Transformer (DETR / Deformable DETR / DINO)
DETR (Carion dkk., 2020, Facebook AI) mengubah cara deteksi dirumuskan pada intinya. Tanpa anchor dan tanpa NMS, ia menjalankan fitur gambar melalui encoder Transformer dan meneruskan sejumlah "query" tetap (vektor yang dapat dipelajari yang mewakili objek kandidat) melalui decoder, langsung menghasilkan pasangan kelas-kotak sebanyak itu. Selama pelatihan, himpunan prediksi dan himpunan ground-truth dicocokkan satu-per-satu melalui algoritma Hungaria, dan kerugian dihitung terhadap pencocokan tersebut.
y_i adalah objek ground-truth ke-i, \hat{y}_{\sigma(i)} adalah prediksi yang diberikan kepadanya di bawah permutasi \sigma, dan \mathfrak{S}_N adalah himpunan semua permutasi dari N elemen. Ini berarti: temukan permutasi \hat{\sigma} yang menetapkan prediksi ke kebenaran dasar satu-ke-satu dengan biaya total minimum — hanya setelah penetapan tersebut diselesaikan, kerugian klasifikasi dan regresi biasa dapat dihitung. Karena tidak ada objek yang dapat diberi lebih dari satu prediksi, NMS menjadi tidak perlu berdasarkan konstruksi.
DETR memang memiliki kelemahan: perhatian penuh pada seluruh gambar itu mahal, dan model membutuhkan sejumlah besar epoch pelatihan untuk konvergen. Deformable DETR (Zhu dkk., 2020) memperkenalkan mekanisme perhatian deformabel di mana setiap kueri hanya memperhatikan sejumlah kecil titik sampel yang dipelajari daripada seluruh gambar, mengurangi komputasi sekaligus mempercepat konvergensi secara signifikan. DINO (Zhang dkk., 2022; "DETR dengan Kotak Jangkar DeNoising yang Ditingkatkan") menambahkan trik seperti kueri denoising kontrastif untuk stabilitas pelatihan dan pemilihan kueri campuran untuk memulai inisialisasi kueri dari peta fitur, mencapai akurasi terbaik di antara detektor keluarga DETR pada saat itu. Detektor berbasis Transformer kini berdiri sejajar dengan keluarga YOLO sebagai salah satu dari dua arah utama dalam penggunaan produksi.
7. Apa Itu Segmentasi Semantik?
Segmentasi Semantik memprediksi, untuk setiap piksel dalam gambar, kelas mana yang dimilikinya. Outputnya bukanlah kotak pembatas — melainkan "peta kelas" pada resolusi yang sama dengan gambar masukan, di mana setiap piksel membawa ID kelas.
Di mana Deteksi Objek mendekati objek dengan persegi panjang kasar, Segmentasi Semantik dapat merepresentasikan garis luar objek yang sebenarnya pada resolusi piksel — kekuatan nyata untuk bentuk tipis dan memanjang seperti trotoar, atau garis luar yang rumit seperti cabang pohon. Kelemahannya: bahkan ketika beberapa contoh dari kelas yang sama muncul dalam satu bingkai, Segmentasi Semantik tidak membedakannya — semua piksel "orang" diwarnai dengan warna yang sama, dan jumlah individu hilang. Menutup celah itu persis seperti yang dilakukan Segmentasi Instans, yang akan dibahas di bawah ini.
8. Algoritma Segmentasi Landmark
FCN (Fully Convolutional Network; Long, Shelhamer, Darrell, 2015) menghilangkan lapisan yang terhubung sepenuhnya dari CNN klasifikasi gambar, hanya menyisakan lapisan konvolusional, sehingga jaringan dapat menghasilkan prediksi piksel demi piksel secara langsung untuk input dengan ukuran apa pun. Ini adalah titik awal bidang ini — desain pertama yang menetapkan Segmentasi Semantik sebagai jaringan tunggal yang dapat dilatih dari ujung ke ujung.
U-Net (Ronneberger dkk., 2015), yang diusulkan untuk segmentasi gambar medis, mengatur encoder (downsampling sambil mengekstrak fitur) secara simetris terhadap decoder (upsampling sambil merekonstruksi), dan menghubungkan lapisan encoder dan decoder dengan resolusi yang sesuai secara langsung melalui "skip connection." Desain tersebut — mempertahankan detail batas yang halus sambil tetap menghasilkan output resolusi tinggi — menjadi arsitektur standar yang menyebar jauh melampaui bidang kedokteran.
SegNet (Badrinarayanan dkk.) mengingat, selama penggabungan encoder, posisi mana yang memegang nilai maksimum ("indeks penggabungan"), kemudian menggunakan kembali catatan tersebut selama peningkatan resolusi decoder, memulihkan batas secara efisien dalam penggunaan memori. PSPNet (Zhao dkk., 2017) memperkenalkan Modul Penggabungan Piramida yang merata-ratakan fitur di berbagai wilayah pada beberapa skala, menangkap konteks seluruh gambar yang akan terlewatkan oleh bidang reseptif yang sempit saja.
Seri DeepLab (Chen dkk.) membangun intinya di sekitar konvolusi dilatasi (atrous) — menyebarkan celah antara ketukan kernel untuk memperluas bidang reseptif tanpa mengorbankan resolusi — berevolusi dari v1 hingga v3+ (2018). HRNet (Wang dkk., 2019) membalikkan pendekatan yang biasa: alih-alih menurunkan resolusi dan kemudian memulihkan resolusi, ia menjaga aliran fitur resolusi tinggi tetap hidup secara paralel di seluruh jaringan, terus menerus bertukar informasi di berbagai resolusi.
SegFormer (Xie dkk., 2021) menggabungkan encoder Transformer hierarkis dengan decoder MLP-only yang ringan, mencapai akurasi dan efisiensi tinggi dengan desain yang sangat sederhana. Mask2Former (Cheng dkk., 2022) merumuskan ulang segmentasi sebagai "sejumlah kueri tetap, masing-masing memprediksi satu mask dan satu kelas," membatasi perhatian setiap kueri ke wilayah mask yang diprediksi di lapisan sebelumnya melalui "perhatian bertopeng" — memberikan konvergensi cepat dan arsitektur tunggal yang menangani segmentasi Semantik, Instans, dan Panoptik.
9. Membandingkan Deteksi / Semantik / Instans / Panoptik
Empat tugas yang diperkenalkan sejauh ini menjadi jelas setelah Anda mengorganisirnya di sepanjang dua sumbu: apakah ia membedakan instans individual dari kelas yang sama, dan apakah ia menangani "latar belakang" — hal-hal yang tak terhitung jumlahnya seperti jalan, langit, atau dinding.
| Tugas | Unit keluaran | Membedakan instans | Menangani latar belakang | Algoritma Landmark | Metrik Kunci |
|---|---|---|---|---|---|
| Deteksi Objek | Kotak Pembatas | Ya (satu kotak per instance) | Tidak | Faster R-CNN, YOLO, DETR | mAP |
| Segmentasi Semantik | Label kelas per piksel | Tidak (kelas yang sama bergabung menjadi satu warna) | Ya | FCN, DeepLab, SegFormer | mIoU |
| Segmentasi Instans | Masker per piksel | Ya (masker terpisah per instans) | Tidak | Mask R-CNN, Mask2Former | AP (berbasis mask-IoU) |
| Segmentasi Panoptik | Kelas per piksel + ID instans | Ya (hanya latar depan) | Ya (hanya kelas, tanpa ID instans) | Panoptic FPN, Mask2Former | PQ (Kualitas Panoptik) |
Seperti yang ditunjukkan tabel, Segmentasi Panoptik (diusulkan oleh Kirillov dkk., 2019) adalah "yang terbaik dari keduanya" antara Segmentasi Instans dan Segmentasi Semantik. Objek latar depan — hal-hal yang dapat dihitung seperti orang dan mobil — dibedakan per instans, seperti pada Segmentasi Instans; latar belakang — hal-hal yang tidak dapat dihitung seperti jalan dan langit — hanya mendapatkan label kelas, seperti pada Segmentasi Semantik. Jika Anda berupaya untuk mendeskripsikan satu gambar secara lengkap dan menyeluruh, Anda akan sampai pada bentuk Panoptik ini — cara yang berguna untuk melihat bagaimana keempat tugas tersebut saling terkait.
Metrik evaluasi mIoU (rata-rata Intersection over Union) menghitung, untuk setiap kelas c, IoU antara wilayah kebenaran G_c dan wilayah prediksi P_c, kemudian dirata-ratakan di semua kelas.
Di mana skor mAP Deteksi menilai kesepakatan pada tingkat kotak, skor mIoU menilai kesepakatan pada tingkat piksel — perbedaan metrik tersebut mencerminkan persis perbedaan dalam apa yang dianggap "benar" oleh setiap tugas.
10. Deteksi Objek 3D
Kendaraan otonom dan robot seringkali perlu mendeteksi posisi, ukuran, dan orientasi 3D suatu objek langsung dari awan titik LiDAR, bukan hanya dari gambar 2D. Awan titik tidak memiliki struktur grid seperti gambar 2D, sehingga CNN tidak dapat mengonsumsinya apa adanya — bagaimana mengubah data yang tidak teratur ini menjadi sesuatu yang teratur adalah tantangan desain utama dalam Deteksi Objek 3D.
KEDUA (Yan dkk., 2018) membagi awan titik menjadi voxel 3D (sel kubik) dan menggunakan konvolusi sparse untuk melewati sebagian besar voxel yang tidak mengandung titik, sehingga secara signifikan mengurangi biaya komputasi CNN 3D. PointPillars (Lang dkk., 2019) menyederhanakan hal ini lebih lanjut, menggabungkan titik-titik menjadi "pilar" vertikal alih-alih voxel sehingga jaringan dapat memprosesnya dengan konvolusi 2D biasa daripada 3D, sehingga meningkatkan kecepatan secara signifikan.
PV-RCNN (Shi dkk., 2020) menggabungkan efisiensi pemrosesan berbasis voxel dengan lokalisasi tepat yang berasal dari pemrosesan titik secara langsung (gaya PointNet), dalam desain hibrida Point-Voxel. CenterPoint (Yin dkk., 2021) menghadirkan pendekatan tanpa jangkar untuk deteksi 3D: mendeteksi objek sebagai satu titik pusat, kemudian meregresikan lebar, tinggi, kedalaman, dan orientasi dari sana, memasangkannya dengan backbone gaya PointPillars atau VoxelNet untuk akurasi yang tinggi.
Banyak dari metode ini memiliki satu ide desain tambahan: memproyeksikan informasi point-cloud ke dalam Bird's-Eye View (BEV) — peta fitur 2D yang dilihat dari atas — sebelum menjalankan kepala deteksi. Kompresi informasi ketinggian mengorbankan beberapa detail demi kemampuan untuk menangani "di mana objek ini berada di permukaan jalan" — hubungan yang paling penting untuk mengemudi — dalam kerangka kerja yang sama dengan detektor 2D biasa.
11. Segmentasi Semantik 3D
Segmentasi Semantik 3D menetapkan label kelas untuk setiap titik dalam point cloud (atau setiap pantulan laser dari LiDAR). Sekali lagi, bagaimana menangani data point cloud yang tidak beraturan adalah yang membedakan pendekatan utama.
PointNet++ (Qi dkk., 2017) memasukkan titik-titik ke dalam jaringan apa adanya, tanpa voxelisasi atau konversi lainnya, mengelompokkan titik-titik yang berdekatan dan menggabungkan fitur secara hierarkis — membangun fondasi untuk metode berbasis titik. RandLA-Net (Hu dkk., 2020) mengatasi hambatan pencarian tetangga yang membuat awan titik skala besar menjadi mahal, menggabungkan pengambilan sampel acak dengan modul agregasi fitur lokal yang mengkompensasi informasi yang akan hilang jika pengambilan sampel acak dilakukan, mencapai kecepatan praktis bahkan pada awan titik skala kota.
RangeNet++ (Milioto dkk., 2019) sama sekali melewatkan pemrosesan 3D: ia memproyeksikan awan titik, menggunakan urutan pemindaian LiDAR sendiri, ke dalam "citra jangkauan" 2D, menjalankan CNN 2D biasa di atasnya, dan memproyeksikan hasilnya kembali ke 3D — memanfaatkan kematangan alat CNN 2D untuk kecepatan. Cylinder3D (Zhu dkk., 2021) memperhatikan bahwa awan titik LiDAR luar ruangan memancar keluar dari sensor, dan divokselisasi dalam koordinat silindris daripada koordinat Kartesius untuk menangani penurunan kepadatan yang dihasilkan pada jarak tertentu. SPVNAS (Tang dkk., 2020) menggabungkan pemrosesan berbasis titik dan berbasis voxel melalui konvolusi Sparse Point-Voxel, kemudian menerapkan pencarian arsitektur neural (NAS) untuk secara otomatis menemukan konfigurasi dengan trade-off akurasi/kecepatan yang kuat.
Seperti pada kasus 2D, sejarah Segmentasi Semantik 3D dapat dibaca sebagai bolak-balik antara "mempertahankan titik sebagai titik" (berbasis titik) dan "mengonversi ke grid reguler" (berbasis voxel atau citra rentang), masing-masing mengorbankan akurasi, kecepatan, dan memori secara berbeda.
12. Memilih Pendekatan yang Tepat dalam Praktik
Pendekatan mana yang akan digunakan, Deteksi atau Segmentasi, dan algoritma spesifik mana, sangat bergantung pada kasus penggunaan.
-
Lengan robot / pengambilan: mengetahui garis besar target yang akan digenggam sangat penting, sehingga Segmentasi Instans (misalnya Mask2Former) paling cocok — kotak pembatas saja tidak mengungkapkan bentuk sebenarnya dari objek atau titik genggaman yang baik. - Pengemudian otonom: kinerja waktu nyata tidak dapat ditawar, sehingga 2D mengandalkan detektor satu tahap (keluarga YOLO), dan 3D mengandalkan detektor 3D berbasis BEV yang berfokus pada efisiensi seperti PointPillars atau CenterPoint. Segmentasi Semantik/Panoptik sering ditambahkan di atasnya untuk memahami area yang dapat dilalui.
-
Kamera pengawasan/keamanan: kumpulan kelas target (orang, kendaraan) biasanya terbatas, dan kehilangan deteksi lebih penting daripada kecepatan mentah, membuka pintu bagi detektor dua tahap atau detektor berbasis Transformer dengan akurasi tinggi.
- AR/VR: memutuskan di mana di dunia nyata untuk menambatkan objek virtual biasanya berarti menggunakan Segmentasi Semantik untuk mengidentifikasi bidang dan wilayah objek, kemudian menerapkan Penggabungan Sensor (lihat artikel pendamping) untuk penyelarasan 3D yang sebenarnya.
Pada perangkat edge dengan keterbatasan sumber daya, kecepatan dan ukuran biasanya lebih diutamakan daripada akurasi — varian YOLO yang ringan atau SegFormer yang lebih ramping. Untuk analisis offline yang presisi (pencitraan medis, citra satelit), akurasi menjadi prioritas utama, sehingga lebih mengutamakan detektor dua tahap atau model kelas Mask2Former. Dalam praktiknya, pertimbangan antara kinerja waktu nyata dan akurasi adalah faktor terbesar dalam pengambilan keputusan.
Untuk perkembangan terbaru — arsitektur bebas NMS, deteksi kosakata terbuka, model dasar dalam keluarga Segment Anything — lihat Tren Teknologi dalam Deteksi Objek dan Tren Teknologi dalam Segmentasi Semantik.
13. Ringkasan
Deteksi Objek menangkap objek sebagai persegi panjang; Segmentasi Semantik menangkapnya piksel demi piksel — dua tugas pemahaman gambar yang beroperasi pada resolusi berbeda. Silsilah deteksi dimulai dari dua tahap (Faster R-CNN) melalui satu tahap (YOLO) hingga detektor berbasis Transformer yang menghilangkan anchor dan NMS sama sekali (DETR/DINO); segmentasi dimulai dari FCN melalui U-Net dan DeepLab hingga SegFormer/Mask2Former berbasis Transformer. Di atas fondasi itu terdapat Segmentasi Instans, yang menambahkan pembedaan per objek, Segmentasi Panoptik, yang menyatukan keduanya, dan rekan-rekan berbasis point cloud 3D mereka — dan mana yang akan digunakan selalu bergantung pada apakah momen tersebut membutuhkan akurasi atau kecepatan.
Apa yang membedakan deteksi dari segmentasi?
Deteksi biasanya mengembalikan kotak dan kelas; segmentasi mengembalikan wilayah piksel.
Pilih sesuai dengan kebutuhan lokalisasi, kontur, dan identitas instance.
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.