Contents — find the section you need
Bevor ein Roboter beispielsweise „die Tasse vom Tisch aufheben“ oder „dem Fußgänger ausweichen“ kann, muss er anhand eines Kamerabildes erkennen, was sich dort befindet und wo. Diese Erkenntnis ist Aufgabe der Objekterkennung und der semantischen Segmentierung. Beide werden oft in einem Atemzug genannt, unterscheiden sich aber grundlegend – sowohl in der Detailgenauigkeit ihrer Ergebnisse als auch in der Art und Weise, wie das zugrundeliegende Problem formuliert wird. Dieser Artikel erläutert beide Konzepte von Grund auf anhand ihrer 3D-Pendants und eines direkten Vergleichs.
 Fahrzeug-Wahrnehmungskamera
Bild: Car Fensterkamera des Mobileye-Systems (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Eine repräsentative Eingangskamera, keine Aussage über die neuesten Produktspezifikationen.

0. Inhalt dieses Artikels
-
Was Objekterkennung und semantische Segmentierung jeweils ausgeben
-
Die Pipeline der Erkennung (Merkmalsextraktion → Erkennungskopf)
-
Die Entwicklung wegweisender Algorithmen von R-CNN über YOLO, DETR und DINO und ihre unterschiedlichen Designphilosophien
Der Kompromiss zwischen zweistufigen und einstufigen Verfahren und die Rolle transformatorbasierter Detektoren
Die Entwicklung von Segmentierungsalgorithmen von FCN zu Mask2Former
Eine Tabelle, die die Unterschiede zwischen Erkennung, semantischer, Instanz- und panoptischer Segmentierung verdeutlicht
Die Grundlagen der 3D-Objekterkennung und 3D-semantischen Segmentierung auf Punktwolken
Wie man die richtige Technologie für Robotik, autonomes Fahren, Überwachung und AR auswählt
1. Die Kurzfassung: Was sind Erkennung und Segmentierung?
In einem Satz: Die Objekterkennung beantwortet die Frage "Wo im Bild befindet sich was?" mit einem Rechteck (a Die Begrenzungsbox dient der Identifizierung einzelner Pixel, während die semantische Segmentierung** die Frage „Was ist jedes Pixel?“ durch Einfärben des Bildes beantwortet. Beide verfolgen dasselbe Ziel – das Verständnis eines Bildes –, arbeiten jedoch mit völlig unterschiedlichen Auflösungen.
Zwei weitere Verfahren bauen auf diesem Paar auf. Die Instanzsegmentierung färbt Pixel ähnlich wie die semantische Segmentierung ein, unterscheidet aber zusätzlich einzelne Objekte derselben Klasse (z. B. drei verschiedene Personen in einem Bild). Die panoptische Segmentierung vereint die Instanzsegmentierung mit der für die Erfassung unzähliger Hintergrundelemente wie Straßen oder Himmel benötigten semantischen Segmentierung zu einem einzigen, maximal vollständigen Ergebnis. Abschnitt 9 unten veranschaulicht die Zusammenhänge dieser vier Verfahren in einer Tabelle.
... 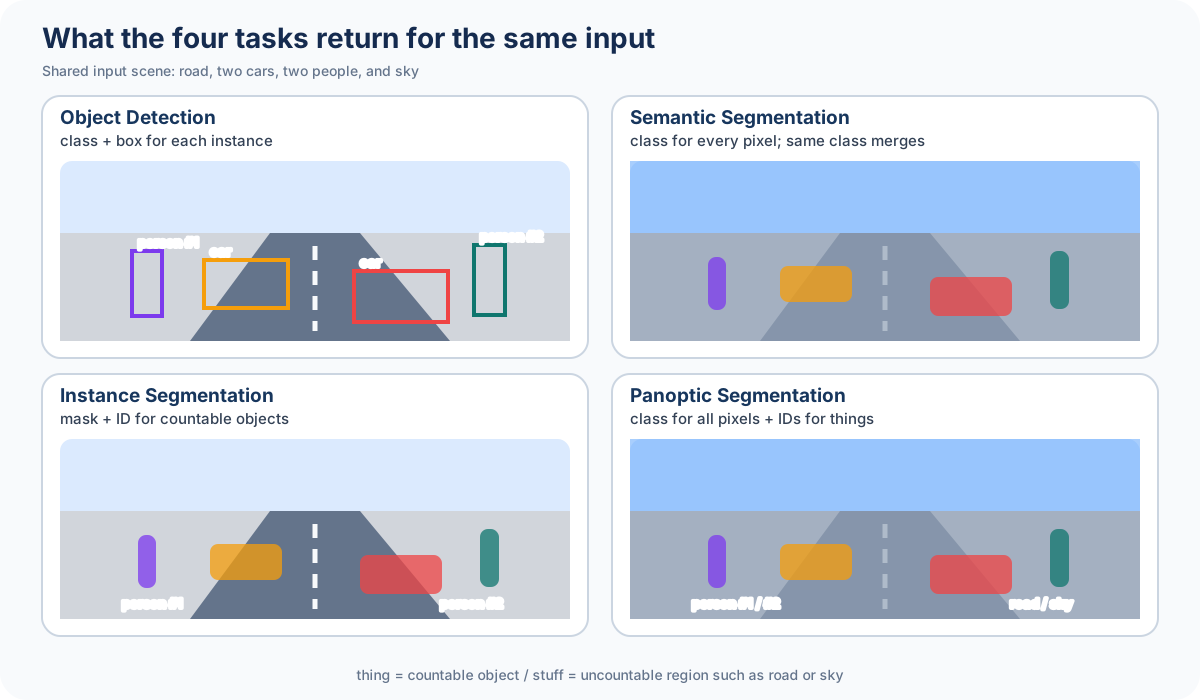
Abbildung: Duskcoil. Generiert aus einer schematischen Szene und gemeinsam genutzter Geometrie; keine gemessene Modellausgabe.
2. Was ist Objekterkennung? (Klasse / Begrenzungsrahmen / Konfidenz)
Die Objekterkennung gibt für ein einzelnes Bild eine Reihe von Tripeln aus, eines pro Objekt:
- Klasse: die Objektkategorie (eine von vordefinierten Kategorien – z. B. „Person“, „Auto“, „Stuhl“ usw.)
- Begrenzungsrahmen: das Rechteck, das das Objekt umschließt, üblicherweise angegeben als Mittelpunkt plus Breite und Höhe (x, y, w, h) oder als obere linke/untere rechte Ecke (x_1, y_1, x_2, y_2)
- Konfidenz: ein Wert (0–1), der angibt, wie sicher sich das Modell bei der Zuordnung von Begrenzungsrahmen und Klasse ist.
Die Bildklassifizierung liefert eine einzige Antwort – „Was ist auf diesem Bild zu sehen?“ –, die Objekterkennung hingegen muss gleichzeitig beantworten, wie viele Objekte es gibt, wo sie sich befinden und um welche Art von Objekten es sich handelt. Diese Eigenschaft, dass die Anzahl der Objekte selbst unbekannt ist, macht die Objekterkennung grundlegend schwieriger als die Klassifizierung. Ein Bild kann null oder hundert Objekte enthalten – die variable Anzahl an Objekten ist die grundlegende Designvorgabe, die praktisch allen im Folgenden beschriebenen Tricks zugrunde liegt.
3. Wie funktioniert Objekterkennung?
Angesichts der variablen Anzahl an Objekten folgen die meisten modernen Objekterkennungsalgorithmen demselben zweistufigen Verfahren: Zunächst wird eine Feature-Map aus dem gesamten Bild extrahiert. Anschließend wird diese Feature-Map mit einer großen Anzahl von Kandidatenpositionen (Ankerboxen oder den später beschriebenen Transformer-„Abfragen“) versehen. Für jede Kandidatenposition wird entschieden, ob es sich um ein Objekt oder einen Hintergrund handelt. Falls ja, wird die Klasse und die genaue Position bestimmt.
Abbildung 2 – Der Feature-Extraktor (Backbone) komprimiert das Bild zu einer Feature-Map, und der Detektionskopf führt gleichzeitig Klassifizierung und Box-Regression darauf durch.
Im Detektionskopf werden zwei Regressions-/Klassifizierungsprobleme gleichzeitig gelöst: „Befindet sich an dieser Kandidatenposition ein Objekt, und wenn ja, welcher Klasse?“ und „Um wie viel muss dieser Kandidat (Anker) verschoben werden, um ihn mit dem tatsächlichen Objekt auszurichten?“ Die Kombination dieser beiden Probleme zu einem gewichteten Summenverlust ist der Multi-Task-Verlust, der seit Fast R-CNN weit verbreitet ist.
Hierbei ist p die vorhergesagte Klassenwahrscheinlichkeit, p^{*} die tatsächliche Klasse, t die vorhergesagte Korrektur des Objektbereichs und t^{*} die aus dem tatsächlichen Objektbereich abgeleitete Zielkorrektur. Der Indikator \mathbb{1}[p^{*} > 0] bedeutet: „Berechnen Sie den Regressionsfehler nur für Kandidaten, die tatsächlich ein Objekt und keinen Hintergrund enthalten.“ Da ein Hintergrundkandidat keinen tatsächlichen Objektbereich hat, auf den die Regression erfolgen kann, ist diese Einschränkung sinnvoll. \lambda legt fest, wie stark der Regressionsterm im Verhältnis zur Klassifizierung gewichtet wird.
4. Algorithmen zur Landmarkenerkennung
Die Entwicklung von Erkennungsalgorithmen lässt sich am einfachsten anhand zweier Achsen nachvollziehen: „Wie werden Kandidatenregionen eingegrenzt?“ und „Wie wird der Objektbereich selbst vorhergesagt?“
R-CNN (Girshick et al., 2014) extrahierte mithilfe des klassischen Bildverarbeitungsalgorithmus Selective Search etwa 2.000 Kandidatenregionen aus einem Bild und klassifizierte diese anschließend einzeln mit einem CNN. Das Verfahren war zwar präzise, aber extrem langsam, da das CNN für jede Kandidatenregion einmal durchlaufen werden musste.
Fast R-CNN (Girshick, 2015) verarbeitete das gesamte Bild nur einmal mit einem CNN, um eine einzelne Feature-Map zu erstellen, und extrahierte anschließend die Kandidatenregionen aus dieser Feature-Map (RoI-Pooling). Dadurch wurde die redundante Berechnung pro Region vermieden.
Faster R-CNN (Ren, He, Girshick, Sun, 2015) ging noch einen Schritt weiter und ersetzte die Generierung von Kandidatenregionen durch ein kleines Region Proposal Network (RPN). Dadurch wurden Proposal-Generierung, Klassifizierung und Regression in einem einzigen Netzwerk vereint. Diese drei Generationen bilden zusammen die Grundlage des sogenannten zweistufigen Detektors.
SSD (Liu et al., 2016) und YOLO (Redmon et al., 2015–2016) waren Pioniere der einstufigen Detektoren, die die Kandidatenregionsphase vollständig eliminierten und Klasse und Objektgröße direkt anhand jeder Position auf der Feature-Map vorhersagten. Die Geschwindigkeit stieg dadurch enorm an, obwohl YOLO in der frühen Version hinsichtlich der Genauigkeit bei kleinen Objekten hinter zweistufigen Detektoren zurückblieb.
RetinaNet (Lin et al., 2017) ging das Problem des Klassenungleichgewichts an, das einstufige Detektoren plagte – Hintergrundkandidaten überwiegen die Objektkandidaten bei Weitem, und das Training wird von ihnen dominiert – mit einer neuen Verlustfunktion, dem Focal Loss. Dies zeigte, dass einstufige Detektoren die Genauigkeit zweistufiger Detektoren letztendlich erreichen konnten.
FCOS (Tian et al., 2019) verzichtet vollständig auf Anker: Anstatt Ankerboxen in verschiedenen Größen und Seitenverhältnissen vorzudefinieren, berechnet es den Abstand jedes Feature-Map-Pixels direkt zur Objektgrenze und umgeht so die für die Ankerkonstruktion notwendige Hyperparameter-Optimierung.
DETR, Deformable DETR und DINO definieren die Objekterkennung mit Transformatoren als Mengenvorhersageproblem – Thema des nächsten Abschnitts.
5. Zwei- vs. Einstufendetektoren
Zwei- und einstufige Detektoren unterscheiden sich in genau einer Frage: Existiert die Kandidatenregionsverengung als eigenständiger Schritt?
| Aspekt | Zweistufig (z. B. Faster R-CNN) | Einstufig (z. B. YOLO) |
|---|---|---|
| Ablauf | Vorschlagsgenerierung (RPN) → Klassifizierung und Regression pro Region | Klassifizierung und Regression direkt an jeder Position der Feature-Map |
Genauigkeit | Generell hoch, insbesondere bei kleinen/dichten Objekten | Neuere Generationen schließen die Lücke weitgehend |
Inferenzgeschwindigkeit | Relativ langsam (Verarbeitung pro Kandidat erforderlich) | Schnell, geeignet für Echtzeit |
Rechenaufwand | Skaliert mit der Anzahl der Kandidaten | Annähernd proportional zur Bildgröße, vorhersehbar |
Implementierungs-/Optimierungsaufwand | Mehr Stufen, komplexer | Einfachere Pipeline |
Anwendungsbereiche | Offline-Verarbeitung, Genauigkeitsorientierte Inspektion/Analyse | Echtzeit-Wahrnehmung in Fahrzeugen und Robotern |
Beide Familien nutzten lange Zeit Non-Maximum Suppression (NMS) als Nachbearbeitungsverfahren, um überlappende Kandidaten auszusortieren. Unter den mehreren für ein Objekt erzeugten Kandidatenboxen wird jede Box, deren Überlappung (IoU: Schnittmenge über Vereinigung) einen Schwellenwert überschreitet, gemäß folgender Definition verworfen:
A und B bezeichnen die Bereiche, die zwei Boxen belegen. Die Division ihrer Überlappungsfläche durch ihre Vereinigungsfläche ergibt einen Wert zwischen 0 und 1. Ein hoher IoU-Wert deutet darauf hin, dass die beiden Boxen wahrscheinlich auf dasselbe Objekt zeigen. Die Box mit der geringeren Konfidenz wird daher verworfen. NMS funktioniert, kann aber bei dicht gedrängten Objekten Fehlfunktionen aufweisen – eine Schwäche, die die im Folgenden beschriebene DETR-Familie vollständig beseitigt.
6. Objekterkennung im Zeitalter der Transformer (DETR / Deformable DETR / DINO)
DETR (Carion et al., 2020, Facebook AI) hat die grundlegende Formulierung der Objekterkennung verändert. Ohne Anker und ohne NMS werden Bildmerkmale durch einen Transformer-Encoder geleitet und eine feste Anzahl von „Anfragen“ (lernbare Vektoren, die Kandidatenobjekte repräsentieren) durch einen Decoder gesendet, der direkt genau diese Anzahl an Box-Klassen-Paaren ausgibt. Während des Trainings werden die vorhergesagte Menge und die Ground-Truth-Menge mithilfe des ungarischen Algorithmus eins zu eins abgeglichen, und der Verlust wird anhand dieses Abgleichs berechnet.
y_i ist das i -te Ground-Truth-Objekt, \hat{y}_{\sigma(i)} die ihm unter der Permutation \sigma zugewiesene Vorhersage und \mathfrak{S}_N die Menge aller Permutationen von N Elementen. Dies bedeutet: Finde die Permutation \hat{\sigma}, die Vorhersagen den tatsächlichen Werten eins zu eins zuordnet und dabei die Gesamtkosten minimiert. Erst wenn diese Zuordnung feststeht, können die üblichen Klassifizierungs- und Regressionsverluste berechnet werden. Da keinem Objekt jemals mehr als eine Vorhersage zugewiesen werden kann, ist NMS per Konstruktion überflüssig.
DETR hatte jedoch einen Nachteil: Die vollständige Selbstaufmerksamkeit über das gesamte Bild ist rechenintensiv, und das Modell benötigte eine enorme Anzahl an Trainingsepochen, um zu konvergieren. Deformable DETR (Zhu et al., 2020) führte einen deformierbaren Aufmerksamkeitsmechanismus ein, bei dem jede Anfrage nur eine kleine, gelernte Menge von Abtastpunkten anstatt des gesamten Bildes berücksichtigt. Dies reduziert den Rechenaufwand und beschleunigt die Konvergenz erheblich. DINO (Zhang et al., 2022; „DETR mit verbesserten Entrauschungs-Ankerboxen“) erweiterte die Möglichkeiten um Tricks wie kontrastive Entrauschungsabfragen für eine stabilere Trainingsumgebung und die Auswahl gemischter Abfragen zur Initialisierung der Abfragen anhand der Feature-Map. Damit erreichte DINO die höchste Genauigkeit aller Detektoren der DETR-Familie. Transformerbasierte Detektoren zählen heute neben der YOLO-Familie zu den beiden wichtigsten Ansätzen im Produktiveinsatz.
7. Was ist semantische Segmentierung?
Die semantische Segmentierung sagt für jedes Pixel in einem Bild voraus, zu welcher Klasse es gehört. Die Ausgabe ist kein Begrenzungsrahmen, sondern eine „Klassenkarte“ in der gleichen Auflösung wie das Eingabebild, in der jedes Pixel eine Klassen-ID trägt.
Während die Objekterkennung ein Objekt mit einem groben Rechteck approximiert, kann die semantische Segmentierung die tatsächliche Kontur des Objekts in Pixelauflösung darstellen – ein großer Vorteil bei dünnen, länglichen Formen wie Bordsteinkanten oder komplexen Konturen wie Baumästen. Der Nachteil: Selbst wenn mehrere Instanzen derselben Klasse in einem Bild erscheinen, kann die semantische Segmentierung diese nicht unterscheiden – alle Pixel der „Personen“ werden in derselben Farbe dargestellt, und die Anzahl der Individuen geht verloren. Genau diese Lücke schließt die Instanzsegmentierung, die weiter unten erläutert wird.
8. Landmarkensegmentierungsalgorithmen
FCN (Fully Convolutional Network; Long, Shelhamer, Darrell, 2015) entfernte die vollständig verbundenen Schichten aus einem CNN zur Bildklassifizierung und beließ nur Faltungsschichten. Dadurch konnte das Netzwerk direkt pixelweise Vorhersagen für Eingaben beliebiger Größe treffen. Es gilt als Ausgangspunkt des Forschungsfelds – der erste Ansatz, der die semantische Segmentierung als ein einziges, durchgängig trainierbares Netzwerk etablierte.
8. Landmarkensegmentierungsalgorithmen
FCN (Fully Convolutional Network; Long, Shelhamer, Darrell, 2015) entfernte die vollständig verbundenen Schichten aus einem CNN zur Bildklassifizierung und behielt nur Faltungsschichten bei. Dadurch konnte das Netzwerk direkt pixelweise Vorhersagen für Eingaben beliebiger Größe treffen. U-Net (Ronneberger et al., 2015), entwickelt für die Segmentierung medizinischer Bilder, ordnet einen Encoder (Downsampling bei der Merkmalsextraktion) symmetrisch einem Decoder (Upsampling bei der Rekonstruktion) an und verbindet Encoder- und Decoder-Schichten mit passender Auflösung direkt über „Skip-Verbindungen“. Dieses Design – das feine Konturdetails bei gleichzeitig hoher Auflösung erhält – etablierte sich als Standardarchitektur und fand weit über die Medizin hinaus Anwendung.
SegNet (Badrinarayanan et al.) speichert beim Encoder-Pooling die Position des Maximalwerts („Pooling-Indizes“) und nutzt diese Information beim Decoder-Upsampling, um Konturen speichereffizient wiederherzustellen. PSPNet (Zhao et al., 2017) führte ein Pyramid-Pooling-Modul ein, das Merkmale über Regionen auf verschiedenen Skalen mittelt und so den Kontext des gesamten Bildes erfasst, der mit einem kleinen rezeptiven Feld allein nicht erfasst würde.
Die DeepLab-Serie (Chen et al.) basiert auf dilatierter (atrous) Faltung – der Vergrößerung der Abstände zwischen den Kernel-Taps, um das rezeptive Feld zu erweitern, ohne die Auflösung zu beeinträchtigen – und wurde von Version 1 bis 3+ (2018) weiterentwickelt. HRNet (Wang et al., 2019) kehrt den üblichen Ansatz um: Anstatt die Auflösung zu reduzieren und anschließend wiederherzustellen, hält es einen hochauflösenden Feature-Stream parallel im gesamten Netzwerk aufrecht und tauscht kontinuierlich Informationen zwischen den Auflösungen aus.
SegFormer (Xie et al., 2021) kombiniert einen hierarchischen Transformer-Encoder mit einem ressourcenschonenden MLP-Decoder und erzielt so hohe Genauigkeit und Effizienz mit einem bemerkenswert einfachen Design. Mask2Former (Cheng et al., 2022) reformulierte die Segmentierung als „eine feste Anzahl von Anfragen, die jeweils eine Maske und eine Klasse vorhersagen“. Dabei wird die Aufmerksamkeit jeder Anfrage mittels „maskierter Aufmerksamkeit“ auf den in der vorherigen Schicht vorhergesagten Maskenbereich beschränkt. Dies ermöglicht sowohl eine schnelle Konvergenz als auch eine einheitliche Architektur, die semantische, instanzielle und panoptische Segmentierung gleichermaßen unterstützt.
9. Vergleich von Erkennung / Semantik / Instanziierung / Panoptischer Segmentierung
Die vier bisher vorgestellten Aufgaben werden verständlicher, wenn man sie anhand zweier Achsen ordnet: Unterscheidet die Aufgabe einzelne Instanzen derselben Klasse? Und berücksichtigt sie den „Hintergrund“ – also unzählbare Objekte wie Straßen, Himmel oder Wände?
| Aufgabe | Ausgabeeinheit | Unterscheidet Instanzen | Berücksichtigt den Hintergrund | Landmark-Algorithmen | Schlüsselmetrik |
|---|---|---|---|---|---|
| Objekterkennung | Begrenzungsrahmen | Ja (ein Rahmen pro Instanz) | Nein | Faster R-CNN, YOLO, DETR | mAP |
| Semantische Segmentierung | Klassenbezeichnung pro Pixel | Nein (gleiche Klasse wird zu einer Farbe zusammengefasst) | Ja | FCN, DeepLab, SegFormer | mIoU |
| Instanzsegmentierung | Maske pro Pixel | Ja (separate Maske pro Instanz) | Nein | Mask R-CNN, Mask2Former | AP (masken-IoU-basiert) |
| Panoptische Segmentierung | Klasse + Instanz-ID pro Pixel | Ja (nur Vordergrund) | Ja (nur Klasse, keine Instanz-ID) | Panoptic FPN, Mask2Former | PQ (Panoptic Quality) |
Wie die Tabelle verdeutlicht, vereint die panoptische Segmentierung (vorgeschlagen von Kirillov et al., 2019) die Vorteile der Instanz- und der semantischen Segmentierung. Vordergrundobjekte – zählbare Dinge wie Personen und Autos – werden wie bei der Instanzsegmentierung pro Instanz unterschieden; Der Hintergrund – unzählige Elemente wie Straße und Himmel – erhält lediglich eine Klassenbezeichnung, wie bei der semantischen Segmentierung. Versucht man, ein einzelnes Bild vollständig und erschöpfend zu beschreiben, gelangt man genau zu dieser panoptischen Form – eine hilfreiche Methode, um die Zusammenhänge der vier Aufgaben zu verdeutlichen.
Die Bewertungsmetrik mIoU (mittlere Schnittmenge über Vereinigung) berechnet für jede Klasse c die IoU zwischen der tatsächlichen Region G_c und der vorhergesagten Region P_c und mittelt diese anschließend über alle Klassen.
Während die mAP-Metrik der Objekterkennung die Übereinstimmung auf Ebene der Boxen bewertet, bewertet mIoU die Übereinstimmung auf Pixelebene – dieser Unterschied in der Metrik spiegelt genau den Unterschied in der Definition von „korrekt“ in den einzelnen Aufgaben wider.
10. 3D-Objekterkennung
Autonome Fahrzeuge und Roboter müssen häufig die 3D-Position, -Größe und -Orientierung eines Objekts direkt aus LiDAR-Punktwolken erkennen, nicht nur aus 2D-Bildern. Da eine Punktwolke nicht die Rasterstruktur eines 2D-Bildes aufweist, kann ein CNN sie nicht direkt verarbeiten. Die zentrale Herausforderung bei der 3D-Objekterkennung besteht darin, diese unregelmäßigen Daten in regelmäßige Daten umzuwandeln.
SECOND (Yan et al., 2018) unterteilt eine Punktwolke in 3D-Voxel (kubische Zellen) und verwendet Sparse Convolution, um den großen Anteil der Voxel ohne Punkte zu überspringen. Dadurch wird der Rechenaufwand von 3D-CNNs deutlich reduziert. PointPillars (Lang et al., 2019) vereinfacht dies weiter, indem Punkte zu vertikalen „Säulen“ anstatt zu Voxeln aggregiert werden. So kann das Netzwerk sie mit gewöhnlicher 2D- statt 3D-Convolution verarbeiten, was die Geschwindigkeit erheblich steigert.
SECOND (Yan et al., 2018) unterteilt eine Punktwolke in 3D-Voxel (kubische Zellen) und verwendet Sparse Convolution, um den großen Anteil der Voxel ohne Punkte zu überspringen. Dies reduziert den Rechenaufwand von 3D-CNNs erheblich. PV-RCNN (Shi et al., 2020) kombinierte die Effizienz der voxelbasierten Verarbeitung mit der präzisen Lokalisierung durch direkte Punktverarbeitung (PointNet-ähnlich) in einem hybriden Punkt-Voxel-Design. CenterPoint (Yin et al., 2021) führte einen ankerfreien Ansatz zur 3D-Detektion ein: Ein Objekt wird als einzelner Mittelpunkt erkannt, von dem aus Breite, Höhe, Tiefe und Orientierung berechnet werden. Dies wird mit PointPillars- oder VoxelNet-ähnlichen Backbones kombiniert, um eine hohe Genauigkeit zu erzielen.
Viele dieser Methoden haben eine weitere gemeinsame Designidee: Die Punktwolkeninformationen werden vor dem Detektionsvorgang in eine Vogelperspektive (Bird's-Eye View, BEV) – eine 2D-Feature-Map aus der Vogelperspektive – projiziert. Durch die Komprimierung der Höheninformationen geht zwar etwas Detailgenauigkeit verloren, die für das Fahren entscheidende Information über die Position eines Objekts auf der Fahrbahn wird jedoch im selben Rahmen wie bei einem herkömmlichen 2D-Detektor erfasst.
11. 3D-Semantische Segmentierung
Die 3D-Semantische Segmentierung ordnet jedem Punkt einer Punktwolke (oder jedem Laser-Rückstreusignal eines LiDAR-Systems) eine Klassenbezeichnung zu. Auch hier liegt der entscheidende Unterschied zwischen den verschiedenen Ansätzen im Umgang mit unregelmäßigen Punktwolkendaten.
PointNet++ (Qi et al., 2017) speist Punkte unverändert in das Netzwerk ein, ohne Voxelisierung oder andere Konvertierungen. Dabei werden benachbarte Punkte gruppiert und Merkmale hierarchisch aggregiert – die Grundlage für punktbasierte Methoden. RandLA-Net (Hu et al., 2020) löste den Engpass der Nachbarsuche, der die Verarbeitung großer Punktwolken so aufwendig machte. Es kombiniert Zufallsstichproben mit einem lokalen Merkmalsaggregationsmodul, das die sonst bei der Zufallsstichprobe verlorenen Informationen kompensiert und so selbst bei Punktwolken im Stadtmaßstab praktikable Geschwindigkeiten erreicht.
PointNet++ (Qi et al., 2017) speist Punkte unverändert in das Netzwerk ein, ohne sie zu voxelisieren oder anderweitig zu konvertieren. RangeNet++ (Milioto et al., 2019) verzichtet vollständig auf die 3D-Verarbeitung: Es projiziert die Punktwolke mithilfe der Scanreihenfolge des LiDAR in ein 2D-„Entfernungsbild“, wendet ein herkömmliches 2D-CNN darauf an und projiziert das Ergebnis zurück in 3D – und nutzt dabei die ausgereifte Technologie der 2D-CNNs für eine hohe Geschwindigkeit. Cylinder3D (Zhu et al., 2021) stellte fest, dass LiDAR-Punktwolken im Außenbereich vom Sensor nach außen strahlen und voxelisiert in zylindrischen statt kartesischen Koordinaten, um den daraus resultierenden Dichteabfall mit zunehmender Entfernung zu berücksichtigen. SPVNAS (Tang et al., 2020) fusioniert punkt- und voxelbasierte Verarbeitung mittels Sparse Point-Voxel Convolution und wendet anschließend die Suche nach neuronalen Architekturen (NAS) an, um automatisch Konfigurationen mit einem optimalen Verhältnis von Genauigkeit und Geschwindigkeit zu finden.
Wie im 2D-Fall lässt sich die Entwicklung der 3D-Semantischen Segmentierung als ein ständiges Hin und Her zwischen „Punkte als Punkte beibehalten“ (punktbasiert) und „In ein regelmäßiges Raster umwandeln“ (voxel- oder bildbasierte Segmentierung) beschreiben, wobei Genauigkeit, Geschwindigkeit und Speicherbedarf jeweils unterschiedlich abgewogen werden.
12. Die richtige Vorgehensweise in der Praxis
Welche Methode – Detektion oder Segmentierung – und welcher Algorithmus verwendet wird, hängt stark vom Anwendungsfall ab.
-
Roboterarme / Greifen: Die genaue Kenntnis der Konturen des zu greifenden Objekts ist entscheidend. Daher eignet sich die Instanzsegmentierung (z. B. Mask2Former) am besten – ein Begrenzungsrahmen allein gibt weder die wahre Form des Objekts noch einen geeigneten Greifpunkt preis.
-
Autonomes Fahren: Echtzeitfähigkeit ist unerlässlich. Daher setzt man in 2D auf einstufige Detektoren (die YOLO-Familie) und in 3D auf effizienzorientierte, BEV-basierte 3D-Detektoren wie PointPillars oder CenterPoint. Semantische/panoptische Segmentierung wird häufig zusätzlich eingesetzt, um den befahrbaren Bereich zu ermitteln.
-
Überwachungskameras: Die Anzahl der Zielklassen (Personen, Fahrzeuge) ist in der Regel begrenzt, und das Übersehen eines Objekts ist wichtiger als die reine Geschwindigkeit. Dies eröffnet die Möglichkeit für zweistufige Detektoren oder hochpräzise Transformer-basierte Verfahren.
-
AR/VR: Die Bestimmung des Ankerpunkts eines virtuellen Objekts in der realen Welt erfolgt typischerweise durch semantische Segmentierung zur Identifizierung von Ebenen und Objektbereichen. Anschließend wird Sensorfusion (siehe Begleitartikel) für eine präzise 3D-Ausrichtung angewendet.
Auf ressourcenbeschränkten Endgeräten haben Geschwindigkeit und geringer Speicherbedarf meist Vorrang vor Genauigkeit – hier kommen ressourcenschonende YOLO-Varianten oder ein abgespeckter SegFormer zum Einsatz. Für präzise Offline-Analysen (medizinische Bildgebung, Satellitenbilder) steht die Genauigkeit an erster Stelle, weshalb zweistufige Detektoren oder Modelle der Mask2Former-Klasse bevorzugt werden. In der Praxis ist dieser Kompromiss zwischen Echtzeitleistung und Genauigkeit der wichtigste Entscheidungsfaktor.
Die neuesten Entwicklungen – NMS-freie Architekturen, Open-Vocabular-basierte Objekterkennung und Basismodelle der Segment Anything-Familie – finden Sie unter Technologietrends in der Objekterkennung und Technologietrends in der semantischen Segmentierung.
13. Zusammenfassung
Die Objekterkennung erfasst Objekte als Rechtecke; die semantische Segmentierung erfasst sie Pixel für Pixel – zwei Bildverarbeitungsaufgaben mit unterschiedlichen Auflösungen. Die Entwicklung der Objekterkennung reicht von zweistufigen Verfahren (Faster R-CNN) über einstufige Verfahren (YOLO) bis hin zu Transformer-basierten Detektoren, die Anker und NMS vollständig weglassen (DETR/DINO). Die Entwicklung der Segmentierung reicht von FCN über U-Net und DeepLab bis hin zu den Transformer-basierten Verfahren SegFormer/Mask2Former. Auf dieser Grundlage bilden die Instanzsegmentierung, die eine Unterscheidung pro Objekt ermöglicht, die panoptische Segmentierung, die beides vereint, und ihre 3D-Punktwolken-basierten Pendants. Welches Verfahren man wählt, hängt immer davon ab, ob Genauigkeit oder Geschwindigkeit gefragt ist.
Welche Ausgaben unterscheiden Erkennung von Segmentierung?
Die Erkennung liefert typischerweise Rechtecke und Klassen; die Segmentierung liefert Pixelbereiche. Wählen Sie entsprechend Ihren Anforderungen an Lokalisierung, Konturen und Instanzidentität.
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.