Contents — find the section you need
Antes de que un robot pueda "recoger la taza de la mesa" o "evitar al peatón", primero debe comprender, a partir de una imagen de la cámara, qué hay y dónde. Esta comprensión es la función de la detección de objetos y la segmentación semántica. Si bien a menudo se mencionan juntas, difieren fundamentalmente, tanto en el nivel de detalle de sus resultados como en la forma en que se plantea el problema subyacente. Este artículo desarrolla ambos conceptos desde cero, pasando por sus contrapartes en 3D, hasta una clara comparación directa.
 Cámara de percepción del vehículo
Imagen: Car cámara de ventana del sistema Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Una cámara de entrada representativa, no una afirmación sobre las últimas especificaciones del producto.

0. Contenido de este artículo
- Qué producen realmente la detección de objetos y la segmentación semántica
- El proceso de detección (extracción de características → cabezal de detección)
- La evolución de los algoritmos de puntos de referencia, desde R-CNN hasta YOLO, DETR y DINO, y cómo difieren sus filosofías de diseño
- La disyuntiva entre dos y una etapa, y dónde encajan los detectores basados en Transformer
- Cómo evolucionaron los algoritmos de segmentación, desde FCN hasta Mask2Former
- Una tabla que explica las diferencias entre la detección, la segmentación semántica, la segmentación de instancias y la segmentación panóptica
- Los fundamentos de la detección de objetos 3D y la segmentación semántica 3D en nubes de puntos
- Cómo elegir la tecnología adecuada para robótica, conducción autónoma, vigilancia y realidad aumentada
1. Respuesta breve: Qué son la detección y la segmentación
En una frase: La detección de objetos responde a la pregunta "¿dónde está qué en la imagen?" con un rectángulo (un La segmentación de instancias colorea los píxeles, al igual que la segmentación semántica, y la segmentación panóptica** responde a la pregunta "¿qué representa cada píxel?" coloreando la imagen. Ambas comparten el mismo objetivo fundamental: comprender una imagen, pero lo hacen con resoluciones completamente diferentes.
Otras dos tareas se basan en este par. La segmentación de instancias colorea los píxeles como la segmentación semántica, pero también distingue objetos individuales de la misma clase (por ejemplo, tres personas distintas en un fotograma). La segmentación panóptica unifica la segmentación de instancias con la segmentación semántica necesaria para elementos de fondo "incontables", como carreteras o cielo, en una única salida lo más completa posible. La sección 9, a continuación, muestra la relación entre estas cuatro tareas en una tabla.
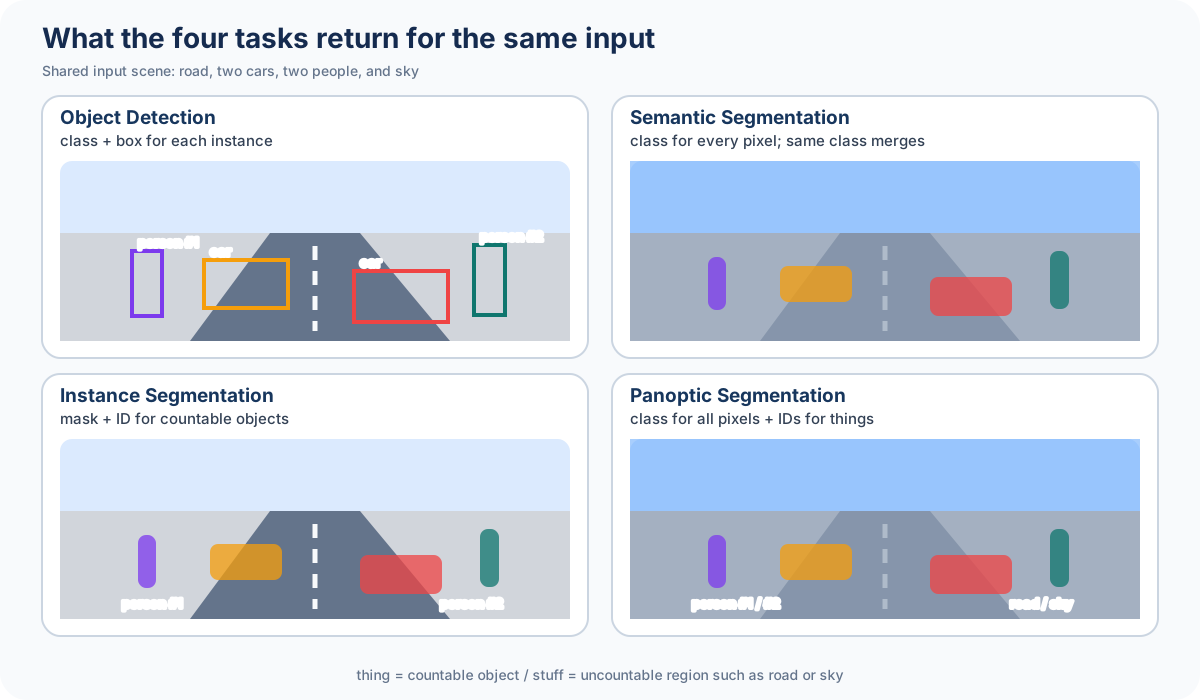
Figura: Duskcoil. Generada a partir de una escena esquemática y geometría compartida; no es la salida del modelo medido.
2. ¿Qué es la detección de objetos? (Clase / Cuadro Delimitador / Confianza)
Para una sola imagen, la Detección de Objetos genera un conjunto de tripletas, una por objeto:
- Clase: qué es el objeto (una de un conjunto predefinido de categorías: "persona", "coche", "silla", etc.)
- Cuadro Delimitador: el rectángulo que encierra el objeto, generalmente dado como un punto central más ancho y alto (x, y, w, h), o como las esquinas superior izquierda/inferior derecha (x_1, y_1, x_2, y_2)
- Confianza: una puntuación (0-1) que indica la certeza del modelo sobre esa combinación particular de cuadro delimitador y clase.
La Clasificación de Imágenes devuelve una única respuesta: "¿qué es esta imagen?", pero la Detección de Objetos debe responder "cuántos objetos hay, dónde están y de qué tipo" simultáneamente. Esta propiedad de "el recuento en sí es desconocido" es lo que hace que la Detección sea fundamentalmente más difícil que la clasificación. Una imagen puede contener cero objetos o cien; precisamente la variabilidad en el número de resultados es la limitación de diseño que impulsa prácticamente todas las técnicas que se describen a continuación.
3. ¿Cómo se realiza la detección?
Ante este problema de la variabilidad en el número de resultados, prácticamente todos los algoritmos de detección modernos siguen el mismo proceso de dos etapas: extraer un mapa de características de la imagen completa, dividir ese mapa de características con un gran número de ubicaciones candidatas (cuadros de anclaje o las "consultas" del Transformer que se describen más adelante) y, para cada candidata, determinar si se trata de un objeto o fondo y, en caso de ser un objeto, determinar su clase y su ubicación exacta.
Figura 2 — El extractor de características (estructura principal) comprime la imagen en un mapa de características, y el módulo de detección realiza simultáneamente la clasificación y la regresión de la caja.
Dentro del módulo de detección, se resuelven simultáneamente dos problemas de regresión/clasificación: "¿Existe un objeto en esta ubicación candidata? Si es así, ¿a qué clase pertenece?" y "¿Cuánto debe desplazarse este candidato (ancla) para alinearse con el objeto real?". La combinación de estos problemas en una única función de pérdida de suma ponderada es la función de pérdida multitarea ampliamente utilizada desde Fast R-CNN en adelante.
Aquí, p representa la probabilidad de clase predicha, p^{*} la clase real, t la corrección del cuadro predicho y t^{*} la corrección objetivo derivada del cuadro real. El indicador \mathbb{1}[p^{*} > 0] significa "calcular el error de regresión de ubicación solo para los candidatos que contienen un objeto, no fondo". Un candidato a fondo no tiene un cuadro real hacia el cual realizar la regresión, por lo que esta restricción es natural. \lambda ajusta la ponderación del término de regresión en relación con la clasificación.
4. Algoritmos de detección de puntos de referencia
La evolución de los algoritmos de detección se comprende mejor a través de dos ejes: "cómo se reducen las regiones candidatas" y "cómo se predice el cuadro".
R-CNN (Girshick et al., 2014) extrajo alrededor de 2000 regiones candidatas de una imagen mediante el algoritmo clásico de procesamiento de imágenes Búsqueda Selectiva, y luego procesó cada una individualmente con una CNN para su clasificación. Si bien era preciso, resultaba extremadamente lento, ya que la CNN debía ejecutarse una vez por cada región candidata.
Fast R-CNN (Girshick, 2015) procesó la imagen completa con una CNN una sola vez para construir un único mapa de características, y luego recortó las regiones candidatas de ese mapa de características (RoI Pooling), eliminando así el cálculo redundante por región.
Faster R-CNN (Ren, He, Girshick, Sun, 2015) fue un paso más allá y reemplazó la generación de regiones candidatas con una pequeña Red de Propuesta de Región (RPN), integrando la generación de propuestas, la clasificación y la regresión en una sola red. Estas tres generaciones, en conjunto, conforman el linaje de lo que se conoce como detector de dos etapas.
SSD (Liu et al., 2016) y YOLO (Redmon et al., 2015–2016) fueron pioneros en los detectores de una etapa, eliminando por completo la etapa de región candidata y prediciendo la clase y el recuadro directamente a partir de cada ubicación en el mapa de características. La velocidad aumentó drásticamente, aunque las primeras versiones de YOLO presentaban una precisión inferior a la de los detectores de dos etapas en la detección de objetos pequeños.
RetinaNet (Lin et al., 2017) abordó el problema del desequilibrio de clases que afectaba a los detectores de una etapa —los candidatos a fondo superaban ampliamente en número a los candidatos a objeto, y el entrenamiento se veía dominado por ellos— con una nueva función de pérdida, la Pérdida Focal, demostrando que los detectores de una etapa podían, después de todo, igualar la precisión de los de dos etapas.
FCOS (Tian et al., 2019) eliminó por completo el uso de anclas: en lugar de predefinir un conjunto de cajas de anclaje con diferentes tamaños y relaciones de aspecto, calcula la regresión de la distancia de cada píxel del mapa de características directamente al límite del objeto, evitando así el ajuste de hiperparámetros que exige el diseño de anclas.
DETR, Deformable DETR y DINO replantean la detección con Transformers como un problema de predicción de conjuntos, tema de la siguiente sección.
5. Dos etapas vs. Una etapa
Los detectores de dos etapas y de una etapa se diferencian en una sola pregunta: ¿existe el estrechamiento de la región candidata como una etapa independiente?
| Aspecto | Dos etapas (p. ej., Faster R-CNN) | Una etapa (p. ej., YOLO) |
|---|---|---|
| Flujo | Generación de propuestas (RPN) → clasificación y regresión por región | Clasificación y regresión directa en cada ubicación del mapa de características |
| Precisión | Generalmente alta, especialmente en objetos pequeños/densos | Las generaciones recientes reducen considerablemente la brecha |
| Velocidad de inferencia | Relativamente lenta (aún requiere trabajo por candidato) | Rápida, adecuada para tiempo real |
| Costo computacional | Escala con el número de candidatos | Aproximadamente proporcional al tamaño de la imagen, predecible |
| Dificultad de implementación/ajuste | Más etapas, más complejo | Pipeline más simple |
| Aplicaciones | Procesamiento fuera de línea, inspección/análisis con prioridad en la precisión | Percepción en tiempo real en vehículos y robots |
Ambas familias se basaron durante mucho tiempo en la supresión no máxima (NMS) como posprocesamiento para reducir la superposición de candidatos. Entre las diversas cajas candidatas generadas para un objeto, se descarta cualquier superposición (IoU: Intersección sobre Unión) con otra que supere un umbral, según esta definición:
A y B son las regiones que ocupan dos cajas; al dividir su área de superposición por su área de unión, se obtiene una puntuación entre 0 y 1. Un IoU alto indica que es probable que las dos cajas apunten al mismo objeto, por lo que se descarta la de menor confianza. El método NMS funciona, pero puede fallar en objetos muy agrupados, una debilidad que la familia DETR, que se describe a continuación, elimina por completo.
6. Detección en la Era Transformer (DETR / DETR Deformable / DINO)
DETR (Carion et al., 2020, Facebook AI) cambió la formulación de la detección desde su esencia. Sin anclas ni NMS, procesa las características de la imagen mediante un codificador Transformer y pasa un número fijo de "consultas" (vectores entrenables que representan objetos candidatos) a través de un decodificador, generando directamente esa misma cantidad de pares caja-clase. Durante el entrenamiento, el conjunto predicho y el conjunto real se comparan uno a uno mediante el algoritmo húngaro, y la pérdida se calcula en función de dicha comparación.
y_i es el objeto real i, \hat{y}_{\sigma(i)} la predicción asignada a este objeto bajo la permutación \sigma, y \mathfrak{S}_N el conjunto de todas las permutaciones de los elementos N. Esto significa: encontrar la permutación \hat{\sigma} que asigne predicciones a valores reales de forma uno a uno con el mínimo coste total; solo una vez establecida dicha asignación se pueden calcular las pérdidas habituales de clasificación y regresión. Dado que a ningún objeto se le puede asignar más de una predicción, la supresión de mínimos cuadrados (NMS) resulta innecesaria por definición.
DETR tenía una desventaja: la autoatención completa sobre toda la imagen es costosa, y el modelo requería un número enorme de épocas de entrenamiento para converger. DETR Deformable (Zhu et al., 2020) introdujo un mecanismo de atención deformable en el que cada consulta se centra únicamente en un pequeño conjunto aprendido de puntos de muestreo, en lugar de en toda la imagen, lo que reduce el cálculo y acelera drásticamente la convergencia. DINO (Zhang et al., 2022; "DETR con cajas de anclaje de eliminación de ruido mejoradas") incorporó técnicas como consultas de eliminación de ruido contrastivas para la estabilidad del entrenamiento y la selección de consultas mixtas para inicializar las consultas a partir del mapa de características, alcanzando la mejor precisión entre los detectores de la familia DETR en ese momento. Los detectores basados en Transformer ahora se sitúan junto a la familia YOLO como una de las dos principales tendencias en su uso en producción.
7. ¿Qué es la segmentación semántica?
La segmentación semántica predice, para cada píxel de una imagen, a qué clase pertenece. Su resultado no es un cuadro delimitador, sino un "mapa de clases" con la misma resolución que la imagen de entrada, donde cada píxel lleva un identificador de clase.
Mientras que la detección de objetos aproxima un objeto con un rectángulo grueso, la segmentación semántica puede representar el contorno real del objeto con resolución de píxel, una gran ventaja para formas delgadas y alargadas como un bordillo, o contornos complejos como las ramas de un árbol. La desventaja: incluso cuando aparecen varias instancias de la misma clase en un fotograma, la segmentación semántica no las distingue; todos los píxeles que representan a una persona se pintan del mismo color y se pierde el recuento de individuos. La segmentación de instancias, que se describe más adelante, se encarga precisamente de solucionar este problema.
8. Algoritmos de segmentación de puntos de referencia
FCN (Red Convolucional Completa; Long, Shelhamer, Darrell, 2015) eliminó las capas totalmente conectadas de una CNN de clasificación de imágenes, dejando solo las capas convolucionales, de modo que la red podía generar predicciones a nivel de píxel directamente para entradas de cualquier tamaño. Es el punto de partida de este campo: el primer diseño que estableció la segmentación semántica como una única red entrenable de extremo a extremo.
U-Net (Ronneberger et al., 2015), propuesta para la segmentación de imágenes médicas, dispone un codificador (que realiza submuestreo durante la extracción de características) simétricamente frente a un decodificador (que realiza sobremuestreo durante la reconstrucción), y conecta directamente las capas del codificador y del decodificador con la misma resolución mediante "conexiones de salto". Este diseño, que preserva los detalles finos de los contornos a la vez que produce una salida de alta resolución, se convirtió en una arquitectura estándar que se extendió mucho más allá de la medicina.
SegNet (Badrinarayanan et al.) recuerda, durante el agrupamiento del codificador, la posición exacta que contenía el valor máximo ("índices de agrupamiento"), y luego reutiliza ese registro durante el sobremuestreo del decodificador, restaurando los contornos de forma eficiente en términos de memoria. PSPNet (Zhao et al., 2017) introdujo un módulo de agrupamiento piramidal que promedia las características en regiones a múltiples escalas, capturando el contexto de la imagen completa que un campo receptivo estrecho por sí solo no podría captar.
La serie DeepLab (Chen et al.) basó su núcleo en la convolución dilatada (atrosa), que amplía los intervalos entre los núcleos para aumentar el campo receptivo sin sacrificar la resolución, evolucionando desde la versión 1 hasta la 3+ (2018). HRNet (Wang et al., 2019) invirtió el enfoque habitual: en lugar de reducir la resolución y luego restaurarla, mantiene un flujo de características de alta resolución activo en paralelo a lo largo de toda la red, intercambiando información continuamente entre resoluciones.
SegFormer (Xie et al., 2021) combinó un codificador Transformer jerárquico con un decodificador MLP ligero, logrando alta precisión y eficiencia con un diseño sorprendentemente simple. Mask2Former (Cheng et al., 2022) reformuló la segmentación como "un número fijo de consultas, cada una prediciendo una máscara y una clase", restringiendo la atención de cada consulta a la región de la máscara predicha en la capa anterior mediante "atención enmascarada". Esto proporciona una convergencia rápida y una arquitectura única que maneja la segmentación semántica, de instancia y panóptica por igual.
9. Comparación de detección / semántica / de instancia / panóptica
Las cuatro tareas presentadas hasta ahora se aclaran al organizarlas en dos ejes: ¿distingue instancias individuales de la misma clase? y ¿maneja el "fondo" (elementos incontables como carreteras, cielo o paredes)?
| Tarea | Unidad de salida | Distingue instancias | Maneja el fondo | Algoritmos de puntos de referencia | Métrica clave |
|---|---|---|---|---|---|
| Detección de objetos | Cuadro delimitador | Sí (un cuadro por instancia) | No | Faster R-CNN, YOLO, DETR | mAP |
| Segmentación semántica | Etiqueta de clase por píxel | No (la misma clase se fusiona en un solo color) | Sí | FCN, DeepLab, SegFormer | mIoU |
| Segmentación de instancias | Máscara por píxel | Sí (máscara separada por instancia) | No | Mask R-CNN, Mask2Former | AP (basado en IoU de máscara) |
| Segmentación panóptica | Clase por píxel + ID de instancia | Sí (solo primer plano) | Sí (solo clase, sin ID de instancia) | Panoptic FPN, Mask2Former | PQ (Calidad panóptica) |
Como se muestra en la tabla, la segmentación panóptica (propuesta por Kirillov et al., 2019) es la mejor combinación de la segmentación de instancias y la segmentación semántica. Los objetos en primer plano —elementos contables como personas y automóviles— se distinguen por instancia, como en la segmentación de instancias; El fondo —elementos incontables como la carretera y el cielo— solo recibe una etiqueta de clase, como en la segmentación semántica. Si se busca describir una sola imagen de forma completa y exhaustiva, se llega exactamente a esta forma panóptica, una manera útil de ver cómo se relacionan las cuatro tareas.
La métrica de evaluación mIoU (Intersección sobre Unión media) calcula, para cada clase c, la IoU entre la región real G_c y la región predicha P_c, y luego promedia entre todas las clases.
Mientras que la métrica mAP de detección evalúa la concordancia a nivel de cajas, mIoU la evalúa a nivel de píxeles; esta diferencia en la métrica refleja exactamente la diferencia en lo que cada tarea considera "correcto".
10. Detección de objetos 3D
Los vehículos autónomos y los robots a menudo necesitan detectar la posición, el tamaño y la orientación 3D de un objeto directamente a partir de nubes de puntos LiDAR, no solo de imágenes 2D. Una nube de puntos no tiene la estructura de cuadrícula de una imagen 2D, por lo que una CNN no puede procesarla tal cual. Convertir estos datos irregulares en datos regulares es el principal desafío de diseño en la detección de objetos 3D.
SECOND (Yan et al., 2018) divide una nube de puntos en vóxeles 3D (celdas cúbicas) y utiliza convolución dispersa para omitir la gran fracción de vóxeles que no contienen puntos, reduciendo drásticamente el coste computacional de las CNN 3D. PointPillars (Lang et al., 2019) simplificó aún más este proceso, agrupando los puntos en "pilares" verticales en lugar de vóxeles, de modo que la red puede procesarlos con convolución 2D convencional en lugar de 3D, lo que aumenta significativamente la velocidad.
PV-RCNN (Shi et al., 2020) combinó la eficiencia del procesamiento basado en vóxeles con la localización precisa que se obtiene al procesar puntos directamente (estilo PointNet), en un diseño híbrido de punto-vóxel. CenterPoint (Yin et al., 2021) introdujo un enfoque sin anclajes para la detección 3D: detecta un objeto como un único punto central, luego estima su ancho, altura, profundidad y orientación a partir de ahí, combinándolo con arquitecturas tipo PointPillars o VoxelNet para lograr una alta precisión.
Muchos de estos métodos comparten otra idea de diseño: proyectar la información de la nube de puntos en una vista aérea (BEV, por sus siglas en inglés) —un mapa de características 2D visto desde arriba— antes de ejecutar el cabezal de detección. Al comprimir la información de altura, se sacrifica algo de detalle a cambio de la capacidad de determinar la ubicación del objeto en la superficie de la carretera —la relación más importante para la conducción— dentro del mismo marco que un detector 2D convencional.
11. Segmentación Semántica 3D
La Segmentación Semántica 3D asigna una etiqueta de clase a cada punto de una nube de puntos (o a cada señal láser recibida por un LiDAR). Una vez más, la forma de manejar datos de nubes de puntos irregulares es lo que diferencia los principales enfoques.
PointNet++ (Qi et al., 2017) introduce los puntos en la red tal cual, sin voxelización ni otras conversiones, agrupando puntos vecinos y agregando características jerárquicamente, sentando así las bases para los métodos basados en puntos. RandLA-Net (Hu et al., 2020) abordó el problema de la búsqueda de vecinos que encarecía el procesamiento de nubes de puntos a gran escala, combinando el muestreo aleatorio con un módulo de agregación de características locales que compensa la información que el muestreo aleatorio perdería, alcanzando velocidades prácticas incluso en nubes de puntos a escala urbana.
RangeNet++ (Milioto et al., 2019) omite por completo el procesamiento 3D: proyecta la nube de puntos, utilizando el orden de escaneo del propio LiDAR, en una "imagen de rango" 2D, aplica una CNN 2D convencional sobre ella y proyecta el resultado de nuevo en 3D, aprovechando la madurez de las herramientas de CNN 2D para mayor velocidad. Cylinder3D (Zhu et al., 2021) observó que las nubes de puntos LiDAR en exteriores irradian hacia afuera desde el sensor y voxelizó en coordenadas cilíndricas en lugar de cartesianas para gestionar la consiguiente disminución de densidad con la distancia. SPVNAS (Tang et al., 2020) fusionó el procesamiento basado en puntos y en vóxeles mediante convolución dispersa de punto-vóxel, y luego aplicó la búsqueda de arquitectura neuronal (NAS) para encontrar automáticamente configuraciones con un fuerte equilibrio entre precisión y velocidad.
Al igual que en el caso 2D, la historia de la segmentación semántica 3D puede interpretarse como una alternancia entre "mantener los puntos como puntos" (basada en puntos) y "convertir a una cuadrícula regular" (basada en vóxeles o imágenes de rango), cada una con sus propias limitaciones en cuanto a precisión, velocidad y memoria.
12. Elegir el enfoque adecuado en la práctica
La elección entre detección o segmentación, y el algoritmo específico, depende en gran medida del caso de uso.
- Brazos robóticos / manipulación de objetos: conocer el contorno exacto del objeto a sujetar es fundamental, por lo que la segmentación de instancias (p. ej., Mask2Former) es la más adecuada; un cuadro delimitador por sí solo no revela la forma real del objeto ni un buen punto de agarre.
-
Conducción autónoma: el rendimiento en tiempo real es fundamental, por lo que la detección 2D se basa en detectores de una etapa (familia YOLO), y la detección 3D en detectores 3D basados en BEV (vehículos eléctricos de batería) orientados a la eficiencia, como PointPillars o CenterPoint. La segmentación semántica/panóptica se suele aplicar para comprender el área transitable.
-
Cámaras de vigilancia/seguridad: el conjunto de clases objetivo (personas, vehículos) suele ser limitado, y no detectar un objeto es más importante que la velocidad bruta, lo que abre la puerta a detectores de dos etapas o a detectores Transformer de alta precisión.
-
Realidad aumentada/realidad virtual: decidir dónde anclar un objeto virtual en el mundo real generalmente implica usar la segmentación semántica para identificar planos y regiones de objetos, y luego aplicar la fusión de sensores (ver el artículo complementario) para una alineación 3D precisa.
En dispositivos periféricos con recursos limitados, la velocidad y el tamaño suelen primar sobre la precisión: variantes ligeras de YOLO o una versión reducida de SegFormer. Para un análisis preciso sin conexión (imágenes médicas, imágenes satelitales), la precisión es primordial, favoreciendo los detectores de dos etapas o los modelos de la clase Mask2Former. En la práctica, esta compensación entre rendimiento en tiempo real y precisión es el factor más importante en la decisión.
Para conocer los últimos avances —arquitecturas sin NMS, detección de vocabulario abierto, modelos base de la familia Segment Anything— consulte Tendencias tecnológicas en detección de objetos y Tendencias tecnológicas en segmentación semántica.
13. Resumen
La detección de objetos los captura como rectángulos; la segmentación semántica los captura píxel a píxel: dos tareas de comprensión de imágenes que operan a diferentes resoluciones. La evolución de la detección abarca desde las redes neuronales de dos etapas (Faster R-CNN) hasta las de una etapa (YOLO), pasando por los detectores basados en Transformer que prescinden de anclas y la supresión de nomenclatura (DETR/DINO). La segmentación, por su parte, va desde las redes neuronales convolucionales (FCN) hasta U-Net y DeepLab, llegando a los detectores SegFormer/Mask2Former basados en Transformer. Sobre esta base se asientan la segmentación de instancias, que añade distinción por objeto; la segmentación panóptica, que unifica ambas; y sus contrapartes 3D basadas en nubes de puntos. La elección entre una u otra depende siempre de si se requiere precisión o velocidad.
¿Qué resultados distinguen la detección de la segmentación?
La detección suele devolver cuadros delimitadores y clases; la segmentación devuelve regiones de píxeles.
Seleccione según las necesidades de localización, contornos e identificación de instancias. ## Referencias - [COCO — Objetos comunes en contexto](https://cocodataset.org/) - [Detectron2 (Facebook AI Research)](https://github.com/facebookresearch/detectron2) - [Carion et al., "Detección de objetos de extremo a extremo con transformadores" (DETR)](https://arxiv.org/abs/2005.12872)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.