Contents — find the section you need
Bir robotun "masadaki bardağı alabilmesi" veya "önündeki yayayı atlatabilmesi" için öncelikle kamera görüntüsünden ne olduğunu ve nerede olduğunu anlaması gerekir. Bu anlama, Nesne Algılama ve Semantik Bölümleme'nin işidir. İkisi sıklıkla aynı cümle içinde anılır, ancak temelde farklıdırlar - hem çıktılarının ne kadar ayrıntılı olduğu hem de altta yatan sorunun nasıl çerçevelendiği açısından. Bu makale, her ikisini de temelden, 3 boyutlu karşılıkları ve net bir karşılaştırmayla ele almaktadır.
 Araç algılama kamerası
Resim: Car Mobileye sisteminin pencere kamerası (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Temsili bir giriş kamerası, en son ürün özellikleriyle ilgili bir iddia değil.

0. Bu Makalenin Kapsamı
- Nesne Algılama ve Semantik Bölümlemenin her birinin gerçekte ne ürettiği
- Algılamanın çalıştığı işlem hattı (özellik çıkarımı → algılama başlığı)
- R-CNN'den YOLO, DETR ve DINO'ya kadar dönüm noktası algoritmalarının soy ağacı ve tasarım felsefelerinin nasıl farklılaştığı
- İki aşamalı ve tek aşamalı arasındaki denge ve Transformer tabanlı dedektörlerin nerede yer aldığı
- Bölümleme algoritmalarının FCN'den Mask2Former'a nasıl evrimleştiği
- Algılama, Semantik, Örnek ve Panoptik Bölümleme arasındaki farkları açıklayan tek bir tablo
- Nokta bulutlarında 3B Nesne Algılama ve 3B Semantik Bölümlemenin temelleri
- Robotik, otonom sürüş, gözetim ve AR için doğru teknolojiyi nasıl seçeceğiniz
1. Kısa Cevap: Algılama ve Bölümleme Nedir?
Tek cümleyle: Nesne Algılama, "görüntüde ne nerede?" sorusuna bir dikdörtgen (sınır kutusu) ile cevap verirken, Semantik Bölümleme ise "her piksel ne anlama geliyor?" sorusuna görüntüyü renklendirerek cevap verir. Her ikisi de aynı temel amaca, yani görüntüyü anlamaya odaklanır, ancak tamamen farklı çözünürlüklerde cevap verirler.
İki ek görev bu ikili üzerine kuruludur. Örnek Bölümleme, Semantik Bölümleme gibi pikselleri renklendirir, ancak aynı zamanda aynı sınıfa ait ayrı nesneleri de ayırt eder (örneğin, bir karede üç ayrı kişi). Panoptik Bölümleme, bu Örnek Bölümlemeyi, yol veya gökyüzü gibi "sayılamayan" arka plan öğeleri için gerekli olan Semantik Bölümleme ile birleştirerek tek, maksimum düzeyde eksiksiz bir çıktı oluşturur. Aşağıdaki 9. Bölüm, bu dört yöntemin nasıl ilişkili olduğunu bir tabloda göstermektedir.
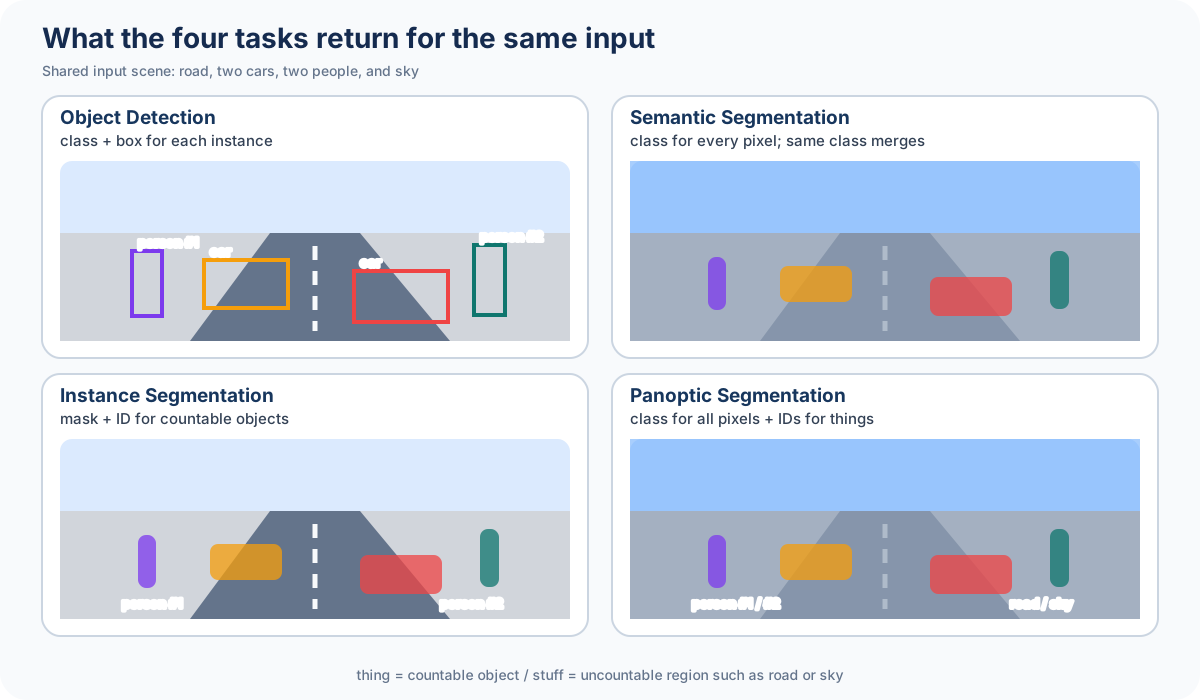
Şekil: Duskcoil. Bir şematik sahneden ve paylaşılan geometriden oluşturulmuştur; ölçülmüş model çıktısı değildir.
2. Nesne Algılama Nedir? (Sınıf / Sınır Kutusu / Güvenirlik)
Tek bir görüntü için, Nesne Algılama, nesne başına bir tane olmak üzere bir dizi üçlü çıktı üretir:
- Sınıf: Nesnenin ne olduğu (önceden tanımlanmış bir kategori kümesinden biri — "kişi", "araba", "sandalye" vb.)
- Sınır Kutusu: Nesneyi çevreleyen dikdörtgen, genellikle bir merkez noktası artı genişlik ve yükseklik (x, y, w, h) veya sol üst/sağ alt köşeler (x_1, y_1, x_2, y_2) olarak verilir.
- Güvenirlik: Modelin o belirli kutu-sınıf eşleşmesi hakkında ne kadar emin olduğunu gösteren bir puan (0-1).
Görüntü Sınıflandırması tek bir cevap döndürür — "bu resim neyin resmi" — ancak Nesne Algılama, "kaç nesne, nerede ve ne tür" sorularına aynı anda cevap vermek zorundadır. "Sayının kendisi bilinmiyor" özelliği, Algılamayı sınıflandırmadan temel olarak daha zor hale getirir. Verilen bir görüntü sıfır nesne veya yüz nesne içerebilir; çıktı sayısının değişken olması, aşağıda tartışılan her yöntemin temelini oluşturan tasarım kısıtlamasıdır.
3. Algılama Gerçekte Nasıl Yapılır?
Bu değişken çıktı sayısı sorunuyla karşı karşıya kalan modern algılama algoritmalarının neredeyse tamamı aynı iki aşamalı süreci izler: tüm görüntüden bir özellik haritası çıkarın, bu özellik haritasını çok sayıda aday konumla (çapa kutuları veya daha sonra tartışılan Transformer "sorguları") döşeyin ve her aday için "nesne mi yoksa arka plan mı" kararını verin ve eğer nesne ise "hangi sınıf ve tam konumu nedir" kararını verin.
Şekil 2 — Özellik çıkarıcı (omurga), görüntüyü bir özellik haritasına sıkıştırır ve algılama başlığı, bunun üzerinde eş zamanlı olarak sınıflandırma ve kutu regresyonu gerçekleştirir.
Algılama başlığının içinde, iki regresyon/sınıflandırma problemi aynı anda etkili bir şekilde çözülür: "Bu aday konumda bir nesne var mı ve varsa hangi sınıfa ait?" ve "Bu aday (çapa) gerçek nesneyle hizalanacak şekilde ne kadar kaydırılmalıdır?" Bunları tek bir ağırlıklı toplam kaybında birleştirmek, Fast R-CNN'den itibaren yaygın olarak kullanılan çoklu görev kaybıdır.
Burada p tahmin edilen sınıf olasılığı, p^{*} gerçek sınıf, t tahmin edilen kutu düzeltmesi ve t^{*} gerçek kutudan türetilen hedef düzeltmesidir. \mathbb{1}[p^{*} > 0] göstergesi "sadece nesne içeren adaylar için konum regresyon hatasını hesaplayın, arka plan için değil" anlamına gelir — bir arka plan adayının regresyon yapılacak gerçek bir kutusu yoktur, bu nedenle bu kısıtlama doğaldır. \lambda, sınıflandırmaya göre regresyon terimine ne kadar ağırlık verileceğini ayarlar.
4. Dönüm Noktası Tespit Algoritmaları
Tespit algoritmalarının soy ağacını iki eksen boyunca takip etmek en kolayıdır: "aday bölgeler nasıl daraltılır" ve "kutunun kendisi nasıl tahmin edilir".
R-CNN (Girshick vd., 2014), klasik görüntü işleme algoritması Seçici Arama'yı kullanarak bir görüntüden yaklaşık 2000 aday bölge çıkardı ve ardından her birini sınıflandırma için ayrı ayrı bir CNN'den geçirdi. Doğru sonuçlar verdi, ancak CNN'nin her aday bölge için bir kez çalıştırılması gerektiğinden son derece yavaştı.
Hızlı R-CNN (Girshick, 2015), tek bir özellik haritası oluşturmak için tüm görüntüyü yalnızca bir kez bir CNN'den geçirdi ve ardından bu özellik haritasından aday bölgeleri kırptı (RoI Havuzlama) - gereksiz bölge başına hesaplamayı ortadan kaldırdı.
Daha Hızlı R-CNN (Ren, He, Girshick, Sun, 2015), bir adım daha ileri giderek aday bölge oluşturma işlemini küçük bir Bölge Öneri Ağı (RPN) ile değiştirdi ve öneri oluşturma, sınıflandırma ve regresyonu tek bir ağda birleştirdi. Bu üç nesil birlikte, İki aşamalı dedektör olarak adlandırılan şeyin soyunu oluşturur.
SSD (Liu vd., 2016) ve YOLO (Redmon vd., 2015–2016), aday bölge aşamasını tamamen ortadan kaldırarak ve özellik haritasındaki her konumdan doğrudan sınıf ve kutuyu tahmin ederek Tek aşamalı dedektörlere öncülük etti. Hız önemli ölçüde arttı, ancak erken dönem YOLO, küçük nesne doğruluğunda İki aşamalı dedektörlerin gerisinde kaldı.
RetinaNet (Lin vd., 2017), Tek aşamalı dedektörleri rahatsız eden sınıf dengesizliği sorununu (arka plan adayları nesne adaylarından çok daha fazla ve eğitim bunlara hakim oluyor) yeni bir kayıp fonksiyonu olan Odak Kaybı ile ele aldı ve Tek aşamalı dedektörlerin sonuçta İki aşamalı doğruluğa ulaşabileceğini gösterdi.
FCOS (Tian vd., 2019) tamamen çapa noktası içermeyen bir yaklaşım benimsedi: çeşitli boyutlarda ve en boy oranlarında bir dizi çapa kutusu önceden tanımlamak yerine, her özellik haritası pikselinin nesnenin sınırına olan mesafesini doğrudan regresyon yöntemiyle hesaplayarak, çapa tasarımının gerektirdiği hiperparametre ayarlamasını atlıyor.
DETR, Deformable DETR ve DINO, Transformer'larla tespiti bir küme tahmin problemi olarak yeniden ele alıyor - bu, bir sonraki bölümün konusu.
5. İki Aşamalı vs. Tek Aşamalı
İki aşamalı ve tek aşamalı dedektörler tam olarak tek bir soruda ayrılıyor: aday bölge daraltma kendi başına bağımsız bir aşama olarak mevcut mu?
| En Boy Oranı | İki Aşamalı (ör. Faster R-CNN) | Tek Aşamalı (ör. YOLO) |
|---|---|---|
| Akış | Öneri oluşturma (RPN) → bölge bazlı sınıflandırma ve regresyon | Özellik haritasındaki her konumda doğrudan sınıflandırma ve regresyon |
| Doğruluk | Genellikle yüksek, özellikle küçük/yoğun nesnelerde | Son nesiller çoğu açığı kapatıyor |
| Çıkarım hızı | Nispeten yavaş (aday başına çalışma devam ediyor) | Hızlı, gerçek zamanlıya uygun |
| Hesaplama maliyeti | Aday sayısıyla orantılı | Kabaca görüntü boyutuyla orantılı, tahmin edilebilir |
| Uygulama/ayarlama zorluğu | Daha fazla aşama, daha karmaşık | Daha basit işlem hattı |
| Uygun olduğu yerler | Çevrimdışı işleme, doğruluk öncelikli inceleme/analiz | Araçlarda ve robotlarda gerçek zamanlı algılama |
Her iki aile de uzun süre, örtüşen adayları seyreltmek için işlem sonrası olarak Maksimum Olmayan Bastırma (NMS) yöntemine güvenmiştir. Bir nesne için üretilen çeşitli aday kutular arasında, bir diğeriyle olan örtüşmesi (IoU: Kesişim/Birleşim) bir eşiği aşan herhangi bir kutu, şu tanıma göre atılır:
A ve B, iki kutunun kapladığı bölgelerdir; örtüşme alanlarını birleşim alanlarına bölmek, 0 ile 1 arasında bir puan verir. Yüksek bir IoU, iki kutunun muhtemelen aynı nesneyi işaret ettiğini gösterir, bu nedenle daha düşük güvene sahip olan atılır. NMS çalışır, ancak yoğun paketlenmiş nesnelerde yanlış sonuç verebilir - bu, bir sonraki bölümde ele alınacak olan DETR ailesinin tamamen ortadan kaldırdığı bir zayıflıktır.
6. Transformer Çağında Algılama (DETR / Deformable DETR / DINO)
DETR (Carion vd., 2020, Facebook AI), algılamanın temelde nasıl formüle edildiğini değiştirdi. Çapa ve NMS olmadan, görüntü özelliklerini bir Transformer kodlayıcıdan geçirir ve sabit sayıda "sorgu"yu (aday nesnelerin yerine geçen öğrenilebilir vektörler) bir kod çözücüden geçirerek, tam olarak o kadar kutu-sınıf çiftini doğrudan çıktı olarak verir. Eğitim sırasında, tahmin edilen küme ve gerçek küme Macar algoritması aracılığıyla bire bir eşleştirilir ve kayıp bu eşleştirmeye göre hesaplanır.
y_i, i -inci gerçek nesnedir, \hat{y}_{\sigma(i)}, \sigma permütasyonu altında ona atanan tahmindir ve \mathfrak{S}_N, N elemanının tüm permütasyonlarının kümesidir. Bu, şunu ifade eder: En düşük toplam maliyetle tahminleri gerçek değerlere bire bir atayan \hat{\sigma} permütasyonunu bulun; ancak bu atama kesinleştikten sonra olağan sınıflandırma ve regresyon kayıpları hesaplanabilir. Hiçbir nesneye birden fazla tahmin atanamayacağı için, NMS yapısı gereği gereksiz hale gelir.
DETR'nin bir dezavantajı vardı: Tüm görüntü üzerinde tam öz-dikkat mekanizması pahalıdır ve modelin yakınsaması için çok sayıda eğitim dönemine ihtiyaç duyuluyordu. Deformable DETR (Zhu vd., 2020), her sorgunun tüm görüntü yerine yalnızca küçük, öğrenilmiş bir örnekleme noktası kümesine dikkat ettiği, hesaplamayı azaltırken yakınsamayı önemli ölçüde hızlandıran deforme edilebilir bir dikkat mekanizması tanıttı. DINO (Zhang vd., 2022; "Geliştirilmiş Gürültü Giderici Çapa Kutuları ile DETR"), eğitim kararlılığı için kontrastlı gürültü giderme sorguları ve özellik haritasından sorgu başlatmayı başlatmak için karma sorgu seçimi gibi yöntemler ekleyerek, o dönemde DETR ailesi dedektörleri arasında en iyi doğruluğa ulaştı. Transformer tabanlı dedektörler artık YOLO ailesiyle birlikte üretimde kullanılan iki ana akım yönden biri olarak yer alıyor.
7. Semantik Bölümleme Nedir?
Semantik Bölümleme, bir görüntüdeki her piksel için hangi sınıfa ait olduğunu tahmin eder. Çıktısı bir sınırlayıcı kutu değil, her pikselin bir sınıf kimliği taşıdığı, giriş görüntüsüyle aynı çözünürlükte bir "sınıf haritası"dır.
Nesne Algılama bir nesneyi kaba bir dikdörtgenle yaklaşık olarak temsil ederken, Semantik Bölümleme nesnenin gerçek ana hatlarını piksel çözünürlüğünde temsil edebilir; bu, kaldırım gibi ince, uzun şekiller veya ağaç dalları gibi karmaşık ana hatlar için gerçek bir avantajdır. Dezavantajı: Bir karede aynı sınıfa ait birden fazla örnek görünse bile, Semantik Bölümleme bunları ayırt etmez; tüm "kişi" pikselleri aynı renge boyanır ve birey sayısı kaybolur. Bu boşluğu kapatmak, aşağıda ele alınan Örnek Bölümleme'nin tam olarak amacıdır.
8. Dönüm Noktası Bölümleme Algoritmaları
FCN (Tamamen Evrişimsel Ağ; Long, Shelhamer, Darrell, 2015), bir görüntü sınıflandırma CNN'sinden tam bağlantılı katmanları çıkararak yalnızca evrişimsel katmanları bıraktı, böylece ağ herhangi bir boyuttaki girdi için doğrudan piksel bazında tahminler üretebildi. Bu, alanın başlangıç noktasıdır; Semantik Bölümlemeyi tek, uçtan uca eğitilebilir bir ağ olarak kuran ilk tasarımdır.
U-Net (Ronneberger vd., 2015), tıbbi görüntü segmentasyonu için önerilen bir kodlayıcıyı (özellik çıkarırken örneklemeyi azaltır) bir kod çözücüye (yeniden yapılandırırken örneklemeyi artırır) karşı simetrik olarak yerleştirir ve eşleşen çözünürlükteki kodlayıcı ve kod çözücü katmanlarını "atlama bağlantıları" aracılığıyla doğrudan bağlar. Bu tasarım - ince sınır detaylarını korurken yüksek çözünürlüklü çıktı üretme - tıp alanının çok ötesine yayılan standart bir mimari haline geldi.
SegNet (Badrinarayanan vd.), kodlayıcı havuzlama sırasında hangi konumun maksimum değere sahip olduğunu ("havuzlama indeksleri") tam olarak hatırlar, ardından bu kaydı kod çözücü örneklemeyi artırırken yeniden kullanır ve sınırları bellek açısından verimli bir şekilde geri yükler. PSPNet (Zhao vd., 2017), birden fazla ölçekteki bölgeler üzerindeki özellikleri ortalamasını alan ve yalnızca dar bir alıcı alanın kaçıracağı tüm görüntü bağlamını yakalayan bir Piramit Havuzlama Modülü tanıttı.
DeepLab serisi (Chen ve diğerleri), çekirdeğini genişletilmiş (atrous) evrişim etrafında inşa etti; bu, çözünürlükten ödün vermeden alıcı alanı genişletmek için çekirdek uçları arasındaki boşlukları yaymayı içeriyordu ve v1'den v3+'a (2018) kadar evrim geçirdi. HRNet (Wang ve diğerleri, 2019) ise alışılagelmiş yaklaşımı tersine çevirdi: çözünürlüğü düşürüp sonra geri yüklemek yerine, tüm ağ boyunca paralel olarak yüksek çözünürlüklü bir özellik akışını canlı tutarak, çözünürlükler arasında sürekli bilgi alışverişi sağlıyor.
SegFormer (Xie ve diğerleri, 2021), hiyerarşik bir Transformer kodlayıcıyı hafif bir MLP-sadece kod çözücü ile eşleştirerek, çarpıcı derecede basit bir tasarımla yüksek doğruluk ve verimlilik elde etti. Mask2Former (Cheng vd., 2022), segmentasyonu "her biri bir maske ve bir sınıf tahmin eden sabit sayıda sorgu" olarak yeniden formüle etti ve her sorgunun dikkatini "maskeli dikkat" yoluyla önceki katmanda tahmin edilen maske bölgesine sınırlandırdı; bu da hem hızlı yakınsama hem de Semantik, Örnek ve Panoptik segmentasyonu aynı şekilde ele alan tek bir mimari sağladı.
9. Algılama / Semantik / Örnek / Panoptik Karşılaştırması
Şimdiye kadar tanıtılan dört görev, iki eksen boyunca düzenlendiğinde netleşir: aynı sınıfın bireysel örneklerini ayırt ediyor mu ve "arka planı" - yol, gökyüzü veya duvar gibi sayısız şeyi - ele alıyor mu?
| Görev | Çıktı birimi | Örnekleri ayırt eder | Arka planı ele alır | Önemli algoritmalar | Temel ölçüt |
|---|---|---|---|---|---|
| Nesne Algılama | Sınır kutusu | Evet (örnek başına bir kutu) | Hayır | Faster R-CNN, YOLO, DETR | mAP |
| Semantik Bölümleme | Piksel başına sınıf etiketi | Hayır (aynı sınıf tek bir renkte birleşir) | Evet | FCN, DeepLab, SegFormer | mIoU |
| Örnek Bölümleme | Piksel başına maske | Evet (örnek başına ayrı maske) | Hayır | Mask R-CNN, Mask2Former | AP (maske-IoU tabanlı) |
| Panoptik Bölümleme | Piksel başına sınıf + örnek kimliği | Evet (yalnızca ön plan) | Evet (yalnızca sınıf, örnek kimliği yok) | Panoptic FPN, Mask2Former | PQ (Panoptik Kalite) |
Tablonun da açıkça gösterdiği gibi, Panoptik Bölümleme (Kirillov vd., 2019 tarafından önerilmiştir) Örnek ve Semantik Bölümlemenin "en iyi yönlerini" bir araya getiriyor. Ön plandaki nesneler — insanlar ve arabalar gibi sayılabilir şeyler — Örnek Bölümleme'de olduğu gibi her bir örnek için ayrı ayrı ayırt edilir; arka plandaki nesneler — yol ve gökyüzü gibi sayılamaz şeyler — Semantik Bölümleme'de olduğu gibi yalnızca bir sınıf etiketi alır. Tek bir görüntüyü tam ve kapsamlı bir şekilde tanımlamaya çalışırsanız, tam olarak bu Panoptik forma ulaşırsınız — bu, dört görevin nasıl ilişkili olduğunu görmek için kullanışlı bir yoldur.
Değerlendirme metriği mIoU (Ortalama Kesişim Birleşimi), her sınıf c için, gerçek bölge G_c ile tahmin edilen bölge P_c arasındaki IoU'yu hesaplar ve ardından tüm sınıflar arasında ortalamasını alır.
Algılama'nın mAP'si kutu düzeyinde uyumu puanlarken, mIoU piksel düzeyinde uyumu puanlar — bu metrik farkı, her görevin "doğru" olarak ele aldığı şeydeki farkı tam olarak yansıtır.
10. 3B Nesne Algılama
Otonom araçlar ve robotlar, bir nesnenin 3B konumunu, boyutunu ve yönünü yalnızca 2B görüntülerden değil, doğrudan LiDAR nokta bulutlarından da algılamak zorundadır. Bir nokta bulutu, 2B bir görüntünün sahip olduğu ızgara yapısına sahip değildir, bu nedenle bir CNN onu olduğu gibi işleyemez - bu düzensiz veriyi düzenli bir şeye dönüştürmek, 3B Nesne Algılama'daki temel tasarım zorluğudur.
İKİNCİ (Yan vd., 2018), bir nokta bulutunu 3B voksel (kübik hücreler) olarak böler ve nokta içermeyen voksellerin büyük bir bölümünü atlamak için seyrek evrişim kullanır, böylece 3B CNN'lerin hesaplama maliyetini önemli ölçüde azaltır. PointPillars (Lang vd., 2019), bu durumu daha da basitleştirerek, noktaları voksel yerine dikey "sütunlar" halinde bir araya getirerek, ağın bunları 3 boyutlu yerine sıradan 2 boyutlu evrişimle işlemesini ve böylece hızı önemli ölçüde artırmasını sağladı.
PV-RCNN (Shi vd., 2020), hibrit bir Point-Voxel tasarımında, voksel tabanlı işlemenin verimliliğini, noktaları doğrudan işlemenin (PointNet tarzı) getirdiği hassas yerelleştirme ile birleştirdi. CenterPoint (Yin vd., 2021), 3 boyutlu algılamaya çapa içermeyen bir yaklaşım getirdi: bir nesneyi tek bir merkez noktası olarak algılayın, ardından buradan genişlik, yükseklik, derinlik ve yönelimi tahmin edin ve bunu yüksek doğruluk için PointPillars veya VoxelNet tarzı omurgalarla eşleştirin.
Bu yöntemlerin çoğu, ortak bir tasarım fikrini daha paylaşıyor: algılama başlığını çalıştırmadan önce nokta bulutu bilgilerini kuşbakışı görünüme (BEV) - doğrudan yukarıdan görülen 2 boyutlu özellik haritasına - yansıtmak. Yükseklik bilgilerinin sıkıştırılması, "bu nesne yol yüzeyinde nerede" - sürüş için en önemli ilişki - sorusunun cevabını sıradan bir 2 boyutlu dedektörle aynı çerçevede ele alma yeteneği karşılığında bazı ayrıntılardan ödün vermeyi sağlar.
11. 3 Boyutlu Semantik Bölümleme
3 Boyutlu Semantik Bölümleme, bir nokta bulutundaki her noktaya (veya bir LiDAR'dan gelen her lazer dönüşüne) bir sınıf etiketi atar. Yine, düzensiz nokta bulutu verilerinin nasıl ele alınacağı, ana yaklaşımları birbirinden ayıran şeydir.
PointNet++ (Qi vd., 2017), noktaları ağa olduğu gibi, vokselleştirme veya başka bir dönüştürme yapmadan besler, komşu noktaları gruplandırır ve özellikleri hiyerarşik olarak bir araya getirir - nokta tabanlı yöntemler için temel oluşturur. RandLA-Net (Hu vd., 2020), büyük ölçekli nokta bulutlarını pahalı hale getiren komşu arama darboğazını ele aldı; rastgele örneklemeyi, rastgele örneklemenin aksi takdirde kaybedeceği bilgileri telafi eden yerel bir özellik toplama modülüyle birleştirerek, şehir ölçeğindeki nokta bulutlarında bile pratik hızlara ulaştı.
RangeNet++ (Milioto vd., 2019) 3B işlemeyi tamamen atlıyor: LiDAR'ın kendi tarama sıralamasını kullanarak nokta bulutunu 2B "menzil görüntüsüne" yansıtıyor, bunun üzerinde sıradan bir 2B CNN çalıştırıyor ve sonucu tekrar 3B'ye yansıtıyor - hız için 2B CNN araçlarının olgunluğundan yararlanıyor. Cylinder3D (Zhu vd., 2021), dış mekan LiDAR nokta bulutlarının sensörden dışarı doğru yayıldığını fark etti ve menzildeki yoğunluk düşüşünü ele almak için Kartezyen koordinatlar yerine silindirik koordinatlarda vokselleştirdi. SPVNAS (Tang vd., 2020), seyrek nokta-voksel evrişimi yoluyla nokta tabanlı ve voksel tabanlı işlemeyi birleştirdi ve ardından güçlü bir doğruluk/hız dengesine sahip konfigürasyonları otomatik olarak bulmak için sinirsel mimari arama (NAS) uyguladı.
2D durumunda olduğu gibi, 3D Semantik Bölümlemenin tarihi, "noktaları nokta olarak tut" (nokta tabanlı) ve "düzenli bir ızgaraya dönüştür" (voksel veya aralık görüntüsü tabanlı) arasında gidip gelme olarak okunabilir; her biri doğruluk, hız ve bellek açısından farklı dengeler kurar.
12. Uygulamada Doğru Yaklaşımı Seçmek
Hangi tespit veya bölümleme yönteminin kullanılacağı ve hangi özel algoritmanın seçileceği, kullanım durumuna büyük ölçüde bağlıdır.
-
Robotik kollar / nesne toplama: Hedefin tam hatlarını kavramak önemlidir, bu nedenle Örnek Bölümleme (örneğin Mask2Former) en uygunudur - tek başına bir sınırlayıcı kutu, nesnenin gerçek şeklini veya iyi bir kavrama noktasını ortaya çıkarmaz.
-
Otonom sürüş: Gerçek zamanlı performans tartışılmazdır, bu nedenle 2D, Tek Aşamalı dedektörlere (YOLO ailesi) ve 3D, PointPillars veya CenterPoint gibi verimliliğe odaklı BEV tabanlı 3D dedektörlere dayanır. Sürülebilir alanı anlamak için genellikle Semantik/Panoptik Bölümleme üst üste eklenir.
-
Gözetim / güvenlik kameraları: Hedef sınıfları (insanlar, araçlar) genellikle sınırlıdır ve bir tespiti kaçırmak, ham hızdan daha önemlidir; bu da İki Aşamalı dedektörlere veya yüksek doğruluklu Transformer tabanlı dedektörlere kapı açar.
- AR/VR: Sanal bir nesneyi gerçek dünyada nereye sabitleyeceğinize karar vermek, genellikle düzlemleri ve nesne bölgelerini belirlemek için Semantik Bölümleme kullanmayı ve ardından gerçek 3B hizalama için Sensör Füzyonu (eşlik eden makaleye bakın) uygulamayı gerektirir.
Kaynak kısıtlı uç cihazlarda, hız ve kapladığı alan genellikle doğruluktan daha önemlidir — hafif YOLO varyantları veya inceltilmiş bir SegFormer. Hassas çevrimdışı analiz (tıbbi görüntüleme, uydu görüntüleri) için doğruluk önceliklidir ve İki aşamalı dedektörler veya Mask2Former sınıfı modeller tercih edilir. Pratikte, gerçek zamanlı performans ve doğruluk arasındaki bu denge, karar vermede en büyük faktördür.
En son gelişmeler için — NMS içermeyen mimariler, açık kelime dağarcığı tespiti, Segment Anything ailesindeki temel modeller — Nesne Tespitinde Teknoloji Trendleri ve Semantik Bölümlemede Teknoloji Trendleri bölümlerine bakın.
13. Özet
Nesne tespiti nesneleri dikdörtgenler olarak yakalar; Semantik Bölümleme ise piksel piksel yakalar — farklı çözünürlüklerde çalışan iki görüntü anlama görevi. Tespitin soy ağacı, İki Aşamalı (Faster R-CNN)'den Tek Aşamalı (YOLO)'ya ve çapaları ve NMS'yi tamamen ortadan kaldıran Transformer tabanlı dedektörlere (DETR/DINO) kadar uzanır; Bölümlemenin soy ağacı ise FCN'den U-Net ve DeepLab'e ve Transformer tabanlı SegFormer/Mask2Former'a kadar uzanır. Bu temelin üzerine, nesne bazında ayrım ekleyen Örnek Bölümleme, her ikisini birleştiren Panoptik Bölümleme ve bunların 3 boyutlu, nokta bulutu tabanlı karşılıkları yer almaktadır; hangisine başvurulacağı her zaman anın doğruluğa mı yoksa hıza mı ihtiyaç duyduğuna bağlıdır.
Algılama ve bölümlemeyi birbirinden ayıran çıktılar nelerdir?
Algılama genellikle kutular ve sınıflar döndürür; bölümleme piksel bölgeleri döndürür.
Konumlandırma, konturlar ve örnek kimliği ihtiyaçlarına göre seçim yapın.
Yorumlar
Lütfen önce giriş yapın.
Henüz veri yok.