Contents — find the section you need
Avant qu'un robot puisse « ramasser la tasse sur la table » ou « éviter le piéton devant lui », il doit d'abord comprendre, à partir d'une image de la caméra, ce qui se trouve là et où. Cette compréhension est le rôle de la détection d'objets et de la segmentation sémantique. Ces deux techniques sont souvent mentionnées ensemble, mais elles diffèrent fondamentalement, tant par la précision de leur résultat que par la formulation même du problème sous-jacent. Cet article les présente en détail, en s'appuyant sur leurs équivalents 3D et en proposant une comparaison directe.
 Caméra de vision embarquée
Image : Car caméra de fenêtre du système Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Une caméra d'entrée représentative, et non une affirmation concernant les dernières spécifications du produit.

0. Contenu de cet article
-
Résultats concrets de la détection d'objets et de la segmentation sémantique
-
Le pipeline de détection (extraction de caractéristiques → détection)
-
L'histoire des algorithmes de points de repère, de R-CNN à YOLO, DETR et DINO, et leurs différences de conception
-
Le compromis entre les approches à deux étapes et à une étape, et la place des détecteurs basés sur les Transformers
-
L'évolution des algorithmes de segmentation, de FCN à Mask2Former
Un tableau comparatif des segmentations de détection, sémantique, d'instance et panoptique
Les bases de la détection d'objets 3D et de la segmentation sémantique 3D sur les nuages de points
Comment choisir la technologie adaptée à la robotique, la conduite autonome, la surveillance et la réalité augmentée
1. En bref : Que sont la détection et la segmentation ?
En une phrase : La détection d'objets répond à la question « où se trouve quoi dans l'image ? » à l'aide d'un rectangle (une boîte englobante), tandis que… La segmentation sémantique répond à la question « que représente chaque pixel ? » en coloriant l'image. Ces deux techniques partagent le même objectif sous-jacent — la compréhension d'une image — mais elles y répondent à des résolutions totalement différentes.
Deux autres tâches s'appuient sur cette paire. La segmentation d'instances colore les pixels comme la segmentation sémantique, mais distingue également les objets individuels d'une même classe (par exemple, trois personnes distinctes dans une image). La segmentation panoptique unifie la segmentation d'instances avec la segmentation sémantique nécessaire pour les éléments d'arrière-plan « non dénombrables » comme la route ou le ciel, en un seul résultat aussi complet que possible. La section 9 ci-dessous présente le tableau qui détaille les relations entre ces quatre techniques.
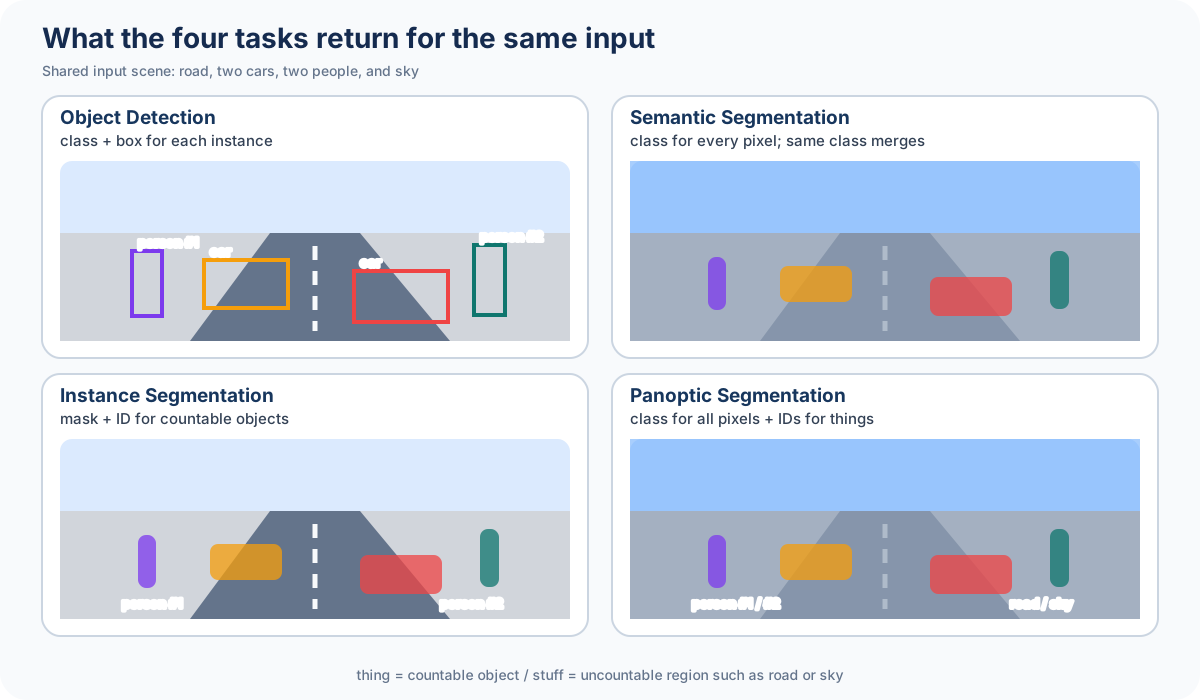
Figure : Duskcoil. Générée à partir d'une scène schématique et d'une géométrie partagée ; il ne s'agit pas d'une sortie de modèle mesurée.
2. Qu'est-ce que la détection d'objets ? (Classe / Boîte englobante / Confiance)
Pour une image donnée, la détection d'objets produit un ensemble de triplets, un par objet :
-
Classe : la nature de l'objet (une catégorie prédéfinie : « personne », « voiture », « chaise », etc.)
-
Boîte englobante : le rectangle qui entoure l'objet, généralement défini par son centre, sa largeur et sa hauteur ((x, y, w, h)), ou par ses coins supérieur gauche et inférieur droit ((x_1, y_1, x_2, y_2))
-
Confiance : un score (0 à 1) indiquant le degré de certitude du modèle quant à cette association boîte-classe.
La classification d'images fournit une réponse unique (« de quoi s'agit-il ? »), tandis que la détection d'objets doit répondre simultanément aux questions « combien d'objets, où et de quel type ? ». C'est cette incertitude quant au nombre d'objets qui rend la détection fondamentalement plus complexe que la classification. Une image donnée peut contenir zéro objet, ou une centaine ; cette variabilité du nombre de sorties constitue la contrainte de conception qui sous-tend la quasi-totalité des techniques présentées ci-dessous.
3. Comment la détection est-elle effectuée concrètement ?
Face à ce problème de nombre variable de sorties, la quasi-totalité des algorithmes de détection modernes suivent le même processus en deux étapes : extraction d’une carte de caractéristiques de l’image entière, pavage de cette carte avec un grand nombre d’emplacements candidats (boîtes d’ancrage, ou les « requêtes » du Transformer décrites plus loin), et pour chaque candidat, détermination de son appartenance à un objet ou à l’arrière-plan, et s’il s’agit d’un objet, de sa classe et de son emplacement précis.
Figure 2 — L'extracteur de caractéristiques (réseau dorsal) compresse l'image en une carte de caractéristiques, et la tête de détection effectue simultanément la classification et la régression de la boîte sur cette carte.
Au sein de la tête de détection, deux problèmes de régression/classification sont résolus simultanément : « y a-t-il un objet à cet emplacement candidat, et si oui, de quelle classe ? » et « de combien ce candidat (ancre) doit-il être décalé pour s'aligner avec l'objet réel ? ». La combinaison de ces deux problèmes en une seule perte pondérée constitue la perte multitâche largement utilisée depuis Fast R-CNN.
Ici, p représente la probabilité de classe prédite, p^{*} la classe réelle, t la correction de la boîte prédite et t^{*} la correction cible dérivée de la boîte réelle. L'indicateur \mathbb{1}[p^{*} > 0] signifie « ne calculer l'erreur de régression de localisation que pour les candidats contenant effectivement un objet, et non du fond » ; un candidat faisant partie du fond n'ayant pas de boîte réelle vers laquelle effectuer la régression, cette restriction est naturelle. \lambda ajuste le poids à accorder au terme de régression par rapport à la classification.
4. Algorithmes de détection de points de repère
L'évolution des algorithmes de détection est plus facile à suivre selon deux axes : « comment les régions candidates sont-elles restreintes ? » et « comment la boîte elle-même est-elle prédite ? »
R-CNN (Girshick et al., 2014) extrait environ 2 000 régions candidates d'une image à l'aide de l'algorithme classique de traitement d'images Selective Search, puis traite chacune d'elles individuellement par un réseau de neurones convolutif (CNN) pour la classification. Précis, mais extrêmement lent, car le CNN devait être exécuté une fois par région candidate.
Fast R-CNN (Girshick, 2015) traite l'image entière par un CNN une seule fois afin de construire une carte de caractéristiques unique, puis extrait les régions candidates de cette carte (RoI Pooling), éliminant ainsi les calculs redondants pour chaque région.
Faster R-CNN (Ren, He, Girshick, Sun, 2015) va plus loin en remplaçant la génération des régions candidates par un petit réseau de proposition de régions (RPN), intégrant la génération de propositions, la classification et la régression en un seul réseau. Ces trois générations forment ensemble la lignée de ce que l'on appelle le détecteur à deux étapes.
Les travaux SSD (Liu et al., 2016) et YOLO (Redmon et al., 2015–2016) ont été les pionniers des détecteurs à une étape, en supprimant complètement l'étape de sélection des régions candidates et en prédisant directement la classe et la boîte à partir de chaque emplacement sur la carte de caractéristiques. La vitesse a été considérablement accrue, bien que les premières versions de YOLO aient été moins performantes que les détecteurs à deux étapes en termes de précision pour les petits objets.
RetinaNet (Lin et al., 2017) s'est attaqué au problème de déséquilibre des classes qui affectait les détecteurs à une étape — les candidats d'arrière-plan étant beaucoup plus nombreux que les candidats d'objets, l'entraînement est dominé par ces derniers — grâce à une nouvelle fonction de perte, la Focal Loss, démontrant ainsi que les détecteurs à une étape pouvaient finalement égaler la précision des détecteurs à deux étapes.
FCOS (Tian et al., 2019) se passe totalement d'ancres : au lieu de prédéfinir un ensemble de boîtes d'ancrage de tailles et de rapports d'aspect variés, il calcule directement la distance entre chaque pixel de la carte de caractéristiques et la frontière de l'objet, évitant ainsi le réglage des hyperparamètres qu'exige la conception des ancres.
DETR, Deformable DETR et DINO reformulent la détection avec les Transformers comme un problème de prédiction d'ensembles — sujet de la section suivante.
5. Deux étapes vs. Une étape
Les détecteurs à deux étapes et à une étape se distinguent par une seule question : le rétrécissement des régions candidates constitue-t-il une étape indépendante ?
| Aspect | Deux étapes (ex. : Faster R-CNN) | Une étape (ex. : YOLO) |
|---|---|---|
| Flux | Génération de propositions (RPN) → classification et régression par région | Classification et régression directes à chaque emplacement de la carte de caractéristiques |
| Précision | Généralement élevée, surtout pour les objets petits et denses | Les générations récentes comblent en grande partie l'écart |
| Vitesse d'inférence | Relativement lente (traitement par candidat restant nécessaire) | Rapide, adaptée au temps réel |
| Coût de calcul | Évolutif avec le nombre de candidats | Approximativement proportionnel à la taille de l'image, prévisible |
| Complexité d'implémentation/réglage | Plus d'étapes, plus complexe | Pipeline plus simple |
| Applications | Traitement hors ligne, inspection/analyse axée sur la précision | Perception en temps réel dans les véhicules et les robots |
Ces deux familles ont longtemps utilisé la suppression des non-maximums (NMS) comme post-traitement pour éliminer les candidats redondants. Parmi les nombreuses boîtes candidates générées pour un objet, celles dont le chevauchement (IoU : Intersection sur Union) avec une autre dépasse un seuil sont éliminées, conformément à la définition suivante :
A et B représentent les régions occupées par deux boîtes ; le rapport entre leur aire de chevauchement et leur aire d'union donne un score compris entre 0 et 1. Un IoU élevé indique que les deux boîtes pointent probablement vers le même objet ; la boîte présentant la plus faible confiance est donc écartée. La méthode NMS fonctionne, mais elle peut se tromper sur des objets très denses – une faiblesse que la famille DETR, présentée ci-après, corrige entièrement.
6. Détection à l'ère des Transformers (DETR / DETR déformable / DINO)
DETR (Carion et al., 2020, Facebook AI) a fondamentalement transformé la conception de la détection. Sans ancres ni système de gestion des non-matrices (NMS), ce modèle traite les caractéristiques des images à l'aide d'un encodeur Transformer et transmet un nombre fixe de « requêtes » (vecteurs apprenables représentant les objets candidats) à un décodeur, produisant directement autant de paires boîte-classe. Lors de l'entraînement, l'ensemble prédit et l'ensemble de vérité terrain sont appariés un à un par l'algorithme hongrois, et la perte est calculée par rapport à cet appariement.
y_i représente le i-ième objet de vérité terrain, \hat{y}_{\sigma(i)} la prédiction qui lui est associée par la permutation \sigma, et \mathfrak{S}_N l'ensemble de toutes les permutations des éléments N. Cela signifie : trouver la permutation \hat{\sigma} qui associe les prédictions aux vérités de terrain de manière univoque, au coût total minimal. Ce n'est qu'une fois cette association établie que les pertes de classification et de régression habituelles peuvent être calculées. Comme aucun objet ne peut se voir attribuer plus d'une prédiction, la sélection de nombres non paramétriques (NMS) devient inutile par construction.
DETR présentait un inconvénient : l'auto-attention complète sur l'image entière est coûteuse, et le modèle nécessitait un nombre considérable d'époques d'entraînement pour converger. Deformable DETR (Zhu et al., 2020) a introduit un mécanisme d'attention déformable où chaque requête ne porte que sur un petit ensemble de points d'échantillonnage appris, plutôt que sur l'image entière, réduisant ainsi la charge de calcul tout en accélérant considérablement la convergence. DINO (Zhang et al., 2022 ; « DETR avec boîtes d'ancrage de débruitage améliorées ») a ajouté des techniques telles que des requêtes de débruitage contrastives pour la stabilité de l'entraînement et une sélection de requêtes mixtes pour initialiser les requêtes à partir de la carte de caractéristiques, atteignant ainsi la meilleure précision parmi les détecteurs de la famille DETR à l'époque. Les détecteurs basés sur les transformeurs, au même titre que la famille YOLO, constituent désormais l'une des deux principales approches utilisées en production.
7. Qu'est-ce que la segmentation sémantique ?
La segmentation sémantique prédit, pour chaque pixel d'une image, à quelle classe il appartient. Son résultat n'est pas un cadre de délimitation, mais une « carte de classes » à la même résolution que l'image d'entrée, où chaque pixel possède un identifiant de classe.
Alors que la détection d'objets approxime un objet par un rectangle grossier, la segmentation sémantique peut représenter le contour réel de l'objet à la résolution du pixel ; un atout majeur pour les formes fines et allongées comme un trottoir, ou les contours complexes comme les branches d'un arbre. Le revers de la médaille : même lorsque plusieurs instances de la même classe apparaissent dans une image, la segmentation sémantique ne les distingue pas ; tous les pixels représentant des « personnes » sont colorés de la même couleur, et le nombre d'individus est perdu. Combler cette lacune, c'est précisément le rôle de la segmentation d'instances, présentée ci-dessous.
8. Algorithmes de segmentation de points de repère
FCN (Fully Convolutional Network ; Long, Shelhamer, Darrell, 2015) supprime les couches entièrement connectées d'un CNN de classification d'images, ne conservant que les couches convolutionnelles. Le réseau peut ainsi produire des prédictions pixel par pixel pour des entrées de toute taille. Il s'agit du point de départ du domaine : la première conception à établir la segmentation sémantique comme un réseau unique, entièrement entraînable.
U-Net (Ronneberger et al., 2015), proposé pour la segmentation d'images médicales, dispose un encodeur (sous-échantillonnage lors de l'extraction de caractéristiques) symétriquement à un décodeur (sur-échantillonnage lors de la reconstruction), et connecte directement les couches d'encodeur et de décodeur de résolution identique via des « connexions de saut ». Cette conception, qui préserve les détails fins des contours tout en produisant une sortie haute résolution, est devenue une architecture standard largement répandue au-delà du domaine médical.
SegNet (Badrinarayanan et al.) mémorise, lors du regroupement des données de l'encodeur, la position exacte contenant la valeur maximale (« indices de regroupement »), puis réutilise cet enregistrement lors du suréchantillonnage du décodeur, restaurant ainsi les contours de manière économe en mémoire. PSPNet (Zhao et al., 2017) a introduit un module de regroupement pyramidal qui moyenne les caractéristiques sur des régions à différentes échelles, capturant ainsi le contexte global de l'image qu'un champ réceptif étroit ne permettrait pas de saisir.
La série DeepLab (Chen et al.) s'appuie sur la convolution dilatée (à trous) — qui consiste à espacer les points de connexion du noyau pour élargir le champ réceptif sans sacrifier la résolution — et a évolué de la version 1 à la version 3+ (2018). HRNet (Wang et al., 2019) inverse l'approche habituelle : au lieu de sous-échantillonner puis de restaurer la résolution, elle maintient un flux de caractéristiques haute résolution actif en parallèle dans tout le réseau, échangeant continuellement des informations entre les différentes résolutions.
SegFormer (Xie et al., 2021) associe un encodeur Transformer hiérarchique à un décodeur léger basé uniquement sur un MLP, obtenant ainsi une précision et une efficacité élevées grâce à une conception remarquablement simple. Mask2Former (Cheng et al., 2022) reformule la segmentation comme « un nombre fixe de requêtes, chacune prédisant un masque et une classe », en limitant l'attention de chaque requête à la région du masque prédite par la couche précédente grâce à l'« attention masquée ». Cette approche offre une convergence rapide et une architecture unique qui gère aussi bien la segmentation sémantique que la segmentation d'instances et la segmentation panoptique.
9. Comparaison Détection / Sémantique / Instance / Panoptique
Les quatre tâches présentées jusqu'à présent deviennent plus claires lorsqu'on les organise selon deux axes : la capacité à distinguer les instances individuelles d'une même classe et la gestion de l'« arrière-plan » (éléments non dénombrables comme la route, le ciel ou un mur).
| Tâche | Unité de sortie | Distingue les instances | Gère l'arrière-plan | Algorithmes de points de repère | Métrique clé |
|---|---|---|---|---|---|
| Détection d'objets | Boîte englobante | Oui (une boîte par instance) | Non | Faster R-CNN, YOLO, DETR | mAP |
| Segmentation sémantique | Étiquette de classe par pixel | Non (les pixels de même classe sont regroupés en une seule couleur) | Oui | FCN, DeepLab, SegFormer | mIoU |
| Segmentation d'instances | Masque par pixel | Oui (masque distinct par instance) | Non | Mask R-CNN, Mask2Former | AP (basé sur le masque et l'IoU) |
| Segmentation panoptique | Classe par pixel + ID d'instance | Oui (premier plan uniquement) | Oui (classe uniquement, sans ID d'instance) | Panoptic FPN, Mask2Former | PQ (Qualité panoptique) |
Comme le montre le tableau, la segmentation panoptique (proposée par Kirillov et al., 2019) combine les avantages de la segmentation par instance et de la segmentation sémantique. Les objets au premier plan — des éléments dénombrables comme les personnes et les voitures — sont distingués instance par instance, comme dans la segmentation par instance ; l’arrière-plan — des éléments non dénombrables comme la route et le ciel — reçoit uniquement une étiquette de classe, comme dans la segmentation sémantique. Si l’on cherche à décrire une image de manière complète et exhaustive, on aboutit précisément à cette forme panoptique — un moyen utile de comprendre les liens entre ces quatre tâches.
La métrique d’évaluation mIoU (Intersection moyenne sur Union) calcule, pour chaque classe c, l’IoU entre la région de référence G_c et la région prédite P_c, puis effectue une moyenne sur toutes les classes.
Alors que le mAP de la détection évalue la concordance au niveau des boîtes, le mIoU évalue la concordance au niveau des pixels ; cette différence de métrique reflète exactement la différence dans ce que chaque tâche considère comme « correct ».
10. Détection d'objets 3D
Les véhicules autonomes et les robots doivent souvent détecter la position, la taille et l'orientation 3D d'un objet directement à partir de nuages de points LiDAR, et non seulement à partir d'images 2D. Un nuage de points ne possède pas la structure de grille d'une image 2D ; un CNN ne peut donc pas l'exploiter tel quel. Transformer ces données irrégulières en données régulières constitue le principal défi de conception en détection d'objets 3D.
La méthode SECOND (Yan et al., 2018) divise un nuage de points en voxels 3D (cellules cubiques) et utilise la convolution parcimonieuse pour ignorer la grande proportion de voxels ne contenant aucun point, réduisant ainsi considérablement le coût de calcul des CNN 3D. PointPillars (Lang et al., 2019) a simplifié davantage ce processus en regroupant les points en « piliers » verticaux plutôt qu'en voxels. Le réseau peut ainsi les traiter par convolution 2D classique plutôt qu'en 3D, ce qui améliore considérablement la vitesse de calcul.
PV-RCNN (Shi et al., 2020) a combiné l'efficacité du traitement voxel-based avec la localisation précise issue du traitement direct des points (à la manière de PointNet), dans une conception hybride Point-Voxel. CenterPoint (Yin et al., 2021) a introduit une approche sans ancrage pour la détection 3D : un objet est détecté comme un point central unique, puis sa largeur, sa hauteur, sa profondeur et son orientation sont calculées par régression à partir de ce point. Ce résultat est associé à des architectures de type PointPillars ou VoxelNet pour une précision optimale.
Bon nombre de ces méthodes partagent une autre idée de conception : projeter les informations du nuage de points en une vue aérienne (BEV) – une carte de caractéristiques 2D vue directement du dessus – avant d’exécuter la détection. La compression des informations de hauteur sacrifie certains détails au profit de la capacité à déterminer la position de l’objet sur la chaussée – la relation la plus importante pour la conduite – dans le même cadre qu’un détecteur 2D classique.
11. Segmentation sémantique 3D
La segmentation sémantique 3D attribue une étiquette de classe à chaque point d’un nuage de points (ou à chaque écho laser d’un LiDAR). Une fois encore, la gestion des données irrégulières des nuages de points est ce qui distingue les principales approches.
PointNet++ (Qi et al., 2017) alimente le réseau avec les points tels quels, sans voxelisation ni autre conversion, en regroupant les points voisins et en agrégeant les caractéristiques de manière hiérarchique – établissant ainsi les bases des méthodes basées sur les points. RandLA-Net (Hu et al., 2020) a résolu le problème de la recherche de voisins, qui rendait les nuages de points à grande échelle coûteux. Ce réseau combine un échantillonnage aléatoire avec un module d'agrégation de caractéristiques locales qui compense les pertes d'information dues à un échantillonnage aléatoire classique, atteignant ainsi des vitesses acceptables même pour des nuages de points à l'échelle d'une ville.
RangeNet++ (Milioto et al., 2019) s'affranchit du traitement 3D : il projette le nuage de points, en utilisant l'ordre de balayage propre au LiDAR, en une « image de profondeur » 2D, applique un réseau de neurones convolutif 2D classique sur cette image, puis reprojette le résultat en 3D, tirant parti de la maturité des outils de développement des réseaux de neurones convolutifs 2D pour gagner en rapidité. Cylinder3D (Zhu et al., 2021) a constaté que les nuages de points LiDAR extérieurs rayonnent à partir du capteur et a donc opté pour une voxelisation en coordonnées cylindriques plutôt que cartésiennes afin de gérer la diminution de densité qui en résulte avec la distance. SPVNAS (Tang et al., 2020) fusionne les traitements ponctuels et voxélisés via une convolution Sparse Point-Voxel, puis applique une recherche d'architecture neuronale (NAS) pour trouver automatiquement des configurations offrant un compromis optimal entre précision et vitesse.
Comme pour la segmentation 2D, l'historique de la segmentation sémantique 3D peut être interprété comme une alternance entre « conserver les points tels quels » (approche ponctuelle) et « convertir en une grille régulière » (approche voxélisée ou basée sur une image de profondeur), chaque option présentant un compromis différent entre précision, vitesse et mémoire.
12. Choisir la bonne approche en pratique
Le choix entre détection et segmentation, et l'algorithme spécifique à utiliser, dépendent fortement du cas d'utilisation.
-
Bras robotisés / préhension : la connaissance précise du contour de la cible à saisir est essentielle. La segmentation d'instance (par exemple, Mask2Former) est donc la solution idéale ; un simple cadre de délimitation ne révèle ni la forme réelle de l'objet ni un point de préhension optimal.
-
Conduite autonome : la performance en temps réel est impérative. Les solutions 2D s'appuient sur des détecteurs à une étape (famille YOLO), tandis que les solutions 3D privilégient des détecteurs 3D optimisés pour les véhicules électriques, tels que PointPillars ou CenterPoint. Une segmentation sémantique/panoptique est souvent ajoutée pour définir la zone praticable.
-
Caméras de surveillance / de sécurité : le nombre de cibles (personnes, véhicules) étant généralement limité, la moindre erreur de détection est plus problématique que la vitesse pure. Ceci justifie l'utilisation de détecteurs à deux étapes ou de détecteurs de haute précision basés sur la technologie Transformer. Réalité augmentée/Réalité virtuelle : déterminer l’emplacement d’ancrage d’un objet virtuel dans le monde réel implique généralement l’utilisation de la segmentation sémantique pour identifier les plans et les régions de l’objet, puis l’application de la fusion de capteurs (voir l’article associé) pour un alignement 3D précis.
Sur les appareils périphériques aux ressources limitées, la vitesse et l’encombrement priment généralement sur la précision : on privilégie les variantes YOLO légères ou une version allégée de SegFormer. Pour une analyse hors ligne précise (imagerie médicale, imagerie satellite), la précision est primordiale, ce qui favorise les détecteurs à deux étapes ou les modèles de type Mask2Former. En pratique, ce compromis entre performances en temps réel et précision est le facteur de décision le plus important.
Pour les dernières évolutions — architectures sans NMS, détection à vocabulaire ouvert, modèles de base de la famille Segment Anything — consultez Tendances technologiques en détection d’objets et Tendances technologiques en segmentation sémantique.
13. Résumé
La détection d'objets les capture sous forme de rectangles ; la segmentation sémantique les capture pixel par pixel : deux tâches de compréhension d'images opérant à des résolutions différentes. L'histoire de la détection s'étend des méthodes à deux étapes (Faster R-CNN) aux méthodes à une étape (YOLO), jusqu'aux détecteurs basés sur les Transformers qui abandonnent les ancres et la sélection non paramétrique (DETR/DINO). Quant à la segmentation, elle va des FCN à U-Net et DeepLab, jusqu'aux méthodes basées sur les Transformers SegFormer/Mask2Former. Sur cette base se trouvent la segmentation d'instances, qui ajoute une distinction par objet, la segmentation panoptique, qui unifie les deux, et leurs équivalents 3D basés sur les nuages de points. Le choix de la méthode dépend toujours de la priorité accordée à la précision ou à la rapidité.
Quelles sont les différences entre la détection et la segmentation ?
La détection renvoie généralement des boîtes englobantes et des classes ; la segmentation renvoie des régions de pixels. Choisissez en fonction de vos besoins en matière de localisation, de contours et d'identification des instances.
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.