Contents — find the section you need
Antes que um robô possa "pegar a xícara na mesa" ou "desviar do pedestre à frente", ele precisa primeiro entender, a partir de uma imagem da câmera, o que está ali e onde. Essa compreensão é a função da Detecção de Objetos e da Segmentação Semântica. As duas são frequentemente mencionadas juntas, mas diferem fundamentalmente — tanto na granularidade da informação que produzem quanto na própria forma como o problema subjacente é formulado. Este artigo aborda ambas desde o princípio, passando por suas contrapartes em 3D e uma comparação direta e clara.
Antes que um robô possa "pegar a xícara na mesa" ou "desviar do pedestre à frente", ele precisa primeiro entender, a partir de uma imagem da câmera, o que está ali e onde está. Essa compreensão é a função da Detecção de Objetos e da Segmentação Semântica. As duas são frequentemente mencionadas juntas, mas diferem fundamentalmente — tanto na granularidade da informação que produzem quanto na forma como o problema subjacente é abordado. Este artigo desenvolve ambas a partir do básico, por meio de suas contrapartes em 3D e uma comparação direta e clara.
 Câmera de percepção do veículo
Imagem: Car câmera de janela do sistema Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Uma câmera de entrada representativa, não uma afirmação sobre as especificações mais recentes do produto.

0. O que este artigo aborda
- O que a Detecção de Objetos e a Segmentação Semântica realmente produzem
- O pipeline de Detecção (extração de características → cabeça de detecção)
- A linhagem de algoritmos marcantes, do R-CNN ao YOLO, DETR e DINO, e como suas filosofias de design diferem
- A compensação entre duas etapas e uma etapa, e onde os detectores baseados em Transformers se encaixam
- Como os algoritmos de Segmentação evoluíram do FCN para o Mask2Former
- Uma tabela que torna as diferenças entre Detecção, Segmentação Semântica, Segmentação de Instância e Segmentação Panóptica mais claras
- Os fundamentos da Detecção de Objetos 3D e da Segmentação Semântica 3D em nuvens de pontos
- Como escolher a tecnologia certa para robótica, direção autônoma, vigilância e RA
1. Resposta curta: O que são Detecção e Segmentação
Em uma frase: **A Detecção de Objetos responde à pergunta "onde na imagem está o quê" com um A Segmentação de Instâncias (ou Segmentação Semântica) define o que é cada pixel colorindo a imagem. Ambas compartilham o mesmo objetivo fundamental — compreender uma imagem — mas respondem em resoluções completamente diferentes.
Duas outras tarefas se baseiam nesse par. A Segmentação de Instâncias colore os pixels como a Segmentação Semântica, mas também distingue objetos individuais da mesma classe (por exemplo, três pessoas diferentes em um quadro). A Segmentação Panóptica unifica a Segmentação de Instâncias com a Segmentação Semântica necessária para elementos de fundo "incontáveis", como estradas ou céu, em uma única saída o mais completa possível. A Seção 9 abaixo apresenta a relação entre essas quatro tarefas em uma tabela.
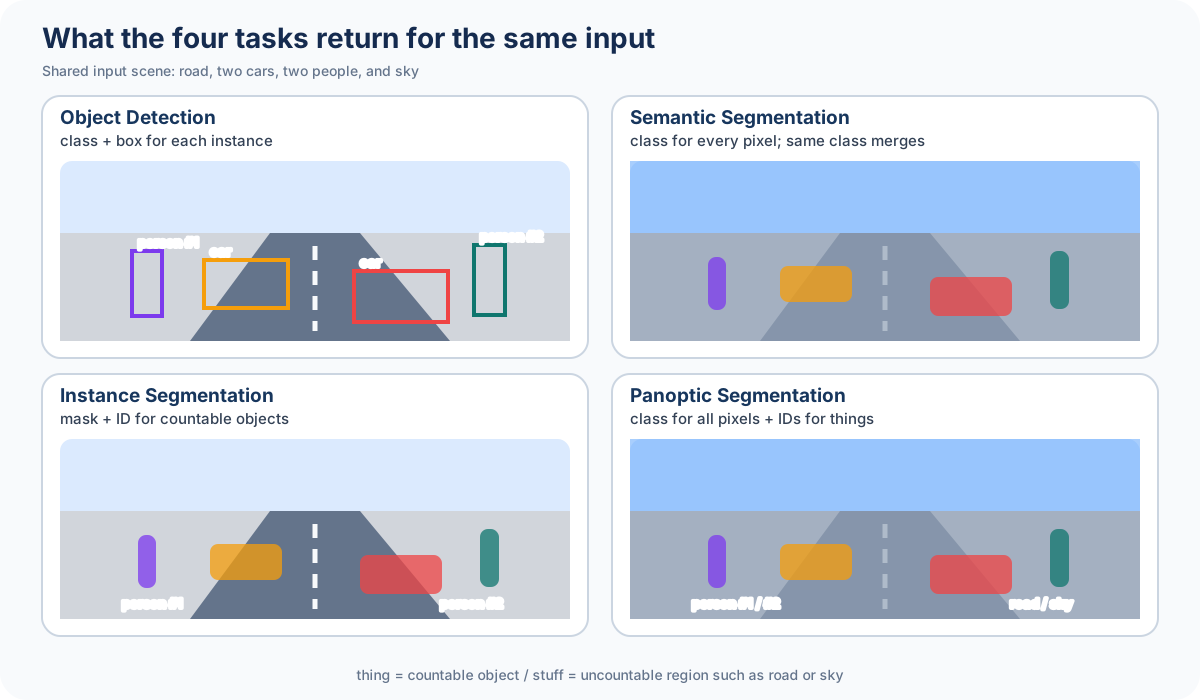
Figura: Duskcoil. Gerada a partir de uma cena esquemática e geometria compartilhada; não é a saída do modelo medido.
2. O que é Detecção de Objetos? (Classe / Caixa Delimitadora / Confiança)
Para uma única imagem, a Detecção de Objetos gera um conjunto de triplas, uma para cada objeto:
- Classe: o que o objeto representa (uma das categorias predefinidas — "pessoa", "carro", "cadeira", etc.)
- Caixa Delimitadora: o retângulo que envolve o objeto, geralmente definido como o ponto central mais a largura e a altura (x, y, w, h), ou como os cantos superior esquerdo/inferior direito (x_1, y_1, x_2, y_2)
- Confiança: uma pontuação (0-1) que indica o grau de certeza do modelo sobre a associação entre a caixa delimitadora e a classe.
A Classificação de Imagens retorna uma única resposta — "o que é esta imagem" —, mas a Detecção de Objetos precisa responder "quantos objetos, onde e de que tipo" simultaneamente. Essa propriedade de "a contagem em si ser desconhecida" é o que torna a Detecção fundamentalmente mais difícil do que a Classificação. Uma determinada imagem pode conter zero objetos ou cem — o próprio fato de o número de saídas ser variável é a restrição de projeto que impulsiona essencialmente todos os truques discutidos abaixo.
3. Como a Detecção é Feita na Prática?
Diante desse problema de contagem variável de saídas, essencialmente todos os algoritmos de Detecção modernos seguem o mesmo fluxo de trabalho de duas etapas: extrair um mapa de características da imagem inteira, dividir esse mapa de características em blocos com um grande número de localizações candidatas (caixas de ancoragem ou as "consultas" do Transformer discutidas posteriormente) e, para cada candidata, decidir "objeto ou fundo" e, se for objeto, "qual classe e qual a localização precisa".
Figura 2 — O extrator de características (backbone) comprime a imagem em um mapa de características, e o cabeçalho de detecção realiza a classificação e a regressão de caixa simultaneamente.
Dentro do cabeçalho de detecção, dois problemas de regressão/classificação são resolvidos efetivamente de uma só vez: "existe um objeto nesta localização candidata e, em caso afirmativo, a qual classe?" e "quanto este candidato (âncora) deve ser deslocado para se alinhar com o objeto real". A combinação desses dois em uma perda de soma ponderada é a perda multitarefa amplamente utilizada desde o Fast R-CNN.
Aqui, p representa a probabilidade da classe prevista, p^{*} a classe real, t a correção da caixa delimitadora prevista e t^{*} a correção do alvo derivada da caixa delimitadora real. O indicador \mathbb{1}[p^{*} > 0] significa "calcular o erro de regressão de localização apenas para candidatos que realmente contenham um objeto, não o fundo" — um candidato de fundo não possui uma caixa delimitadora real para regredir, portanto, essa restrição é natural. \lambda ajusta o peso a ser atribuído ao termo de regressão em relação à classificação.
4. Algoritmos de Detecção de Pontos de Referência
A linhagem dos algoritmos de detecção é mais fácil de acompanhar ao longo de dois eixos: "como as regiões candidatas são restringidas" e "como a própria caixa delimitadora é prevista".
R-CNN (Girshick et al., 2014) recortava cerca de 2.000 regiões candidatas de uma imagem usando o algoritmo clássico de processamento de imagens Busca Seletiva, e então executava cada uma delas individualmente em uma CNN para classificação. Preciso, porém extremamente lento, já que a CNN precisava ser executada uma vez para cada região candidata.
Fast R-CNN (Girshick, 2015) executava a imagem inteira em uma CNN apenas uma vez para construir um único mapa de características, e então recortava as regiões candidatas desse mapa de características (RoI Pooling) — eliminando o cálculo redundante por região.
Faster R-CNN (Ren, He, Girshick, Sun, 2015) foi um passo além e substituiu a própria geração de regiões candidatas por uma pequena Rede de Propostas de Regiões (RPN), integrando a geração de propostas, a classificação e a regressão em uma única rede. Essas três gerações juntas formam a linhagem do que é chamado de detector de dois estágios.
SSD (Liu et al., 2016) e YOLO (Redmon et al., 2015–2016) foram pioneiros em detectores de estágio único, eliminando completamente o estágio de região candidata e prevendo a classe e a caixa delimitadora diretamente de cada localização no mapa de características. A velocidade aumentou drasticamente, embora o YOLO inicial tenha ficado atrás dos detectores de dois estágios em termos de precisão para objetos pequenos.
RetinaNet (Lin et al., 2017) abordou o problema do desequilíbrio de classes que afetava os detectores de estágio único — os candidatos de fundo superavam em muito os candidatos de objeto, e o treinamento era dominado por eles — com uma nova função de perda, a Focal Loss, mostrando que os detectores de estágio único podiam, afinal, igualar a precisão dos detectores de dois estágios.
** FCOS (Tian et al., 2019) foi totalmente livre de âncoras: em vez de pré-definir um conjunto de caixas de ancoragem com vários tamanhos e proporções, ele regride a distância de cada pixel do mapa de características diretamente para o limite do objeto, evitando o ajuste de hiperparâmetros exigido pelo design de âncoras.
DETR, Deformable DETR e DINO reformulam a detecção com Transformers como um problema de predição de conjuntos — o assunto da próxima seção.
5. Dois estágios vs. Um estágio
Os detectores de dois estágios e de um estágio divergem exatamente em uma questão: o estreitamento da região candidata existe como um estágio independente?
| Aspecto | Dois estágios (ex.: Faster R-CNN) | Um estágio (ex.: YOLO) |
|---|---|---|
| Fluxo | Geração de propostas (RPN) → classificação e regressão por região | Classificar e regredir diretamente em cada localização no mapa de características |
| Precisão | Geralmente alta, especialmente em objetos pequenos/densos | Gerações recentes reduziram a maior parte da diferença |
| Velocidade de inferência | Relativamente lenta (ainda há trabalho por candidato) | Rápida, adequada para tempo real |
| Custo computacional | Escala com o número de candidatos | Aproximadamente proporcional ao tamanho da imagem, previsível |
| Dificuldade de implementação/ajuste | Mais etapas, mais complexo | Pipeline mais simples |
| Aplicações | Processamento offline, inspeção/análise com foco na precisão | Percepção em tempo real em veículos e robôs |
Ambas as famílias de algoritmos dependiam há muito tempo da Supressão Não Máxima (NMS) como pós-processamento para reduzir a quantidade de candidatos sobrepostos. Dentre as várias caixas candidatas geradas para um objeto, qualquer uma cuja sobreposição (IoU: Interseção sobre União) com outra exceda um limite é descartada, conforme esta definição:
A e B são as regiões ocupadas por duas caixas; dividir a área de sobreposição pela área de união resulta em uma pontuação entre 0 e 1. Um IoU alto indica que as duas caixas provavelmente apontam para o mesmo objeto, portanto, a caixa com menor confiança é descartada. O NMS funciona, mas pode falhar em objetos densamente agrupados — uma fraqueza que a família DETR, discutida a seguir, elimina completamente.
6. Detecção na Era Transformer (DETR / DETR Deformável / DINO)
DETR (Carion et al., 2020, Facebook AI) mudou a essência da formulação da detecção. Sem âncoras e sem NMS, o algoritmo processa as características da imagem por meio de um codificador Transformer e passa um número fixo de "consultas" (vetores treináveis que representam objetos candidatos) por um decodificador, gerando diretamente exatamente esse número de pares caixa-classe. Durante o treinamento, o conjunto previsto e o conjunto de verdade fundamental são comparados um a um por meio do algoritmo húngaro, e a perda é calculada com base nessa comparação.
y_i é o i-ésimo objeto de verdade fundamental, \hat{y}_{\sigma(i)} é a previsão atribuída a ele sob a permutação \sigma, e \mathfrak{S}_N é o conjunto de todas as permutações dos elementos N. Isso significa: encontre a permutação \hat{\sigma} que atribua previsões às verdades fundamentais de forma um-para-um com o menor custo total possível — somente após essa atribuição ser definida é que as perdas usuais de classificação e regressão podem ser calculadas. Como nenhum objeto pode ter mais de uma previsão atribuída, o NMS torna-se desnecessário por construção.
O DETR tinha uma desvantagem: a autoatenção completa sobre toda a imagem é custosa, e o modelo precisava de um número enorme de épocas de treinamento para convergir. O DETR Deformável (Zhu et al., 2020) introduziu um mecanismo de atenção deformável, no qual cada consulta se concentra apenas em um pequeno conjunto aprendido de pontos de amostragem, em vez da imagem inteira, reduzindo o custo computacional e acelerando drasticamente a convergência. O DINO (Zhang et al., 2022; "DETR com Caixas de Âncora de Remoção de Ruído Aprimoradas") adicionou técnicas como consultas de remoção de ruído contrastivas para estabilidade do treinamento e seleção mista de consultas para inicializar as consultas a partir do mapa de características, alcançando a melhor precisão entre os detectores da família DETR na época. Detectores baseados em Transformers agora figuram ao lado da família YOLO como uma das duas principais abordagens em uso na produção.
7. O que é Segmentação Semântica?
A Segmentação Semântica prevê, para cada pixel em uma imagem, a qual classe ele pertence. Sua saída não é uma caixa delimitadora — é um "mapa de classes" na mesma resolução da imagem de entrada, onde cada pixel carrega um ID de classe.
Enquanto a Detecção de Objetos aproxima um objeto com um retângulo grosseiro, a Segmentação Semântica pode representar o contorno real do objeto na resolução de pixel — uma grande vantagem para formas finas e alongadas, como um meio-fio, ou contornos complexos, como galhos de árvores. A desvantagem: mesmo quando várias instâncias da mesma classe aparecem em um quadro, a Segmentação Semântica não as distingue — todos os pixels de "pessoas" são pintados com a mesma cor e a contagem de indivíduos é perdida. Preencher essa lacuna é exatamente o objetivo da Segmentação de Instâncias, abordada a seguir.
8. Algoritmos de Segmentação de Pontos de Referência
FCN (Rede Totalmente Convolucional; Long, Shelhamer, Darrell, 2015) removeu as camadas totalmente conectadas de uma CNN de classificação de imagens, deixando apenas as camadas convolucionais. Dessa forma, a rede podia produzir previsões pixel a pixel diretamente para entradas de qualquer tamanho. É o ponto de partida da área — o primeiro projeto a estabelecer a Segmentação Semântica como uma única rede treinável de ponta a ponta.
U-Net (Ronneberger et al., 2015), proposta para segmentação de imagens médicas, organiza um codificador (reduzindo a resolução enquanto extrai características) simetricamente em relação a um decodificador (aumentando a resolução enquanto reconstrói) e conecta camadas de codificador e decodificador com resolução correspondente diretamente por meio de "conexões de salto". Esse projeto — que preserva detalhes finos de contorno enquanto ainda produz saída de alta resolução — tornou-se uma arquitetura padrão que se espalhou muito além da medicina.
** A SegNet (Badrinarayanan et al.) memoriza, durante o agrupamento do codificador, exatamente qual posição continha o valor máximo ("índices de agrupamento") e, em seguida, reutiliza esse registro durante o aumento da resolução do decodificador, restaurando os limites de forma eficiente em termos de memória. A PSPNet (Zhao et al., 2017) introduziu um Módulo de Agrupamento Piramidal que calcula a média de características em regiões em múltiplas escalas, capturando o contexto da imagem inteira que um campo receptivo estreito sozinho não conseguiria.
A série DeepLab (Chen et al.) construiu seu núcleo em torno da convolução dilatada (atrous) — espalhando os espaços entre os taps do kernel para ampliar o campo receptivo sem sacrificar a resolução — evoluindo da v1 para a v3+ (2018). A HRNet (Wang et al., 2019) inverteu a abordagem usual: em vez de reduzir a resolução e depois restaurá-la, ela mantém um fluxo de características de alta resolução ativo em paralelo por toda a rede, trocando continuamente informações entre as resoluções. SegFormer (Xie et al., 2021) combinou um codificador Transformer hierárquico com um decodificador leve baseado apenas em MLP, alcançando alta precisão e eficiência com um design surpreendentemente simples. Mask2Former (Cheng et al., 2022) reformulou a segmentação como "um número fixo de consultas, cada uma prevendo uma máscara e uma classe", restringindo a atenção de cada consulta à região da máscara prevista na camada anterior por meio de "atenção mascarada" — proporcionando convergência rápida e uma arquitetura única que lida com segmentação semântica, de instância e panóptica.
9. Comparando Detecção / Semântica / Instância / Panóptica
As quatro tarefas apresentadas até agora ficam claras quando organizadas em dois eixos: a tarefa distingue instâncias individuais da mesma classe e ela lida com o "fundo" — elementos incontáveis como estrada, céu ou parede.
| Tarefa | Unidade de saída | Distingue instâncias | Manipulação de fundo | Algoritmos de referência | Métrica principal |
|---|---|---|---|---|---|
| Detecção de objetos | Caixa delimitadora | Sim (uma caixa por instância) | Não | Faster R-CNN, YOLO, DETR | mAP |
| Segmentação semântica | Rótulo de classe por pixel | Não (mesma classe mesclada em uma única cor) | Sim | FCN, DeepLab, SegFormer | mIoU |
| Segmentação de instâncias | Máscara por pixel | Sim (máscara separada por instância) | Não | Mask R-CNN, Mask2Former | AP (baseado em IoU de máscara) |
| Segmentação panóptica | Classe por pixel + ID da instância | Sim (somente primeiro plano) | Sim (somente classe, sem ID da instância) | Panoptic FPN, Mask2Former | PQ (Qualidade Panóptica) |
Como a tabela deixa claro, a Segmentação Panóptica (proposta por Kirillov et al., 2019) é o "melhor dos dois mundos" da Segmentação de Instâncias e da Segmentação Semântica. Objetos em primeiro plano — elementos contáveis como pessoas e carros — são distinguidos por instância, como na Segmentação de Instâncias; o plano de fundo — elementos incontáveis como estrada e céu — recebe apenas um rótulo de classe, como na Segmentação Semântica. Se você se esforçar para descrever completa e exaustivamente uma única imagem, chegará exatamente a essa forma Panóptica — uma maneira útil de ver como todas as quatro tarefas se relacionam.
A métrica de avaliação mIoU (Interseção Média sobre União) calcula, para cada classe c, a IoU entre a região de verdade fundamental G_c e a região prevista P_c, e então calcula a média entre todas as classes.
Enquanto o mAP da Detecção avalia a concordância no nível das caixas delimitadoras, o mIoU avalia a concordância no nível dos pixels — essa diferença na métrica reflete exatamente a diferença no que cada tarefa considera "correto".
10. Detecção de Objetos 3D
Veículos autônomos e robôs frequentemente precisam detectar a posição, o tamanho e a orientação 3D de um objeto diretamente a partir de nuvens de pontos LiDAR, e não apenas de imagens 2D. Uma nuvem de pontos não possui a estrutura de grade de uma imagem 2D, portanto, uma CNN não pode processá-la diretamente — como transformar esses dados irregulares em algo regular é o principal desafio de projeto na Detecção de Objetos 3D.
SECOND (Yan et al., 2018) divide uma nuvem de pontos em voxels 3D (células cúbicas) e usa convolução esparsa para ignorar a grande fração de voxels que não contêm pontos, reduzindo drasticamente o custo computacional das CNNs 3D. PointPillars (Lang et al., 2019) simplificou ainda mais esse processo, agregando pontos em "pilares" verticais em vez de voxels, permitindo que a rede os processe com convolução 2D comum em vez de 3D, aumentando significativamente a velocidade.
PV-RCNN (Shi et al., 2020) combinou a eficiência do processamento baseado em voxels com a localização precisa obtida pelo processamento direto de pontos (estilo PointNet), em um design híbrido Ponto-Voxel. CenterPoint (Yin et al., 2021) trouxe uma abordagem sem âncoras para a detecção 3D: detectar um objeto como um único ponto central e, a partir daí, regredir a largura, altura, profundidade e orientação, combinando-o com arquiteturas de backbone no estilo PointPillars ou VoxelNet para obter alta precisão.
Muitos desses métodos compartilham uma ideia de design adicional: projetar informações da nuvem de pontos em uma Visão Aérea (BEV, na sigla em inglês) — um mapa de características 2D visto diretamente de cima — antes de executar a cabeça de detecção. A compressão das informações de altura sacrifica alguns detalhes em troca da capacidade de lidar com a localização de um objeto na superfície da estrada — a relação mais importante para a direção — dentro da mesma estrutura de um detector 2D comum.
11. Segmentação Semântica 3D
A Segmentação Semântica 3D atribui um rótulo de classe a cada ponto em uma nuvem de pontos (ou a cada retorno de laser de um LiDAR). Mais uma vez, a forma como os dados irregulares da nuvem de pontos são tratados é o que diferencia as principais abordagens.
O PointNet++ (Qi et al., 2017) alimenta a rede com pontos em sua forma original, sem voxelização ou outra conversão, agrupando pontos vizinhos e agregando características hierarquicamente — estabelecendo a base para métodos baseados em pontos. RandLA-Net (Hu et al., 2020) resolveu o gargalo da busca por vizinhos que encarecia o processamento de nuvens de pontos em larga escala, combinando amostragem aleatória com um módulo de agregação de características locais que compensa a perda de informação que a amostragem aleatória normalmente teria, atingindo velocidades práticas mesmo em nuvens de pontos em escala urbana.
RangeNet++ (Milioto et al., 2019) dispensa o processamento 3D: projeta a nuvem de pontos, usando a própria ordem de varredura do LiDAR, em uma "imagem de alcance" 2D, executa uma CNN 2D comum sobre essa imagem e projeta o resultado de volta em 3D — aproveitando a maturidade das ferramentas de CNN 2D para obter velocidade. Cylinder3D (Zhu et al., 2021) observou que as nuvens de pontos LiDAR externas irradiam para fora do sensor e as voxelizou em coordenadas cilíndricas em vez de cartesianas para lidar com a consequente queda de densidade em longas distâncias. SPVNAS (Tang et al., 2020) fundiu o processamento baseado em pontos e em voxels por meio da convolução esparsa ponto-voxel, aplicando em seguida a busca de arquitetura neural (NAS) para encontrar automaticamente configurações com uma forte relação entre precisão e velocidade.
Assim como no caso 2D, a história da segmentação semântica 3D pode ser vista como um vai e vem entre "manter os pontos como pontos" (baseado em pontos) e "converter para uma grade regular" (baseado em voxels ou imagens de alcance), cada uma com suas próprias compensações em relação à precisão, velocidade e memória.
12. Escolhendo a Abordagem Correta na Prática
A escolha entre detecção ou segmentação, e o algoritmo específico, depende muito do caso de uso.
- Braços robóticos / coleta: conhecer o contorno exato do alvo a ser agarrado é fundamental, portanto, a Segmentação de Instâncias (por exemplo, Mask2Former) é a mais adequada — uma caixa delimitadora sozinha não revela a forma real do objeto nem um bom ponto de preensão.
-
Condução autônoma: o desempenho em tempo real é imprescindível, então o 2D se baseia em detectores de um estágio (a família YOLO) e o 3D se baseia em detectores 3D focados em eficiência, como PointPillars ou CenterPoint. A Segmentação Semântica/Panóptica é frequentemente aplicada em camadas para entender a área transitável.
-
Câmeras de vigilância / segurança: o conjunto de classes de alvos (pessoas, veículos) geralmente é limitado, e a falha na detecção é mais importante do que a velocidade bruta, abrindo caminho para detectores de dois estágios ou detectores de alta precisão baseados em Transformers. AR/VR: decidir onde ancorar um objeto virtual no mundo real geralmente significa usar Segmentação Semântica para identificar planos e regiões do objeto e, em seguida, aplicar Fusão de Sensores (consulte o artigo complementar) para um alinhamento 3D preciso.
Em dispositivos de borda com recursos limitados, velocidade e tamanho geralmente são priorizados em relação à precisão — variantes leves do YOLO ou um SegFormer simplificado. Para análises offline precisas (imagens médicas, imagens de satélite), a precisão vem em primeiro lugar, favorecendo detectores de dois estágios ou modelos da classe Mask2Former. Na prática, esse equilíbrio entre desempenho em tempo real e precisão é o fator mais importante na decisão.
Para os desenvolvimentos mais recentes — arquiteturas sem NMS, detecção de vocabulário aberto, modelos fundamentais na família Segment Anything — consulte Tendências Tecnológicas em Detecção de Objetos e Tendências Tecnológicas em Segmentação Semântica.
13. Resumo
A Detecção de Objetos captura objetos como retângulos; a Segmentação Semântica os captura pixel a pixel — duas tarefas de compreensão de imagem operando em resoluções diferentes. A linhagem da Detecção vai de duas etapas (Faster R-CNN) a uma etapa (YOLO) e aos detectores baseados em Transformers que descartam âncoras e NMS completamente (DETR/DINO); a da Segmentação vai de FCN a U-Net e DeepLab, até o SegFormer/Mask2Former baseado em Transformers. Sobre essa base, temos a Segmentação de Instâncias, que adiciona distinção por objeto, a Segmentação Panóptica, que unifica ambas, e suas contrapartes 3D baseadas em nuvens de pontos — e a escolha entre elas sempre depende se o momento exige precisão ou velocidade.
Quais saídas distinguem a detecção da segmentação?
A detecção normalmente retorna caixas delimitadoras e classes; a segmentação retorna regiões de pixels. Escolha de acordo com as necessidades de localização, contornos e identidade da instância.
Comentários
Entre na sua conta para continuar.
Ainda não há dados.