Contents — find the section you need
Şimdiye kadar ele alınan Takviyeli Öğrenmenin Temelleri ve Q-öğrenme ve DQN, ortamın yalnızca tek bir ajana tepki verdiği bir MDP'yi varsaymaktadır. Ancak, birden fazla ajanın aynı anda ortam üzerinde hareket ettiği birçok durum vardır - bir depoda birden fazla taşıma robotu, rekabetçi oyunlar, iletişim görevlerini paylaşan bir drone sürüsü. Çoklu Ajanlı Takviyeli Öğrenme (MARL), tek ajanlı RL'de bulunmayan bir zorlukla ilgilenir: bu ortamda, sizden başka herkes de öğrenir ve sürekli değişir.
30 Saniyelik Özet
-
Tek ajanlı bir MDP'de, ortamın geçiş olasılığı P(s'\mid s,a) sabittir, ancak diğer ajanların da öğrenip politikalarını değiştirdiği çok ajanlı bir ortamda, belirli bir ajanın "ortam" olarak gördüğü şey zaman içinde değişir - buna durağan olmama denir.
-
Ortamlar genel olarak işbirlikçi (herkes paylaşılan bir ödülü maksimize eder), rekabetçi (sıfır toplamlı benzeri, rakibi yenme) ve karma (kısmen işbirlikçi, kısmen rekabetçi) olarak ayrılır ve gerekli algoritma buna göre değişir.
-
CTDE (Merkezi Eğitim ve Merkezi Olmayan Yürütme) - burada öğrenme küresel bilgileri kullanır, ancak yürütme her ajanın yalnızca kendi gözlemlerine göre hareket etmesini sağlar - gerçek donanım ve gerçek ortamlar için pratik olan ana akım çerçevedir.
-
Paylaşılan bir ödülün bireysel ajanların katkıları arasında nasıl dağıtılacağı - kredi atama problemi - işbirlikçi MARL'deki en büyük teknik zorluktur.
-
MADDPG (Lowe vd., 2017) ve QMIX (Rashid vd., 2018), sırasıyla Aktör-Eleştirmen ve Q-değeri faktörizasyonu açısından CTDE'yi somutlaştıran temsili algoritmalardır.
1. Tek Ajanlı Çerçeve Neden Başarısız Oluyor?
MDP'nin temel varsayımı, ortamın geçişinin P(s'\mid s,a) ve ödülünün R(s,a,s') ajanın politikasından bağımsız olarak sabit olmasıydı. Ajan politikasını güncellese bile, ortamın fiziksel yasaları değişmez.
Birden fazla ajanın bulunduğu bir ortamda bu varsayım geçerliliğini yitirir. Ajan i'ün "ortam" olarak gördüğü şey artık sadece fiziksel yasaları değil, diğer ajanların -i (i hariç herkesin) politikalarını \pi_{-i} da içerir. Diğer ajanlar da aynı anda öğrenip sürekli olarak \pi_{-i}'yi güncellediği için, ajan i'in deneyimlediği etkin geçiş olasılığı,
\pi_{-i} her değiştiğinde değişir. Bu, durağan olmama durumudur. Ajan i'in bakış açısından, dün iyi sonuç veren bir eylem, karşı tarafın politikası değiştiği için bugün işe yaramayabilir. Eski geçişleri bir tekrar oynatma tamponunda saklamak bile aktif olarak yanıltıcı olabilir; bu deneyim, "artık var olmayan" bir rakibe karşı toplanmıştır.

Şekil 1 — i ajanı için "ortam", yalnızca fiziksel yasaları değil, diğer ajanların politikalarını da içerir. Diğerleri öğrenmeye devam ettikçe, i'nin deneyimlediği geçiş dağılımı hareket etmeye devam eder.
2. İşbirlikçi, Rekabetçi ve Karma: Ödül Yapısı Problemi Şekillendirir
Çoklu ajan probleminin karakteri, ödülün nasıl atandığına bağlı olarak önemli ölçüde değişir.
| Ortam | Ödül İlişkisi | Temsili Örnek | Ana Zorluk |
|---|---|---|---|
| İşbirlikçi | Herkes ortak veya yüksek oranda ilişkili bir ödülü maksimize eder | Taşıma verimliliğini maksimize eden birden fazla depo robotu | Kredi ataması, iletişim tasarımı |
| Rekabetçi | Bir tarafın kazancı diğer tarafın kaybıdır (sıfıra yakın toplam) | Rekabetçi oyunlar, fiyat rekabeti simülasyonları | Rakibin adaptasyonunu takip etmek gerekir, kararsız dengeler |
| Karma / genel toplam | Kısmen işbirlikçi, kısmen düşmanca | Bir kavşakta birden fazla araç, bir kaynak için rekabet eden işbirlikçi robotlar | İşbirliği gerektiren durumlar ile rekabet gerektiren durumlar arasında geçiş |
İşbirlikçi ortamlar genellikle matematiksel olarak Dec-POMDP (Merkezi Olmayan Kısmen Gözlemlenebilir MDP) olarak formüle edilir; burada herkes aynı optimal politika kümesini hedefler. Rekabetçi ortamlar, oyun teorisinde Nash dengesine yakın kavramlar kullanılarak değerlendirilir; burada tek bir "optimal politika" bile mevcut olmayabilir - çünkü rakibin politikası değiştikçe, sizin için optimal olan da değişir. Karma ortamlar gerçeğe en yakın olanlardır, ancak en az teorik garantiye sahiptirler.
3. CTDE: Merkezi Eğitim, Uygulama Sahaya Bırakıldı
CTDE (Merkezi Eğitim ve Merkezi Olmayan Uygulama) Yürütme (Execution)**, durağan olmayan durumlarla başa çıkmak için yaygın olarak kullanılır. Eğitim sırasında (bir simülatör içinde veya çevrimdışı bir eğitim aşamasında), her ajanın gözlemlerini, eylemlerini ve bazen ödüllerini aynı anda gören merkezi bilgileri kullanmanıza izin verilir. Ancak yürütme zamanında (gerçek donanımda, bir üretim ortamında), her ajan kendi sensörlerinden gelen yerel gözlemi kullanarak eylemine karar verir.
CTDE'nin pratik çalışma nedeni açıktır. İletişim bant genişliği ve gecikme kısıtlamaları göz önüne alındığında, gerçek bir robot veya drone filosunun her ajanın durumunu sürekli olarak paylaşırken çalışması genellikle gerçekçi değildir. Ancak bir simülatör veya eğitim sunucusu içinde, iletişim maliyeti konusunda endişelenmeden tüm bilgileri kullanabilirsiniz. CTDE, "yalnızca eğitim sırasında kullanılabilen ayrıcalıklı bilgilerden" maksimum düzeyde yararlanırken, yürütme zamanında özerk olarak hareket edebilecek bir politikayı da geride bırakan bir tasarımdır.
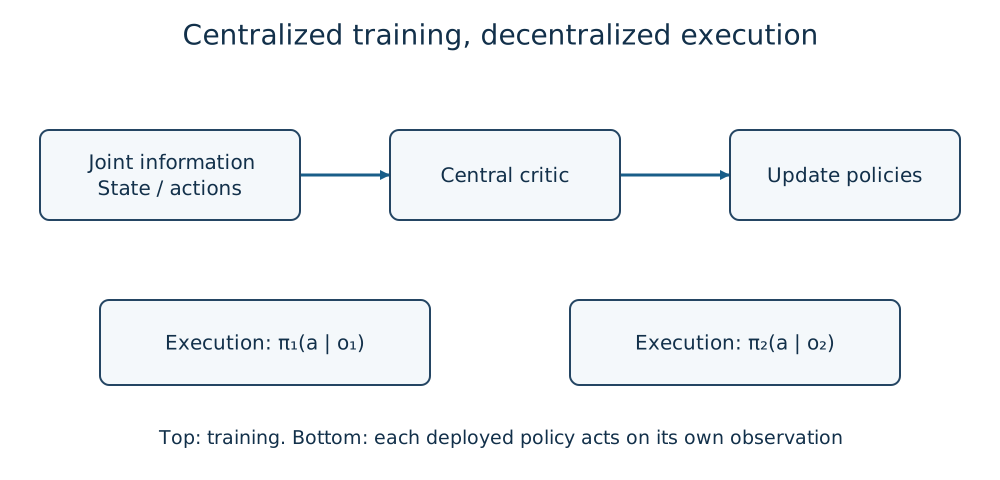
Şekil 2 — Eğitim sırasında, merkezi bir eleştirmen (veya karıştırma ağı) herkesin bilgilerini bütünleştirir; yürütme zamanında, her ajan yalnızca yerel gözleme dayanarak karar verir. İkisini ayırmak, yürütme zamanı iletişim kısıtlamalarına tolerans gösterirken, eğitim tarafında durağan olmama durumunun absorbe edilmesini sağlar.
4. Kredi Atama Problemi: Kimin Başarısı, Kimin Başarısızlığı
İşbirliğine dayalı bir ortamda, elde ettiğiniz tek şey tek bir paylaşılan ödül r olduğunda, hangi n ajanın eylemlerinin bu ödüle gerçekten katkıda bulunduğu kendiliğinden açık değildir. Her ajana aynı ödülü verin; aslında tembellik eden bir ajan da aynı "iyi" değerlendirmeyi alırken, gerçekten katkıda bulunan bir ajanın sinyali diğerlerinin eylemlerinin arasında kaybolur. Bu, ödül atama problemidir.
Bir yaklaşım, değer fonksiyonunu bireysel ajanlara ayırmaktır. QMIX (Rashid vd., 2018), her ajanın bireysel Q-değerini Q_i(o_i,a_i) negatif olmayan ağırlıklara sahip bir karıştırma ağı kullanarak birleştirir ve genel Q-değerini Q_{\text{tot}} oluşturur.
Bu monotonluk kısıtlaması, her ajanın kendi Q_i değerini açgözlülükle maksimize eden eylemi seçmesinin, genel Q_{\text{tot}} değerini maksimize etme ile çelişmemesini garanti eder (IGM: Bireysel-Küresel-Maksimum koşulu). Başka bir deyişle, karıştırma ağı, eğitim sırasında, merkezi olmayan yürütme zamanında yalnızca kendi Q-değerine göre hareket eden her bir ajanın küresel optimumdan çok uzaklaşmamasını sağlayacak bir yapı oluşturur.
Farklı bir yönde, COMA (Foerster vd., 2018), Aktör-Eleştirmen çerçevesi içinde karşıolgusal bir temel kullanır. Ajan i'nin eyleminin varsayımsal olarak farklı bir eylemle değiştirilmesi durumunda beklenen ödül ile gerçekten seçilen eylemin beklenen ödülü arasındaki farkı alarak ve bunu avantaj olarak kullanarak, diğer ajanların katkılarından ayrı olarak "kendi eylemim genel ödülü ne kadar değiştirdi" sorusunu izole eder ve değerlendirir.
Her iki yöntemin de ortak noktası, tek bir paylaşılan ödül sayısından her bir ajan için bir öğrenme sinyali çıkarmak için kullanılan araçlar olmalarıdır.
5. Temsili Algoritmalar
| Algoritma | Aile | Ana Ortam | Ana Fikir |
|---|---|---|---|
| MADDPG (Lowe vd., 2017) | Aktör-Eleştirmen (sürekli eylem) | İşbirlikçi, rekabetçi, karma | Her ajan için özel bir merkezi Eleştirmen; yürütme zamanında yalnızca kendi Aktörü |
| QMIX (Rashid vd., 2018) | Değer tabanlı (ayrık eylem) | İşbirlikçi | Bireysel Q-değerlerini, IGM koşulunu sağlayan monoton bir karıştırma ağıyla birleştirir |
| COMA (Foerster vd., 2018) | Aktör-Eleştirmen | İşbirlikçi | Karşı olgusal bir temel çizgi ile kredi atamasını açıkça ele alır |
| Bağımsız öğrenme (Bağımsız Q-Öğrenme / IPPO, vb.) | Tek ajanlı yöntemlerin basit uzantısı | Her şeye uygulanabilir | Uygulaması basit, ancak durağan olmama durumunu göz ardı ediyor, bu nedenle öğrenme istikrarsız hale gelme eğiliminde. |
MADDPG, DDPG'yi birden fazla ajana genişletir: her ajan i, eğitim sırasında kendi özel merkezi Eleştirmenini Q_i(s,a_1,\dots,a_n) kullanır ve yürütme zamanında yalnızca kendi Aktörünü \pi_i(a_i\mid o_i) kullanarak hareket eder. Bu tasarım, aynı çerçevenin işbirlikçi, rekabetçi veya karma ödül yapılarının herhangi birine uygulanmasına olanak tanır.
QMIX, sürekli kontrole göre ayrık eylemli işbirlikçi görevlerde (StarCraft Çoklu Ajan Yarışması gibi kıyaslama testleri) daha güçlüdür ve nispeten güçlü monotonluk kısıtlaması varsayımı karşılığında, teorik olarak merkezi olmayan yürütme zamanında tutarlılığı garanti eder.
"Bağımsız öğrenme" - her ajanın diğer ajanların varlığını görmezden geldiği ve sıradan Q-öğrenme veya PPO'yu paralel olarak çalıştırdığı basit yöntem - bazı durumlarda şaşırtıcı derecede iyi çalışabilir. Ancak, durağan olmama durumunu hiç ele almadığı için, ajan sayısı arttıkça veya rakiplerin politikaları hızla değiştikçe öğrenme sapma eğilimi gösterir. CTDE ailesi yöntemleri, eğitim sırasında mevcut olan ayrıcalıklı bilgileri kullanarak bu basit yöntemin sorunlarını hafifletme girişimi olarak anlaşılabilir.
6. Çoklu Robot Sürü Kontrolü ile İlişkisi
Birden fazla fiziksel robotun işbirliği içinde birlikte çalıştığı sürü kontrolü (çoklu robot sistemleri), MARL'nin uygulama alanlarından biridir. Depo taşımacılığı, birden fazla dronun birlikte uçuşu ve birden fazla üniteyle işbirliği içinde arama ve kurtarma, "her robotun yalnızca yerel gözlemleri vardır, iletişim kısıtlıdır ve genel verimliliği artırmak istiyoruz" yapısını paylaşır; bu yapı, CTDE'nin merkezi eğitim ve merkezi olmayan yürütme fikriyle iyi örtüşmektedir.
Bununla birlikte, sürü kontrolünün MARL'nin öğrenme teorisinin tek başına tam olarak ele alamayacağı birçok unsuru vardır: değişken sayıda birey (robotların görevden ayrılması veya görev sırasında eklenmesi), dinamik olarak değişen bir iletişim topolojisi ve çarpışmadan kaçınma gibi güvenlik kısıtlamalarının her zaman öğrenilen politikanın dışında tutulması gerekliliği. Bu sitede henüz çoklu robot sürü kontrolüne adanmış bir makale bulunmamaktadır, ancak MARL, temel teorilerinden biri olarak konumlandırılmıştır.
7. Uygulama ve Değerlendirme Kontrol Listesi
-
Her ajanın gözlemlerini, eylemlerini ve ödüllerini eğitim süresi (merkezi bilgilerle) ve uygulama süresi (yalnızca yerel gözlem) için açıkça ayırdınız ve kaydettiniz mi?
-
Ödülün işbirlikçi, rekabetçi veya karma olup olmadığını önceden tanımladınız ve buna uygun bir algoritma seçtiniz mi (bir QMIX ailesi, bir MADDPG ailesi veya bağımsız öğrenme)?
-
Öğrenme eğrisini sadece genel ödül olarak değil, ajan başına katkı, eylem oranı ve bireysel başarı oranı açısından da takip ettiniz mi, böylece hiçbir ajanın öğrenme sürecinde tembellik etmediğini doğruladınız mı?
-
Farklı sayıda ajan veya topoloji içeren koşullar altında değerlendirme yaptınız mı, böylece eğitim süresi boyunca aşırı uyum sağlamadığınızı doğruladınız mı?
-
Gerçek donanım ve gerçek ortamlar için, iletişim gecikmesi ve veri kaybını varsaydınız mı ve her ajanın iletişim kesintisi sırasında bile güvenli davranışa geri dönebildiğini (öğrenilen politikanın dışında tutulan güvenlik kısıtlamalarıyla) doğruladınız mı?
Özet
Çoklu ajanlı pekiştirmeli öğrenme, tek ajanlı bir MDP'nin örtük varsayımı olan "ortam sabittir" varsayımının bozulduğu noktada başlar. Durağan olmama durumu, diğer ajanların öğrenmesinin kendi ortamınız olarak kabul edilen şeyi sürekli olarak değiştirmesi; işbirlikçi, rekabetçi ve karma ödül yapıları arasındaki fark; ve paylaşılan bir ödülün bireysel katkılar arasında nasıl dağıtılacağına dair kredi atama problemi — CTDE bunların hepsine pratik bir cevaptır ve MADDPG ve QMIX bunun somut uygulamalarıdır. Çoklu robot sürüsü kontrolü gibi birden fazla fiziksel ajanı içeren uygulamalarda, uygulama düzeyindeki zorlukların — değişken sayıda birey, dinamik iletişim ve güvenlik kısıtlamaları — öğrenme teorisinin üzerine eklendiğini de akılda tutmakta fayda var.
Tek ajanlı bir yöntem, birçok ajana değiştirilmeden aktarılabilir mi?
Diğer öğrenme ajanları ortamı değiştirir.
İşbirliği, rekabet, gözlem sınırları ve eğitim ile uygulama bilgileri arasındaki farkı açıklayın. ## Referanslar - [Lowe vd., Karışık İşbirlikçi-Rekabetçi Ortamlar için Çoklu Ajan Aktör-Eleştirmen (NeurIPS, 2017)](https://arxiv.org/abs/1706.02275) - [Rashid vd., QMIX: Derin Çoklu Ajan Takviyeli Öğrenme için Monotonik Değer Fonksiyonu Faktörizasyonu (ICML, 2018)](https://arxiv.org/abs/1803.11485) - [Foerster vd., Karşıolgusal Çoklu Ajan Politika Gradyanları (AAAI, 2018)](https://arxiv.org/abs/1705.08926) - [OpenAI Spinning Up — RL'de Temel Kavramlar](https://spinningup.openai.com/en/latest/spinningup/rl_intro.html) - [Takviyenin Temelleri] [Öğrenme](/tr/blog/posts/reinforcement-learning-basics.html), [Q-Learning ve DQN Temelleri](/tr/blog/posts/reinforcement-q-learning-dqn.html), [Politika Gradyanı/PPO/SAC Temelleri](/tr/blog/posts/reinforcement-policy-gradient-ppo-sac.html)
Yorumlar
Lütfen önce giriş yapın.
Henüz veri yok.