Contents — find the section you need
I fondamenti dell'apprendimento per rinforzo e Q-learning e DQN, trattati finora, presupponevano un MDP in cui l'ambiente reagisce a un solo agente. Esistono però numerosi scenari in cui più agenti interagiscono contemporaneamente con l'ambiente: ad esempio, più robot di trasporto in un magazzino, giochi competitivi, uno sciame di droni che condividono le funzioni di comunicazione. L'apprendimento per rinforzo multi-agente (MARL) affronta una difficoltà assente nell'apprendimento per rinforzo a singolo agente: in questo contesto, tutti gli altri agenti, oltre a te, apprendono e sono in continua evoluzione.
Riepilogo in 30 secondi
-
In un MDP a singolo agente, la probabilità di transizione dell'ambiente P(s'\mid s,a) è fissa, ma in un ambiente multi-agente in cui anche altri agenti apprendono e modificano le proprie politiche, ciò che un particolare agente percepisce come "l'ambiente" cambia nel tempo: questo fenomeno è chiamato non stazionarietà.
-
Gli scenari si dividono generalmente in cooperativi (ognuno massimizza una ricompensa condivisa), competitivi (simili a somma zero, sconfiggendo un avversario) e misti (in parte cooperativi, in parte competitivi), e l'algoritmo richiesto cambia di conseguenza.
-
Il CTDE (Centralized Training with Decentralized Execution) — in cui l'apprendimento utilizza informazioni globali ma l'esecuzione fa sì che ogni agente agisca esclusivamente in base alle proprie osservazioni — è il framework principale, pratico per hardware e ambienti reali.
-
Come distribuire una ricompensa condivisa tra i contributi dei singoli agenti — il problema dell'assegnazione del credito — è la sfida tecnica più grande nell'apprendimento multi-agente cooperativo (MARL).
-
MADDPG (Lowe et al., 2017) e QMIX (Rashid et al., 2018) sono algoritmi rappresentativi che concretizzano il CTDE, rispettivamente dal punto di vista dell'attore-critico e della fattorizzazione del valore Q.
1. Perché il framework a singolo agente non è più valido?
L'assunto centrale del MDP era che la transizione dell'ambiente P(s'\mid s,a) e la ricompensa R(s,a,s') fossero fisse, indipendenti dalla politica dell'agente. Anche quando l'agente aggiorna la sua politica, le leggi fisiche dell'ambiente stesso non cambiano.
In un ambiente con più agenti, questa premessa non è più valida. Ciò che l'agente i percepisce come "l'ambiente" ora include non solo le leggi fisiche, ma anche le politiche \pi_{-i} degli altri agenti -i (tutti tranne i). Poiché anche gli altri agenti apprendono simultaneamente e aggiornano continuamente \pi_{-i}, la probabilità di transizione effettiva che l'agente i sperimenta,
cambia ogni volta che \pi_{-i} cambia. Questa è la non stazionarietà. Dal punto di vista dell'agente i, un'azione che ha funzionato bene ieri potrebbe non funzionare oggi, ora che la politica dell'altra parte è cambiata. Anche memorizzare vecchie transizioni in un buffer di replay può essere fuorviante: quell'esperienza è stata raccolta contro un avversario che "non esiste più".

Figura 1 — Ciò che "l'ambiente" rappresenta per l'agente i include non solo le leggi fisiche, ma anche le politiche degli altri agenti. Finché gli altri continuano ad apprendere, la distribuzione di transizione che l'agente i sperimenta continua a evolversi.
2. Cooperativo, Competitivo e Misto: la struttura delle ricompense modella il problema
La natura di un problema multi-agente cambia drasticamente a seconda di come vengono assegnate le ricompense.
| Contesto | Relazione tra ricompense | Esempio rappresentativo | Difficoltà principale |
|---|---|---|---|
| Cooperativo | Ognuno massimizza una ricompensa comune o altamente correlata | Più robot di magazzino che massimizzano l'efficienza del trasporto | Assegnazione del credito, progettazione della comunicazione |
| Competitivo | Il guadagno di una parte corrisponde alla perdita dell'altra (quasi a somma zero) | Giochi competitivi, simulazioni di concorrenza di prezzo | È necessario monitorare l'adattamento dell'avversario, equilibri instabili |
Misto / a somma generale | Parzialmente cooperativo, parzialmente avversariale | Più veicoli a un incrocio, robot cooperativi in competizione per una risorsa | Passaggio tra situazioni che richiedono cooperazione e situazioni che richiedono competizione |
Gli ambienti cooperativi sono spesso formalizzati matematicamente come un Dec-POMDP (Decentralized Partially Observable MDP), in cui tutti mirano allo stesso insieme di politiche ottimali. Gli ambienti competitivi vengono valutati utilizzando concetti simili all'equilibrio di Nash nella teoria dei giochi, dove una singola "politica ottimale" potrebbe non esistere nemmeno, perché al variare della politica dell'avversario, cambia anche ciò che è ottimale per te. Gli ambienti misti sono i più vicini alla realtà, ma offrono il minor numero di garanzie teoriche.
3. CTDE: Addestramento centralizzato, esecuzione lasciata al campo
**CTDE (Addestramento centralizzato con decentralizzazione L'algoritmo CTDE (Execution) è ampiamente utilizzato per gestire la non stazionarietà. Durante l'addestramento (all'interno di un simulatore o durante una fase di addestramento offline), è possibile utilizzare informazioni centralizzate che visualizzano simultaneamente le osservazioni, le azioni e talvolta le ricompense di ogni agente. Tuttavia, in fase di esecuzione (su hardware reale, in un ambiente di produzione), ogni agente decide la propria azione utilizzando solo le osservazioni locali provenienti dai propri sensori.
Il motivo pratico per cui CTDE funziona è chiaro. Date le limitazioni di larghezza di banda e latenza della comunicazione, è spesso irrealistico per una flotta reale di robot o droni operare condividendo costantemente lo stato di ogni agente. Ma all'interno di un simulatore o di un server di addestramento, è possibile utilizzare tutte le informazioni senza preoccuparsi dei costi di comunicazione. CTDE è un'architettura che sfrutta al massimo queste "informazioni privilegiate disponibili solo durante l'addestramento", lasciando comunque una policy che può agire autonomamente in fase di esecuzione.
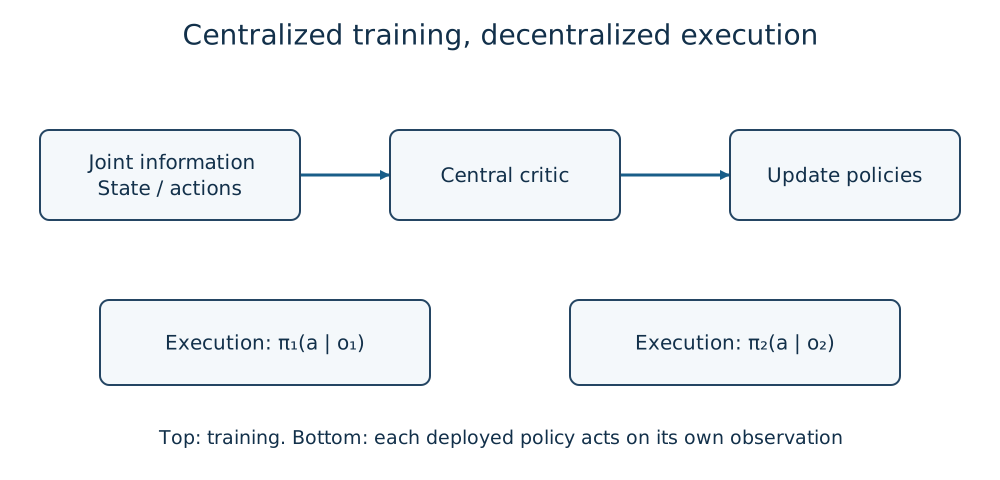
Figura 2 — Durante l'addestramento, un critico centrale (o rete di miscelazione) integra le informazioni di tutti; in fase di esecuzione, ogni agente decide basandosi esclusivamente sull'osservazione locale. La separazione delle due fasi consente di assorbire la non stazionarietà durante l'addestramento, tollerando al contempo i vincoli di comunicazione in fase di esecuzione.
4. Il problema dell'attribuzione del merito: di chi è il successo, di chi è il fallimento
In un contesto cooperativo, quando si ottiene un'unica ricompensa condivisa r, non è immediatamente evidente quale delle azioni degli agenti n abbia effettivamente contribuito a tale ricompensa. Assegnando a ogni agente la stessa ricompensa, un agente che in realtà si è adagiato sugli allori riceve una valutazione altrettanto "buona", mentre il segnale di un agente che ha effettivamente contribuito viene oscurato dalle azioni degli altri. Questo è il problema dell'attribuzione del credito.
Un approccio consiste nel decomporre la funzione di valore in singoli agenti. QMIX (Rashid et al., 2018) combina il valore Q individuale Q_i(o_i,a_i) di ciascun agente utilizzando una rete di miscelazione con pesi non negativi, per costruire il valore Q complessivo Q_{\text{tot}}.
Questo vincolo di monotonicità garantisce che la scelta da parte di ciascun agente dell'azione che massimizza in modo avido il proprio Q_i non sia in conflitto con la massimizzazione del Q_{\text{tot}} complessivo (la condizione IGM: Individual-Global-Max). In altre parole, la rete di miscelazione integra, durante l'addestramento, una struttura tale che ciascun agente, agendo esclusivamente in base al proprio valore Q in fase di esecuzione decentralizzata, non si discosti significativamente dall'ottimo globale.
In un approccio diverso, COMA (Foerster et al., 2018) utilizza una baseline controfattuale all'interno di un framework Actor-Critic. Calcolando la differenza tra la ricompensa attesa se l'azione dell'agente i fosse ipoteticamente sostituita con un'altra azione, e la ricompensa attesa per l'azione effettivamente scelta, e utilizzando tale differenza come vantaggio, si isola e si valuta "quanto la mia azione ha influenzato la ricompensa complessiva", separatamente dal contributo degli altri agenti.
Entrambi i metodi hanno in comune il fatto di essere strumenti per estrarre un segnale di apprendimento per ogni singolo agente da un unico valore di ricompensa condivisa.
5. Algoritmi rappresentativi
| Algoritmo | Famiglia | Ambientazione principale | Idea chiave |
|---|---|---|---|
| MADDPG (Lowe et al., 2017) | Attore-Critico (azione continua) | Cooperativo, competitivo, misto | Un Critico centralizzato dedicato per ogni agente; solo il proprio Attore al momento dell'esecuzione |
| QMIX (Rashid et al., 2018) | Basato sul valore (azione discreta) | Cooperativo | Combina i valori Q individuali con una rete di miscelazione monotona, soddisfacendo la condizione IGM |
| COMA (Foerster et al., 2018) | Attore-Critico | Cooperativo | Gestisce esplicitamente l'assegnazione del credito con una baseline controfattuale |
| Apprendimento indipendente (Independent Q-Learning / IPPO, ecc.) | Estensione ingenua dei metodi a singolo agente | Applicabile a qualsiasi cosa | Semplice da implementare, ma ignora la non stazionarietà, quindi l'apprendimento tende a diventare instabile. |
MADDPG estende DDPG a più agenti: ogni agente i utilizza il proprio Critico centralizzato dedicato Q_i(s,a_1,\dots,a_n) durante l'addestramento e agisce utilizzando solo il proprio Attore \pi_i(a_i\mid o_i) in fase di esecuzione. Questa progettazione consente di applicare lo stesso framework a qualsiasi struttura di ricompensa cooperativa, competitiva o mista.
QMIX è più efficace nei compiti cooperativi ad azioni discrete (benchmark come la StarCraft Multi-Agent Challenge) che nel controllo continuo e, in cambio della relativamente forte ipotesi del vincolo di monotonicità, garantisce teoricamente la coerenza in fase di esecuzione decentralizzata.
L'"apprendimento indipendente" - il metodo ingenuo in cui ogni agente ignora semplicemente l'esistenza degli altri agenti ed esegue in parallelo il Q-learning o il PPO ordinario - può funzionare sorprendentemente bene in alcuni casi. Ma poiché non affronta affatto il problema della non stazionarietà, l'apprendimento tende a divergere all'aumentare del numero di agenti o al variare rapido delle politiche degli avversari. I metodi della famiglia CTDE possono essere intesi come un tentativo di mitigare i problemi di questo metodo ingenuo, utilizzando le informazioni privilegiate disponibili in fase di addestramento.
6. Relazione con il controllo di sciami di robot multipli
Il controllo di sciami (sistemi multi-robot), in cui più robot fisici lavorano insieme in modo cooperativo, è una delle aree di applicazione di MARL. Il trasporto in magazzino, il volo in formazione di più droni e la ricerca e il salvataggio cooperativi con più unità condividono tutti la struttura "ogni robot ha solo osservazioni locali, la comunicazione è limitata e vogliamo migliorare l'efficienza complessiva" - una struttura che si adatta bene all'idea di CTDE di addestramento centralizzato ed esecuzione decentralizzata.
Detto questo, il controllo di sciami presenta molti elementi che la sola teoria dell'apprendimento MARL non è in grado di gestire completamente: un numero variabile di individui (robot che si ritirano o vengono aggiunti durante la missione), una topologia di comunicazione che cambia dinamicamente e la necessità di posizionare vincoli di sicurezza, come l'evitamento delle collisioni, al di fuori della politica appresa in ogni momento. Questo sito non ha ancora un articolo dedicato al controllo di sciami multi-robot, ma MARL è considerato una delle sue teorie fondamentali.
7. Lista di controllo per l'implementazione e la valutazione
- Hai separato e registrato chiaramente le osservazioni, le azioni e le ricompense di ciascun agente per il tempo di addestramento (con informazioni centralizzate) rispetto al tempo di esecuzione (solo osservazioni locali)?
Hai prima definito se la ricompensa è cooperativa, competitiva o mista e hai scelto un algoritmo adatto (una famiglia QMIX, una famiglia MADDPG o apprendimento indipendente)?
-
Avete monitorato la curva di apprendimento non solo in termini di ricompensa complessiva, ma anche in base al contributo per agente, al rapporto di azione e al tasso di successo individuale, per confermare che nessun singolo agente stia semplicemente rallentando il proprio apprendimento?
-
Avete effettuato valutazioni in condizioni con un numero diverso di agenti o topologie, per confermare di non aver incorrere in overfitting rispetto al numero di agenti disponibili per l'addestramento?
-
Per hardware e ambienti reali, avete ipotizzato latenza e dropout nella comunicazione e confermato che ogni agente possa tornare a un comportamento sicuro anche durante un'interruzione della comunicazione (con vincoli di sicurezza mantenuti al di fuori della politica appresa)?
Riepilogo
L'apprendimento per rinforzo multi-agente inizia nel punto in cui l'assunto implicito di un MDP a singolo agente — "l'ambiente è fisso" — non è più valido. La non stazionarietà, in cui l'apprendimento degli altri agenti continua a modificare ciò che viene considerato il proprio ambiente; la differenza tra strutture di ricompensa cooperative, competitive e miste; e il problema dell'attribuzione del merito, ovvero come distribuire una ricompensa condivisa tra i contributi individuali: CTDE è la risposta pratica a tutti questi problemi, e MADDPG e QMIX ne sono le realizzazioni concrete. Nelle applicazioni che coinvolgono più agenti fisici, come il controllo di sciami di robot, è importante tenere presente che le sfide a livello di implementazione – un numero variabile di individui, la comunicazione dinamica e i vincoli di sicurezza – si sommano alla teoria dell'apprendimento.
Un metodo per singolo agente può essere trasferito senza modifiche a più agenti?
Altri agenti di apprendimento modificano l'ambiente.
Distinguere tra cooperazione, competizione, limiti di osservazione e informazioni di addestramento rispetto a quelle di esecuzione.Riferimenti
- Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (NeurIPS, 2017)
- Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning (ICML, 2018)
- Foerster et al., Counterfactual Multi-Agent Policy Gradients (AAAI, 2018)
- OpenAI Spinning Up — Key Concepts in RL
- [The Basics of Reinforcement Apprendimento, Introduzione al Q-Learning e al DQN, Introduzione al Policy Gradient/PPO/SAC
Commenti
Accedi per continuare.
Nessun dato disponibile.