Contents — find the section you need
Dasar-dasar pembelajaran penguatan dan Q-learning dan DQN, yang telah dibahas sejauh ini, mengasumsikan MDP di mana lingkungan hanya bereaksi terhadap satu agen. Tetapi ada banyak pengaturan di mana banyak agen bertindak pada lingkungan secara bersamaan — beberapa robot pengangkut di gudang, permainan kompetitif, sekumpulan drone yang berbagi tugas komunikasi. Pembelajaran Penguatan Multi-Agen (MARL) menangani kesulitan yang tidak ada dalam RL agen tunggal: dalam pengaturan ini, semua orang selain Anda juga belajar, dan terus berubah.
Ringkasan 30 Detik
- Dalam MDP agen tunggal, probabilitas transisi lingkungan P(s'\mid s,a) tetap, tetapi dalam lingkungan multi-agen di mana agen lain juga belajar dan mengubah kebijakan mereka, apa yang dilihat oleh satu agen tertentu sebagai "lingkungan" berubah seiring waktu — ini disebut non-stasioneritas.
- Pengaturan secara umum terbagi menjadi kooperatif (setiap orang memaksimalkan imbalan bersama), kompetitif (seperti zero-sum, mengalahkan lawan), dan campuran (sebagian kooperatif, sebagian kompetitif), dan algoritma yang dibutuhkan berubah sesuai dengan itu.
-
CTDE (Pelatihan Terpusat dengan Eksekusi Terdesentralisasi) — di mana pembelajaran menggunakan informasi global tetapi eksekusi membuat setiap agen bertindak berdasarkan pengamatannya sendiri — adalah kerangka kerja utama yang praktis untuk perangkat keras nyata dan lingkungan nyata.
-
Bagaimana mendistribusikan imbalan bersama di seluruh kontribusi agen individu — masalah penugasan kredit — adalah tantangan teknis terbesar dalam MARL kooperatif.
-
MADDPG (Lowe dkk., 2017) dan QMIX (Rashid dkk., 2018) adalah algoritma representatif yang mengkonkretkan CTDE, dari sudut pandang faktorisasi Aktor-Kritik dan nilai Q masing-masing.
1. Mengapa Kerangka Kerja Agen Tunggal Gagal?
Asumsi utama MDP adalah bahwa transisi lingkungan P(s'\mid s,a) dan imbalan R(s,a,s') tetap, independen dari kebijakan agen. Bahkan ketika agen memperbarui kebijakannya, hukum fisika lingkungan itu sendiri tidak berubah.
Dalam lingkungan dengan banyak agen, premis ini gagal. Apa yang dilihat agen i sebagai "lingkungan" sekarang mencakup tidak hanya hukum fisika tetapi juga kebijakan \pi_{-i} dari agen lain -i (semua selain i). Karena agen-agen lain juga belajar secara bersamaan dan terus memperbarui \pi_{-i}, probabilitas transisi efektif yang dialami agen i,
berubah setiap kali \pi_{-i} berubah. Ini adalah non-stasioneritas. Dari perspektif agen i, tindakan yang berhasil kemarin mungkin tidak berhasil hari ini, karena kebijakan pihak lain telah berubah. Bahkan menyimpan transisi lama dalam buffer pemutaran ulang dapat secara aktif menyesatkan — pengalaman itu dikumpulkan terhadap lawan yang "tidak lagi ada."

Gambar 1 — Apa yang dimaksud dengan "lingkungan" bagi agen i mencakup bukan hanya hukum fisik tetapi juga kebijakan agen lain. Selama agen lain terus belajar, distribusi transisi yang dialami i terus bergerak.
2. Kooperatif, Kompetitif, dan Campuran: Struktur Hadiah Membentuk Masalah
Karakter masalah multi-agen berubah secara dramatis tergantung pada bagaimana hadiah diberikan.
| Pengaturan | Hubungan Hadiah | Contoh Representatif | Kesulitan Utama |
|---|---|---|---|
| Kooperatif | Semua orang memaksimalkan hadiah umum atau yang sangat berkorelasi | Beberapa robot gudang memaksimalkan efisiensi transportasi | Penugasan kredit, desain komunikasi |
| Kompetitif | Keuntungan satu pihak adalah kerugian pihak lain (mendekati zero-sum) | Permainan kompetitif, simulasi persaingan harga | Harus melacak adaptasi lawan, keseimbangan tidak stabil |
| Campuran / general-sum | Sebagian kooperatif, sebagian antagonis | Beberapa kendaraan di persimpangan, robot kooperatif bersaing untuk mendapatkan sumber daya | Beralih antara situasi yang membutuhkan kerja sama dan situasi yang membutuhkan persaingan |
Pengaturan kooperatif sering diformalkan secara matematis sebagai Dec-POMDP (Decentralized Partially Observable MDP), di mana setiap orang bertujuan untuk serangkaian kebijakan optimal yang sama. Pengaturan kompetitif dievaluasi menggunakan konsep yang mendekati keseimbangan Nash dalam teori permainan, di mana satu "kebijakan optimal" mungkin bahkan tidak ada — karena ketika kebijakan lawan berubah, apa yang optimal untuk Anda juga berubah. Pengaturan campuran adalah yang paling dekat dengan kenyataan, tetapi memiliki jaminan teoritis paling sedikit.
3. CTDE: Pelatihan Terpusat, Eksekusi Diserahkan ke Lapangan
CTDE (Pelatihan Terpusat dengan Desentralisasi) CTDE (Execution) banyak digunakan untuk menangani non-stasioneritas. Selama pelatihan (di dalam simulator, atau selama fase pelatihan offline), Anda diizinkan untuk menggunakan informasi pusat yang melihat pengamatan, tindakan, dan terkadang imbalan setiap agen, semuanya sekaligus. Tetapi pada saat eksekusi (pada perangkat keras nyata, di lingkungan produksi), setiap agen memutuskan tindakannya hanya menggunakan pengamatan lokal dari sensornya sendiri.
Alasan praktis mengapa CTDE berfungsi jelas. Mengingat keterbatasan bandwidth dan latensi komunikasi, seringkali tidak realistis bagi armada robot atau drone nyata untuk beroperasi sambil terus-menerus berbagi status setiap agen. Tetapi di dalam simulator atau server pelatihan, Anda dapat menggunakan semua informasi tanpa perlu khawatir tentang biaya komunikasi. CTDE adalah desain yang memaksimalkan penggunaan "informasi istimewa yang hanya tersedia selama pelatihan," sambil tetap meninggalkan kebijakan yang dapat bertindak secara otonom pada saat eksekusi.
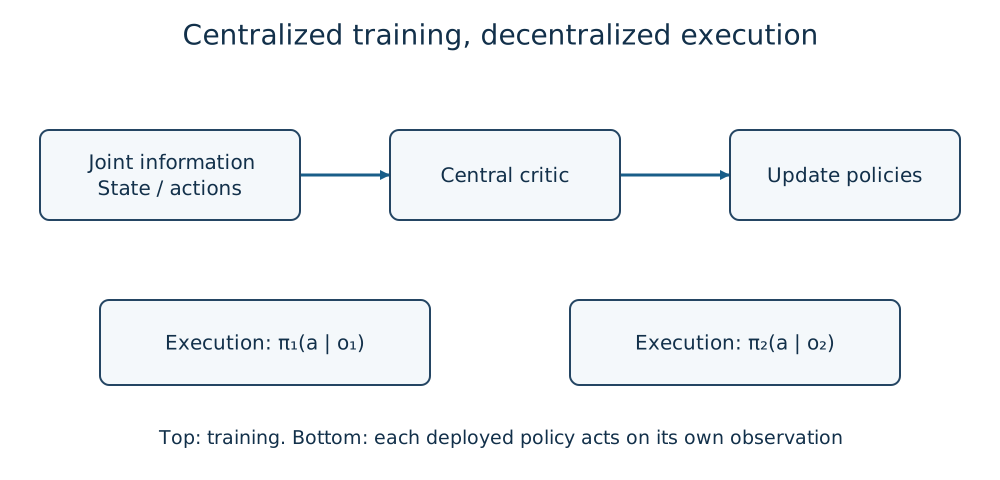
Gambar 2 — Selama pelatihan, kritikus pusat (atau jaringan pencampuran) mengintegrasikan informasi semua orang; pada saat eksekusi, setiap agen memutuskan berdasarkan pengamatan lokal saja. Memisahkan keduanya memungkinkan non-stasioneritas diserap di sisi pelatihan sambil mentolerir kendala komunikasi pada saat eksekusi.
4. Masalah Penugasan Kredit: Siapa yang Sukses, Siapa yang Gagal
Dalam pengaturan kooperatif, ketika yang Anda dapatkan hanyalah satu hadiah bersama r, tidak jelas tindakan agen mana yang sebenarnya berkontribusi pada hadiah tersebut. Berikan setiap agen hadiah yang sama apa adanya, dan agen yang sebenarnya bermalas-malasan menerima evaluasi yang sama "baiknya", sementara sinyal dari agen yang benar-benar berkontribusi terkubur dalam tindakan agen lain. Ini adalah masalah penugasan kredit.
Salah satu pendekatannya adalah dengan menguraikan fungsi nilai menjadi agen-agen individual. QMIX (Rashid dkk., 2018) menggabungkan nilai Q individual setiap agen Q_i(o_i,a_i) menggunakan jaringan pencampuran dengan bobot non-negatif, untuk membangun nilai Q keseluruhan Q_{\text{tot}}.
Kendala monotonisitas ini menjamin bahwa setiap agen yang memilih tindakan yang secara serakah memaksimalkan Q_i miliknya sendiri tidak bertentangan dengan memaksimalkan Q_{\text{tot}} keseluruhan (kondisi IGM: Individual-Global-Max). Dengan kata lain, jaringan pencampuran membangun, selama pelatihan, struktur sedemikian rupa sehingga setiap agen yang bertindak murni berdasarkan nilai Q-nya sendiri pada waktu eksekusi terdesentralisasi tidak menyimpang jauh dari optimum global.
Dari arah yang berbeda, COMA (Foerster et al., 2018) menggunakan dasar kontrafaktual dalam kerangka Aktor-Kritik. Dengan mengambil perbedaan antara imbalan yang diharapkan jika tindakan agen i saja secara hipotetis ditukar dengan tindakan yang berbeda, dan imbalan yang diharapkan untuk tindakan yang sebenarnya dipilih, dan menggunakan itu sebagai keuntungan, ia mengisolasi dan mengevaluasi "seberapa besar tindakan saya sendiri memengaruhi imbalan keseluruhan," terpisah dari kontribusi agen lain.
Yang sama dari kedua metode ini adalah bahwa keduanya merupakan perangkat untuk mengekstrak sinyal pembelajaran untuk setiap agen individu dari satu angka imbalan bersama.
5. Algoritma Representatif
| Algoritma | Keluarga | Pengaturan Utama | Ide Kunci |
|---|---|---|---|
| MADDPG (Lowe dkk., 2017) | Aktor-Kritik (aksi kontinu) | Kooperatif, kompetitif, campuran | Kritik terpusat khusus untuk setiap agen; hanya Aktornya sendiri pada saat eksekusi |
| QMIX (Rashid dkk., 2018) | Berbasis nilai (aksi diskrit) | Kooperatif | Menggabungkan nilai Q individual dengan jaringan pencampuran monotonik, memenuhi kondisi IGM |
| COMA (Foerster dkk., 2018) | Aktor-Kritik | Kooperatif | Secara eksplisit menangani penugasan kredit dengan garis dasar kontrafaktual |
| Pembelajaran independen (Independent Q-Learning / IPPO, dll.) | Perluasan sederhana dari metode agen tunggal | Dapat diterapkan pada apa saja | Mudah diimplementasikan, tetapi mengabaikan non-stasioneritas, sehingga pembelajaran cenderung menjadi tidak stabil |
MADDPG memperluas DDPG ke beberapa agen: setiap agen i menggunakan Critic terpusatnya sendiri Q_i(s,a_1,\dots,a_n) selama pelatihan, dan bertindak hanya menggunakan Actornya sendiri \pi_i(a_i\mid o_i) pada waktu eksekusi. Desain ini memungkinkan kerangka kerja yang sama diterapkan pada struktur penghargaan kooperatif, kompetitif, atau campuran apa pun.
QMIX lebih kuat pada tugas kooperatif aksi diskrit (tolok ukur seperti StarCraft Multi-Agent Challenge) daripada kontrol kontinu, dan sebagai imbalan atas asumsi yang relatif kuat dari kendala monotonisitas, secara teoritis menjamin konsistensi pada waktu eksekusi terdesentralisasi.
"Pembelajaran independen" — metode naif di mana setiap agen hanya mengabaikan keberadaan agen lain dan menjalankan Q-learning atau PPO biasa secara paralel — dapat bekerja dengan sangat baik dalam beberapa kasus. Tetapi karena sama sekali tidak menangani non-stasioneritas, pembelajaran cenderung menyimpang seiring bertambahnya jumlah agen atau kebijakan lawan berubah dengan cepat. Metode keluarga CTDE dapat dipahami sebagai upaya untuk mengurangi masalah yang dimiliki metode naif ini, dengan menggunakan informasi istimewa yang tersedia pada saat pelatihan.
6. Hubungan dengan Kontrol Kawanan Multi-Robot
Kontrol kawanan (sistem multi-robot), di mana beberapa robot fisik bekerja sama secara kooperatif, adalah salah satu area aplikasi MARL. Transportasi gudang, penerbangan formasi beberapa drone, dan pencarian dan penyelamatan kooperatif dengan beberapa unit semuanya memiliki struktur "setiap robot hanya memiliki pengamatan lokal, komunikasi terbatas, dan kita ingin meningkatkan efisiensi keseluruhan" — struktur yang sangat sesuai dengan gagasan CTDE tentang pelatihan terpusat dan eksekusi terdesentralisasi.
Meskipun demikian, kontrol kawanan memiliki banyak elemen yang tidak dapat sepenuhnya ditangani oleh teori pembelajaran MARL saja: jumlah individu yang bervariasi (robot yang keluar atau ditambahkan di tengah misi), topologi komunikasi yang berubah secara dinamis, dan kebutuhan untuk menempatkan batasan keselamatan, seperti penghindaran tabrakan, di luar kebijakan yang dipelajari setiap saat. Situs ini belum memiliki artikel yang khusus membahas kontrol kawanan multi-robot, tetapi MARL diposisikan sebagai salah satu teori dasarnya.
7. Daftar Periksa Implementasi dan Evaluasi
- Apakah Anda telah memisahkan dan mencatat dengan jelas pengamatan, tindakan, dan imbalan setiap agen untuk waktu pelatihan (dengan informasi pusat) dibandingkan dengan waktu eksekusi (hanya pengamatan lokal)?
- Apakah Anda telah terlebih dahulu menentukan apakah imbalannya bersifat kooperatif, kompetitif, atau campuran, dan memilih algoritma yang sesuai (keluarga QMIX, keluarga MADDPG, atau pembelajaran independen)?
-
Apakah Anda telah melacak kurva pembelajaran tidak hanya sebagai imbalan keseluruhan tetapi juga berdasarkan kontribusi per agen, rasio tindakan, dan tingkat keberhasilan individu, untuk memastikan tidak ada satu agen pun yang hanya bermalas-malasan dalam pembelajarannya?
-
Apakah Anda telah melakukan evaluasi dalam kondisi dengan jumlah agen atau topologi yang berbeda, untuk memastikan Anda tidak mengalami overfitting pada jumlah agen selama pelatihan?
-
Untuk perangkat keras dan lingkungan nyata, apakah Anda telah mengasumsikan latensi dan putus komunikasi, dan telah memastikan bahwa setiap agen dapat kembali ke perilaku aman bahkan selama gangguan komunikasi (dengan batasan keselamatan yang tetap berada di luar kebijakan yang dipelajari)?
Ringkasan
Pembelajaran penguatan multi-agen dimulai pada titik di mana asumsi implisit dari MDP agen tunggal — "lingkungan tetap" — tidak berlaku. Ketidakstasioneran, di mana pembelajaran agen lain terus mengubah apa yang dianggap sebagai lingkungan Anda sendiri; perbedaan antara struktur penghargaan kooperatif, kompetitif, dan campuran; dan masalah penugasan kredit tentang bagaimana mendistribusikan penghargaan bersama di antara kontribusi individu — CTDE adalah jawaban praktis untuk semua ini, dan MADDPG dan QMIX adalah realisasi konkretnya. Dalam aplikasi yang melibatkan banyak agen fisik, seperti kontrol kawanan multi-robot, perlu juga diingat bahwa tantangan tingkat implementasi — jumlah individu yang bervariasi, komunikasi dinamis, dan batasan keselamatan — menumpuk di atas teori pembelajaran.
Bisakah metode agen tunggal ditransfer tanpa perubahan ke banyak agen?
Agen pembelajaran lain mengubah lingkungan.
Membedakan kerja sama, persaingan, batasan pengamatan, dan informasi pelatihan versus eksekusi.Referensi
- Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (NeurIPS, 2017)
- Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning (ICML, 2018)
- Foerster et al., Counterfactual Multi-Agent Policy Gradients (AAAI, 2018)
- OpenAI Spinning Up — Key Concepts in RL
- [The Basics of Reinforcement] Pembelajaran Dasar Penguatan, Pengantar Q-Learning dan DQN, Pengantar Gradien Kebijakan/PPO/SAC
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.