Contents — find the section you need
Os artigos Os fundamentos do aprendizado por reforço e Aprendizado Q e DQN, abordados até agora, pressupõem um MDP (Processo de Decisão de Markov) no qual o ambiente reage a apenas um único agente. No entanto, existem diversos cenários em que múltiplos agentes atuam sobre o ambiente simultaneamente — múltiplos robôs de transporte em um armazém, jogos competitivos, um enxame de drones compartilhando tarefas de comunicação. O Aprendizado por Reforço Multiagente (MARL) lida com uma dificuldade que não existe no aprendizado por reforço de agente único: nesse cenário, todos, exceto você, também estão aprendendo e em constante mudança.
Os fundamentos do aprendizado por reforço ## Resumo de 30 segundos
-
Em um MDP de agente único, a probabilidade de transição do ambiente P(s'\mid s,a) é fixa, mas em um ambiente multiagente onde outros agentes também estão aprendendo e alterando suas políticas, o que um agente específico vê como "o ambiente" muda ao longo do tempo — isso é chamado de não estacionariedade.
-
Os cenários são amplamente divididos em cooperativo (todos maximizam uma recompensa compartilhada), competitivo (semelhante a um jogo de soma zero, onde o objetivo é vencer um oponente) e misto (parcialmente cooperativo, parcialmente competitivo), e o algoritmo necessário muda de acordo.
-
CTDE (Treinamento Centralizado com Execução Descentralizada) — onde o aprendizado usa informações globais, mas a execução faz com que cada agente aja com base em suas próprias observações — é a estrutura principal que é prática para hardware e ambientes reais.
-
Como distribuir uma recompensa compartilhada entre as contribuições individuais dos agentes — o problema de atribuição de crédito — é o maior desafio técnico no aprendizado multiagente cooperativo. - MADDPG (Lowe et al., 2017) e QMIX (Rashid et al., 2018) são algoritmos representativos que concretizam o CTDE, do ponto de vista da fatoração Ator-Crítico e do valor Q, respectivamente.
1. Por que o modelo de agente único falha?
A premissa central do MDP era que a transição P(s'\mid s,a) e a recompensa R(s,a,s') do ambiente são fixas, independentes da política do agente. Mesmo quando o agente atualiza sua política, as leis físicas do próprio ambiente não mudam.
Em um ambiente com múltiplos agentes, essa premissa deixa de ser válida. O que o agente i vê como "o ambiente" agora inclui não apenas as leis da física, mas também as políticas \pi_{-i} dos outros agentes -i (todos, exceto i). Como os outros agentes também estão aprendendo simultaneamente e atualizando continuamente \pi_{-i}, a probabilidade efetiva de transição que o agente i experimenta,
muda a cada vez que \pi_{-i} muda. Isso é não estacionariedade. Da perspectiva do agente i, uma ação que funcionou bem ontem pode não funcionar hoje, agora que a política do outro lado mudou. Mesmo armazenar transições antigas em um buffer de repetição pode ser ativamente enganoso — essa experiência foi adquirida contra um oponente que "não existe mais".

Figura 1 — O que "o ambiente" representa para o agente i inclui não apenas as leis da física, mas também as políticas dos outros agentes. Enquanto os outros continuarem aprendendo, a distribuição de transição que i experimenta continuará se movendo.
2. Cooperativo, Competitivo e Misto: A Estrutura de Recompensas Molda o Problema
A natureza de um problema multiagente muda drasticamente dependendo de como a recompensa é atribuída.
| Cenário | Relação de Recompensas | Exemplo Representativo | Dificuldade Principal |
|---|---|---|---|
| Cooperativo | Todos maximizam uma recompensa comum ou altamente correlacionada | Vários robôs de armazém maximizando a eficiência do transporte | Atribuição de créditos, projeto de comunicação |
| Competitivo | Um O ganho de um lado é a perda do outro (quase soma zero) | Jogos competitivos, simulações de competição de preços | Deve-se acompanhar a adaptação do oponente, equilíbrios instáveis |
| Misto / soma geral | Parcialmente cooperativo, parcialmente adversário | Vários veículos em um cruzamento, robôs cooperativos competindo por um recurso | Alternando entre situações que exigem cooperação e situações que exigem competição |
Os cenários cooperativos são frequentemente formalizados matematicamente como um Dec-POMDP (MDP Parcialmente Observável Descentralizado), onde todos buscam o mesmo conjunto de políticas ótimas. Os cenários competitivos são avaliados usando conceitos próximos ao equilíbrio de Nash na teoria dos jogos, onde uma única "política ótima" pode nem existir — porque, à medida que a política do oponente muda, o que é ótimo para você também muda. Os cenários mistos são os mais próximos da realidade, mas oferecem as menores garantias teóricas.
3. CTDE: Treinamento Centralizado, Execução Deixada para o Campo
CTDE (Treinamento Centralizado com Execução Descentralizada) é amplamente utilizado para lidar com Não estacionariedade. Durante o treinamento (dentro de um simulador ou durante uma fase de treinamento offline), você pode usar informações centrais que visualizam as observações, ações e, às vezes, recompensas de cada agente, tudo ao mesmo tempo. Mas, no momento da execução (em hardware real, em um ambiente de produção), cada agente decide sua ação usando apenas a observação local de seus próprios sensores.
A razão prática pela qual o CTDE funciona é clara. Dadas as restrições de largura de banda e latência de comunicação, muitas vezes é inviável para uma frota real de robôs ou drones operar compartilhando constantemente o estado de cada agente. Mas, dentro de um simulador ou servidor de treinamento, você pode usar todas as informações sem se preocupar com o custo da comunicação. O CTDE é um projeto que maximiza o uso dessas "informações privilegiadas disponíveis apenas durante o treinamento", ao mesmo tempo que mantém uma política que pode agir autonomamente no momento da execução.
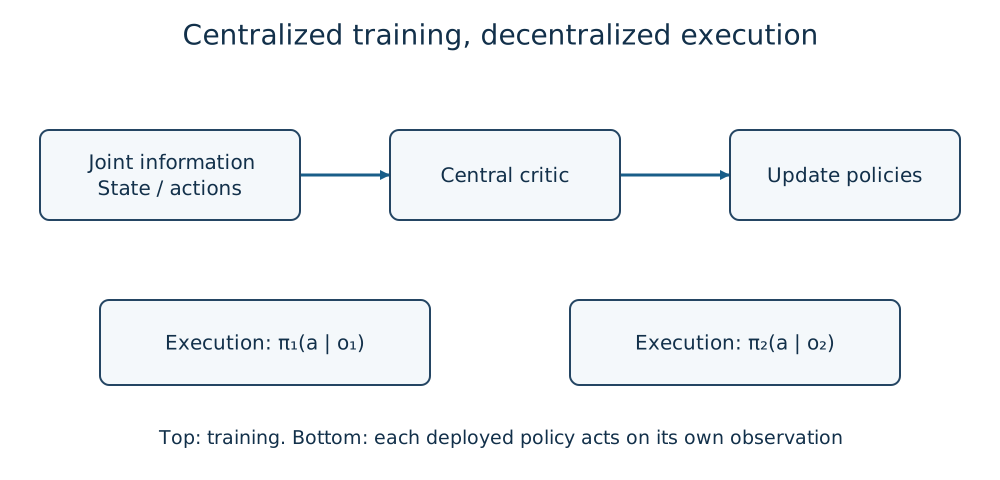
Figura 2 — Durante o treinamento, um crítico central (ou rede de mistura) integra as informações de todos; no momento da execução, cada agente decide com base apenas na observação local. Separar os dois permite que a não estacionariedade seja absorvida no lado do treinamento, enquanto tolera as restrições de comunicação no momento da execução.
4. O Problema da Atribuição de Crédito: De Quem é o Sucesso, De Quem é o Fracasso
Em um ambiente cooperativo, quando tudo o que você recebe é uma única recompensa compartilhada r, não é evidente qual das ações dos agentes n realmente contribuiu para essa recompensa. Dê a todos os agentes a mesma recompensa, e um agente que estava realmente ocioso receberá uma avaliação tão "boa" quanto qualquer outro, enquanto o sinal de um agente que genuinamente contribuiu fica obscurecido pelas ações dos outros. Este é o problema da atribuição de crédito. Uma abordagem consiste em decompor a função de valor em agentes individuais. O QMIX (Rashid et al., 2018) combina o valor Q individual de cada agente Q_i(o_i,a_i) usando uma rede de mistura com pesos não negativos, para construir o valor Q geral Q_{\text{tot}}.
Essa restrição de monotonicidade garante que cada agente que escolhe a ação que maximiza avidamente seu próprio Q_i não entre em conflito com a maximização do Q_{\text{tot}} geral (a condição IGM: Individual-Global-Max). Em outras palavras, a rede de mistura constrói, durante o treinamento, uma estrutura tal que cada agente que age puramente com base em seu próprio valor Q no momento da execução descentralizada não se afasta muito do ótimo global.
Em uma direção diferente, o COMA (Foerster et al., 2018) utiliza uma linha de base contrafactual dentro de uma estrutura Ator-Crítico. Ao calcular a diferença entre a recompensa esperada se a ação do agente i fosse hipoteticamente trocada por outra ação, e a recompensa esperada para a ação realmente escolhida, e usando essa diferença como vantagem, o algoritmo isola e avalia "o quanto minha própria ação influenciou a recompensa geral", separadamente das contribuições dos outros agentes.
O que ambos os métodos têm em comum é que são mecanismos para extrair um sinal de aprendizado para cada agente individual a partir de um único valor de recompensa compartilhada.
5. Algoritmos Representativos
| Algoritmo | Família | Contexto Principal | Ideia Principal |
|---|---|---|---|
| MADDPG (Lowe et al., 2017) | Ator-Crítico (ação contínua) | Cooperativo, competitivo, misto | Um Crítico centralizado dedicado por agente; apenas seu próprio Ator no momento da execução |
| QMIX (Rashid et al., 2018) | Baseado em valor (ação discreta) | Cooperativo | Combina valores Q individuais com uma rede de mistura monotônica, satisfazendo a condição IGM |
| COMA (Foerster et al., 2018) | Ator-Crítico | Cooperativo | Lida explicitamente com a atribuição de crédito com uma linha de base contrafactual |
| Aprendizado independente (Aprendizado Q independente / IPPO, etc.) | Extensão ingênua de métodos de agente único | Aplicável a qualquer coisa | Simples de implementar, mas ignora a não estacionariedade, então o aprendizado tende a se tornar instável |
O MADDPG estende o DDPG para múltiplos agentes: cada agente i utiliza seu próprio Crítico centralizado dedicado Q_i(s,a_1,\dots,a_n) durante o treinamento e age utilizando apenas seu próprio Ator \pi_i(a_i\mid o_i) no momento da execução. Esse design permite que a mesma estrutura seja aplicada a qualquer uma das estruturas de recompensa cooperativa, competitiva ou mista.
O QMIX é mais eficiente em tarefas cooperativas de ação discreta (benchmarks como o Desafio Multiagente de StarCraft) do que em controle contínuo e, em troca da suposição relativamente forte da restrição de monotonicidade, teoricamente garante consistência no momento da execução descentralizada.
A "aprendizagem independente" — o método ingênuo em que cada agente simplesmente ignora a existência dos outros agentes e executa o Q-learning ou PPO em paralelo — pode funcionar surpreendentemente bem em alguns casos. Mas, como não aborda a não estacionariedade, a aprendizagem tende a divergir à medida que o número de agentes aumenta ou as políticas dos oponentes mudam rapidamente. Os métodos da família CTDE podem ser entendidos como uma tentativa de mitigar os problemas desse método ingênuo, utilizando informações privilegiadas disponíveis durante o treinamento.
6. Relação com o Controle de Enxames Multi-Robôs
O controle de enxames (sistemas multi-robôs), onde múltiplos robôs físicos trabalham juntos de forma cooperativa, é uma das áreas de aplicação do MARL. Transporte em armazéns, voo em formação de múltiplos drones e busca e resgate cooperativos com múltiplas unidades compartilham a estrutura de "cada robô possui apenas observações locais, a comunicação é limitada e busca-se melhorar a eficiência geral" — uma estrutura que se encaixa bem na ideia do CTDE de treinamento centralizado e execução descentralizada.
Dito isso, o controle de enxames possui muitos elementos que a teoria de aprendizado do MARL sozinha não consegue lidar completamente: um número variável de indivíduos (robôs saindo ou sendo adicionados no meio da missão), uma topologia de comunicação que muda dinamicamente e a necessidade de impor restrições de segurança, como a prevenção de colisões, fora da política aprendida em todos os momentos. Este site ainda não possui um artigo dedicado ao controle de enxames multi-robôs em si, mas o MARL é apresentado como uma de suas teorias fundamentais.
7. Lista de Verificação de Implementação e Avaliação
-
Você separou e registrou claramente as observações, ações e recompensas de cada agente durante o tempo de treinamento (com informações centrais) versus o tempo de execução (apenas observação local)?
-
Você definiu se a recompensa é cooperativa, competitiva ou mista e escolheu um algoritmo adequado (da família QMIX, da família MADDPG ou aprendizado independente)?
-
Você acompanhou a curva de aprendizado não apenas como uma recompensa geral, mas também pela contribuição de cada agente, taxa de ação e taxa de sucesso individual, para confirmar que nenhum agente está simplesmente negligenciando seu aprendizado?
-
Você avaliou o modelo em condições com diferentes números de agentes ou topologias, para confirmar que não houve sobreajuste ao número de agentes durante o treinamento? Para hardware e ambientes reais, você considerou a latência e a perda de comunicação e confirmou que cada agente pode recorrer a um comportamento seguro mesmo durante uma interrupção de comunicação (com as restrições de segurança mantidas fora da política aprendida)?
Resumo
O aprendizado por reforço multiagente começa no ponto em que a suposição implícita de um MDP de agente único — "o ambiente é fixo" — deixa de ser válida. A não estacionariedade, onde o aprendizado dos outros agentes altera constantemente o que conta como seu próprio ambiente; a diferença entre estruturas de recompensa cooperativas, competitivas e mistas; e o problema de atribuição de crédito, ou seja, como distribuir uma recompensa compartilhada entre as contribuições individuais — o CTDE é a resposta prática para todos esses problemas, e o MADDPG e o QMIX são suas implementações concretas. Em aplicações que envolvem múltiplos agentes físicos, como o controle de enxames de robôs, também é importante lembrar que os desafios de implementação — um número variável de indivíduos, comunicação dinâmica e restrições de segurança — se somam à teoria do aprendizado.
Um método de agente único pode ser transferido sem alterações para vários agentes?
Outros agentes de aprendizado alteram o ambiente. Distinguir entre cooperação, competição, limites de observação e informações de treinamento versus execução.
Referências
- Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (NeurIPS, 2017)
- Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning (ICML, 2018)
- Foerster et al., Counterfactual Multi-Agent Policy Gradients (AAAI, 2018)
- OpenAI Spinning Up — Key Concepts in RL
- [The Basics of Reinforcement Aprendizagem, Introdução ao Q-Learning e DQN, Introdução ao Gradiente de Política/PPO/SAC
Comentários
Entre na sua conta para continuar.
Ainda não há dados.