Contents — find the section you need
目前为止介绍的强化学习基础知识(/zh/blog/posts/reinforcement-learning-basics.html)和 Q 学习与 DQN(/zh/blog/posts/reinforcement-q-learning-dqn.html)假设环境仅对单个智能体做出反应,而模型则是一个马尔可夫决策过程(MDP)。然而,在许多场景中,多个智能体同时作用于环境——例如仓库中的多个运输机器人、竞技游戏、以及共享通信任务的无人机群。多智能体强化学习(MARL)解决了单智能体强化学习中不存在的难题:在这种情况下,除了你之外的每个智能体都在学习,并且不断变化。
30 秒概要
-
在单智能体马尔可夫决策过程 (MDP) 中,环境的转移概率 P(s'\mid s,a) 是固定的。但在多智能体环境中,由于其他智能体也在学习并改变策略,因此每个智能体所感知到的“环境”会随时间变化——这被称为非平稳性。
-
系统设置大致可分为合作型(所有智能体最大化共享奖励)、竞争型(类似零和博弈,目标是击败对手)和混合型(部分合作,部分竞争),所需的算法也会相应变化。
-
集中式训练与分散式执行 (CTDE)——其中学习过程使用全局信息,但执行过程中每个智能体仅根据自身的观测结果采取行动——是适用于真实硬件和真实环境的主流框架。
-
如何在各个智能体的贡献之间分配共享奖励——即积分分配问题——是合作式多智能体强化学习 (MARL) 中最大的技术挑战。
MADDPG(Lowe 等人,2017)和 QMIX(Rashid 等人,2018)分别是从 Actor-Critic 和 Q 值分解的角度具体化 CTDE 的代表性算法。
1. 为什么单智能体框架会失效?
MDP 的核心假设是环境的转移 P(s'\mid s,a) 和奖励 R(s,a,s') 是固定的,与智能体的策略无关。即使智能体更新了其策略,环境本身的物理规律也不会改变。
在多智能体环境中,这个前提不再成立。智能体 i 所看到的“环境”现在不仅包含物理规律,还包含其他智能体 -i(除 i 之外的所有智能体)的策略 \pi_{-i}。由于其他智能体也在同步学习并不断更新\pi_{-i},智能体i所经历的有效转移概率,
会随着\pi_{-i}的每次变化而改变。这就是非平稳性。从智能体i的角度来看,昨天有效的策略今天可能就失效了,因为对方的策略已经改变。即使将旧的转移存储在回放缓冲区中,也可能产生误导——因为这些经验是针对一个“已不存在”的对手积累的。

图 1 — 对于智能体 i 而言,“环境”不仅包括物理定律,还包括其他智能体的策略。只要其他智能体持续学习,智能体 i 所经历的转移分布就会持续变化。
2. 合作、竞争和混合:奖励结构塑造问题
多智能体问题的特征会根据奖励的分配方式而发生显著变化。
| 设置 | 奖励关系 | 代表性示例 | 主要难点 |
|---|---|---|---|
| 合作 | 所有智能体最大化共同或高度相关的奖励 | 多个仓库机器人最大化运输效率 | 信用分配、通信设计 |
| 竞争 | 一个一方的收益即是另一方的损失(接近零和博弈) | 竞争博弈,价格竞争模拟 | 必须追踪对手的调整,不稳定均衡 |
| 混合/一般和博弈 | 部分合作,部分对抗 | 多车在十字路口,合作机器人争夺资源 | 在需要合作和需要竞争的情境之间切换 |
合作情境通常在数学上被形式化为 Dec-POMDP(去中心化部分可观测马尔可夫决策过程),其中每个人都以同一组最优策略为目标。竞争情境则使用接近博弈论中纳什均衡的概念进行评估,其中可能根本不存在单一的“最优策略”——因为随着对手策略的变化,你的最优策略也会随之改变。混合情境最接近现实,但理论保证最少。
3. CTDE:集中式训练,执行交给现场
**CTDE(集中式训练,去中心化执行) CTDE(执行)广泛用于处理非平稳性。在训练期间(在模拟器中或离线训练阶段),您可以同时使用集中信息,该信息涵盖每个智能体的观测值、动作以及有时的奖励。但在执行时(在实际硬件上,在生产环境中),每个智能体仅使用来自自身传感器的本地观测值来决定其动作。
CTDE 的工作原理显而易见。考虑到通信带宽和延迟的限制,对于实际的机器人或无人机集群来说,持续共享每个智能体的状态通常是不现实的。但在模拟器或训练服务器中,您可以利用所有信息而无需担心通信成本。CTDE 的设计充分利用了这些“仅在训练期间可用的特权信息”,同时仍然保留了能够在执行时自主行动的策略。
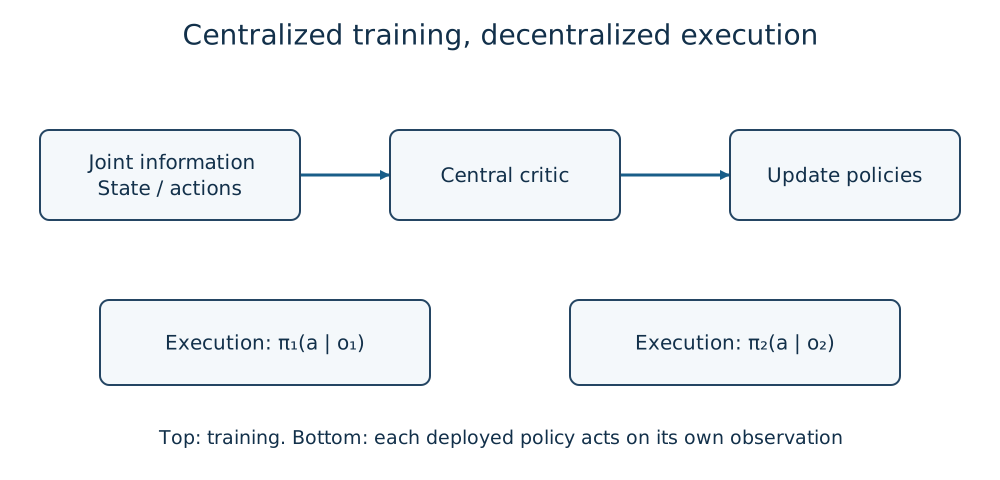
图 2 — 在训练过程中,中央评论家(或混合网络)整合所有参与者的信息;在执行阶段,每个智能体仅基于局部观察做出决策。将两者分离,可以在训练阶段吸收非平稳性,同时容忍执行阶段的通信约束。
4. 功劳分配问题:谁的成功,谁的失败
在合作环境中,当只有一个共享奖励r时,很难确定n个智能体中哪些行为真正促成了该奖励。如果给每个智能体相同的奖励,那么一个实际上在偷懒的智能体也会得到同样“好”的评价,而真正做出贡献的智能体的信号则会被其他智能体的行为所掩盖。这就是信用分配问题。
一种方法是将价值函数分解为各个个体。QMIX(Rashid 等人,2018)使用具有非负权重的混合网络,将每个个体的 Q 值 Q_i(o_i,a_i) 组合起来,构建整体 Q 值 Q_{\text{tot}}。
这种单调性约束保证了每个个体选择贪婪地最大化自身 Q_i 的行动,不会与最大化整体 Q_{\text{tot}} 相冲突(IGM:个体-全局-最大化条件)。换句话说,混合网络在训练过程中构建了一种结构,使得每个个体在分散执行时仅基于自身 Q 值行动,其策略不会偏离全局最优解太远。
COMA(Foerster 等人,2018)则另辟蹊径,在 Actor-Critic 框架内使用反事实基线。它通过计算智能体 i 单独行动被替换为其他行动时的预期奖励,与实际选择行动的预期奖励之间的差值,并将此差值作为优势,从而分离并评估“我自身的行动对整体奖励的影响程度”,使其与其他智能体的贡献区分开来。
这两种方法的共同之处在于,它们都是从单一的共享奖励值中提取每个智能体学习信号的工具。
5. 代表性算法
| 算法 | 算法族 | 主要场景 | 核心思想 |
|---|---|---|---|
| MADDPG(Lowe 等人,2017) | Actor-Critic(连续行动) | 合作、竞争、混合 | 每个智能体拥有一个专用的集中式 Criter;执行时仅包含其自身的 Actor |
| QMIX(Rashid 等人,2018) | 基于值(离散行动) | 合作 | 将个体 Q 值与单调混合网络相结合,满足 IGM 条件 |
| COMA(Foerster 等人,2018) | Actor-Critic | 合作 | 使用反事实基线显式处理信用分配 |
| 独立学习(独立 Q 学习/IPPO 等) | 单智能体方法的简单扩展 | 适用于任何场景 | 易于实现,但忽略了非平稳性,因此学习容易变得不稳定 |
MADDPG 将 DDPG 扩展到多个智能体:每个智能体 i 在训练期间使用其专用的集中式 Critic Q_i(s,a_1,\dots,a_n),并在执行时仅使用其自身的 Actor \pi_i(a_i\mid o_i) 进行行动。这种设计使得同一框架可以应用于任何合作、竞争或混合奖励结构。
QMIX 在离散动作合作任务(例如星际争霸多智能体挑战赛等基准测试)上的表现优于连续控制,并且作为对单调性约束的较强假设的交换,它在理论上保证了分散执行时的一致性。
“独立学习”——一种朴素的方法,其中每个智能体简单地忽略其他智能体的存在,并并行运行普通的 Q 学习或 PPO——在某些情况下可能效果出奇地好。但由于它完全没有处理非平稳性,因此随着智能体数量的增加或对手策略的快速变化,学习往往会发散。 CTDE 系列方法可以理解为利用训练时可获得的特殊信息来缓解这种简单方法所存在问题的尝试。
6. 与多机器人集群控制的关系
集群控制(多机器人系统)是指多个物理机器人协同工作,是多机器人强化学习(MARL)的应用领域之一。仓库运输、多架无人机编队飞行以及多单元协同搜救等都具有“每个机器人仅拥有局部观测数据,通信受限,且我们希望提高整体效率”的结构——这种结构与 CTDE 的集中式训练和分散式执行理念非常契合。
然而,集群控制包含许多仅靠 MARL 学习理论无法完全解决的因素:例如,机器人数量可变(任务中途机器人可能退出或加入)、动态变化的通信拓扑结构,以及始终需要在学习策略之外设置安全约束(例如避障)。本网站目前还没有专门介绍多机器人集群控制的文章,但多智能体强化学习(MARL)是其基础理论之一。
7. 实现与评估清单
-
您是否已清晰地分离并记录了每个智能体在训练时间(包含中心信息)和执行时间(仅包含局部观察)的观察结果、动作和奖励?
-
您是否已首先定义奖励是合作型、竞争型还是混合型,并选择了与之匹配的算法(例如 QMIX 系列、MADDPG 系列或独立学习)?
-
您是否不仅跟踪了总体奖励,还跟踪了每个智能体的贡献、动作比例和个体成功率,以确保没有单个智能体在学习过程中懈怠?
-
您是否已在不同智能体数量或拓扑结构下进行评估,以确保模型没有过度拟合训练时间的智能体数量?
-
对于真实的硬件和环境,您是否考虑了通信延迟和丢包,并确认每个智能体即使在通信中断期间也能回退到安全行为(安全约束被置于学习策略之外)?
总结
多智能体强化学习始于单智能体马尔可夫决策过程(MDP)的隐含假设——“环境是固定的”——失效之处。非平稳性,即其他智能体的学习会不断改变自身环境的定义;合作、竞争和混合奖励结构之间的差异;以及如何将共享奖励分配给各个智能体的贡献——CTDE 是所有这些问题的实用解决方案,而 MADDPG 和 QMIX 则是其具体实现。在涉及多个物理智能体的应用中,例如多机器人集群控制,还应注意实现层面的挑战——个体数量可变、动态通信和安全约束——会叠加在学习理论之上。
单智能体方法能否原封不动地迁移到多智能体?
其他学习智能体会改变环境。
区分合作、竞争、观察限制以及训练信息与执行信息。
评论
请先登录。
暂无数据。