Contents — find the section you need
Die bisher behandelten Grundlagen des Reinforcement Learning (RL) und Q-Learning sowie DQN gingen von einem Markov-Entscheidungsprozess (MDP) aus, in dem die Umgebung nur auf einen einzigen Agenten reagiert. Es gibt jedoch zahlreiche Anwendungsfälle, in denen mehrere Agenten gleichzeitig auf die Umgebung einwirken – beispielsweise mehrere Transportroboter in einem Lager, Wettkampfspiele oder ein Drohnenschwarm, der sich die Kommunikationsaufgaben teilt. Multi-Agent Reinforcement Learning (MARL) begegnet einer Schwierigkeit, die beim Single-Agent RL nicht auftritt: In diesem Szenario lernt jeder außer dem Agenten selbst und verändert sich ständig.
Die 30-Sekunden-Zusammenfassung
-
In einem Einzelagenten-MDP ist die Übergangswahrscheinlichkeit P(s'\mid s,a) der Umgebung fixiert. In einer Mehragentenumgebung, in der andere Agenten ebenfalls lernen und ihre Strategien anpassen, ändert sich die Wahrnehmung der Umgebung durch einen einzelnen Agenten im Laufe der Zeit – dies wird als Nicht-Stationarität bezeichnet.
-
Die Einstellungen lassen sich grob in kooperativ (jeder maximiert eine gemeinsame Belohnung), kompetitiv (Nullsummenspiel, ein Gegner wird besiegt) und gemischt (teils kooperativ, teils kompetitiv) unterteilen. Der benötigte Algorithmus ändert sich entsprechend.
-
CTDE (Centralized Training with Decentralized Execution) – bei dem das Lernen globale Informationen nutzt, die Ausführung aber von jedem Agenten auf Basis seiner eigenen Beobachtungen durchgeführt wird – ist das gängigste Framework, das sich für reale Hardware und reale Umgebungen bewährt hat.
-
Die Verteilung einer gemeinsamen Belohnung auf die Beiträge der einzelnen Agenten – das Problem der Gutschriftzuweisung – ist die größte technische Herausforderung im kooperativen MARL.
MADDPG (Lowe et al., 2017) und QMIX (Rashid et al., 2018) sind repräsentative Algorithmen, die CTDE konkretisieren, und zwar aus der Perspektive der Akteur-Kritiker- bzw. der Q-Wert-Faktorisierung.
1. Warum versagt das Einzelagenten-Framework?
Die zentrale Annahme des MDP war, dass die Transition P(s'\mid s,a) und die Belohnung R(s,a,s') der Umgebung unabhängig von der Agentenstrategie feststehen. Selbst wenn der Agent seine Strategie aktualisiert, ändern sich die physikalischen Gesetze der Umgebung nicht.
In einer Umgebung mit mehreren Agenten ist diese Annahme nicht mehr gültig. Was Agent i als „Umgebung“ wahrnimmt, umfasst nun nicht nur die physikalischen Gesetze, sondern auch die Strategien \pi_{-i} der anderen Agenten -i (alle außer i). Da die anderen Agenten ebenfalls gleichzeitig lernen und \pi_{-i} kontinuierlich aktualisieren, ändert sich die effektive Übergangswahrscheinlichkeit, die Agent i erfährt,
jedes Mal, wenn sich \pi_{-i} ändert. Dies ist Nicht-Stationarität. Aus der Perspektive von Agent i kann eine Aktion, die gestern noch erfolgreich war, heute wirkungslos sein, da sich die Strategie des Gegners geändert hat. Selbst das Speichern alter Übergänge in einem Wiedergabepuffer kann irreführend sein – diese Erfahrung wurde gegen einen Gegner gesammelt, der „nicht mehr existiert“.

Abbildung 1 – Die „Umgebung“ für Agent i umfasst nicht nur physikalische Gesetze, sondern auch die Richtlinien der anderen Agenten. Solange die anderen lernen, ändert sich die Übergangsverteilung, die Agent i erlebt.
2. Kooperativ, kompetitiv und gemischt: Die Belohnungsstruktur prägt das Problem
Der Charakter eines Multiagentenproblems ändert sich dramatisch, je nachdem, wie die Belohnung zugewiesen wird.
| Setting | Belohnungsbeziehung | Repräsentatives Beispiel | Hauptschwierigkeit |
|---|---|---|---|
| Kooperativ | Alle maximieren eine gemeinsame oder stark korrelierte Belohnung | Mehrere Lagerroboter maximieren die Transporteffizienz | Gutschriftvergabe, Kommunikationsdesign |
| Kompetitiv | Der Gewinn einer Seite ist der Gewinn der Verlust anderer (nahezu Nullsummenspiel) | Wettbewerbsspiele, Preiswettbewerbssimulationen | Anpassung des Gegners muss berücksichtigt werden, instabile Gleichgewichte |
Gemischte/allgemeine Summenspiele | Teilweise kooperativ, teilweise konfrontativ | Mehrere Fahrzeuge an einer Kreuzung, kooperative Roboter konkurrieren um eine Ressource | Wechsel zwischen Situationen, die Kooperation erfordern, und Situationen, die Wettbewerb erfordern |
Kooperative Szenarien werden oft mathematisch als Dec-POMDP (Decentralized Partially Observable MDP) formalisiert, bei dem alle die gleichen optimalen Strategien anstreben. Wettbewerbssituationen werden anhand von Konzepten der Spieltheorie, die dem Nash-Gleichgewicht nahekommen, bewertet, wobei eine einzige „optimale Strategie“ möglicherweise gar nicht existiert – denn mit der Strategie des Gegners ändert sich auch das, was für einen selbst optimal ist. Gemischte Szenarien kommen der Realität am nächsten, bieten aber die wenigsten theoretischen Garantien.
3. CTDE: Zentralisiertes Training, Ausführung dem Feld überlassen
CTDE (Zentralisiertes Training mit dezentraler Ausführung) wird häufig verwendet, um mit Nichtstationarität umzugehen. Während Beim Training (in einem Simulator oder während einer Offline-Trainingsphase) können Sie zentrale Informationen nutzen, die die Beobachtungen, Aktionen und teilweise auch die Belohnungen aller Agenten gleichzeitig erfassen. Zur Laufzeit (auf realer Hardware in einer Produktionsumgebung) entscheidet jedoch jeder Agent seine Aktion ausschließlich anhand der lokalen Beobachtungen seiner eigenen Sensoren.
Der praktische Grund für die Funktionsweise von CTDE liegt auf der Hand. Aufgrund von Bandbreiten- und Latenzbeschränkungen ist es für eine reale Roboter- oder Drohnenflotte oft unrealistisch, ständig den Zustand jedes einzelnen Agenten auszutauschen. In einem Simulator oder auf einem Trainingsserver hingegen können Sie alle Informationen nutzen, ohne sich Gedanken über die Kommunikationskosten machen zu müssen. CTDE ist ein Design, das diese „privilegierten Informationen, die nur während des Trainings verfügbar sind“, optimal nutzt und gleichzeitig eine Strategie implementiert, die zur Laufzeit autonom agieren kann.
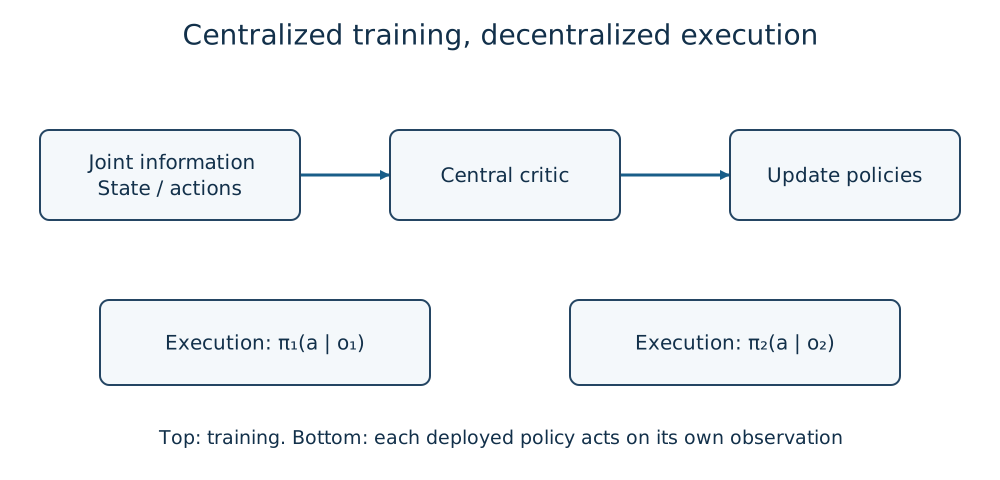
Abbildung 2 – Während des Trainings integriert ein zentraler Kritiker (oder ein Mischnetzwerk) die Informationen aller Agenten; zur Ausführungszeit entscheidet jeder Agent ausschließlich auf Basis lokaler Beobachtungen. Durch die Trennung der beiden Prozesse kann Nichtstationarität auf der Trainingsseite absorbiert werden, während gleichzeitig Kommunikationsbeschränkungen zur Ausführungszeit toleriert werden.
4. Das Problem der Gutschrift: Wessen Erfolg, wessen Misserfolg
In einem kooperativen Umfeld, in dem es nur eine gemeinsame Belohnung gibt, ist es nicht offensichtlich, welche Aktionen der Agenten tatsächlich zu dieser Belohnung beigetragen haben. Erhält jeder Agent die gleiche Belohnung, erhält ein Agent, der tatsächlich faul war, eine ebenso „gute“ Bewertung, während das Signal eines Agenten, der tatsächlich beigetragen hat, in den Aktionen der anderen untergeht. Dies ist das Problem der Gutschrift.
Ein Ansatz besteht darin, die Wertfunktion in einzelne Agenten zu zerlegen. QMIX (Rashid et al., 2018) kombiniert die individuellen Q-Werte Q_i(o_i,a_i) jedes Agenten mithilfe eines Mischnetzwerks mit nicht-negativen Gewichten, um den Gesamt-Q-Wert Q_{\text{tot}} zu bilden.
Diese Monotoniebedingung garantiert, dass die Wahl der Aktion eines Agenten, die seinen eigenen Q-Wert Q_i maximiert, nicht mit der Maximierung des Gesamt-Q-Werts Q_{\text{tot}} (der IGM-Bedingung: Individuell-Global-Maximum) kollidiert. Anders ausgedrückt: Das Mischnetzwerk integriert während des Trainings eine Struktur, sodass jeder Agent, der zum Zeitpunkt der dezentralen Ausführung ausschließlich auf seinen eigenen Q-Wert reagiert, nicht weit vom globalen Optimum abweicht.
COMA (Foerster et al., 2018) verfolgt einen anderen Ansatz und verwendet eine kontrafaktische Baseline innerhalb eines Actor-Critic-Modells. Indem die Differenz zwischen der erwarteten Belohnung, wenn die Aktion von Agent i hypothetisch durch eine andere Aktion ersetzt würde, und der erwarteten Belohnung für die tatsächlich gewählte Aktion berechnet und als Vorteil verwendet wird, wird isoliert und bewertet, wie stark die eigene Aktion die Gesamtbelohnung beeinflusst hat – unabhängig von den Beiträgen der anderen Agenten.
Beide Methoden haben gemeinsam, dass sie aus einer einzigen gemeinsamen Belohnungszahl ein individuelles Lernsignal für jeden Agenten extrahieren.
5. Repräsentative Algorithmen
| Algorithmus | Familie | Hauptanwendungsbereich | Kernidee |
|---|---|---|---|
| MADDPG (Lowe et al., 2017) | Actor-Critic (kontinuierliche Aktion) | Kooperativ, kompetitiv, gemischt | Ein dedizierter zentralisierter Critic pro Agent; nur der eigene Actor zur Ausführungszeit |
| QMIX (Rashid et al., 2018) | Wertbasiert (diskrete Aktion) | Kooperativ | Kombiniert individuelle Q-Werte mit einem monotonen Mischnetzwerk, das die IGM-Bedingung erfüllt |
| COMA (Foerster et al., 2018) | Actor-Critic | Kooperativ | Behandelt die Kreditvergabe explizit mit einer kontrafaktischen Baseline |
| Unabhängiges Lernen (Independent Q-Learning / IPPO usw.) | Naive Erweiterung von Einzelagentenmethoden | Anwendbar auf alles | Einfach zu implementieren, ignoriert aber Nichtstationarität, wodurch das Lernen instabil werden kann |
MADDPG erweitert DDPG auf mehrere Agenten: Jeder Agent i verwendet während des Trainings seinen eigenen zentralen Kritiker Q_i(s,a_1,\dots,a_n) und agiert zur Ausführungszeit ausschließlich mit seinem eigenen Akteur \pi_i(a_i\mid o_i). Dieses Design ermöglicht die Anwendung desselben Frameworks auf beliebige kooperative, kompetitive oder gemischte Belohnungsstrukturen.
QMIX eignet sich besser für diskrete kooperative Aufgaben (Benchmarks wie die StarCraft Multi-Agent Challenge) als für kontinuierliche Steuerung. Im Gegenzug für die relativ starke Annahme der Monotoniebedingung garantiert es theoretisch Konsistenz zur dezentralen Ausführungszeit.
„Unabhängiges Lernen“ – die naive Methode, bei der jeder Agent die Existenz der anderen Agenten ignoriert und parallel normales Q-Learning oder PPO ausführt – kann in manchen Fällen überraschend gut funktionieren. Da sie jedoch Nichtstationarität nicht berücksichtigt, neigt das Lernen dazu, mit zunehmender Anzahl an Agenten oder schnellen Strategieänderungen der Gegner zu divergieren. Methoden der CTDE-Familie können als Versuch verstanden werden, die Probleme dieser naiven Methode mithilfe von während des Trainings verfügbaren privilegierten Informationen zu mindern.
6. Bezug zur Schwarmsteuerung mehrerer Roboter
Die Schwarmsteuerung (Mehrrobotersysteme), bei der mehrere physische Roboter kooperativ zusammenarbeiten, ist eines der Anwendungsgebiete von MARL. Lagertransport, Formationsflug mehrerer Drohnen und kooperative Such- und Rettungsaktionen mit mehreren Einheiten weisen alle die Struktur auf, dass jeder Roboter nur lokale Beobachtungen hat, die Kommunikation eingeschränkt ist und die Gesamteffizienz verbessert werden soll – eine Struktur, die gut zu CTDEs Idee des zentralisierten Trainings und der dezentralen Ausführung passt.
Allerdings weist die Schwarmsteuerung viele Elemente auf, die die Lerntheorie von MARL allein nicht vollständig bewältigen kann: eine variable Anzahl von Individuen (Roboter, die während der Mission ausscheiden oder hinzugefügt werden), eine sich dynamisch verändernde Kommunikationstopologie und die Notwendigkeit, Sicherheitsbeschränkungen wie Kollisionsvermeidung jederzeit außerhalb der gelernten Strategie zu platzieren. Diese Website enthält noch keinen Artikel, der sich ausschließlich mit der Steuerung von Roboterschwärmen befasst, MARL wird jedoch als eine ihrer grundlegenden Theorien positioniert.
7. Checkliste für Implementierung und Evaluierung
-
Wurden die Beobachtungen, Aktionen und Belohnungen jedes Agenten während der Trainingszeit (mit zentralen Informationen) und der Ausführungszeit (nur lokale Beobachtungen) klar getrennt und protokolliert?
-
Wurde zunächst definiert, ob die Belohnung kooperativ, kompetitiv oder gemischt ist, und ein geeigneter Algorithmus ausgewählt (z. B. aus der QMIX-Familie, der MADDPG-Familie oder unabhängiges Lernen)?
-
Wurde die Lernkurve nicht nur hinsichtlich der Gesamtbelohnung, sondern auch hinsichtlich des Beitrags jedes Agenten, des Aktionsverhältnisses und der individuellen Erfolgsrate verfolgt, um sicherzustellen, dass kein einzelner Agent beim Lernen nachlässig ist?
-
Wurde die Evaluierung unter verschiedenen Bedingungen mit unterschiedlichen Agentenanzahlen oder Topologien durchgeführt, um sicherzustellen, dass keine Überanpassung an die Anzahl der Agenten während der Trainingszeit stattgefunden hat?
-
Haben Sie für reale Hardware und reale Umgebungen Kommunikationslatenzen und -ausfälle berücksichtigt und sichergestellt, dass jeder Agent auch bei einem Kommunikationsausfall auf sicheres Verhalten zurückgreifen kann (wobei die Sicherheitsbeschränkungen außerhalb der gelernten Strategie liegen)?
Zusammenfassung
Multiagenten-Reinforcement-Learning setzt dort an, wo die implizite Annahme eines Single-Agent-MDP – „Die Umgebung ist fix“ – nicht mehr zutrifft. Nichtstationarität, bei der das Lernen der anderen Agenten die Definition der eigenen Umgebung verändert; der Unterschied zwischen kooperativen, kompetitiven und gemischten Belohnungsstrukturen; und das Problem der Verteilung einer gemeinsamen Belohnung auf die individuellen Beiträge – CTDE ist die praktische Antwort auf all diese Herausforderungen, und MADDPG und QMIX sind ihre konkreten Realisierungen. Bei Anwendungen mit mehreren physischen Agenten, wie z. B. der Steuerung von Roboterschwärmen, ist es außerdem wichtig zu beachten, dass Herausforderungen auf Implementierungsebene – eine variable Anzahl von Individuen, dynamische Kommunikation und Sicherheitsbeschränkungen – zusätzlich zur Lerntheorie hinzukommen.
Lässt sich eine Einzelagentenmethode unverändert auf viele Agenten übertragen?
Andere Lernagenten verändern die Umgebung.
Unterscheiden Sie Kooperation, Wettbewerb, Beobachtungsgrenzen und Trainings- versus Ausführungsinformationen.Referenzen
- Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (NeurIPS, 2017)
- Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning (ICML, 2018)
- Foerster et al., Counterfactual Multi-Agent Policy Gradients (AAAI, 2018)
- OpenAI Spinning Up — Key Concepts in RL
- [The Basics of Reinforcement Learning Reinforcement Learning, Q-Learning und DQN-Einführung, Policy Gradient/PPO/SAC-Einführung
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.