Contents — find the section you need
Les articles « Les bases de l’apprentissage par renforcement » et « Q-learning et DQN », abordés jusqu’ici, supposaient un processus de décision markovien (MDP) où l’environnement ne réagit qu’à un seul agent. Or, de nombreux contextes impliquent plusieurs agents agissant simultanément sur l’environnement : plusieurs robots de transport dans un entrepôt, des jeux compétitifs, un essaim de drones se partageant les tâches de communication. L’apprentissage par renforcement multi-agents (MARL) résout une difficulté absente de l’apprentissage par renforcement mono-agent : dans ce contexte, tous les agents, sauf vous, apprennent et évoluent constamment.
MARL ## Résumé en 30 secondes
-
Dans un processus de décision markovien (MDP) à agent unique, la probabilité de transition de l'environnement (P(s'\mid s,a)) est fixe. En revanche, dans un environnement multi-agents où les autres agents apprennent et modifient leurs politiques, la perception de l'environnement par un agent donné évolue au fil du temps : c'est ce qu'on appelle la non-stationnarité.
-
Les environnements se répartissent en trois grandes catégories : coopératifs (chaque agent maximise une récompense partagée), compétitifs (similaires à somme nulle, où il s'agit de vaincre un adversaire) et mixtes (partiellement coopératifs, partiellement compétitifs). L'algorithme requis est adapté en conséquence.
-
Le CTDE (entraînement centralisé avec exécution décentralisée) – où l'apprentissage utilise des informations globales tandis que l'exécution repose sur les seules observations de chaque agent – est le cadre dominant, pratique pour les matériels et environnements réels.
-
La répartition d'une récompense partagée entre les contributions individuelles des agents – le problème d'attribution du crédit – constitue le principal défi technique de l'apprentissage par renforcement multi-agents (MARL) coopératif. MADDPG (Lowe et al., 2017) et QMIX (Rashid et al., 2018) sont des algorithmes représentatifs qui concrétisent le CTDE, respectivement du point de vue de l'approche acteur-critique et de la factorisation de la valeur Q.
1. Pourquoi le cadre mono-agent est-il inopérant ?
L'hypothèse centrale du MDP était que la transition P(s'\mid s,a) et la récompense R(s,a,s') de l'environnement sont fixes, indépendantes de la politique de l'agent. Même lorsque l'agent met à jour sa politique, les lois physiques de l'environnement lui-même restent inchangées.
Dans un environnement multi-agents, cette prémisse n'est plus valable. Ce que l'agent i perçoit comme « l'environnement » inclut désormais non seulement les lois physiques, mais aussi les politiques \pi_{-i} des autres agents -i (tous sauf i). Étant donné que les autres agents apprennent simultanément et mettent à jour en permanence \pi_{-i}, la probabilité de transition effective que subit l'agent i,
change à chaque modification de \pi_{-i}. Il s'agit d'une non-stationnarité. Du point de vue de l'agent i, une action efficace hier peut ne plus l'être aujourd'hui, la politique de l'adversaire ayant évolué. Même le stockage des anciennes transitions dans une mémoire tampon de relecture peut induire en erreur : cette expérience a été acquise face à un adversaire qui « n'existe plus ».

Figure 1 — Ce que représente « l'environnement » pour l'agent i inclut non seulement les lois physiques, mais aussi les politiques des autres agents. Tant que les autres agents continuent d'apprendre, la distribution de transition que subit l'agent i continue d'évoluer.
2. Coopératif, compétitif et mixte : la structure des récompenses façonne le problème
La nature d'un problème multi-agents change radicalement selon la manière dont les récompenses sont attribuées.
| Contexte | Relation de récompense | Exemple représentatif | Difficulté principale |
|---|---|---|---|
| Coopératif | Chacun maximise une récompense commune ou fortement corrélée | Plusieurs robots d'entrepôt maximisant l'efficacité du transport | Attribution du crédit, conception de la communication |
| Compétitif | Le gain d'une partie est le Perte de l'autre (somme quasi nulle) | Jeux compétitifs, simulations de concurrence par les prix | Nécessité de suivre l'adaptation de l'adversaire, équilibres instables |
| Mixte / somme générale | Coopération partielle, affrontement partiel | Plusieurs véhicules à une intersection, robots coopératifs en compétition pour une ressource | Alternance entre situations de coopération et situations de compétition |
Les contextes coopératifs sont souvent formalisés mathématiquement par un Dec-POMDP (MDP partiellement observable décentralisé), où tous les acteurs visent le même ensemble de politiques optimales. Les contextes compétitifs sont évalués à l'aide de concepts proches de l'équilibre de Nash en théorie des jeux, où une « politique optimale » unique peut ne pas exister, car l'optimum pour vous évolue en fonction de la politique de l'adversaire. Les contextes mixtes sont les plus proches de la réalité, mais offrent le moins de garanties théoriques.
3. CTDE : Formation centralisée, exécution décentralisée
CTDE (Formation centralisée avec exécution décentralisée) est largement utilisé pour traiter Non-stationnarité. Lors de l'entraînement (dans un simulateur ou lors d'une phase d'entraînement hors ligne), vous pouvez utiliser des informations centralisées qui visualisent simultanément les observations, les actions et parfois les récompenses de chaque agent. Mais lors de l'exécution (sur du matériel réel, en environnement de production), chaque agent décide de son action en se basant uniquement sur les observations locales de ses propres capteurs.
La raison pratique du fonctionnement de CTDE est claire. Compte tenu des contraintes de bande passante et de latence des communications, il est souvent irréaliste pour une flotte réelle de robots ou de drones de fonctionner en partageant constamment l'état de chaque agent. Mais dans un simulateur ou sur un serveur d'entraînement, vous pouvez utiliser toutes les informations sans vous soucier du coût de communication. CTDE est une conception qui tire le meilleur parti de ces « informations privilégiées disponibles uniquement pendant l'entraînement », tout en conservant une politique capable d'agir de manière autonome lors de l'exécution.
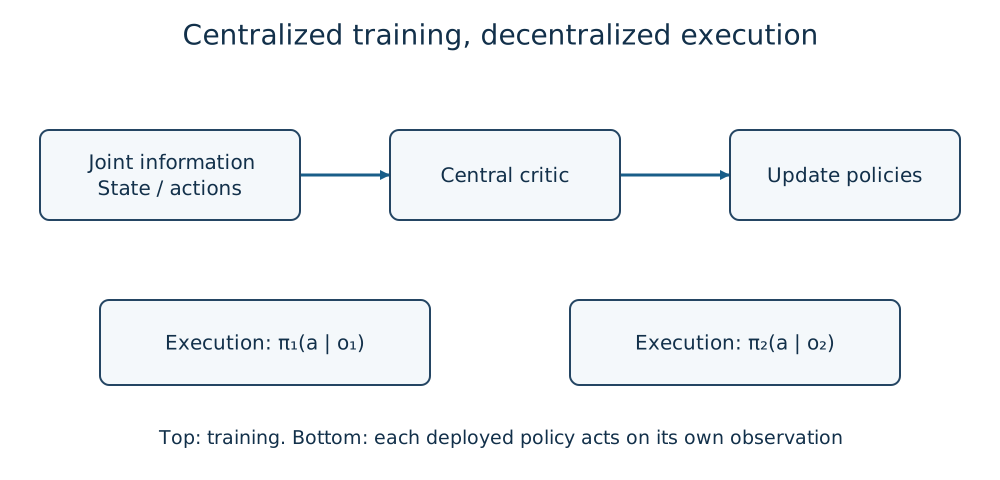
Figure 2 — Pendant l'entraînement, un critique central (ou réseau de mélange) intègre les informations de tous les agents ; lors de l'exécution, chaque agent décide uniquement sur la base de ses observations locales. Cette séparation permet d'absorber la non-stationnarité lors de l'entraînement tout en tolérant les contraintes de communication lors de l'exécution.
4. Le problème d'attribution du mérite : Qui réussit, qui échoue
Dans un contexte coopératif, lorsqu'une seule récompense partagée est distribuée, il n'est pas évident de déterminer quels agents ont réellement contribué à cette récompense. Si chaque agent reçoit la même récompense telle quelle, un agent qui n'a pas contribué recevra une évaluation tout aussi « bonne », tandis que le signal d'un agent ayant réellement contribué sera noyé dans les actions des autres. C'est le problème d'attribution du mérite.
Une approche consiste à décomposer la fonction de valeur en agents individuels. QMIX (Rashid et al., 2018) combine les valeurs Q individuelles de chaque agent (Q_i(o_i,a_i)) à l'aide d'un réseau de mélange à pondérations non négatives, afin de construire la valeur Q globale (Q_{\text{tot}}).
Cette contrainte de monotonie garantit que le choix par chaque agent de l'action maximisant de manière gloutonne sa propre valeur Q (Q_i) n'entre pas en conflit avec la maximisation de la valeur Q globale (Q_{\text{tot}}) (condition IGM : Maximum Individuel-Global). Autrement dit, le réseau de mélange intègre, lors de l'entraînement, une structure telle que chaque agent, agissant uniquement sur sa propre valeur Q au moment de l'exécution décentralisée, ne s'éloigne pas significativement de l'optimum global.
Dans une approche différente, COMA (Foerster et al., 2018) utilise une ligne de base contrefactuelle au sein d'un cadre acteur-critique. En calculant la différence entre la récompense attendue si l'action de l'agent i était hypothétiquement remplacée par une autre, et la récompense attendue pour l'action réellement choisie, et en utilisant cette différence comme avantage, COMA isole et évalue « dans quelle mesure mon action a influencé la récompense globale », indépendamment des contributions des autres agents.
Ces deux méthodes ont en commun d'extraire un signal d'apprentissage pour chaque agent à partir d'une récompense partagée.
5. Algorithmes représentatifs
| Algorithme | Famille | Contexte principal | Idée clé |
|---|---|---|---|
| MADDPG (Lowe et al., 2017) | Acteur-Critique (action continue) | Coopératif, compétitif, mixte | Un Critique centralisé dédié par agent ; seul son propre Acteur est impliqué lors de l'exécution |
QMIX (Rashid et al., 2018) | Basé sur les valeurs (action discrète) | Coopératif | Combine les valeurs Q individuelles avec un réseau de mélange monotone, satisfaisant la condition IGM |
COMA (Foerster et al., 2018) | Acteur-Critique | Coopératif | Gère explicitement l'attribution du crédit avec une base de référence contrefactuelle |
Apprentissage indépendant (Independent Q-Learning / IPPO, etc.) | Extension naïve des méthodes mono-agent | Applicable à tout système | Simple à implémenter, mais ignore la non-stationnarité, ce qui rend l'apprentissage instable |
MADDPG étend DDPG à plusieurs agents : chaque agent utilise son propre Critique centralisé dédié (i) pendant l'entraînement, et agit uniquement à l'aide de son propre Acteur (\pi_i(a_i\mid o_i)) lors de l'exécution. Cette conception permet d'appliquer le même cadre à toute structure de récompense coopérative, compétitive ou mixte.
QMIX est plus performant sur les tâches coopératives à actions discrètes (comme le StarCraft Multi-Agent Challenge) que sur le contrôle continu. En contrepartie de l'hypothèse relativement forte de la contrainte de monotonie, il garantit théoriquement la cohérence lors de l'exécution décentralisée.
L'« apprentissage indépendant » – la méthode naïve où chaque agent ignore simplement l'existence des autres et exécute un apprentissage Q ou PPO classique en parallèle – peut donner des résultats étonnamment bons dans certains cas. Cependant, comme elle ne traite pas la non-stationnarité, l'apprentissage tend à diverger lorsque le nombre d'agents augmente ou que les politiques des adversaires changent rapidement. Les méthodes de la famille CTDE peuvent être perçues comme une tentative d'atténuer les problèmes de cette méthode naïve, en exploitant les informations privilégiées disponibles lors de l'entraînement.
6. Lien avec le contrôle d'essaims multi-robots
Le contrôle d'essaims (systèmes multi-robots), où plusieurs robots physiques coopèrent, est l'un des domaines d'application de MARL. Le transport en entrepôt, le vol en formation de plusieurs drones et la recherche et le sauvetage coopératifs avec plusieurs unités partagent tous la structure suivante : « chaque robot ne dispose que d'observations locales, la communication est contrainte et l'objectif est d'améliorer l'efficacité globale » – une structure qui correspond bien au concept de CTDE, à savoir un entraînement centralisé et une exécution décentralisée.
Cependant, le contrôle d'essaims présente de nombreux éléments que la théorie d'apprentissage de MARL ne peut à elle seule prendre entièrement en compte : un nombre variable d'individus (des robots qui quittent ou rejoignent le groupe en cours de mission), une topologie de communication dynamique et la nécessité de placer en permanence des contraintes de sécurité, telles que l'évitement des collisions, en dehors de la politique apprise. Ce site ne propose pas encore d'article dédié au contrôle d'essaims de robots multiples, mais MARL y est présenté comme l'une de ses théories fondamentales.
7. Liste de vérification pour l'implémentation et l'évaluation
-
Avez-vous clairement séparé et consigné les observations, actions et récompenses de chaque agent pour la phase d'entraînement (avec informations centralisées) et la phase d'exécution (observation locale uniquement) ?
-
Avez-vous préalablement défini si la récompense est coopérative, compétitive ou mixte, et choisi un algorithme adapté (famille QMIX, famille MADDPG ou apprentissage indépendant) ?
-
Avez-vous suivi la courbe d'apprentissage non seulement en termes de récompense globale, mais aussi en fonction de la contribution de chaque agent, du ratio d'actions et du taux de réussite individuel, afin de vérifier qu'aucun agent ne ralentit son apprentissage ?
-
Avez-vous effectué des évaluations avec différents nombres d'agents ou topologies, afin de vérifier l'absence de surapprentissage ? Pour du matériel et des environnements réels, avez-vous pris en compte la latence et les interruptions de communication, et vérifié que chaque agent peut adopter un comportement sûr même en cas de coupure de communication (les contraintes de sécurité étant exclues de la politique apprise) ?
Résumé
L'apprentissage par renforcement multi-agents commence là où l'hypothèse implicite d'un processus de décision markovien (MDP) mono-agent — « l'environnement est fixe » — n'est plus valable. La non-stationnarité, où l'apprentissage des autres agents modifie constamment ce qui constitue votre environnement ; la différence entre les structures de récompense coopératives, compétitives et mixtes ; et le problème de l'attribution du crédit (comment répartir une récompense partagée entre les contributions individuelles) : CTDE apporte une réponse pratique à tous ces problèmes, et MADDPG et QMIX en sont des implémentations concrètes. Dans les applications impliquant plusieurs agents physiques, comme le contrôle d'essaims de robots, il est également important de noter que les défis liés à l'implémentation — un nombre variable d'individus, une communication dynamique et des contraintes de sécurité — s'ajoutent à la théorie de l'apprentissage.
Une méthode à agent unique peut-elle être transférée sans modification à plusieurs agents ?
D'autres agents apprenants modifient l'environnement. Distinguer la coopération, la compétition, les limites d'observation et les informations d'entraînement par rapport aux informations d'exécution.
## Références - [Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (NeurIPS, 2017)](https://arxiv.org/abs/1706.02275) - [Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning (ICML, 2018)](https://arxiv.org/abs/1803.11485) - [Foerster et al., Counterfactual Multi-Agent Policy Gradients (AAAI, 2018)](https://arxiv.org/abs/1705.08926) - [OpenAI Spinning Up — Key Concepts in RL](https://spinningup.openai.com/en/latest/spinningup/rl_intro.html) - [The Basics of Reinforcement Apprentissage](/fr/blog/posts/reinforcement-learning-basics.html), [Introduction à l'apprentissage Q et au DQN](/fr/blog/posts/reinforcement-q-learning-dqn.html), [Introduction au gradient de politique/PPO/SAC](/fr/blog/posts/reinforcement-policy-gradient-ppo-sac.html)
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.