Contents — find the section you need
अब तक कवर किए गए रीइन्फोर्समेंट लर्निंग के मूल सिद्धांत और क्यू-लर्निंग और डीक्यूएन में एक मल्टी-एजेंट रीइन्फोर्समेंट लर्निंग (एमडीपी) की धारणा थी जिसमें वातावरण केवल एक एजेंट पर प्रतिक्रिया करता है। लेकिन ऐसे कई परिदृश्य हैं जहां एक ही समय में कई एजेंट वातावरण पर कार्य करते हैं - एक गोदाम में कई परिवहन रोबोट, प्रतिस्पर्धी खेल, संचार कार्यों को साझा करने वाले ड्रोन का झुंड। मल्टी-एजेंट रीइन्फोर्समेंट लर्निंग (एमएआरएएल) एक ऐसी कठिनाई से निपटता है जो सिंगल-एजेंट आरएल में मौजूद नहीं है: इस सेटिंग में, आपके अलावा हर कोई सीख रहा है, और लगातार बदल रहा है।
30 सेकंड का सारांश
-
एक एजेंट वाले मल्टी-डिटैचमेंट डेवलपमेंट प्रोग्राम (एमडीपी) में, वातावरण की संक्रमण संभावना P(s'\mid s,a) स्थिर होती है, लेकिन बहु-एजेंट वातावरण में, जहाँ अन्य एजेंट भी सीख रहे होते हैं और अपनी नीतियों को बदल रहे होते हैं, समय के साथ किसी विशेष एजेंट द्वारा "वातावरण" के रूप में देखी जाने वाली चीज़ बदलती रहती है — इसे गैर-स्थिरता कहा जाता है।
-
सेटिंग्स को मोटे तौर पर सहकारी (सभी एजेंट एक साझा पुरस्कार को अधिकतम करते हैं), प्रतिस्पर्धी (शून्य-योग जैसी, प्रतिद्वंद्वी को हराना) और मिश्रित (आंशिक रूप से सहकारी, आंशिक रूप से प्रतिस्पर्धी) में विभाजित किया जाता है, और आवश्यक एल्गोरिदम तदनुसार बदलता है।
-
सीटीडीई (विकेंद्रीकृत निष्पादन के साथ केंद्रीकृत प्रशिक्षण) — जहाँ सीखने में वैश्विक जानकारी का उपयोग होता है, लेकिन निष्पादन में प्रत्येक एजेंट केवल अपने स्वयं के अवलोकनों पर कार्य करता है — वास्तविक हार्डवेयर और वास्तविक वातावरण के लिए व्यावहारिक मुख्यधारा का ढांचा है।
-
व्यक्तिगत एजेंटों के योगदान के बीच एक साझा पुरस्कार को कैसे वितरित किया जाए — क्रेडिट असाइनमेंट समस्या — सहकारी एमएआरएल में सबसे बड़ी तकनीकी चुनौती है।
-
MADDPG (लोवे एट अल., 2017) और QMIX (रशीद एट अल., 2018) प्रतिनिधि एल्गोरिदम हैं जो क्रमशः एक्टर-क्रिटिक और क्यू-वैल्यू फैक्टराइजेशन के दृष्टिकोण से CTDE को मूर्त रूप देते हैं।
1. सिंगल-एजेंट फ्रेमवर्क विफल क्यों हो जाता है?
एमडीपी की केंद्रीय मान्यता यह थी कि पर्यावरण का संक्रमण P(s'\mid s,a) और इनाम R(s,a,s') एजेंट की नीति से स्वतंत्र, स्थिर हैं। भले ही एजेंट अपनी नीति को अपडेट करे, पर्यावरण के भौतिक नियम नहीं बदलते।
एकाधिक एजेंटों वाले पर्यावरण में, यह मान्यता विफल हो जाती है। एजेंट i जिसे "पर्यावरण" के रूप में देखता है, उसमें न केवल भौतिक नियम बल्कि अन्य एजेंटों -i ( i को छोड़कर सभी ) की नीतियां \pi_{-i} भी शामिल होती हैं। क्योंकि अन्य एजेंट भी साथ-साथ सीख रहे हैं और लगातार \pi_{-i} को अपडेट कर रहे हैं, इसलिए एजेंट i द्वारा अनुभव की जाने वाली प्रभावी संक्रमण संभावना,
हर बार \pi_{-i} में परिवर्तन होने पर बदल जाती है। यही अस्थिरता है। एजेंट i के दृष्टिकोण से, जो क्रिया कल तक कारगर रही, वह आज कारगर नहीं हो सकती, क्योंकि अब दूसरी तरफ की नीति बदल गई है। यहां तक कि रीप्ले बफर में पुराने संक्रमणों को संग्रहीत करना भी भ्रामक हो सकता है — वह अनुभव एक ऐसे प्रतिद्वंद्वी के विरुद्ध एकत्रित किया गया था जो अब "अस्तित्व में नहीं है"।

चित्र 1 — एजेंट i के लिए "पर्यावरण" में न केवल भौतिक नियम बल्कि अन्य एजेंटों की नीतियां भी शामिल हैं। जब तक अन्य एजेंट सीखते रहते हैं, एजेंट i द्वारा अनुभव किया जाने वाला संक्रमण वितरण बदलता रहता है।
2. सहयोगात्मक, प्रतिस्पर्धी और मिश्रित: पुरस्कार संरचना समस्या को आकार देती है
पुरस्कार कैसे आवंटित किया जाता है, इसके आधार पर बहु-एजेंट समस्या का स्वरूप नाटकीय रूप से बदल जाता है।
| सेटिंग | पुरस्कार संबंध | प्रतिनिधि उदाहरण | मुख्य कठिनाई |
|---|---|---|---|
| सहयोगात्मक | सभी एक सामान्य या अत्यधिक सहसंबंधित पुरस्कार को अधिकतम करते हैं | परिवहन दक्षता को अधिकतम करने वाले कई वेयरहाउस रोबोट | क्रेडिट आवंटन, संचार डिजाइन |
प्रतिस्पर्धी | एक पक्ष का लाभ दूसरे का नुकसान (लगभग शून्य-योग) | प्रतिस्पर्धी खेल, मूल्य-प्रतिस्पर्धा सिमुलेशन | प्रतिद्वंद्वी के अनुकूलन पर नज़र रखना आवश्यक, अस्थिर संतुलन |
मिश्रित/सामान्य-योग | आंशिक रूप से सहयोगात्मक, आंशिक रूप से विरोधी | चौराहे पर कई वाहन, संसाधन के लिए प्रतिस्पर्धा करने वाले सहयोगात्मक रोबोट | सहयोग की आवश्यकता वाली स्थितियों और प्रतिस्पर्धा की आवश्यकता वाली स्थितियों के बीच स्विच करना |
सहयोगात्मक सेटिंग्स को अक्सर गणितीय रूप से डेक-पीओएमडीपी (विकेंद्रीकृत आंशिक रूप से अवलोकन योग्य एमडीपी) के रूप में औपचारिक रूप दिया जाता है, जहां सभी का लक्ष्य इष्टतम नीतियों का एक ही समूह होता है। प्रतिस्पर्धी सेटिंग्स का मूल्यांकन गेम थ्योरी में नैश संतुलन के निकट की अवधारणाओं का उपयोग करके किया जाता है, जहां एक एकल "इष्टतम नीति" का अस्तित्व भी नहीं हो सकता है - क्योंकि प्रतिद्वंद्वी की नीति में परिवर्तन के साथ, आपके लिए जो इष्टतम है वह भी बदल जाता है। मिश्रित सेटिंग्स वास्तविकता के सबसे करीब होती हैं, लेकिन इनमें सैद्धांतिक गारंटी सबसे कम होती हैं।
3. सीटीडीई: केंद्रीकृत प्रशिक्षण, निष्पादन क्षेत्र पर निर्भर
**सीटीडीई (केंद्रीकृत प्रशिक्षण के साथ) विकेन्द्रीकृत निष्पादन (CTDE) का व्यापक रूप से उपयोग अस्थिरता से निपटने के लिए किया जाता है। प्रशिक्षण के दौरान (सिम्युलेटर के अंदर, या ऑफ़लाइन प्रशिक्षण चरण के दौरान), आपको केंद्रीय जानकारी का उपयोग करने की अनुमति होती है जो प्रत्येक एजेंट के अवलोकन, क्रियाओं और कभी-कभी पुरस्कारों को एक साथ देखती है। लेकिन निष्पादन के समय (वास्तविक हार्डवेयर पर, उत्पादन वातावरण में), प्रत्येक एजेंट केवल अपने स्वयं के सेंसर से प्राप्त स्थानीय अवलोकन का उपयोग करके अपनी क्रिया का निर्णय लेता है।
CTDE के काम करने का व्यावहारिक कारण स्पष्ट है। संचार बैंडविड्थ और विलंबता की सीमाओं को देखते हुए, रोबोट या ड्रोन के वास्तविक बेड़े के लिए प्रत्येक एजेंट की स्थिति को लगातार साझा करते हुए काम करना अक्सर अव्यावहारिक होता है। लेकिन सिम्युलेटर या प्रशिक्षण सर्वर के अंदर, आप संचार लागत की चिंता किए बिना सभी जानकारी का उपयोग कर सकते हैं। CTDE एक ऐसा डिज़ाइन है जो "केवल प्रशिक्षण के दौरान उपलब्ध इस विशेषाधिकार प्राप्त जानकारी" का अधिकतम उपयोग करता है, जबकि निष्पादन के समय स्वायत्त रूप से कार्य करने वाली नीति को भी बनाए रखता है।
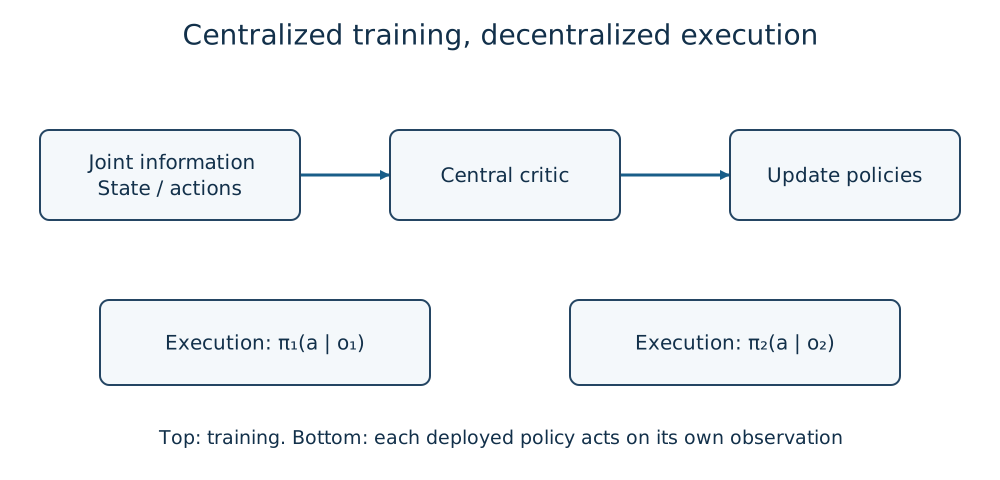
चित्र 2 — प्रशिक्षण के दौरान, एक केंद्रीय आलोचक (या मिक्सिंग नेटवर्क) सभी की जानकारी को एकीकृत करता है; निष्पादन के समय, प्रत्येक एजेंट केवल स्थानीय अवलोकन के आधार पर निर्णय लेता है। इन दोनों को अलग करने से प्रशिक्षण पक्ष में गैर-स्थिरता को अवशोषित किया जा सकता है, जबकि निष्पादन-समय संचार बाधाओं को सहन किया जा सकता है।
4. श्रेय आवंटन समस्या: किसकी सफलता, किसकी विफलता
सहयोगात्मक परिवेश में, जब आपको केवल एक साझा पुरस्कार r मिलता है, तो यह स्वतः स्पष्ट नहीं होता कि n एजेंटों में से किस एजेंट की क्रिया ने वास्तव में उस पुरस्कार में योगदान दिया। प्रत्येक एजेंट को समान पुरस्कार दिया जाए, तो वास्तव में कामचोरी करने वाले एजेंट को भी उतना ही "अच्छा" मूल्यांकन मिलता है, जबकि वास्तव में योगदान देने वाले एजेंट का संकेत अन्य एजेंटों की गतिविधियों में दब जाता है। यही क्रेडिट असाइनमेंट समस्या है।
एक तरीका यह है कि मूल्य फलन को व्यक्तिगत एजेंटों में विभाजित किया जाए। QMIX (राशिद एट अल., 2018) प्रत्येक एजेंट के व्यक्तिगत Q-मूल्य Q_i(o_i,a_i) को गैर-ऋणात्मक भार वाले मिक्सिंग नेटवर्क का उपयोग करके संयोजित करता है, जिससे समग्र Q-मूल्य Q_{\text{tot}} बनता है।
यह एकरसता बाधा सुनिश्चित करती है कि प्रत्येक एजेंट द्वारा अपने स्वयं के Q_i को अधिकतम करने वाली क्रिया का चयन समग्र Q_{\text{tot}} को अधिकतम करने के साथ टकराव नहीं करता है (IGM: व्यक्तिगत-वैश्विक-अधिकतम स्थिति)। दूसरे शब्दों में, मिक्सिंग नेटवर्क प्रशिक्षण के दौरान एक ऐसी संरचना बनाता है जिससे विकेंद्रीकृत निष्पादन समय पर प्रत्येक एजेंट, जो पूरी तरह से अपने Q-मान पर कार्य करता है, वैश्विक इष्टतम से अधिक दूर नहीं भटकता।
एक अलग दिशा में, COMA (फोर्स्टर एट अल., 2018) एक एक्टर-क्रिटिक फ्रेमवर्क के भीतर एक काउंटरफैक्चुअल बेसलाइन का उपयोग करता है। एजेंट i की क्रिया को काल्पनिक रूप से किसी अन्य क्रिया से बदलने पर अपेक्षित इनाम और वास्तव में चुनी गई क्रिया के लिए अपेक्षित इनाम के बीच अंतर लेकर, और उस अंतर को लाभ के रूप में उपयोग करके, यह अन्य एजेंटों के योगदान से अलग, "मेरी अपनी क्रिया ने समग्र इनाम को कितना प्रभावित किया" का मूल्यांकन करता है।
दोनों विधियों में समानता यह है कि वे एक ही साझा इनाम संख्या से प्रत्येक व्यक्तिगत एजेंट के लिए एक लर्निंग सिग्नल निकालने के उपकरण हैं।
5. प्रतिनिधि एल्गोरिदम
| एल्गोरिदम | परिवार | मुख्य सेटिंग | मुख्य विचार |
|---|---|---|---|
| MADDPG (लोवे एट अल., 2017) | कर्ता-आलोचक (निरंतर क्रिया) | सहयोगात्मक, प्रतिस्पर्धी, मिश्रित | प्रत्येक एजेंट के लिए एक समर्पित केंद्रीकृत आलोचक; निष्पादन समय पर केवल उसका अपना कर्ता |
QMIX (राशिद एट अल., 2018) | मूल्य-आधारित (असतत क्रिया) | सहयोगात्मक | व्यक्तिगत Q-मानों को एक मोनोटोनिक मिक्सिंग नेटवर्क के साथ जोड़ता है, जो IGM शर्त को पूरा करता है |
COMA (फोर्स्टर एट अल., 2018) | कर्ता-आलोचक | सहयोगात्मक | प्रति-तथ्यात्मक आधार रेखा के साथ क्रेडिट असाइनमेंट को स्पष्ट रूप से संभालता है |
स्वतंत्र अधिगम (स्वतंत्र Q-अधिगम / IPPO, आदि) | एकल-एजेंट विधियों का सरल विस्तार | किसी भी चीज़ पर लागू | लागू करने में आसान, लेकिन गैर-स्थिरता को अनदेखा करता है, इसलिए अधिगम अस्थिर हो जाता है |
MADDPG, DDPG को कई एजेंटों तक विस्तारित करता है: प्रत्येक एजेंट i प्रशिक्षण के दौरान अपने स्वयं के समर्पित केंद्रीकृत क्रिटिक Q_i(s,a_1,\dots,a_n) का उपयोग करता है, और निष्पादन समय पर केवल अपने स्वयं के एक्टर \pi_i(a_i\mid o_i) का उपयोग करके कार्य करता है। यह डिज़ाइन एक ही फ्रेमवर्क को सहकारी, प्रतिस्पर्धी या मिश्रित पुरस्कार संरचनाओं में से किसी पर भी लागू करने की अनुमति देता है।
QMIX, निरंतर नियंत्रण की तुलना में असतत-क्रिया सहकारी कार्यों (जैसे स्टारक्राफ्ट मल्टी-एजेंट चैलेंज) पर अधिक मजबूत है, और एकरसता बाधा की अपेक्षाकृत मजबूत धारणा के बदले में, यह सैद्धांतिक रूप से विकेंद्रीकृत निष्पादन समय पर स्थिरता की गारंटी देता है।
"स्वतंत्र अधिगम" - वह सरल विधि जिसमें प्रत्येक एजेंट अन्य एजेंटों के अस्तित्व को अनदेखा करता है और समानांतर में सामान्य Q-अध्ययन या PPO चलाता है - कुछ मामलों में आश्चर्यजनक रूप से अच्छा काम कर सकता है। लेकिन चूंकि यह गैर-स्थिरता को बिल्कुल भी संबोधित नहीं करता है, इसलिए एजेंटों की संख्या बढ़ने या विरोधियों की नीतियों में तेजी से बदलाव होने पर अधिगम विचलन की ओर प्रवृत्त होता है। CTDE-परिवार की विधियों को इस सरल विधि की समस्याओं को कम करने के प्रयास के रूप में समझा जा सकता है, जिसमें प्रशिक्षण के समय उपलब्ध विशेषाधिकार प्राप्त जानकारी का उपयोग किया जाता है।
6. बहु-रोबोट झुंड नियंत्रण से संबंध
झुंड नियंत्रण (बहु-रोबोट प्रणालियाँ), जहाँ कई भौतिक रोबोट सहयोगात्मक रूप से एक साथ काम करते हैं, MARL के अनुप्रयोग क्षेत्रों में से एक है। गोदाम परिवहन, कई ड्रोनों की समूह उड़ान, और कई इकाइयों के साथ सहयोगात्मक खोज और बचाव, इन सभी में "प्रत्येक रोबोट के पास केवल स्थानीय अवलोकन होते हैं, संचार सीमित होता है, और हम समग्र दक्षता में सुधार करना चाहते हैं" की संरचना समान है - एक ऐसी संरचना जो केंद्रीकृत प्रशिक्षण और विकेंद्रीकृत निष्पादन के CTDE के विचार के साथ अच्छी तरह से मेल खाती है।
हालांकि, झुंड नियंत्रण में कई ऐसे तत्व हैं जिन्हें MARL का अधिगम सिद्धांत अकेले पूरी तरह से संभाल नहीं सकता: व्यक्तियों की परिवर्तनशील संख्या (मिशन के बीच में रोबोटों का बाहर निकलना या जुड़ना), एक गतिशील रूप से बदलती संचार संरचना, और टक्कर से बचाव जैसे सुरक्षा प्रतिबंधों को हर समय सीखी गई नीति से बाहर रखने की आवश्यकता। इस साइट पर अभी तक मल्टी-रोबोट स्वार्म कंट्रोल पर कोई समर्पित लेख नहीं है, लेकिन MARL को इसके मूलभूत सिद्धांतों में से एक माना जाता है।
7. कार्यान्वयन और मूल्यांकन चेकलिस्ट
-
क्या आपने प्रशिक्षण समय (केंद्रीय जानकारी सहित) और निष्पादन समय (केवल स्थानीय अवलोकन) के लिए प्रत्येक एजेंट के अवलोकन, क्रिया और पुरस्कार को स्पष्ट रूप से अलग-अलग दर्ज किया है?
-
क्या आपने पहले यह परिभाषित किया है कि पुरस्कार सहयोगात्मक, प्रतिस्पर्धी या मिश्रित है, और इसके लिए उपयुक्त एल्गोरिदम का चयन किया है (एक QMIX परिवार, एक MADDPG परिवार, या स्वतंत्र शिक्षण)?
-
क्या आपने सीखने की प्रक्रिया को न केवल समग्र पुरस्कार के रूप में, बल्कि प्रति-एजेंट योगदान, क्रिया अनुपात और व्यक्तिगत सफलता दर के आधार पर भी ट्रैक किया है, ताकि यह सुनिश्चित हो सके कि कोई भी एजेंट सीखने में सुस्ती नहीं दिखा रहा है?
-
क्या आपने अलग-अलग संख्या में एजेंटों या टोपोलॉजी के साथ मूल्यांकन किया है, ताकि यह सुनिश्चित हो सके कि आपने प्रशिक्षण समय के दौरान निर्धारित संख्या से अधिक एल्गोरिदम का उपयोग नहीं किया है?
-
वास्तविक हार्डवेयर और वास्तविक वातावरण के लिए, क्या आपने संचार विलंब और रुकावट को ध्यान में रखा है, और यह पुष्टि की है कि प्रत्येक एजेंट संचार बाधित होने पर भी सुरक्षित व्यवहार पर वापस लौट सकता है (सुरक्षा संबंधी बाधाओं को सीखी गई नीति से बाहर रखते हुए)?
सारांश
बहु-एजेंट सुदृढ़ीकरण अधिगम उस बिंदु से शुरू होता है जहां एकल-एजेंट एमडीपी की अंतर्निहित धारणा — "वातावरण स्थिर है" — टूट जाती है। गैर-स्थिरता, जहां अन्य एजेंटों का अधिगम आपके स्वयं के वातावरण के रूप में मायने रखने वाली चीज़ों को बदलता रहता है; सहकारी, प्रतिस्पर्धी और मिश्रित पुरस्कार संरचनाओं के बीच अंतर; और व्यक्तिगत योगदानों के बीच साझा पुरस्कार को कैसे वितरित किया जाए, इस संबंध में क्रेडिट आवंटन समस्या — सीटीडीई इन सभी का व्यावहारिक समाधान है, और एमएडीडीपीजी और क्यूएमआईएक्स इसके ठोस क्रियान्वयन हैं। कई भौतिक एजेंटों से जुड़े अनुप्रयोगों में, जैसे कि बहु-रोबोट झुंड नियंत्रण, यह भी ध्यान में रखना महत्वपूर्ण है कि कार्यान्वयन-स्तर की चुनौतियां — व्यक्तियों की परिवर्तनशील संख्या, गतिशील संचार और सुरक्षा संबंधी बाधाएं — अधिगम सिद्धांत के ऊपर जमा हो जाती हैं।
क्या एक एजेंट-आधारित विधि को कई एजेंटों पर बिना किसी बदलाव के लागू किया जा सकता है?
अन्य लर्निंग एजेंट वातावरण को बदल देते हैं।
सहयोग, प्रतिस्पर्धा, अवलोकन सीमाएँ और प्रशिक्षण बनाम निष्पादन जानकारी में अंतर स्पष्ट करें। ## संदर्भ - [लोवे एट अल., मिश्रित सहकारी-प्रतिस्पर्धी वातावरण के लिए बहु-एजेंट अभिनेता-आलोचक (न्यूरिप्स, 2017)](https://arxiv.org/abs/1706.02275) - [राशिद एट अल., क्यूमिक्स: डीप मल्टी-एजेंट रीइन्फोर्समेंट लर्निंग के लिए मोनोटोनिक वैल्यू फंक्शन फैक्टराइजेशन (आईसीएमएल, 2018)](https://arxiv.org/abs/1803.11485) - [फोर्स्टर एट अल., काउंटरफैक्चुअल मल्टी-एजेंट पॉलिसी ग्रेडिएंट्स (एएएआई, 2018)](https://arxiv.org/abs/1705.08926) - [ओपनएआई स्पिनिंग अप - आरएल में प्रमुख अवधारणाएँ](https://spinningup.openai.com/en/latest/spinningup/rl_intro.html) - [रीइन्फोर्समेंट की मूल बातें] [रीइन्फोर्समेंट लर्निंग](/hi/blog/posts/reinforcement-learning-basics.html), [क्यू-लर्निंग और डीक्यूएन प्राइमर](/hi/blog/posts/reinforcement-q-learning-dqn.html), [पॉलिसी ग्रेडिएंट/पीपीओ/एसएसी प्राइमर](/hi/blog/posts/reinforcement-policy-gradient-ppo-sac.html)
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।