Contents — find the section you need
강화 학습의 기초와 Q-러닝 및 DQN에서는 환경이 단일 에이전트에만 반응하는 마르코프 결정 과정(MDP)을 가정했습니다. 하지만 창고의 여러 운반 로봇, 경쟁 게임, 통신 임무를 공유하는 드론 무리처럼 여러 에이전트가 동시에 환경에 작용하는 상황은 많습니다. 다중 에이전트 강화 학습(MARL)은 단일 에이전트 강화 학습에는 없는 어려움을 다룹니다. 이 환경에서는 당신을 제외한 모든 에이전트가 학습하고 끊임없이 변화합니다.
30초 요약
-
단일 에이전트 MDP에서는 환경의 전이 확률 P(s'\mid s,a)이 고정되어 있지만, 다른 에이전트들도 학습하고 정책을 변경하는 다중 에이전트 환경에서는 특정 에이전트가 "환경"으로 인식하는 것이 시간에 따라 변합니다. 이를 비정상성이라고 합니다.
-
환경은 크게 협력적(모두가 공유 보상을 최대화함), 경쟁적(제로섬 게임과 유사하며 상대를 이김), 혼합형(부분적으로 협력적이고 부분적으로 경쟁적)으로 나뉘며, 필요한 알고리즘은 이에 따라 달라집니다.
-
CTDE(중앙 집중식 학습 및 분산 실행) 방식은 학습에는 전역 정보를 사용하지만 실행에서는 각 에이전트가 자신의 관찰 결과에만 의존하는 방식으로, 실제 하드웨어와 환경에서 실용적인 주류 프레임워크입니다.
-
공유 보상을 각 에이전트의 기여도에 따라 분배하는 방법, 즉 보상 배분 문제는 협력적 MARL에서 가장 큰 기술적 과제입니다.
-
MADDPG(Lowe et al., 2017)와 QMIX(Rashid et al., 2018)는 각각 액터-크리틱 모델과 Q-값 분해 관점에서 CTDE를 구체화한 대표적인 알고리즘입니다.
1. 단일 에이전트 프레임워크가 실패하는 이유는 무엇일까요?
MDP의 핵심 가정은 환경의 변화(P(s'\mid s,a))와 보상(R(s,a,s'))이 에이전트의 정책과 무관하게 고정되어 있다는 것입니다. 에이전트가 정책을 업데이트하더라도 환경 자체의 물리 법칙은 변하지 않습니다.
여러 에이전트가 있는 환경에서는 이 전제가 무너집니다. 에이전트 i이 "환경"으로 인식하는 것은 이제 물리 법칙뿐만 아니라 다른 에이전트들(-i 제외)의 정책(\pi_{-i})까지 포함하게 됩니다. 다른 에이전트들도 동시에 학습하고 \pi_{-i}을 지속적으로 업데이트하기 때문에, 에이전트 i이 경험하는 유효 전이 확률은
\pi_{-i}이 변할 때마다 변합니다. 이것이 비정상성입니다. 에이전트 i의 관점에서 보면, 어제 효과적이었던 행동이 상대방의 정책이 바뀌었기 때문에 오늘은 효과적이지 않을 수 있습니다. 심지어 이전 전이를 리플레이 버퍼에 저장하는 것조차 오해를 불러일으킬 수 있습니다. 왜냐하면 그 경험은 "더 이상 존재하지 않는" 상대에 대한 것이기 때문입니다.

그림 1 — 에이전트 i의 "환경"에는 물리 법칙뿐만 아니라 다른 에이전트들의 정책도 포함됩니다. 다른 에이전트들이 계속 학습하는 한, i가 경험하는 전이 분포는 계속 변화합니다.
2. 협력적, 경쟁적, 혼합형: 보상 구조가 문제를 형성합니다
다중 에이전트 문제의 특성은 보상이 어떻게 할당되는지에 따라 크게 달라집니다.
| 설정 | 보상 관계 | 대표 예시 | 주요 어려움 |
|---|---|---|---|
| 협력적 | 모든 에이전트가 공통 또는 높은 상관관계를 가진 보상을 극대화 | 여러 대의 창고 로봇이 운송 효율을 극대화 | 보상 할당, 통신 설계 |
| 경쟁적 | 한 대 한쪽의 이득은 다른 쪽의 손실(거의 제로섬) | 경쟁 게임, 가격 경쟁 시뮬레이션 | 상대방의 적응을 추적해야 함, 불안정한 균형 |
| 혼합/일반합 | 부분 협력, 부분 적대적 | 교차로의 여러 차량, 자원을 놓고 경쟁하는 협력 로봇 | 협력이 필요한 상황과 경쟁이 필요한 상황 간 전환 |
협력적 환경은 종종 모든 참여자가 동일한 최적 정책 집합을 목표로 하는 Dec-POMDP(분산형 부분 관찰 가능 마르코프 결정 과정)로 수학적으로 공식화됩니다. 경쟁적 환경은 게임 이론의 내쉬 균형에 가까운 개념을 사용하여 평가되며, 상대방의 정책이 변경됨에 따라 자신에게 최적의 정책도 변경되기 때문에 단일한 "최적 정책"이 존재하지 않을 수도 있습니다. 혼합 환경은 현실에 가장 가깝지만 이론적 보장은 가장 적습니다.
3. CTDE: 중앙 집중식 훈련, 실행은 현장에 맡겨짐
**CTDE(중앙 집중식 훈련과 분산 실행) CTDE(실행)는 비정상성을 처리하는 데 널리 사용됩니다. 훈련 단계(시뮬레이터 또는 오프라인 훈련 단계)에서는 모든 에이전트의 관찰, 행동, 그리고 경우에 따라 보상까지 한 번에 볼 수 있는 중앙 집중식 정보를 사용할 수 있습니다. 하지만 실행 단계(실제 하드웨어, 운영 환경)에서는 각 에이전트가 자체 센서에서 얻은 로컬 관찰 정보만을 사용하여 행동을 결정합니다.
CTDE가 효과적인 실질적인 이유는 명확합니다. 통신 대역폭과 지연 시간 제약 때문에 실제 로봇이나 드론으로 구성된 팀이 모든 에이전트의 상태를 지속적으로 공유하면서 작동하는 것은 비현실적입니다. 하지만 시뮬레이터나 훈련 서버 내부에서는 통신 비용에 대한 걱정 없이 모든 정보를 사용할 수 있습니다. CTDE는 이러한 "훈련 중에만 사용 가능한 특권 정보"를 최대한 활용하면서도 실행 단계에서 자율적으로 작동할 수 있는 정책을 유지하는 설계입니다.
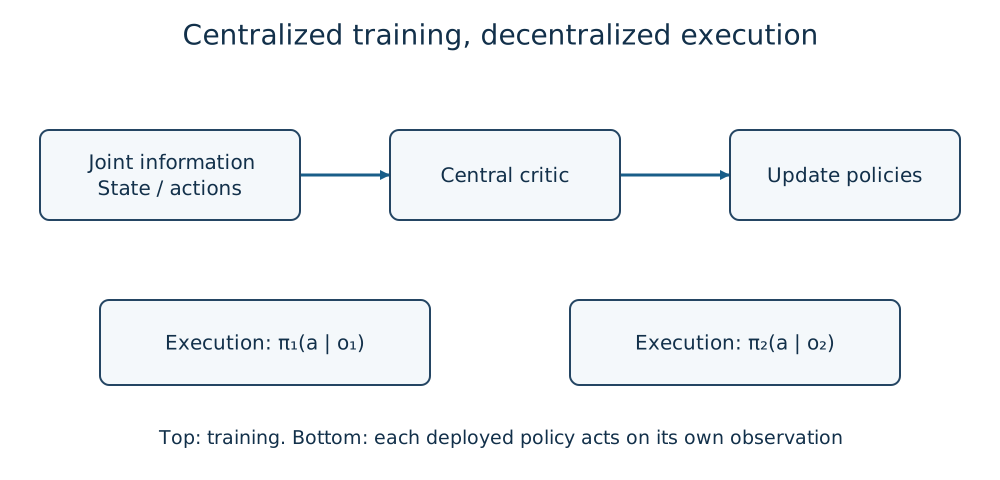
그림 2 — 학습 중에는 중앙 크리틱(또는 믹싱 네트워크)이 모든 에이전트의 정보를 통합합니다. 실행 시에는 각 에이전트가 로컬 관찰만을 기반으로 결정을 내립니다. 이 둘을 분리함으로써 학습 단계에서는 비정상성을 흡수하고 실행 단계의 통신 제약을 허용할 수 있습니다.
4. 크레딧 할당 문제: 누구의 성공, 누구의 실패
협력적인 환경에서 단일 공유 보상만 주어지는 경우, 어떤 에이전트의 행동이 실제로 그 보상에 기여했는지 명확하지 않습니다. 모든 에이전트에게 동일한 보상을 그대로 주면, 실제로는 게으름을 피운 에이전트도 똑같이 "좋은" 평가를 받는 반면, 진정으로 기여한 에이전트의 신호는 다른 에이전트들의 행동에 묻혀버립니다. 이것이 바로 크레딧 할당 문제입니다.
한 가지 접근 방식은 가치 함수를 개별 에이전트로 분해하는 것입니다. QMIX(Rashid et al., 2018)는 각 에이전트의 개별 Q 값 Q_i(o_i,a_i)을 비음수 가중치를 사용하는 혼합 네트워크를 통해 결합하여 전체 Q 값 Q_{\text{tot}}을 구성합니다.
이 단조성 제약 조건은 각 에이전트가 자신의 Q_i을 탐욕적으로 최대화하는 행동을 선택하는 것이 전체 Q_{\text{tot}}을 최대화하는 것과 충돌하지 않도록 보장합니다(IGM: 개별-전역-최대 조건). 즉, 혼합 네트워크는 훈련 중에 분산 실행 시간에 각 에이전트가 자신의 Q 값에만 의존하여 행동하더라도 전역 최적값에서 크게 벗어나지 않도록 하는 구조를 구축합니다.
다른 방향으로, COMA(Foerster et al., 2018)는 액터-크리틱 프레임워크 내에서 반사실적 기준선을 사용합니다. 에이전트 i의 행동이 다른 행동으로 가상적으로 대체되었을 때의 예상 보상과 실제로 선택된 행동의 예상 보상 간의 차이를 계산하고, 이를 이점(advantage)으로 사용하여 다른 에이전트들의 기여도와 분리하여 "내 행동이 전체 보상에 얼마나 영향을 미쳤는지"를 평가합니다.
두 방법 모두 공통적으로 단일 공유 보상 수치에서 각 에이전트의 개별 학습 신호를 추출하는 도구라는 공통점을 가지고 있습니다.
5. 대표 알고리즘
| 알고리즘 | 계열 | 주요 설정 | 핵심 아이디어 |
|---|---|---|---|
| MADDPG (Lowe et al., 2017) | 액터-크리틱(연속 행동) | 협력적, 경쟁적, 혼합형 | 에이전트당 전용 중앙 집중식 크리틱이 있으며, 실행 시에는 해당 에이전트의 액터만 사용 |
| QMIX (Rashid et al., 2018) | 가치 기반(이산 행동) | 협력적 | 개별 Q 값을 단조 혼합 네트워크와 결합하여 IGM 조건을 만족 |
| COMA (Foerster et al., 2018) | 액터-크리틱 | 협력적 | 반사실적 기준선을 사용하여 크레딧 할당을 명시적으로 처리 |
| 독립 학습 (독립 Q-학습 / IPPO 등) | 단일 에이전트 방식의 단순한 확장 | 모든 것에 적용 가능 | 구현은 간단하지만 비정상성을 무시하므로 학습이 불안정해지는 경향이 있음 |
MADDPG는 DDPG를 다중 에이전트로 확장한 것입니다. 각 에이전트(i)는 학습 중에 자체 전용 중앙 집중식 Critic(Q_i(s,a_1,\dots,a_n))을 사용하고, 실행 시에는 자체 Actor(\pi_i(a_i\mid o_i))만을 사용하여 행동합니다. 이러한 설계 덕분에 동일한 프레임워크를 협력적, 경쟁적, 혼합 보상 구조 모두에 적용할 수 있습니다.
QMIX는 연속 제어보다는 이산 행동 협력 작업(StarCraft Multi-Agent Challenge와 같은 벤치마크)에서 강점을 보이며, 단조성 제약 조건에 대한 비교적 강력한 가정을 전제로 분산 실행 시 일관성을 이론적으로 보장합니다.
"독립 학습"은 각 에이전트가 다른 에이전트의 존재를 무시하고 일반적인 Q-러닝이나 PPO를 병렬로 실행하는 단순한 방법으로, 경우에 따라 놀라울 정도로 잘 작동할 수 있습니다. 그러나 비정상성을 전혀 고려하지 않기 때문에 에이전트 수가 증가하거나 상대방의 정책이 빠르게 변화할수록 학습이 발산하는 경향이 있습니다. CTDE 계열 방법론은 훈련 시점에 이용 가능한 특권 정보를 활용하여 이러한 단순한 방법론이 가진 문제점을 완화하려는 시도로 이해할 수 있습니다.
6. 다중 로봇 군집 제어와의 관계
여러 대의 물리적 로봇이 협력적으로 작동하는 군집 제어(다중 로봇 시스템)는 MARL의 응용 분야 중 하나입니다. 창고 운송, 여러 대의 드론의 편대 비행, 여러 대의 로봇이 참여하는 협력 수색 및 구조 작업 등은 모두 "각 로봇은 국소적인 관찰만 할 수 있고, 통신은 제한적이며, 전반적인 효율성을 향상시키고자 한다"는 공통된 구조를 가지고 있습니다. 이러한 구조는 중앙 집중식 훈련과 분산 실행이라는 CTDE의 개념과 잘 부합합니다.
하지만 군집 제어에는 MARL의 학습 이론만으로는 완전히 처리할 수 없는 여러 요소가 있습니다. 예를 들어, 로봇의 수가 가변적이고(임무 도중 로봇이 이탈하거나 추가됨), 통신 토폴로지가 동적으로 변화하며, 충돌 회피와 같은 안전 제약 조건을 학습된 정책 외부에 항상 배치해야 하는 필요성이 있습니다. 이 사이트에는 아직 다중 로봇 군집 제어 자체에 대한 별도의 문서가 없지만, MARL은 그 기초 이론 중 하나로 자리매김하고 있습니다.
7. 구현 및 평가 체크리스트
-
훈련 시간(중앙 정보 사용)과 실행 시간(로컬 관찰만 사용) 동안 각 에이전트의 관찰, 행동 및 보상을 명확하게 구분하여 기록했습니까?
-
보상이 협력적, 경쟁적 또는 혼합형인지 먼저 정의하고, 이에 적합한 알고리즘(QMIX 계열, MADDPG 계열 또는 독립 학습)을 선택했습니까?
-
전체 보상뿐만 아니라 에이전트별 기여도, 행동 비율 및 개별 성공률별로 학습 곡선을 추적하여 특정 에이전트가 학습에서 뒤처지지 않도록 했습니까?
-
에이전트 수 또는 토폴로지가 다른 조건에서 평가를 수행하여 훈련 시간 동안의 에이전트 수에 과적합되지 않았는지 확인했습니까?
-
실제 하드웨어와 실제 환경에서 통신 지연 및 데이터 손실을 고려하고, 통신 장애 발생 시에도 각 에이전트가 안전한 동작으로 복귀할 수 있는지 확인하셨습니까? (단, 안전 제약 조건은 학습된 정책 외부에 유지됩니다.)
요약
다중 에이전트 강화 학습은 단일 에이전트 MDP의 암묵적인 가정, 즉 "환경은 고정되어 있다"는 가정이 더 이상 성립하지 않는 지점에서 시작됩니다. 다른 에이전트의 학습으로 인해 자신의 환경이 계속해서 변화하는 비정상성, 협력적, 경쟁적, 혼합 보상 구조의 차이, 그리고 공유 보상을 각 에이전트의 기여도에 따라 어떻게 분배할 것인가에 대한 보상 배분 문제 등, CTDE는 이러한 모든 문제에 대한 실질적인 해답이며, MADDPG와 QMIX는 이를 구체적으로 구현한 것입니다. 다중 로봇 군집 제어와 같이 여러 물리적 에이전트가 관련된 응용 분야에서는, 가변적인 개체 수, 동적인 통신, 안전 제약 조건과 같은 구현 수준의 문제점들이 학습 이론에 더해 추가적으로 발생한다는 점도 고려해야 합니다.
단일 에이전트 방식을 여러 에이전트로 변경 없이 전송할 수 있나요?
다른 학습 에이전트는 환경을 변경합니다.
협력, 경쟁, 관찰 한계, 훈련 정보와 실행 정보를 구분합니다.참고 문헌
- Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (NeurIPS, 2017)
- Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning (ICML, 2018)
- Foerster et al., Counterfactual Multi-Agent Policy Gradients (AAAI, 2018)
- OpenAI Spinning Up — Key Concepts in RL
- [The Basics of Reinforcement 강화 학습 기본, Q-러닝 및 DQN 입문, 정책 경사/PPO/SAC 입문
댓글
먼저 로그인해 주세요.
아직 데이터가 없습니다.