Contents — find the section you need
Los artículos sobre Fundamentos del aprendizaje por refuerzo y Aprendizaje Q y DQN, que hemos tratado hasta ahora, asumían un proceso de decisión de Markov (MDP) en el que el entorno reacciona a un solo agente. Sin embargo, existen numerosos escenarios donde múltiples agentes interactúan con el entorno simultáneamente: varios robots de transporte en un almacén, juegos competitivos, un enjambre de drones que comparten tareas de comunicación. El aprendizaje por refuerzo multiagente (MARL) aborda una dificultad inexistente en el aprendizaje por refuerzo de un solo agente: en este escenario, todos los demás agentes también aprenden y, además, evolucionan constantemente.
Resumen de 30 segundos
-
En un MDP de un solo agente, la probabilidad de transición del entorno P(s'\mid s,a) es fija, pero en un entorno multiagente, donde otros agentes también aprenden y modifican sus políticas, la percepción que un agente en particular tiene del "entorno" cambia con el tiempo; esto se denomina no estacionariedad.
-
Los entornos se dividen generalmente en cooperativos (todos maximizan una recompensa compartida), competitivos (de suma cero, donde se busca vencer a un oponente) y mixtos (parcialmente cooperativos, parcialmente competitivos), y el algoritmo requerido cambia en consecuencia.
-
El CTDE (Entrenamiento Centralizado con Ejecución Descentralizada), donde el aprendizaje utiliza información global pero la ejecución implica que cada agente actúe únicamente en función de sus propias observaciones, es el marco principal que resulta práctico para hardware y entornos reales.
Cómo distribuir una recompensa compartida entre las contribuciones de cada agente —el problema de asignación de créditos— es el mayor desafío técnico en el aprendizaje por refuerzo multiagente cooperativo. - MADDPG (Lowe et al., 2017) y QMIX (Rashid et al., 2018) son algoritmos representativos que concretan CTDE, desde la perspectiva del Actor-Crítico y la factorización del valor Q, respectivamente.
1. ¿Por qué falla el marco de agente único?
La premisa central del MDP era que la transición del entorno P(s'\mid s,a) y la recompensa R(s,a,s') son fijas, independientemente de la política del agente. Incluso cuando el agente actualiza su política, las leyes físicas del entorno no cambian.
En un entorno con múltiples agentes, esta premisa falla. Lo que el agente i percibe como "el entorno" ahora incluye no solo las leyes físicas, sino también las políticas \pi_{-i} de los demás agentes -i (todos excepto i). Debido a que los demás agentes también aprenden simultáneamente y actualizan continuamente \pi_{-i}, la probabilidad de transición efectiva que experimenta el agente i,
cambia cada vez que cambia \pi_{-i}. Esto se denomina no estacionariedad. Desde la perspectiva del agente i, una acción que funcionó bien ayer podría no funcionar hoy, ahora que la política del otro bando ha cambiado. Incluso almacenar transiciones antiguas en un búfer de repetición puede resultar engañoso, ya que esa experiencia se obtuvo contra un oponente que «ya no existe».

Figura 1: El "entorno" para el agente i incluye no solo las leyes físicas, sino también las políticas de los demás agentes. Mientras los demás sigan aprendiendo, la distribución de transiciones que experimenta i seguirá evolucionando.
2. Cooperativo, competitivo y mixto: La estructura de recompensas define el problema
El carácter de un problema multiagente cambia drásticamente según cómo se asignen las recompensas.
| Entorno | Relación de recompensas | Ejemplo representativo | Dificultad principal |
|---|---|---|---|
| Cooperativo | Todos maximizan una recompensa común o altamente correlacionada | Múltiples robots de almacén que maximizan la eficiencia del transporte | Asignación de crédito, diseño de la comunicación |
| Competitivo | Beneficio de una de las partes La pérdida del otro (suma casi cero) | Juegos competitivos, simulaciones de competencia de precios | Es necesario seguir la adaptación del oponente, equilibrios inestables |
| Mixto / suma general | Parcialmente cooperativo, parcialmente adversario | Múltiples vehículos en una intersección, robots cooperativos compitiendo por un recurso | Alternancia entre situaciones que requieren cooperación y situaciones que requieren competencia |
Los entornos cooperativos suelen formalizarse matemáticamente como un Dec-POMDP (MDP Parcialmente Observable Descentralizado), donde todos buscan el mismo conjunto de políticas óptimas. Los entornos competitivos se evalúan utilizando conceptos cercanos al equilibrio de Nash en la teoría de juegos, donde una única "política óptima" puede incluso no existir, ya que a medida que cambia la política del oponente, también cambia lo que es óptimo para uno mismo. Los entornos mixtos son los más cercanos a la realidad, pero ofrecen las menores garantías teóricas.
3. CTDE: Entrenamiento Centralizado, Ejecución Dejada al Campo
CTDE (Entrenamiento Centralizado con Ejecución Descentralizada) se utiliza ampliamente para abordar la no estacionariedad. Durante el entrenamiento (Dentro de un simulador o durante una fase de entrenamiento offline), se permite usar información centralizada que registra las observaciones, acciones y, a veces, recompensas de cada agente simultáneamente. Sin embargo, en tiempo de ejecución (en hardware real, en un entorno de producción), cada agente decide su acción utilizando únicamente la observación local de sus propios sensores.
La razón práctica por la que CTDE funciona es clara. Dadas las limitaciones de ancho de banda y latencia de la comunicación, a menudo no es realista que una flota real de robots o drones opere compartiendo constantemente el estado de cada agente. Pero dentro de un simulador o un servidor de entrenamiento, se puede usar toda la información sin preocuparse por el costo de la comunicación. CTDE es un diseño que aprovecha al máximo esta "información privilegiada disponible solo durante el entrenamiento", al tiempo que mantiene una política que puede actuar de forma autónoma en tiempo de ejecución.
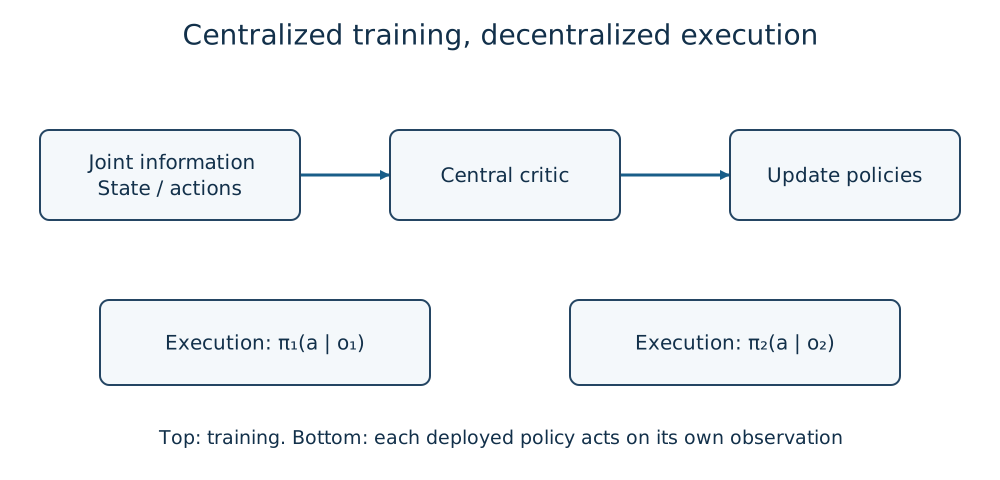
Figura 2 — Durante el entrenamiento, un crítico central (o red de mezcla) integra la información de todos; en el momento de la ejecución, cada agente decide basándose únicamente en la observación local. Separar ambos procesos permite absorber la no estacionariedad durante el entrenamiento, tolerando al mismo tiempo las restricciones de comunicación en tiempo de ejecución.
4. El problema de la asignación de créditos: ¿De quién es el éxito y de quién el fracaso?
En un entorno cooperativo, cuando solo se recibe una recompensa compartida r, no es evidente qué acciones de los agentes n contribuyeron realmente a dicha recompensa. Si se otorga la misma recompensa a todos los agentes, un agente que en realidad no trabajó recibe una evaluación igual de "buena", mientras que la señal de un agente que contribuyó genuinamente queda oculta entre las acciones de los demás. Este es el problema de la asignación de créditos.
Un enfoque consiste en descomponer la función de valor en agentes individuales. QMIX (Rashid et al., 2018) combina el valor Q individual de cada agente (Q_i(o_i,a_i)) mediante una red de mezcla con pesos no negativos para construir el valor Q global (Q_{\text{tot}}).
Esta restricción de monotonicidad garantiza que cada agente que elige la acción que maximiza de forma voraz su propio valor Q (Q_i) no entre en conflicto con la maximización del valor Q global (Q_{\text{tot}}) (la condición IGM: Máximo Individual-Global). En otras palabras, la red de mezcla incorpora, durante el entrenamiento, una estructura tal que cada agente, al actuar exclusivamente sobre su propio valor Q en el tiempo de ejecución descentralizada, no se desvíe demasiado del óptimo global.
En otra dirección, COMA (Foerster et al., 2018) utiliza una línea base contrafactual dentro de un marco Actor-Crítico. Al tomar la diferencia entre la recompensa esperada si la acción del agente i se intercambiara hipotéticamente por otra acción, y la recompensa esperada para la acción realmente elegida, y usar esa diferencia como ventaja, aísla y evalúa «cuánto influyó mi propia acción en la recompensa general», independientemente de las contribuciones de los demás agentes.
Ambos métodos tienen en común que son herramientas para extraer una señal de aprendizaje para cada agente individual a partir de un único valor de recompensa compartida.
5. Algoritmos Representativos
| Algoritmo | Familia | Entorno Principal | Idea Clave |
|---|---|---|---|
| MADDPG (Lowe et al., 2017) | Actor-Crítico (acción continua) | Cooperativo, competitivo, mixto | Un crítico centralizado dedicado por agente; solo su propio actor en el momento de la ejecución |
| QMIX (Rashid et al., 2018) | Basado en valores (acción discreta) | Cooperativo | Combina valores Q individuales con una red de mezcla monótona, satisfaciendo la condición IGM |
| COMA (Foerster et al., 2018) | Actor-Crítico | Cooperativo | Maneja explícitamente la asignación de crédito con una línea base contrafactual |
| Aprendizaje independiente (Aprendizaje Q independiente / IPPO, etc.) | Extensión ingenua de métodos de un solo agente | Aplicable a cualquier cosa | Fácil de implementar, pero ignora la no estacionariedad, por lo que el aprendizaje tiende a volverse inestable |
MADDPG extiende DDPG a múltiples agentes: cada agente i utiliza su propio Crítico centralizado Q_i(s,a_1,\dots,a_n) durante el entrenamiento y actúa únicamente con su propio Actor \pi_i(a_i\mid o_i) en el momento de la ejecución. Este diseño permite aplicar el mismo marco a cualquier estructura de recompensa cooperativa, competitiva o mixta.
QMIX destaca en tareas cooperativas de acción discreta (pruebas de referencia como el StarCraft Multi-Agent Challenge) más que en el control continuo, y a cambio de la suposición relativamente fuerte de la restricción de monotonicidad, garantiza teóricamente la consistencia en el tiempo de ejecución descentralizada.
El "aprendizaje independiente" —el método ingenuo en el que cada agente simplemente ignora la existencia de los demás y ejecuta Q-learning o PPO en paralelo— puede funcionar sorprendentemente bien en algunos casos. Sin embargo, dado que no aborda la no estacionariedad, el aprendizaje tiende a divergir a medida que aumenta el número de agentes o las políticas de los oponentes cambian rápidamente. Los métodos de la familia CTDE pueden entenderse como un intento de mitigar los problemas de este método ingenuo, utilizando información privilegiada disponible durante el entrenamiento.
6. Relación con el control de enjambres multirobot
El control de enjambres (sistemas multirobot), donde varios robots físicos trabajan juntos de forma cooperativa, es una de las áreas de aplicación de MARL. El transporte en almacenes, el vuelo en formación de múltiples drones y la búsqueda y rescate cooperativos con múltiples unidades comparten la estructura de "cada robot solo tiene observaciones locales, la comunicación es limitada y queremos mejorar la eficiencia general", una estructura que encaja bien con la idea de CTDE de entrenamiento centralizado y ejecución descentralizada.
Dicho esto, el control de enjambres tiene muchos elementos que la teoría de aprendizaje de MARL por sí sola no puede manejar completamente: un número variable de individuos (robots que se retiran o se incorporan durante la misión), una topología de comunicación que cambia dinámicamente y la necesidad de colocar restricciones de seguridad, como la prevención de colisiones, fuera de la política aprendida en todo momento. Este sitio aún no cuenta con un artículo dedicado al control de enjambres multirobot, pero MARL se posiciona como una de sus teorías fundamentales.
7. Lista de verificación de implementación y evaluación
-
¿Ha separado y registrado claramente las observaciones, acciones y recompensas de cada agente durante el tiempo de entrenamiento (con información central) y el tiempo de ejecución (solo observación local)?
-
¿Ha definido previamente si la recompensa es cooperativa, competitiva o mixta, y ha elegido un algoritmo adecuado (de la familia QMIX, MADDPG o aprendizaje independiente)?
-
¿Ha monitorizado la curva de aprendizaje no solo como recompensa global, sino también por la contribución de cada agente, la proporción de acciones y la tasa de éxito individual, para confirmar que ningún agente está perdiendo el tiempo en su aprendizaje?
-
¿Ha realizado evaluaciones en condiciones con diferentes números de agentes o topologías, para confirmar que no se ha producido un sobreajuste al número de agentes durante el entrenamiento?
- Para hardware y entornos reales, ¿ha considerado la latencia y la pérdida de comunicación, y ha confirmado que cada agente puede volver a un comportamiento seguro incluso durante una interrupción de la comunicación (con restricciones de seguridad fuera de la política aprendida)?
Resumen
El aprendizaje por refuerzo multiagente comienza donde la suposición implícita de un MDP de un solo agente —«el entorno es fijo»— deja de ser válida. La no estacionariedad, donde el aprendizaje de los demás agentes modifica constantemente lo que se considera su propio entorno; la diferencia entre estructuras de recompensa cooperativas, competitivas y mixtas; y el problema de la asignación de créditos sobre cómo distribuir una recompensa compartida entre las contribuciones individuales: CTDE es la respuesta práctica a todos estos problemas, y MADDPG y QMIX son sus implementaciones concretas. En aplicaciones que involucran múltiples agentes físicos, como el control de enjambres de robots múltiples, también conviene tener en cuenta que los desafíos a nivel de implementación —un número variable de individuos, comunicación dinámica y restricciones de seguridad— se suman a la teoría del aprendizaje.
¿Se puede transferir un método de un solo agente sin cambios a muchos agentes?
Otros agentes de aprendizaje modifican el entorno.
Distinga entre cooperación, competencia, límites de observación e información de entrenamiento frente a información de ejecución. ## Referencias - [Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (NeurIPS, 2017)](https://arxiv.org/abs/1706.02275) - [Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning (ICML, 2018)](https://arxiv.org/abs/1803.11485) - [Foerster et al., Counterfactual Multi-Agent Policy Gradients (AAAI, 2018)](https://arxiv.org/abs/1705.08926) - [OpenAI Spinning Up — Key Concepts in RL](https://spinningup.openai.com/en/latest/spinningup/rl_intro.html) - [The Basics of Reinforcement [Aprendizaje](/es/blog/posts/reinforcement-learning-basics.html), [Introducción al aprendizaje Q y DQN](/es/blog/posts/reinforcement-q-learning-dqn.html), [Introducción al gradiente de política/PPO/SAC](/es/blog/posts/reinforcement-policy-gradient-ppo-sac.html)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.