Contents — find the section you need
Aspiradores robóticos, drones, carros autônomos e óculos de realidade aumentada compartilham um requisito: responder à pergunta "onde estou agora?". O GPS não funciona em ambientes internos ou em cidades densamente povoadas, e um mapa nem sempre está disponível. O SLAM visual é a tecnologia que responde a essa pergunta usando apenas imagens de câmeras (às vezes combinadas com sensores auxiliares baratos). Este artigo começa explicando por que um robô perde a noção de sua própria posição, depois aborda o rastreamento de características, a matemática da geometria da câmera, a diferença entre odometria visual e SLAM, a linhagem dos algoritmos de pontos de referência e, finalmente, como escolher um na prática.
 Câmera de entrada Visual-SLAM
 Exemplo de câmera veicular
Imagens: Intel Câmera de profundidade RealSense D435 (Marc Auledas, CC BY-SA 4.0) / Car Câmera de janela do sistema Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Câmeras representativas, não uma configuração de hardware necessária para o Visual-SLAM.


0. O que este artigo aborda
- O que é Visual-SLAM e por que uma câmera sozinha pode estimar sua própria posição
- Como a Odometria Visual (VO) difere do SLAM
- O que ORB-SLAM, LSD-SLAM, DSO, SVO e DROID-SLAM contribuem como opções de design
- A diferença entre abordagens baseadas em características, diretas e baseadas em aprendizado
- Onde o Visual-SLAM encontra dificuldades e por quê
- Como escolher um método para um robô, um drone, AR/VR ou um carro autônomo
1. O que o Visual-SLAM realmente faz
Em uma frase: O Visual-SLAM estima a trajetória da câmera no espaço (Localização) e a estrutura 3D do ambiente ao seu redor (Mapeamento) simultaneamente, usando apenas a sequência de imagens capturadas pela câmera.
O próprio nome — Localização e Mapeamento Simultâneos — aponta para o que mais importa: a palavra "Simultâneo". Se o mapa já fosse conhecido, encontrar sua própria posição seria um problema relativamente fácil; se sua posição já fosse conhecida com precisão, construir o mapa também seria fácil. O Visual-SLAM não tem essa vantagem — construir o mapa exige saber sua posição, e saber sua posição exige o mapa. Essa dependência do tipo "ovo e galinha" precisa ser desvendada a partir do mesmo fluxo de observações, simultaneamente.
A entrada é uma série temporal de imagens de uma câmera (monocular, estéreo ou RGB-D), e a saída são duas coisas: a pose da câmera com 6 graus de liberdade (3 para posição, 3 para orientação) a cada instante, e um mapa representando o ambiente (um conjunto esparso de pontos de referência ou uma forma 3D densa). Um robô aspirador aprendendo o layout de um cômodo enquanto limpa, um drone estabilizando seu voo estacionário em ambientes internos ou subterrâneos onde o GPS não alcança, um headset de RA sobrepondo objetos virtuais ao mundo real sem desvios — em todos esses casos, o Visual-SLAM está em execução nos bastidores.
2. Por que um robô não sabe onde está?
Para entender o problema que o Visual-SLAM realmente resolve, é útil perguntar concretamente: por que um robô perde a noção de sua própria posição?
Primeiro, existem muitos ambientes sem GPS, ou sem GPS confiável. Ambientes internos, subterrâneos, em túneis, nos cânions urbanos entre arranha-céus (onde reflexões de múltiplos caminhos aumentam o erro de posicionamento), ou debaixo d'água e em outros planetas onde nem sequer existe uma constelação de satélites — nenhum desses locais oferece uma maneira de obter uma posição absoluta diretamente.
Segundo, há o problema da simples inexistência de um mapa. Uma estrutura recém-construída, um local de desastre, uma superfície planetária inexplorada — dados de mapas pré-construídos nem sempre estão disponíveis. Sem um mapa, "verificar sua posição em relação ao mapa" sequer é uma opção.
Terceiro — e mais fundamental — uma única leitura de sensor não pode determinar a posição absoluta, nem mesmo em princípio. Uma câmera só informa o que está ao seu redor no momento. Olhar para uma imagem não lhe diz instantaneamente "isto está a 2,3 metros daquela parede, na sala de estar" — reconhecer aquela parede como "aquela parede" requer tê-la visto antes e lembrar onde você estava quando a viu. Em outras palavras, transformar uma observação atual em informações de posição significativas requer uma correspondência com observações passadas (onde você está agora depende de onde você esteve) — e essa correspondência é exatamente o que um mapa fornece.
A essência do problema do SLAM é construir essa correspondência entre "o que eu vejo agora" e "o que eu mapeei antes", de forma contínua e consistente, apenas a partir de dados de observação, sem que nenhuma posição absoluta externa seja fornecida. Uma única correspondência equivocada propaga seu erro para todas as estimativas subsequentes — e como suprimir esse erro acumulado e como corrigi-lo posteriormente é a questão central de design por trás de todo algoritmo de SLAM visual.
3. O que encontrar em uma imagem de câmera
A saída bruta de uma câmera nada mais é do que uma grade de valores de pixels — brilho, cor. O primeiro passo para descobrir "como me movi" é encontrar pistas rastreáveis dentro dessa grade.
Uma Característica é um ponto local na imagem que se destaca claramente do seu entorno e pode ser detectado novamente de forma confiável mesmo com a mudança do ponto de vista — um canto, uma interseção de borda, um local onde os gradientes de brilho mudam bruscamente em múltiplas direções. Uma área uniforme de céu azul, indistinguível de seus vizinhos, não pode servir como uma característica.
A Detecção de Características encontra pontos candidatos a características dentro de uma única imagem. Algoritmos como ORB (Oriented FAST and Rotated BRIEF), SIFT e o detector de cantos FAST decidem quais pixels "parecem" características e calculam um descritor — um resumo numérico da aparência local ao redor de cada um.
O Rastreamento de Características encontra e identifica essas mesmas características no próximo quadro no tempo. Existem duas abordagens principais: a correspondência de características detectadas por similaridade de descritores (Correspondência de Características) e a busca em sua vizinhança a partir da posição de uma característica no quadro anterior (Fluxo Óptico, classicamente pelo método de Lucas-Kanade).
Essa relação — o mesmo ponto no mundo real aparecendo em locais diferentes em quadros diferentes — é chamada de Correspondência. Quase todos os cálculos geométricos em SLAM visual utilizam um conjunto de correspondências como entrada; sem uma única correspondência, em princípio, não há nenhuma pista sobre como a câmera se moveu.
O Fluxo Óptico é um campo vetorial que descreve a distância e a direção em que cada ponto na imagem (ou um conjunto esparso de pontos) se moveu entre os quadros — não apenas as características. Enquanto o rastreamento baseado em características segue apenas os pontos mais distintos, o fluxo óptico pode explorar informações de movimento em uma área maior, geralmente com um custo computacional mais elevado.
4. Calculando o Movimento da Câmera
Uma vez obtidas as correspondências, elas podem ser transformadas, geometricamente, em uma estimativa de como a câmera se moveu. A base para esse cálculo é a Geometria Epipolar.
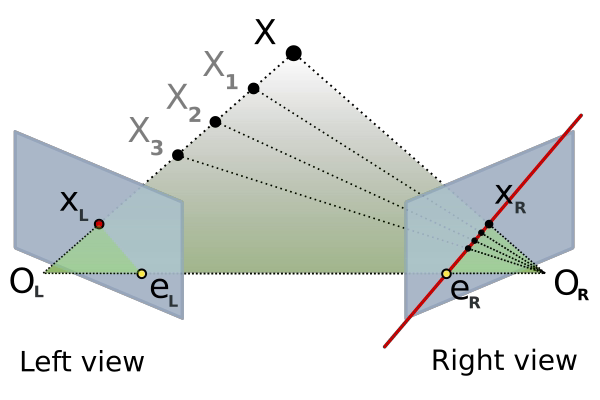
Figura 1 — Dois pontos de vista da câmera O_1 e O_2 , um ponto X no espaço e suas projeções x_1 , x_2 em cada plano da imagem. Dado x_1 , seu ponto correspondente x_2 é sempre restrito a estar em uma única linha na segunda imagem (a linha epipolar).
Figura: Epipolar geometria (Arne Nordmann, CC BY-SA 3.0 / GFDL), Wikimedia Commons. O SVG original foi convertido para PNG com fundo branco para exibição confiável no navegador.

Quando o mesmo ponto X no espaço é fotografado de dois pontos de vista diferentes, o ponto correspondente \mathbf{x}_2 em uma imagem, dado um ponto \mathbf{x}_1 na outra, não pode estar em qualquer lugar da imagem — ele deve estar em uma única linha (a linha epipolar). A matriz que codifica essa restrição geométrica é a Matriz Essencial E. Quando os parâmetros intrínsecos da câmera são conhecidos, os pontos correspondentes em coordenadas normalizadas da câmera satisfazem:
Aqui, R e \mathbf{t} representam a rotação e a translação da câmera 1 para a câmera 2, e [\mathbf{t}]_{\times} é a matriz antissimétrica construída a partir de \mathbf{t}, que representa um produto vetorial como uma multiplicação de matrizes. Esta equação afirma que essa restrição sempre se mantém entre uma correspondência \mathbf{x}_1, \mathbf{x}_2 e a rotação e translação relativas da câmera. O número necessário de correspondências depende do estimador: uma Matriz Essencial calibrada possui um solucionador mínimo de 5 pontos, enquanto a estimativa linear de 8 pontos utiliza pelo menos 8 correspondências. Dados reais contêm outliers, portanto, sistemas práticos coletam mais correspondências e as combinam com RANSAC ou outro estimador robusto. Quando os valores intrínsecos são desconhecidos, ou quando se trabalha diretamente com coordenadas de pixel, a Matriz Fundamental F = K_2^{-\top} E K_1^{-1}, que engloba a matriz intrínseca K, desempenha a mesma função.
A translação \mathbf{t} recuperada da Matriz Essencial não possui uma unidade do mundo real (metros, por exemplo) — duas imagens sozinhas não podem dizer se a câmera se moveu um metro ou dois. Essa ambiguidade de escala é uma restrição específica do SLAM Visual, particularmente em configurações monoculares, e será revisitada na Seção 5.
O cálculo da posição 3D real de uma correspondência — as coordenadas do ponto X no espaço — é chamado de Triangulação. Estendendo os dois raios que partem de cada ponto de vista em direção a X, esses dois raios devem, idealmente, se cruzar exatamente no ponto X; A descoberta dessa interseção recupera a posição 3D da correspondência (na prática, o ruído de observação significa que os raios não se encontram exatamente, então o ponto mais próximo de ambos, no sentido dos mínimos quadrados, é encontrado).
Se houver uma correspondência disponível entre um ponto de referência cuja posição 3D já é conhecida e onde ele aparece na imagem, a pose da câmera pode ser calculada diretamente a partir dela. Este é o problema PnP (Perspectiva-n-Ponto): dados n pontos 3D e suas posições projetadas na imagem, determine a posição e a orientação da câmera. Uma vez que um mapa já exista, o PnP torna-se a ferramenta central para calcular a pose da câmera em cada novo quadro.
5. Odometria Visual
Simplesmente repetir "calcular o movimento da câmera a partir das correspondências", quadro após quadro, já é suficiente para estimar a trajetória da câmera. Isso é Odometria Visual (OV).
A VO (Otimização Vocacional) combina apenas o movimento relativo entre o quadro atual e o anterior (ou os últimos quadros) para construir a trajetória da câmera. Geralmente, ela não possui um mecanismo para manter um mapa persistente ou para reconhecer um local visitado anteriormente — seu funcionamento se assemelha mais ao de um odômetro de carro, que calcula continuamente "quanto eu me movi desde agora".
A distinção entre VO e SLAM reside precisamente nisso: se o sistema mantém um mapa e possui um mecanismo para recuperar a consistência com o passado. A VO é leve e simples de implementar, mas como a estimativa de cada quadro sempre depende da anterior, pequenos erros se acumulam indefinidamente ao longo do tempo. Esse erro acumulado é chamado de Deriva. Se um robô retorna ao seu ponto de partida, a VO sozinha não tem como reconhecer "Estou de volta ao ponto de partida" — a trajetória estimada permanece deslocada em relação ao início e nunca se completa.
Há outro problema específico da VO, especialmente da VO monocular, que já foi abordado na Seção 4: o problema da Escala. As imagens de uma câmera monocular sozinhas não conseguem recuperar uma unidade de comprimento absoluta do mundo real — nada na aparência da imagem distingue "movido 2 metros, o objeto parece duas vezes maior" de "movido 4 metros, o objeto parece quatro vezes maior". Uma câmera estéreo (que possui uma distância de referência conhecida entre suas duas lentes para ancorar a escala), uma câmera RGB-D (cujo sensor de profundidade fornece distâncias do mundo real diretamente) ou o emparelhamento com uma IMU (cuja aceleração em escala real permite que a escala seja estimada) podem resolver essa ambiguidade de escala.
6. O que o SLAM adiciona ao VO
É útil pensar no SLAM como VO mais os seguintes elementos adicionais.
Um Mapa é uma representação acumulada da posição 3D de cada feição observada até o momento (ou uma forma 3D densa). Em vez de comparar apenas com o quadro imediatamente anterior, como o VO faz, o sistema agora pode comparar com tudo o que foi acumulado no mapa.
Um Ponto de Referência é um elemento individual desse mapa — geralmente um ponto de feição com uma posição 3D. A cada novo quadro capturado, a comparação com os pontos de referência visíveis nesse quadro permite que o sistema estime a posição da câmera de forma consistente, não apenas com o quadro anterior, mas com todo o mapa construído ao longo do histórico do robô.
O Fechamento de Loop é a principal vantagem do SLAM sobre a VO (Otimização Voz). Quando um robô retorna a um local já visitado, a similaridade de imagens é usada para detectar esse fato, e uma nova restrição é adicionada ao mapa, conectando "onde estou agora" a "onde eu estava quando visitei este local pela primeira vez". A adição dessa restrição permite que o sistema redistribua o desvio acumulado ao longo de todo o loop e o corrija.
O resultado dessa correção é a Consistência Global. Antes do fechamento de loop, o erro acumulado significa que duas posições no mapa que deveriam ser o mesmo local físico acabam registradas como locais ligeiramente diferentes. A correção por fechamento de loop detecta essa discrepância e remodela todo o mapa em uma forma autoconsistente — esse mecanismo de fechamento de loop é exatamente o motivo pelo qual o SLAM pode oferecer não apenas "um registro de movimento", mas "um mapa consistente".
7. A Estrutura Básica do Visual-SLAM
Ao juntar essas peças, revela-se um fluxo de trabalho compartilhado, em linhas gerais, por todos os principais sistemas modernos de Visual-SLAM.
Figura 2 — As imagens da câmera são comparadas com o quadro anterior (Rastreamento Direto/de Recursos, usando uma das abordagens das Seções 3 e 8), o que direciona a Estimativa de Pose (geometria epipolar e PnP da Seção 4) e, em paralelo, o Mapeamento Local (adicionando e atualizando pontos de referência recentemente capturados). área observada). Quando um loop é detectado, o Fechamento de Loop é acionado e a camada de Otimização no Backend (Seção 10) — Ajuste de Pacote ou otimização do Grafo de Pose — corrige as poses acumuladas e o mapa em um todo consistente.
As imagens da câmera passam primeiro pelo Rastreamento de Características/Direto (qualquer uma das abordagens abordadas nas Seções 3 e 8) para estabelecer correspondências com o quadro anterior. A partir dessas correspondências, a Estimativa de Pose (usando a geometria epipolar e PnP da Seção 4) calcula a pose da câmera, enquanto o Mapeamento Local (adicionando e atualizando pontos de referência na região observada recentemente) prossegue em paralelo. Quando um loop é detectado, o Fechamento de Loop é acionado e o estágio de Otimização do Backend (Seção 10) corrige as poses acumuladas e o mapa em um todo globalmente consistente. O resultado final desse pipeline é a saída final: a Pose (trajetória) e o Mapa (a estrutura 3D do ambiente) da câmera.
8. Algoritmos Marcantes
A história do Visual-SLAM é mais fácil de acompanhar ao longo de um eixo: o quanto é projetado explicitamente e o quanto é delegado ao aprendizado.
PTAM (Parallel Tracking and Mapping, Klein & Murray, 2007) foi um sistema pioneiro que executava o Rastreamento (estimativa de pose) e o Mapeamento (construção de mapas) como threads paralelas separadas. O Rastreamento é executado rapidamente, a cada quadro, enquanto o Ajuste de Pacotes para Mapeamento, computacionalmente custoso, é executado em uma thread em segundo plano com mais tempo disponível — essa ideia de separar o Rastreamento do Mapeamento foi herdada por muitos sistemas Visual-SLAM posteriores.
ORB-SLAM (Mur-Artal, Montiel & Tardós, 2015) foi construído em torno de recursos ORB, combinando uma estrutura de três threads (Rastreamento, Mapeamento Local, Fechamento de Loop) com Reconhecimento de Lugar (correspondência com quadros anteriores via Bag-of-Words) para alcançar um desempenho monocular prático. ORB-SLAM2 (Mur-Artal & Tardós, 2017) estendeu essa estrutura além de câmeras monoculares para câmeras estéreo e RGB-D. ORB-SLAM3 (Campos, Elvira, Gómez Rodríguez, Montiel & Tardós, 2021) adicionou acoplamento estreito com uma IMU (SLAM Visual-Inercial) e Multi-Map SLAM, que mantém múltiplos mapas e os mescla conforme necessário — e permanece, até hoje, a implementação de referência para SLAM baseado em características.
LSD-SLAM (Large-Scale Direct monocular SLAM, Engel, Schöps & Cremers, 2014) é um exemplo marcante do método Direto, mostrando que a pose da câmera pode ser estimada diretamente usando o brilho da imagem, sem a etapa de detecção de características, em grande escala. Ao omitir completamente a extração de características, o método permite explorar informações mesmo em situações onde as características são escassas.
** DSO (Odometria Esparsa Direta, Engel, Koltun e Cremers, apresentada pela primeira vez em 2016, publicada em 2018) mantém a abordagem direta, mas, em vez da estimativa semi-densa produzida pelo LSD-SLAM, minimiza o erro fotométrico em um conjunto esparso de pontos, alcançando precisão e eficiência computacional.
SVO (Odometria Visual Monocular Semi-Direta Rápida, Forster, Pizzoli e Scaramuzza, 2014) combina a detecção de características com um método direto em uma abordagem semi-direta, rastreando o brilho em áreas ao redor das características detectadas para obter operação rápida em altas taxas de quadros — projetada para plataformas com recursos limitados, como drones.
** O DROID-SLAM (Teed & Deng, 2021)** substitui completamente a etapa explícita de extração e correspondência de características por aprendizado profundo, estimando a pose da câmera e a profundidade por pixel por meio de um volume de correlação, um operador de atualização recorrente e uma camada de Ajuste de Pacotes diferenciável — a abordagem representativa baseada em aprendizado (seus mecanismos internos são abordados com mais detalhes em Visual-SLAM Trends).
9. Baseado em Características vs. Direto vs. Baseado em Aprendizado
Em resumo, esses algoritmos se enquadram em uma das três filosofias de design.
| Aspecto | Baseado em Características (ex.: ORB-SLAM3) | Direto (ex.: DSO/LSD-SLAM) | Baseado em Aprendizado (ex.: DROID-SLAM) |
|---|---|---|---|
| Princípio | Detecta e descreve características, calcula a pose a partir da relação geométrica entre as correspondências | Ignora completamente as características, minimiza o brilho da imagem diretamente para encontrar a pose | Uma rede neural aprende a substituir a extração de características, a correspondência e a estimativa de pose/profundidade |
| Precisão | Alta onde as características são abundantes; tende a produzir um mapa esparso | Funciona onde houver um gradiente de brilho; pode produzir mapas semi-densos a densos | Razoavelmente robusto mesmo em ambientes com pouca textura; fácil de obter profundidade densa |
| Custo computacional | Moderado (extração de características, descritores, correspondência) | Varia de acordo com a implementação, geralmente leve (o DSO, em particular, otimiza a eficiência) | Alto (somente a inferência geralmente precisa de vários a mais de uma dúzia de GB de memória da GPU) |
| Robustez | Fraca em ambientes com pouca textura ou com objetos dinâmicos; comparativamente forte contra mudanças de iluminação | Sensível a mudanças de brilho (exposição automática, iluminação) | Forte dentro do intervalo de seus dados de treinamento, mas a generalização para ambientes não vistos pode ser limitada |
| Dificuldade de implementação | Muitas implementações maduras de código aberto, fáceis de adotar | A matemática (linearização do brilho) é um pouco mais complexa | É fácil usar um modelo pré-treinado; o retreinamento ou ajuste interno requer mais experiência |
Os métodos baseados em características têm o histórico mais longo, incluindo muitas implementações em sistemas embarcados; os métodos diretos se saem melhor onde a textura é escassa; os métodos baseados em aprendizado estão melhorando rapidamente, mas exigem maior poder computacional — esse é aproximadamente o cenário atual em 2026.
10. O Backend
O que determina a precisão do Visual-SLAM não é apenas o frontend (extração de características, rastreamento, estimativa de pose) — é o Backend, que aprimora todo o conjunto acumulado de observações em algo autoconsistente.
O Ajuste de Pacote otimiza conjuntamente as poses da câmera e as posições 3D dos pontos de referência para que sejam o mais consistentes possível com cada observação. Minimiza o erro total de reprojeção — a discrepância entre um ponto de referência \mathbf{X}_i projetado em uma imagem pela pose da câmera (R_j, \mathbf{t}_j) e onde a característica correspondente foi realmente observada, \mathbf{u}_{ij}.
\pi(\cdot) é a função de projeção de um ponto 3D para o plano da imagem, com base nos parâmetros intrínsecos da câmera. O Ajuste de Feixe Global, que otimiza cada quadro e cada ponto de referência simultaneamente, é altamente preciso, mas custoso; na prática, geralmente é combinado com o Ajuste de Feixe Local, restrito apenas aos quadros mais recentes, para manter o processamento gerenciável.
Quando um fechamento de loop é detectado, a otimização do Grafo de Pose entra em ação. Ao contrário do Bundle Adjustment, que inclui todos os pontos de referência, a otimização do Pose Graph trata apenas a pose da câmera em cada instante como um nó, com arestas codificando restrições de pose relativa entre os quadros — otimizando apenas a pose, rapidamente. A nova restrição adicionada pelo fechamento do loop redistribui a deriva acumulada por todo o loop.
Ambos os problemas são resolvidos dentro da estrutura da Otimização Não Linear. Como a função de projeção \pi(\cdot) e a composição de rotações em uma pose são inerentemente não lineares, métodos iterativos como Gauss-Newton e Levenberg-Marquardt são usados, e bibliotecas como g2o e Ceres Solver são amplamente utilizadas em implementações de Visual-SLAM.
11. Onde o Visual-SLAM Encontra Dificuldades
Como o Visual-SLAM depende de um sensor passivo — uma câmera — sua precisão se degrada sistematicamente em algumas situações.
- Escuridão: Sem luz suficiente, a relação sinal-ruído da imagem se degrada, desestabilizando tanto a detecção de características quanto os cálculos de gradiente de brilho dos quais os métodos diretos dependem. Câmeras RGB-D com iluminação infravermelha podem compensar parcialmente, mas o efeito é limitado em ambientes externos à noite.
- Pouca textura: Paredes brancas, pisos lisos, superfícies de vidro — em qualquer lugar onde os gradientes de brilho sejam escassos, as características não podem ser encontradas ou a minimização do método direto se torna mal condicionada e propensa a mínimos locais.
- Movimento rápido: Movimentos ou rotações rápidas da câmera ampliam o alcance de busca necessário para encontrar correspondências entre os quadros e, combinados com o desfoque de movimento (abaixo), o rastreamento falha facilmente. O uso de uma IMU (VIO) é a maneira padrão de compensar essa fraqueza.
- Objetos dinâmicos: Tratar as características de um pedestre ou carro em movimento como se pertencessem ao ambiente estático introduz erros na estimativa do próprio movimento da câmera. Isso requer pré-processamento para detectar e excluir objetos dinâmicos ou extensões que os modelem explicitamente.
- Desfoque de movimento: Desfoque causado pelo movimento da câmera ou do objeto durante o período de exposição, o que desestabiliza os descritores de características e degrada a precisão da correspondência. Câmeras com obturador global ou ambientes com muita luz e tempos de exposição curtos reduzem o impacto.
Todos esses problemas têm um ponto em comum: a câmera simplesmente não está recebendo informações visuais suficientes para trabalhar. Um sensor de alcance ativo como o LiDAR (consulte Tendências da Tecnologia LiDAR-SLAM) contorna a maioria dessas fraquezas em princípio, mas apresenta seu próprio conjunto de fraquezas (consulte a Seção 2) — nenhum sensor único é universalmente suficiente, e essa complementaridade é exatamente o motivo pelo qual a Fusão de Sensores (consulte o Guia de Fusão de Sensores) é importante.
12. Escolhendo um Método na Prática
A escolha de uma abordagem de SLAM visual depende muito dos sensores disponíveis, da capacidade computacional e da precisão e desempenho em tempo real exigidos pela aplicação.
-
Robôs (robôs de serviço interno, robôs de limpeza): Frequentemente limitados a configurações de câmeras de baixo custo, métodos da família ORB-SLAM baseados em características ou mapeamento denso via câmeras RGB-D são opções práticas. Em ambientes com muitos corredores e pouca textura, vale a pena considerar o uso de LiDAR.
-
Drones: Restrições severas de capacidade computacional e peso da carga útil impulsionam o uso de métodos semidiretos leves, como SVO, ou configurações VIO fortemente acopladas com uma IMU.
-
AR/VR: Desempenho em tempo real e baixa latência são prioridades máximas, e uma configuração visual-inercial combinada com a IMU integrada do headset tornou-se o padrão de fato. Especificamente em Realidade Aumentada (RA), a Consistência Global determina diretamente se os objetos virtuais se desviam, portanto, a precisão do fechamento do loop também é muito importante.
- Condução autônoma: Raramente usada como Visual-SLAM independente; as informações visuais baseadas em câmeras são normalmente integradas a uma configuração de fusão multissensor juntamente com LiDAR, radar e GNSS (consulte o Guia de Fusão de Sensores).
- Ambiente interno vs. externo: Em ambientes internos, as mudanças de iluminação são suaves e há muita estrutura, portanto, os métodos baseados em recursos tendem a funcionar bem; em ambientes externos, a variação de iluminação, os objetos dinâmicos e a grande escala se tornam desafios, tornando a robustez do fechamento do loop muito mais importante.
A partir de 2026, o eixo de decisão aproximado será o seguinte: escolha o método baseado em aprendizado se houver abundância de poder computacional e a máxima precisão for o objetivo; o método baseado em recursos se o histórico de desempenho e o baixo consumo de recursos forem mais importantes; e o método direto se a resiliência em ambientes com pouca textura for essencial. As últimas tendências de pesquisa — remodelando a representação de mapas com 3D Gaussian Splatting/NeRF, modelos de base 3D feed-forward e muito mais — são abordadas em Tendências do SLAM Visual.
Cinco verificações antes da implementação
Escolher apenas pelo nome do algoritmo dificulta o diagnóstico de falhas em campo. Antes da implementação, certifique-se de que estes cinco itens possam ser registrados; quando o rastreamento falhar, você poderá separar um problema do sensor de um problema do estimador.
| Verificar | Informações a preparar | O que acontece se forem ignoradas |
|---|---|---|
| Calibração | Intrínsecos K , distorção da lente e a linha de base estéreo, se aplicável | O erro de reprojeção parece um erro de pose e a escala não pode ser avaliada |
| Sincronização de tempo | Timestamps dos quadros, deslocamento câmera-IMU e quadros descartados | Durante movimentos rápidos, a imagem e os dados inerciais descrevem poses diferentes |
| Obturador e exposição | Obturador global/rolante, tempo de exposição e configurações de exposição automática | Desfoque de movimento ou distorção geométrica são confundidos com uma falha do algoritmo |
| Objetos dinâmicos | Se máscaras são usadas, a fração de objetos em movimento e correspondências rejeitadas | Pedestres ou veículos são absorvidos pelo mapa estático |
| Registros de avaliação | Verdade fundamental, ATE/RPE, tempos de perda de rastreamento e resultados de detecção de loop | “Ele se moveu” não é suficiente para comparar precisão, deriva ou recuperação |
Preencher esta tabela primeiro também facilita a separação do que deve mudar e do que pode permanecer fixo ao alternar de métodos baseados em recursos para métodos diretos ou baseados em aprendizado. O Visual-SLAM deve ser selecionado como um sistema — câmera, temporização, pré-processamento, otimização e avaliação incluídos — em vez de um algoritmo isolado.
13. Resumo
O Visual-SLAM rastreia correspondências apenas a partir de imagens da câmera, recupera o movimento da câmera por meio de geometria epipolar e PnP, e corrige continuamente o erro acumulado através de um mapa e fechamento de loop — alcançando localização e mapeamento simultâneos. As três filosofias de design — Baseada em Características (família ORB-SLAM), Direta (DSO/LSD-SLAM) e Baseada em Aprendizado (DROID-SLAM) — baseiam-se em diferentes compensações e são mais fáceis de entender considerando se as características são tratadas explicitamente, se o brilho é usado diretamente e quanto é delegado ao aprendizado. A escolha entre elas depende da aplicação específica, ponderada pelos sensores disponíveis, capacidade computacional e a precisão e o desempenho em tempo real necessários.
14. Referências
Os principais artigos e páginas de pesquisa sobre os métodos representativos e a geometria de duas vistas discutidos acima estão reunidos aqui como pontos de partida para implementação e leitura complementar. Para evitar confundir a afirmação de um artigo com o desempenho em um produto ou conjunto de dados específico, leia o texto vinculado juntamente com suas condições experimentais.
-
ORB-SLAM3: Uma Biblioteca de Código Aberto Precisa para SLAM Visual, Visual-Inercial e Multi-Mapa — uma biblioteca que abrange designs visuais, visuais-inerciais e multi-mapa.
-
DROID-SLAM: SLAM Visual Profundo para Câmeras Monoculares, Estéreo e RGB-D — um método baseado em aprendizado que combina volumes de correlação com ajuste de feixe denso diferenciável.
-
LSD-SLAM: SLAM Monocular Direto em Grande Escala — a página oficial de pesquisa para SLAM monocular direto e semi-denso.
-
Odometria Esparsa Direta — o artigo da DSO sobre otimização de erro fotométrico por janela deslizante.
-
Uma solução eficiente para o problema de pose relativa de cinco pontos — o artigo original sobre o solucionador de Matriz Essencial de 5 pontos.
Um mapa atraente estabelece uma localização precisa?
Avalie a aparência do mapa separadamente do erro de trajetória. Verifique a escala, o alinhamento, o erro local e a deriva a longo prazo.
Comentários
Entre na sua conta para continuar.
Ainda não há dados.