Contents — find the section you need
Robot aspirapolvere, droni, auto a guida autonoma e occhiali per la realtà aumentata condividono un requisito fondamentale: rispondere alla domanda "dove mi trovo in questo momento?". Il GPS non funziona al chiuso o nelle città densamente popolate, e una mappa non è sempre disponibile. La tecnologia Visual-SLAM risponde a questa domanda utilizzando esclusivamente immagini acquisite da telecamere (a volte abbinate a sensori ausiliari economici). Questo articolo parte dal perché un robot perda la tracciatura della propria posizione, per poi passare al tracciamento dei punti di riferimento, alla matematica della geometria della telecamera, alla differenza tra odometria visiva e SLAM, all'origine degli algoritmi di riconoscimento dei punti di riferimento e, infine, a come sceglierne uno nella pratica.
 Telecamera di input Visual-SLAM
 Esempio di telecamera veicolare
Immagini: Intel Telecamera di profondità RealSense D435 (Marc Auledas, CC BY-SA 4.0) / Car Telecamera a finestra del sistema Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Telecamere rappresentative, non una configurazione hardware obbligatoria per Visual-SLAM.


0. Cosa tratta questo articolo
- Cos'è Visual-SLAM e perché una telecamera da sola può stimare la propria posizione
- In che modo l'odometria visiva (VO) si differenzia da SLAM
- Cosa apportano ORB-SLAM, LSD-SLAM, DSO, SVO e DROID-SLAM come scelte di progettazione
- La differenza tra approcci basati su caratteristiche, diretti e basati sull'apprendimento
- Dove Visual-SLAM presenta delle difficoltà e perché
- Come scegliere effettivamente un metodo per un robot, un drone, AR/VR o un'auto a guida autonoma
1. Cosa fa effettivamente Visual-SLAM
In una frase: Visual-SLAM stima simultaneamente la traiettoria di una telecamera nello spazio (localizzazione) e la struttura 3D dell'ambiente circostante (mappatura), utilizzando solo la sequenza di immagini catturate dalla telecamera.
Il nome stesso — Localizzazione e Mappatura Simultanea — indica ciò che conta Il punto cruciale: la parola chiave è "simultaneo". Se la mappa fosse già nota, trovare la propria posizione sarebbe un problema relativamente semplice; se la propria posizione fosse già nota con precisione, anche costruire la mappa sarebbe facile. Visual-SLAM non gode di nessuno di questi vantaggi: costruire la mappa richiede di conoscere la propria posizione, e conoscere la propria posizione richiede la mappa. Questa dipendenza, simile al dilemma dell'uovo e della gallina, deve essere risolta dallo stesso flusso di osservazioni, simultaneamente.
L'input è una serie temporale di immagini provenienti da una telecamera (monoculare, stereo o RGB-D), e l'output è costituito da due elementi: la posizione della telecamera a 6 gradi di libertà (3 per la posizione, 3 per l'orientamento) a ogni intervallo di tempo, e una mappa che rappresenta l'ambiente circostante (un insieme sparso di punti caratteristici o una forma 3D densa). Un robot aspirapolvere che impara la planimetria di una stanza mentre pulisce, un drone che stabilizza il suo volo stazionario in ambienti interni o sotterranei dove il GPS non arriva, un visore AR che sovrappone oggetti virtuali al mondo reale senza deriva: in ognuno di questi casi, Visual-SLAM è in esecuzione in sottofondo.
2. Perché un robot non sa dove si trova?
Per comprendere il problema che Visual-SLAM risolve, è utile chiedersi concretamente: perché un robot perde la traccia della propria posizione?
Innanzitutto, esistono molti ambienti privi di GPS, o comunque non affidabili. Ambienti interni, sotterranei, gallerie, canyon urbani tra i grattacieli (dove le riflessioni multipath amplificano l'errore di posizionamento), sott'acqua e su altri pianeti dove non esiste nemmeno una costellazione di satelliti: nessuno di questi ambienti offre un modo per ottenere direttamente una posizione assoluta.
In secondo luogo, c'è il problema della semplice assenza di una mappa. Una struttura appena costruita, un sito colpito da un disastro, una superficie planetaria inesplorata: i dati cartografici preesistenti non sono sempre disponibili. Senza una mappa, "verificare la propria posizione sulla mappa" non è nemmeno un'opzione.
In terzo luogo, e aspetto fondamentale, una singola lettura di un sensore non può determinare la posizione assoluta, nemmeno in linea di principio. Una fotocamera ti mostra solo ciò che la circonda in quel preciso istante. Guardare un'immagine non ti dice immediatamente "questo è a 2,3 metri da quella parete, in soggiorno": riconoscere quella parete come "quella parete" richiede di averla vista prima e di ricordare dove ci si trovava quando l'abbiamo vista. In altre parole, trasformare un'osservazione attuale in informazioni di posizione significative richiede una corrispondenza con le osservazioni passate (dove ti trovi ora dipende da dove sei stato) e questa corrispondenza è esattamente ciò che fornisce una mappa.
L'essenza del problema SLAM è costruire questa corrispondenza tra "ciò che vedo ora" e "ciò che ho mappato prima", in modo continuo e coerente, a partire dai soli dati di osservazione, senza mai fornire una posizione assoluta esterna. Una singola corrispondenza errata propaga il suo errore in ogni stima successiva e come sopprimere questo errore accumulato e come correggerlo a posteriori è la questione progettuale centrale alla base di ogni algoritmo Visual-SLAM.
3. Cosa trovare in un'immagine di una fotocamera
L'output grezzo di una fotocamera non è altro che una griglia di valori di pixel: luminosità, colore. Il primo passo per capire "come mi sono mosso" è trovare indizi tracciabili all'interno di quella griglia.
Una Caratteristica è un punto locale nell'immagine che si distingue chiaramente dall'ambiente circostante e può essere rilevato in modo affidabile anche cambiando il punto di vista: un angolo, un'intersezione di bordi, un punto in cui i gradienti di luminosità cambiano bruscamente in più direzioni. Una porzione uniforme di cielo blu, indistinguibile dalle aree circostanti, non può fungere da caratteristica.
Il Rilevamento delle Caratteristiche individua i potenziali punti caratteristici all'interno di una singola immagine. Algoritmi come ORB (Oriented FAST and Rotated BRIEF), SIFT e il rilevatore di angoli FAST decidono quali pixel "assomigliano" a caratteristiche e calcolano un descrittore, ovvero un riepilogo numerico dell'aspetto locale intorno a ciascuno di essi.
Il Tracciamento delle Caratteristiche individua e abbina le stesse caratteristiche nel fotogramma successivo. Esistono due approcci principali: il confronto delle caratteristiche rilevate tramite la similarità dei descrittori (Feature Matching) e la ricerca del suo vicinato a partire dalla posizione di una caratteristica nel fotogramma precedente (flusso ottico, classicamente tramite il metodo di Lucas-Kanade).
Questa relazione – lo stesso punto nel mondo reale che appare in posizioni diverse in fotogrammi diversi – è chiamata corrispondenza. Quasi ogni calcolo geometrico in Visual-SLAM prende in input un insieme di corrispondenze; senza una singola corrispondenza, in linea di principio non c'è alcun indizio su come si è mossa la telecamera.
Il flusso ottico è un campo vettoriale che descrive quanto e in quale direzione si è spostato ciascun punto dell'immagine (o un insieme sparso di punti) tra i fotogrammi, non solo le caratteristiche. Mentre il tracciamento basato sulle caratteristiche segue solo i punti più distintivi, il flusso ottico può sfruttare le informazioni sul movimento su un'area più ampia, a un costo computazionale generalmente maggiore.
4. Calcolo del movimento della telecamera
Una volta ottenute le corrispondenze, queste possono essere trasformate, geometricamente, in una stima di come si è mossa la telecamera. Il fondamento di questo calcolo è la geometria epipolare.
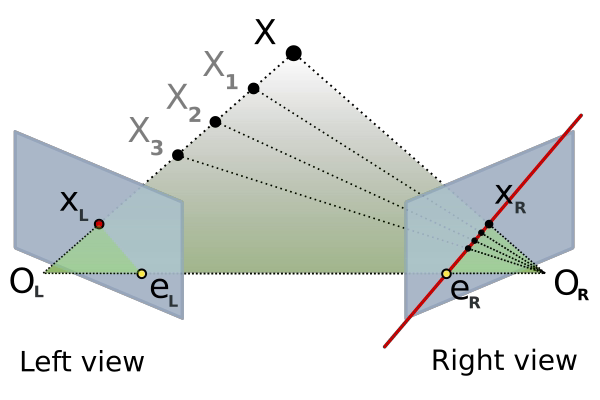
Figura 1 — Due punti di vista della telecamera O_1 e O_2 , un punto X nello spazio e le sue proiezioni x_1 , x_2 su ciascun piano immagine. Dato x_1 , il suo punto corrispondente x_2 è sempre vincolato a giacere su una singola linea nella seconda immagine (la linea epipolare).
Figura: Epipolar geometria (Arne Nordmann, CC BY-SA 3.0 / GFDL), Wikimedia Commons. L'SVG originale è stato convertito in un PNG con sfondo bianco per una visualizzazione affidabile nel browser.

Quando lo stesso punto X nello spazio viene fotografato da due punti di vista diversi, il punto corrispondente \mathbf{x}_2 in un'immagine, dato un punto \mathbf{x}_1 nell'altra, non può trovarsi in nessun punto dell'immagine: deve giacere su una singola linea (la linea epipolare). La matrice che codifica questo vincolo geometrico è la Matrice Essenziale E. Quando i parametri intrinseci della telecamera sono noti, i punti corrispondenti nelle coordinate normalizzate della telecamera soddisfano la seguente equazione:
Qui R e \mathbf{t} rappresentano la rotazione e la traslazione dalla telecamera 1 alla telecamera 2, e [\mathbf{t}]_{\times} è la matrice antisimmetrica costruita a partire da \mathbf{t} che rappresenta un prodotto vettoriale come moltiplicazione di matrici. Questa equazione indica che tale vincolo è sempre valido tra una corrispondenza \mathbf{x}_1, \mathbf{x}_2 e la rotazione e traslazione relative della telecamera. Il numero di corrispondenze richieste dipende dall'algoritmo di stima: una matrice essenziale calibrata ha un risolutore minimale a 5 punti, mentre la stima lineare a 8 punti utilizza almeno 8 corrispondenze. I dati reali contengono valori anomali, quindi i sistemi pratici raccolgono più corrispondenze e le combinano con RANSAC o un altro stimatore robusto. Quando le proprietà intrinseche sono sconosciute, o quando si lavora direttamente con le coordinate dei pixel, la Matrice Fondamentale F = K_2^{-\top} E K_1^{-1}, che include la matrice intrinseca K, svolge lo stesso ruolo.
La traslazione \mathbf{t} ricavata dalla Matrice Essenziale non ha un'unità di misura reale (metri, ad esempio): due immagini da sole non possono dire se la telecamera si è spostata di un metro o di due. Questa ambiguità di scala è un vincolo specifico del Visual-SLAM, in particolare delle configurazioni monoculari, e verrà ripresa nella Sezione 5.
Il calcolo della posizione 3D effettiva di una corrispondenza, ovvero le coordinate del punto X nello spazio, è chiamato Triangolazione. Prolungando i due raggi che partono da ciascun punto di vista verso X, idealmente questi due raggi dovrebbero intersecarsi esattamente nel punto X; trovare tale intersezione permette di ricostruire la posizione 3D della corrispondenza (in pratica, il rumore di osservazione fa sì che i raggi non si incontrino esattamente, quindi si cerca il punto più vicino a entrambi, secondo il metodo dei minimi quadrati).
Se esiste una corrispondenza tra un punto di riferimento di cui si conosce già la posizione 3D e la sua posizione nell'immagine, è possibile calcolare direttamente la posa della telecamera. Questo è il problema PnP (Perspective-n-Point): dati i punti 3D di n e le loro posizioni proiettate nell'immagine, si calcola la posizione e l'orientamento della telecamera. Una volta creata una mappa, il problema PnP diventa lo strumento principale per calcolare la posa della telecamera per ogni nuovo fotogramma.
- Odometria Visiva
Ripetere semplicemente "calcola il movimento della telecamera a partire dalle corrispondenze", fotogramma dopo fotogramma, è già sufficiente per stimare la traiettoria della telecamera. Questa è l'Odometria Visiva (VO).
La VO unisce solo il movimento relativo tra il fotogramma corrente e quello precedente (o gli ultimi fotogrammi) per ricostruire la traiettoria della telecamera. Generalmente non dispone di un meccanismo per mantenere una mappa persistente o per riconoscere un luogo visitato in precedenza: è più simile, per concezione, al contachilometri di un'auto, che calcola continuamente "quanta distanza ho percorso da poco fa".
La differenza tra VO e SLAM risiede proprio in questo: se il sistema mantiene una mappa e dispone di un meccanismo per recuperare la coerenza con il passato. La VO è leggera e semplice da implementare, ma poiché la stima di ogni fotogramma dipende sempre da quella del precedente, piccoli errori si accumulano indefinitamente nel tempo. Questo errore accumulato è chiamato Deriva. Se un robot torna al punto di partenza, la sola VO non ha modo di riconoscere "Sono tornato al punto di partenza": la traiettoria stimata rimane sfalsata rispetto al punto di partenza e non si chiude mai.
C'è un altro problema specifico della VO, in particolare della VO monoculare, già accennato nella Sezione 4: il problema della scala. Le immagini di una telecamera monoculare da sola non possono ricostruire un'unità di lunghezza reale assoluta: nulla nell'aspetto dell'immagine distingue "spostato di 2 metri, l'oggetto appare due volte più grande" da "spostato di 4 metri, l'oggetto appare quattro volte più grande". Una telecamera stereo (che ha una distanza di base nota tra le sue due lenti per ancorare la scala), una telecamera RGB-D (il cui sensore di profondità fornisce direttamente le distanze reali) o l'abbinamento con un'IMU (la cui accelerazione in scala reale consente di stimare la scala) possono risolvere questa ambiguità di scala.
6. Cosa aggiunge SLAM alla VO
È utile pensare a SLAM come alla VO più i seguenti elementi aggiuntivi.
Una mappa è una rappresentazione cumulativa della posizione 3D di ogni elemento osservato fino a quel momento (o una forma 3D densa). Invece di confrontare solo con il fotogramma immediatamente precedente, come fa la VO, il sistema può ora confrontare con tutto ciò che è stato accumulato nella mappa.
Un punto di riferimento è un singolo elemento di quella mappa, solitamente un punto caratteristico con una posizione 3D. Ogni volta che arriva un nuovo fotogramma, confrontandolo con i punti di riferimento visibili in quel fotogramma, il sistema può stimare la posizione della telecamera in modo coerente non solo con il fotogramma precedente, ma con l'intera mappa costruita nel corso della storia del robot.
La chiusura del ciclo è il vantaggio più importante di SLAM rispetto alla VO. Quando un robot ritorna in un luogo che ha già visitato, la similarità delle immagini viene utilizzata per rilevare questo fatto e viene aggiunto un nuovo vincolo alla mappa che collega "dove mi trovo ora" a "dove mi trovavo quando ho visitato questo luogo per la prima volta". L'aggiunta di questo vincolo consente al sistema di ridistribuire la deriva accumulata lungo l'intero ciclo e di correggerla.
Il risultato di tale correzione è la coerenza globale. Prima della chiusura del ciclo, l'errore accumulato fa sì che due posizioni sulla mappa che dovrebbero corrispondere allo stesso luogo fisico vengano registrate come posizioni leggermente diverse. La correzione tramite chiusura del ciclo rileva tale discrepanza e rimodella l'intera mappa in una forma coerente: questo meccanismo di chiusura del ciclo è esattamente il motivo per cui SLAM può offrire non solo "una registrazione del movimento", ma "una mappa coerente".
7. La struttura di base di Visual-SLAM
Mettendo insieme questi elementi, emerge una pipeline condivisa, a grandi linee, da tutti i principali sistemi Visual-SLAM moderni.
Figura 2 — Le immagini della telecamera vengono confrontate con il frame precedente (Tracciamento di caratteristiche/diretto, utilizzando uno degli approcci delle Sezioni 3 e 4) 8), che guida la stima della posa (geometria epipolare e PnP dalla Sezione 4) e, in parallelo, la mappatura locale (aggiunta e aggiornamento di punti di riferimento nell'area osservata di recente). Quando viene rilevato un loop, si attiva la chiusura del loop e il livello di ottimizzazione nel backend (Sezione 10) — Bundle Adjustment o ottimizzazione del Pose Graph — corregge le pose accumulate e la mappa in un insieme coerente.
Le immagini della telecamera passano prima attraverso il Feature Tracking/Direct Tracking (uno dei due approcci descritti nelle Sezioni 3 e 8) per stabilire le corrispondenze con il frame precedente. Da queste corrispondenze, la stima della posa (utilizzando la geometria epipolare e PnP dalla Sezione 4) calcola la posa della telecamera, mentre la mappatura locale (aggiunta e aggiornamento di punti di riferimento nella regione osservata di recente) procede in parallelo. Quando viene rilevato un loop, si attiva la chiusura del loop e la fase di ottimizzazione del backend (Sezione 10) corregge le pose accumulate e la mappa in un insieme globalmente coerente. Il risultato finale di questa pipeline è l'output finale: la posa (traiettoria) della telecamera e la mappa (la struttura 3D dell'ambiente circostante).
8. Algoritmi di riferimento
La storia del Visual-SLAM è più facile da seguire lungo un asse: quanto è stato progettato esplicitamente e quanto è stato affidato all'apprendimento automatico.
PTAM (Parallel Tracking and Mapping, Klein & Murray, 2007) è stato un sistema pionieristico che eseguiva il tracciamento (stima della posa) e la mappatura (costruzione della mappa) come thread paralleli separati. Il tracciamento viene eseguito rapidamente, ad ogni frame, mentre il Bundle Adjustment, computazionalmente oneroso per la mappatura, viene eseguito in un thread in background con più tempo a disposizione: questa idea di separare il tracciamento dalla mappatura è stata ereditata da molti sistemi Visual-SLAM successivi.
ORB-SLAM (Mur-Artal, Montiel & Tardós, 2015) è stato sviluppato attorno alle caratteristiche ORB, combinando una struttura a tre thread (Tracking, Local Mapping, Loop Closing) con il riconoscimento della posizione (confronto con frame precedenti tramite Bag-of-Words) per ottenere prestazioni monoculari pratiche. ORB-SLAM2 (Mur-Artal & Tardós, 2017) ha esteso questo framework oltre il monoculare, includendo telecamere stereo e RGB-D. ORB-SLAM3 (Campos, Elvira, Gómez Rodríguez, Montiel & Tardós, 2021) ha aggiunto un forte accoppiamento con un'IMU (Visual-Inertial SLAM) e un SLAM multi-mappa, che gestisce più mappe e le unisce secondo necessità, e rimane, ad oggi, l'implementazione di riferimento de facto per lo SLAM basato su caratteristiche.
LSD-SLAM (Large-Scale Direct monocular SLAM, Engel, Schöps & Cremers, 2014) è un esempio fondamentale del metodo diretto, che dimostra come la posa della telecamera possa essere stimata utilizzando direttamente la luminosità dell'immagine, senza alcuna fase di rilevamento delle caratteristiche, su larga scala. Saltando completamente l'estrazione delle caratteristiche, il metodo permette di sfruttare le informazioni anche in presenza di caratteristiche sparse.
DSO (Direct Sparse Odometry, Engel, Koltun & Cremers, presentato per la prima volta nel 2016, pubblicato nel 2018) rimane un metodo diretto, ma anziché la stima semi-densa prodotta da LSD-SLAM, minimizza l'errore fotometrico su un insieme sparso di punti, raggiungendo sia l'accuratezza che l'efficienza computazionale.
SVO (Fast Semi-Direct Monocular Visual Odometry, Forster, Pizzoli & Scaramuzza, 2014) combina il rilevamento di caratteristiche con un metodo diretto in un approccio semi-diretto, tracciando la luminosità in patch attorno alle caratteristiche rilevate per ottenere un funzionamento rapido ad alti frame rate, progettato pensando a piattaforme con risorse limitate come i droni.
DROID-SLAM (Teed & Deng, 2021) sostituisce completamente la fase esplicita di estrazione e corrispondenza delle caratteristiche con il deep learning, stimando la posa della telecamera e la profondità per pixel tramite un volume di correlazione, un operatore di aggiornamento ricorrente e un livello di Bundle Adjustment differenziabile: l'approccio basato sull'apprendimento rappresentativo (i suoi meccanismi interni sono descritti più dettagliatamente in Visual-SLAM Trends).
9. Basato su caratteristiche vs. Diretto vs. Basato sull'apprendimento
In sintesi, questi algoritmi rientrano in una delle tre filosofie di progettazione.
| Aspetto | Basato su caratteristiche (ad es. ORB-SLAM3) | Diretto (ad es. DSO/LSD-SLAM) | Basato sull'apprendimento (ad es. DROID-SLAM) |
|---|---|---|---|
Principio | Rileva e descrive le caratteristiche, calcola la posa dalla relazione geometrica tra le corrispondenze | Salta completamente le caratteristiche, minimizza direttamente la luminosità dell'immagine per trovare la posa | Una rete neurale impara a sostituire l'estrazione delle caratteristiche, la corrispondenza e la stima della posa/profondità |
Precisione | Elevata dove le caratteristiche sono abbondanti; tende a produrre una mappa sparsa | Funziona ovunque ci sia un gradiente di luminosità; può produrre mappe da semi-dense a dense | Abbastanza robusto anche in ambienti con texture ridotte; facile ottenere una profondità densa |
Costo computazionale | Moderato (estrazione delle caratteristiche, descrittori, corrispondenza) | Varia a seconda dell'implementazione, generalmente leggero (DSO in particolare ottimizza per l'efficienza) | Elevato (la sola inferenza spesso richiede da diversi a oltre dodici GB di memoria GPU) |
Robustezza | Debole in ambienti con poca texture o con oggetti dinamici; relativamente forte contro le variazioni di illuminazione | Sensibile alle variazioni di luminosità (esposizione automatica, illuminazione) | Forte nell'intervallo dei dati di addestramento, ma la generalizzazione ad ambienti non visti può essere limitata |
Difficoltà di implementazione | Molte implementazioni open-source mature, facili da adottare | La matematica (linearizzazione della luminosità) è un po' più complessa | Facile da usare un modello pre-addestrato; il riaddestramento o la messa a punto dei meccanismi interni richiedono maggiore competenza |
I metodi basati sulle caratteristiche hanno la più lunga esperienza, comprese numerose implementazioni in sistemi embedded; i metodi diretti si comportano meglio in ambienti con scarsa texture; I metodi basati sull'apprendimento automatico stanno migliorando rapidamente, ma richiedono una maggiore potenza di calcolo: questo è, più o meno, lo scenario attuale al 2026.
10. Il Backend
Ciò che determina in definitiva l'accuratezza di Visual-SLAM non è solo il frontend (estrazione delle caratteristiche, tracciamento, stima della posa), ma il Backend, che perfeziona l'intero set di osservazioni accumulate in qualcosa di coerente.
La Bundle Adjustment ottimizza congiuntamente le pose della telecamera e le posizioni 3D dei punti di riferimento in modo che siano il più possibile coerenti con ogni osservazione. Minimizza l'errore di riproiezione totale, ovvero la discrepanza tra un punto di riferimento \mathbf{X}_i proiettato in un'immagine tramite la posa della telecamera (R_j, \mathbf{t}_j) e la posizione in cui la caratteristica corrispondente è stata effettivamente osservata, \mathbf{u}_{ij}.
\pi(\cdot) è la funzione di proiezione da un punto 3D al piano immagine, basata sui parametri intrinseci della telecamera. La regolazione globale del bundle (Global Bundle Adjustment), che ottimizza simultaneamente ogni frame e ogni punto di riferimento, è molto precisa ma costosa; in pratica, viene tipicamente abbinata alla regolazione locale del bundle (Local Bundle Adjustment), limitata solo agli ultimi frame, per mantenere i calcoli gestibili.
Quando viene rilevata la chiusura di un ciclo, entra in gioco l'ottimizzazione del grafo di posa (Pose Graph Optimization). A differenza della regolazione del bundle, che include ogni punto di riferimento, l'ottimizzazione del grafo di posa considera come nodo solo la posa della telecamera a ogni passo temporale, con gli archi che codificano i vincoli di posa relativa tra i frame, ottimizzando rapidamente la sola posa. Il nuovo vincolo aggiunto dalla chiusura del ciclo ridistribuisce la deriva accumulata sull'intero ciclo.
Entrambi questi problemi vengono risolti nell'ambito dell'ottimizzazione non lineare (Nonlinear Optimization). Poiché la funzione di proiezione \pi(\cdot) e la composizione delle rotazioni in una posa sono intrinsecamente non lineari, vengono utilizzati metodi iterativi come Gauss-Newton e Levenberg-Marquardt, e librerie come g2o e Ceres Solver sono ampiamente utilizzate nelle implementazioni di Visual-SLAM.
11. Dove Visual-SLAM incontra difficoltà
Poiché Visual-SLAM si basa su un sensore passivo, ovvero una telecamera, la sua precisione si degrada sistematicamente in alcune situazioni.
-
Oscurità: Senza sufficiente luce, il rapporto segnale/rumore dell'immagine si degrada, destabilizzando sia il rilevamento delle caratteristiche sia i calcoli del gradiente di luminosità su cui si basano i metodi diretti. Le telecamere RGB-D illuminate a infrarossi possono compensare in parte, ma l'effetto è limitato all'aperto di notte.
-
Superfici con bassa texture: Pareti bianche, pavimenti lisci, superfici in vetro: ovunque le sfumature di luminosità siano scarse, non sia possibile individuare dettagli o la minimizzazione con il metodo diretto risulti mal posta e soggetta a minimi locali.
-
Movimento rapido: Movimenti o rotazioni rapide della telecamera ampliano il campo di ricerca necessario per trovare le corrispondenze tra i fotogrammi e, combinati con la sfocatura da movimento (vedi sotto), il tracciamento si interrompe facilmente. L'abbinamento con un'IMU (VIO) è il metodo standard per compensare questa debolezza.
-
Oggetti dinamici: Trattare i dettagli di un pedone o di un'auto in movimento come se appartenessero all'ambiente statico introduce un errore nella stima del movimento della telecamera stessa. Ciò richiede una pre-elaborazione per rilevare ed escludere gli oggetti dinamici, oppure estensioni che li modellino esplicitamente.
-
Sfocatura da movimento: Sfocatura causata dal movimento della telecamera o del soggetto durante la finestra di esposizione, che destabilizza i descrittori dei dettagli e degrada la precisione della corrispondenza. Telecamere con otturatore globale o ambienti luminosi con tempi di esposizione brevi riducono l'impatto.
Tutti questi problemi hanno un filo conduttore: la telecamera non riceve sufficienti informazioni visive per poter funzionare. Un sensore di distanza attivo come il LiDAR (vedi Tendenze tecnologiche LiDAR-SLAM) aggira in linea di principio la maggior parte di queste debolezze, ma presenta a sua volta una serie di punti deboli (vedi Sezione 2): nessun singolo sensore è universalmente sufficiente, ed è proprio questa complementarità che rende la fusione dei sensori (vedi Introduzione alla fusione dei sensori) così importante.
12. Scelta del metodo nella pratica
La scelta di un approccio Visual-SLAM dipende in larga misura dai sensori che è possibile utilizzare, dalla potenza di calcolo disponibile e dall'accuratezza e dalle prestazioni in tempo reale richieste dall'applicazione.
-
Robot (robot di servizio per interni, robot per la pulizia): Spesso limitati a configurazioni di telecamere a basso costo, dove i metodi della famiglia ORB-SLAM basati su caratteristiche o la mappatura densa tramite telecamere RGB-D sono scelte pratiche. In ambienti con molti corridoi e bassa texture, vale la pena considerare l'abbinamento con il LiDAR.
-
Droni: I severi vincoli di potenza di calcolo e peso del carico utile spingono verso metodi semi-diretti leggeri come SVO o configurazioni VIO strettamente accoppiate con un IMU.
-
AR/VR: Prestazioni in tempo reale e bassa latenza sono la massima priorità e una configurazione Visual-Inertial abbinata all'IMU integrata del visore è diventata lo standard di fatto. In AR in particolare, la coerenza globale determina direttamente se gli oggetti virtuali si spostano, quindi anche la precisione della chiusura del ciclo è molto importante.
-
Guida autonoma: Raramente utilizzata come Visual-SLAM standalone; Le informazioni visive acquisite tramite telecamera vengono in genere integrate in una configurazione di fusione multisensore insieme a LiDAR, radar e GNSS (vedi Introduzione alla fusione di sensori).
-
Interni vs. esterni: negli ambienti interni, le variazioni di illuminazione sono graduali e la struttura è ben definita, quindi i metodi basati sulle caratteristiche tendono a funzionare bene; all'aperto, le variazioni di illuminazione, gli oggetti dinamici e le grandi dimensioni diventano una sfida, rendendo la robustezza della chiusura del ciclo ancora più importante.
A partire dal 2026, l'asse decisionale approssimativo si presenta così: scegliere l'apprendimento automatico se la potenza di calcolo è abbondante e l'obiettivo è la massima precisione, il metodo basato sulle caratteristiche se l'esperienza pregressa nei sistemi embedded e il basso consumo di risorse sono più importanti, e il metodo diretto se la resilienza in ambienti con scarsa texture è essenziale. Le ultime direzioni di ricerca — come la riorganizzazione della rappresentazione delle mappe con 3D Gaussian Splatting/NeRF, i modelli di base 3D feed-forward e altro ancora — sono trattate in Visual-SLAM Trends.
Cinque verifiche prima dell'implementazione
Scegliere basandosi solo sul nome dell'algoritmo rende difficile diagnosticare i guasti sul campo. Prima dell'implementazione, assicurarsi che questi cinque elementi possano essere registrati; in caso di errore di tracciamento, sarà possibile distinguere un problema del sensore da un problema dell'algoritmo di stima.
| Verifica | Informazioni da preparare | Cosa succede se viene omessa |
|---|---|---|
| Calibrazione | Parametri intrinseci K, distorsione dell'obiettivo e baseline stereo, se applicabile | L'errore di riproiezione sembra un errore di posa e la scala non può essere valutata |
| Sincronizzazione temporale | Timestamp dei frame, offset telecamera-IMU e frame persi | Durante il movimento rapido, l'immagine e i dati inerziali descrivono pose diverse |
Tempo di esposizione e otturatore | Otturatore globale/rolling, tempo di esposizione e impostazioni di esposizione automatica | La sfocatura da movimento o la distorsione geometrica vengono scambiate per un errore dell'algoritmo |
Oggetti dinamici | Utilizzo di maschere, frazione di oggetti in movimento e corrispondenze rifiutate | Pedoni o veicoli vengono assorbiti nella mappa statica |
Registri di valutazione | Dati di riferimento, ATE/RPE, tempi di perdita di tracciamento e risultati del rilevamento di loop | "Si è mosso" non è sufficiente per confrontare accuratezza, deriva o recupero |
Compilare prima questa tabella semplifica anche la distinzione tra ciò che deve essere modificato e ciò che può rimanere fisso quando si passa da metodi basati su caratteristiche a metodi diretti o basati sull'apprendimento. Il Visual-SLAM dovrebbe essere scelto come un sistema – che include telecamera, temporizzazione, preelaborazione, ottimizzazione e valutazione – piuttosto che come un algoritmo isolato.
13. Riepilogo
Il Visual-SLAM traccia le corrispondenze dalle sole immagini della telecamera, recupera il movimento della telecamera tramite geometria epipolare e PnP e corregge continuamente l'errore accumulato attraverso una mappatura e chiusura del ciclo, ottenendo localizzazione e mappatura simultanee. Le tre filosofie di progettazione — basata sulle caratteristiche (la famiglia ORB-SLAM), diretta (DSO/LSD-SLAM) e basata sull'apprendimento (DROID-SLAM) — si basano ciascuna su un diverso compromesso e sono più facili da comprendere se si considerano se le caratteristiche vengono gestite esplicitamente, se la luminosità viene utilizzata direttamente e quanta parte viene delegata all'apprendimento. La scelta effettiva dipende da una valutazione specifica dell'applicazione, da bilanciare con i sensori disponibili, la potenza di calcolo e l'accuratezza e le prestazioni in tempo reale richieste.
14. Riferimenti
I principali articoli e pagine di ricerca relativi ai metodi rappresentativi e alla geometria a due viste discussi sopra sono raccolti qui come punti di partenza per l'implementazione e ulteriori approfondimenti. Per evitare di confondere le affermazioni di un articolo con le prestazioni su un particolare prodotto o dataset, leggere il testo collegato insieme alle relative condizioni sperimentali.
-
ORB-SLAM3: una libreria open-source accurata per SLAM visivo, visivo-inerziale e multi-mappa — una libreria che copre progetti visivi, visivo-inerziali e multi-mappa.
-
DROID-SLAM: SLAM visivo profondo per telecamere monoculari, stereo e RGB-D — un metodo basato sull'apprendimento che combina volumi di correlazione con la regolazione differenziabile a fasci densi.
-
LSD-SLAM: SLAM monoculare diretto su larga scala — la pagina di ricerca ufficiale per SLAM monoculare diretto semi-denso.
-
Odometria sparsa diretta — l'articolo DSO sull'ottimizzazione dell'errore fotometrico con finestra scorrevole.
-
Una soluzione efficiente al problema della posa relativa a cinque punti — l'articolo originale sul risolutore della matrice essenziale a 5 punti.
Una mappa attraente permette una localizzazione accurata?
Valuta l'aspetto della mappa separatamente dall'errore di traiettoria. Verifica scala, allineamento, errore locale e deriva a lungo termine.
Commenti
Accedi per continuare.
Nessun dato disponibile.