Contents — find the section you need
Les aspirateurs robots, les drones, les voitures autonomes et les lunettes de réalité augmentée partagent tous une exigence fondamentale : répondre à la question « Où suis-je ? ». Le GPS est inopérant en intérieur et dans les zones urbaines denses, et une carte n’est pas toujours disponible. La technologie Visual-SLAM permet de répondre à cette question grâce aux seules images de la caméra (parfois associées à des capteurs auxiliaires bon marché). Cet article explique d’abord pourquoi un robot perd la notion de sa position, puis aborde le suivi des points de repère, les calculs géométriques liés à la caméra, la différence entre l’odométrie visuelle et le SLAM, l’historique des algorithmes de repérage de points de repère, et enfin comment choisir le plus adapté en pratique.
 Caméra d'entrée Visual-SLAM
 Exemple de caméra embarquée
Images : Intel RealSense depth camera D435 (Marc Auledas, CC BY-SA 4.0) / Car window camera of Mobileye system (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Caméras représentatives, configuration matérielle Visual-SLAM non requise.


0. Contenu de cet article
-
Définition de Visual-SLAM et pourquoi une caméra peut estimer sa propre position
-
Différences entre l'odométrie visuelle (VO) et le SLAM
Apports respectifs des approches ORB-SLAM, LSD-SLAM, DSO, SVO et DROID-SLAM
Différences entre les approches basées sur les caractéristiques, directes et basées sur l'apprentissage
Points faibles de Visual-SLAM et leurs causes
Comment choisir la méthode la plus adaptée à un robot, un drone, la réalité augmentée/virtuelle ou un véhicule autonome
1. Fonctionnement de Visual-SLAM
En résumé : Visual-SLAM estime simultanément la trajectoire d'une caméra dans l'espace (localisation) et la structure 3D de son environnement (cartographie), à partir de la seule séquence d'images capturées par la caméra.
Son nom même – Localisation et Cartographie Simultanées – met l'accent sur l'essentiel : les mots. « Simultanément ». Si la carte était déjà connue, déterminer sa propre position serait un problème relativement simple ; si votre position était déjà connue précisément, la construction de la carte le serait également. Le Visual-SLAM ne bénéficie d'aucun de ces avantages : la construction de la carte requiert la connaissance de la position, et la connaissance de la position requiert la carte. Cette dépendance inverse, comparable au dilemme de la poule et de l'œuf, doit être résolue à partir du même flux d'observations, simultanément.
L'entrée est une série temporelle d'images provenant d'une caméra (monoculaire, stéréoscopique ou RGB-D), et la sortie comprend deux éléments : la pose de la caméra selon ses six degrés de liberté (trois pour la position, trois pour l'orientation) à chaque instant, et une carte représentant l'environnement (un ensemble clairsemé de points caractéristiques ou une forme 3D dense). Un aspirateur robot apprenant la configuration d'une pièce pendant son nettoyage, un drone stabilisant son vol stationnaire en intérieur ou sous terre où le GPS est inopérant, un casque de réalité augmentée superposant des objets virtuels au monde réel sans dérive : dans chacun de ces cas, le Visual-SLAM est à l'œuvre.
2. Pourquoi un robot ne sait-il pas où il se trouve ?
Pour comprendre le problème que résout le Visual-SLAM, il est utile de se poser la question suivante : pourquoi un robot perd-il la notion de sa position ?
Premièrement, de nombreux environnements sont dépourvus de GPS, ou d'un GPS peu fiable. En intérieur, sous terre, dans les tunnels, dans les dédales urbains entre les gratte-ciel (où les réflexions multiples amplifient considérablement les erreurs de positionnement), sous l'eau ou sur d'autres planètes dépourvues de constellation de satellites, aucun de ces environnements ne permet d'obtenir directement une position absolue.
Deuxièmement, il y a le problème de l'absence de carte. Un bâtiment nouvellement construit, un site sinistré, une surface planétaire inexplorée : les données cartographiques préexistantes ne sont pas toujours disponibles. Sans carte, il est impossible de « vérifier sa position sur une carte ».
Troisièmement, et surtout, une simple mesure de capteur ne peut pas déterminer une position absolue, même en théorie. Une caméra ne fait que montrer ce qui se trouve autour d'elle à l'instant présent. Regarder une seule image ne vous dit pas instantanément « ceci se trouve à 2,3 mètres de ce mur, dans le salon ». Reconnaître ce mur comme « ce mur-là » nécessite de l'avoir déjà vu et de se souvenir de l'endroit où l'on se trouvait à ce moment-là. Autrement dit, transformer une observation actuelle en information de position pertinente requiert une correspondance avec les observations passées (votre position actuelle dépend de vos positions précédentes), et c'est précisément ce qu'offre une carte.
L'essence du problème SLAM réside dans la construction continue et cohérente de cette correspondance entre « ce que je vois maintenant » et « ce que j'ai cartographié auparavant », à partir des seules données d'observation, sans jamais fournir de position absolue externe. Une seule erreur de correspondance propage son erreur à toutes les estimations suivantes. Comment supprimer cette erreur accumulée et comment la corriger a posteriori ? C'est la question de conception centrale de tout algorithme Visual-SLAM.
3. Que rechercher dans une image de caméra
Le signal brut d'une caméra n'est rien d'autre qu'une grille de valeurs de pixels : luminosité, couleur. La première étape pour déterminer « comment je me suis déplacé » consiste à trouver des indices traçables au sein de cette grille.
Un élément caractéristique est un point local de l'image qui se distingue clairement de son environnement et qui peut être détecté à nouveau de manière fiable même lorsque le point de vue change : un coin, une intersection de bord, un endroit où les gradients de luminosité changent brusquement dans plusieurs directions. Une zone de ciel bleu uniforme, indiscernable de ses voisines, ne peut pas servir d'élément caractéristique.
La détection d'éléments caractéristiques identifie les points caractéristiques potentiels au sein d'une image. Des algorithmes comme ORB (Oriented FAST and Rotated BRIEF), SIFT et le détecteur de coins FAST déterminent quels pixels « ressemblent à des éléments caractéristiques » et calculent un descripteur : un résumé numérique de l'apparence locale autour de chaque pixel.
Le suivi d'éléments caractéristiques retrouve et associe ces mêmes éléments caractéristiques d'une image à l'autre. Il existe deux grandes approches : la mise en correspondance des caractéristiques détectées par similarité de descripteurs (mise en correspondance de caractéristiques) et le suivi à partir de la position d'une caractéristique dans l'image précédente, en explorant son voisinage dans l'image suivante (flux optique, classiquement via la méthode de Lucas-Kanade).
Cette relation – un même point du monde réel apparaissant à différents endroits d'une image à l'autre – est appelée correspondance. Presque tous les calculs géométriques du Visual-SLAM prennent en entrée un ensemble de correspondances ; sans correspondance, il est impossible, en principe, de déterminer le mouvement de la caméra.
Le flux optique est un champ vectoriel décrivant le déplacement de chaque point de l'image (ou d'un petit ensemble de points) entre les images, et ce, en distance et en direction – et pas seulement celui des caractéristiques. Alors que le suivi basé sur les caractéristiques ne suit que les points les plus distinctifs, le flux optique exploite les informations de mouvement sur une zone plus étendue, au prix généralement d'un coût de calcul plus élevé.
4. Calcul du mouvement de la caméra
Une fois les correspondances établies, on peut les convertir géométriquement en une estimation du mouvement de la caméra. Ce calcul repose sur la géométrie épipolaire.
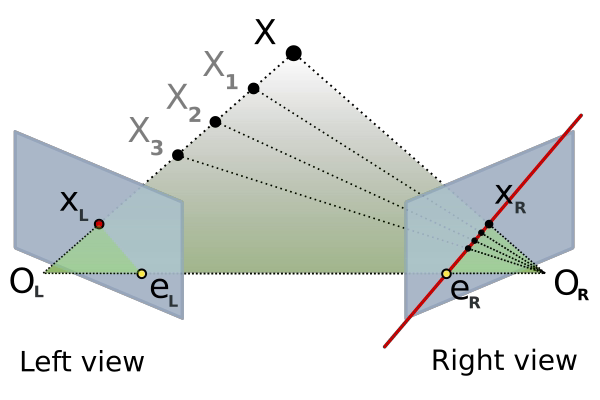
Figure 1 — Deux points de vue de la caméra O_1 et O_2, un point X dans l'espace, et ses projections x_1 et x_2 sur chaque plan image. Étant donné x_1, son point correspondant x_2 est toujours contraint de se situer sur une seule ligne dans la seconde image (la ligne épipolaire).
Figure : Epipolar géométrie (Arne Nordmann, CC BY-SA 3.0 / GFDL), Wikimedia Commons. Le fichier SVG original a été converti en PNG à fond blanc pour un affichage optimal dans les navigateurs.

Lorsqu'un même point X de l'espace est photographié depuis deux points de vue différents, le point correspondant \mathbf{x}_2 dans une image, étant donné un point \mathbf{x}_1 dans l'autre, ne peut se situer n'importe où dans l'image : il doit se trouver sur une même ligne (la ligne épipolaire). La matrice codant cette contrainte géométrique est la Matrice Essentielle E. Lorsque les paramètres intrinsèques de la caméra sont connus, les points correspondants dans le système de coordonnées normalisé de la caméra satisfont à la condition suivante :
Ici, R et \mathbf{t} représentent respectivement la rotation et la translation de la caméra 1 vers la caméra 2, et [\mathbf{t}]_{\times} est la matrice antisymétrique construite à partir de \mathbf{t}, qui représente un produit vectoriel sous forme de multiplication matricielle. Cette équation indique que cette contrainte est toujours vérifiée entre une correspondance \mathbf{x}_1, \mathbf{x}_2 et la rotation et la translation relatives de la caméra. Le nombre de correspondances requis dépend de l'estimateur : une matrice essentielle calibrée possède un solveur minimal à 5 points, tandis qu'une estimation linéaire à 8 points utilise au moins 8 correspondances. Les données réelles contiennent des valeurs aberrantes ; les systèmes pratiques collectent donc davantage de correspondances et les combinent avec RANSAC ou un autre estimateur robuste. Lorsque les paramètres intrinsèques sont inconnus, ou lorsqu'on travaille directement en coordonnées de pixels, la Matrice Fondamentale F = K_2^{-\top} E K_1^{-1}, qui intègre la matrice intrinsèque K, joue le même rôle.
La translation \mathbf{t} récupérée à partir de la Matrice Essentielle n'est pas exprimée dans une unité du monde réel (par exemple, en mètres) ; deux images seules ne permettent pas de déterminer si la caméra s'est déplacée d'un ou de deux mètres. Cette ambiguïté d'échelle est une contrainte spécifique au Visual-SLAM, en particulier aux configurations monoculaires, et est abordée à nouveau dans la section 5.
Le calcul de la position 3D réelle d'une correspondance — les coordonnées du point X dans l'espace — est appelé Triangulation. En prolongeant les deux rayons issus de chaque point de vue vers X, ces deux rayons devraient, idéalement, se croiser exactement au point X. La recherche de cette intersection permet de retrouver la position 3D de la correspondance (en pratique, le bruit d'observation fait que les rayons ne se croisent pas exactement ; on recherche donc le point le plus proche des deux, au sens des moindres carrés).
Si une correspondance existe entre un point de repère dont la position 3D est déjà connue et son emplacement sur l'image, la pose de la caméra peut être calculée directement à partir de cette correspondance. Il s'agit du problème PnP (Perspective-n-Point) : étant donné n points 3D et leurs positions projetées sur l'image, il faut déterminer la position et l'orientation de la caméra. Une fois la carte établie, le problème PnP devient l'outil principal pour calculer la pose de la caméra à chaque nouvelle image.
5. Odométrie visuelle
Il suffit de répéter « calculer le mouvement de la caméra à partir des correspondances », image après image, pour estimer la trajectoire de la caméra. C'est l'odométrie visuelle (OV).
La VO assemble uniquement le mouvement relatif entre l'image actuelle et la précédente (ou les dernières images) pour reconstituer la trajectoire de la caméra. Elle ne dispose généralement d'aucun mécanisme pour maintenir une carte persistante ni pour reconnaître un lieu déjà visité ; son fonctionnement est plus proche de celui d'un compteur kilométrique, calculant en continu la distance parcourue.
La distinction entre la VO et le SLAM réside précisément dans ce point : le système maintient-il une carte et possède-t-il un mécanisme pour rétablir la cohérence avec l'historique ? La VO est légère et simple à implémenter, mais comme l'estimation de chaque image dépend toujours de la précédente, de petites erreurs s'accumulent indéfiniment. Cette erreur cumulée est appelée dérive. Si un robot revient à son point de départ, la VO seule ne peut pas reconnaître ce retour : la trajectoire estimée reste décalée par rapport au point de départ et ne se referme jamais.
Il existe un autre problème spécifique à la VO, en particulier à la VO monoculaire, déjà abordé dans la section 4 : le problème d'échelle. Les images d'une caméra monoculaire ne permettent pas de déterminer une longueur absolue dans le monde réel : rien dans l'apparence de l'image ne permet de distinguer « déplacé de 2 mètres, l'objet paraît deux fois plus grand » de « déplacé de 4 mètres, l'objet paraît quatre fois plus grand ». Une caméra stéréoscopique (dont la distance de base entre les deux objectifs est connue pour ancrer l'échelle), une caméra RGB-D (dont le capteur de profondeur fournit directement les distances réelles) ou un système couplé à une centrale inertielle (dont l'accélération à l'échelle réelle permet d'estimer l'échelle) peuvent lever cette ambiguïté.
6. Apports du SLAM par rapport à la VO
On peut considérer le SLAM comme une VO enrichie des éléments suivants :
Une carte est une représentation cumulée de la position 3D de chaque élément observé jusqu'à présent (ou une forme 3D dense). Au lieu de comparer uniquement avec l'image précédente, comme le fait la VO, le système peut désormais comparer avec toutes les données accumulées dans la carte.
Un repère est un élément individuel de la carte, généralement un point caractéristique doté d'une position 3D. À chaque nouvelle image, sa comparaison avec les repères visibles permet au système d'estimer la pose de la caméra de manière cohérente, non seulement avec l'image précédente, mais aussi avec l'ensemble de la carte construite au fil des déplacements du robot.
La boucle de repérage est le principal avantage du SLAM par rapport à la VO. Lorsqu'un robot retourne à un endroit déjà visité, la similarité des images est utilisée pour détecter cette visite, et une nouvelle contrainte est ajoutée à la carte reliant « où je suis maintenant » à « où j'étais lors de ma première visite ». L'ajout de cette contrainte permet au système de redistribuer et de corriger la dérive accumulée tout au long de la boucle.
Cette correction aboutit à une cohérence globale. Avant la boucle de repérage, l'erreur accumulée fait que deux positions sur la carte, qui devraient correspondre au même lieu physique, sont enregistrées comme des emplacements légèrement différents. La correction par fermeture de boucle détecte cette incohérence et remodèle la carte entière pour la rendre cohérente. Ce mécanisme de fermeture de boucle explique précisément pourquoi le SLAM peut fournir non seulement un enregistrement de mouvement, mais une carte cohérente.
7. Structure de base du Visual-SLAM
L'assemblage de ces éléments révèle un processus commun, dans ses grandes lignes, à tous les principaux systèmes Visual-SLAM modernes.
Figure 2 — Les images de la caméra sont comparées à l'image précédente (Suivi direct/de caractéristiques, selon l'une des approches des sections 3 et 8), ce qui permet l'estimation de la pose (géométrie épipolaire et PnP de la section 4) et, en parallèle, la cartographie locale (ajout et mise à jour des points de repère dans la zone récemment observée). Lorsqu'une boucle est détectée, la fermeture de boucle est déclenchée et la couche d'optimisation du backend (section 10) — ajustement de faisceaux ou optimisation du graphe de pose — corrige les poses accumulées et les projette en un ensemble cohérent.
Les images de la caméra sont d'abord traitées par suivi de caractéristiques/suivi direct (selon l'une des approches décrites dans les sections 3 et 8) afin d'établir des correspondances avec l'image précédente. À partir de ces correspondances, l'estimation de pose (utilisant la géométrie épipolaire et le PnP de la section 4) calcule la pose de la caméra, tandis que la cartographie locale (ajout et mise à jour des points de repère dans la région récemment observée) s'effectue en parallèle. Lorsqu'une boucle est détectée, la fermeture de boucle est déclenchée et l'étape d'optimisation du backend (section 10) corrige les poses accumulées et les projette en un ensemble globalement cohérent. Le résultat final de ce pipeline est la sortie finale : la pose (trajectoire) de la caméra et la carte (structure 3D de son environnement).
8. Algorithmes de repérage
L'histoire du Visual-SLAM se comprend plus facilement en suivant un axe : la part de conception explicite et la part d'apprentissage automatique.
PTAM (Parallel Tracking and Mapping, Klein & Murray, 2007) a été un système pionnier qui exécutait le suivi (estimation de pose) et la cartographie (construction de la carte) dans des threads parallèles distincts. Le suivi s'exécute rapidement, à chaque image, tandis que l'ajustement de faisceaux pour la cartographie, gourmand en ressources de calcul, s'exécute dans un thread d'arrière-plan disposant de plus de temps. Cette idée de séparation du suivi et de la cartographie a été reprise par de nombreux systèmes Visual-SLAM ultérieurs.
ORB-SLAM (Mur-Artal, Montiel & Tardós, 2015) s'appuie sur les descripteurs ORB et combine une structure à trois threads (suivi, cartographie locale, fermeture de boucle) avec la reconnaissance de lieux (comparaison avec les images précédentes via le modèle « sac de mots ») pour obtenir des performances monoculaires optimales. ORB-SLAM2 (Mur-Artal & Tardós, 2017) a étendu ce cadre au-delà des caméras monoculaires pour inclure les caméras stéréoscopiques et RGB-D. ORB-SLAM3 (Campos, Elvira, Gómez Rodríguez, Montiel & Tardós, 2021) a ajouté un couplage étroit avec une centrale inertielle (SLAM visuel-inertiel) et le SLAM multi-cartes, qui gère plusieurs cartes et les fusionne selon les besoins. Cette approche reste, à ce jour, l'implémentation de référence pour le SLAM basé sur les caractéristiques.
LSD-SLAM (Large-Scale Direct monocular SLAM, Engel, Schöps & Cremers, 2014) est un exemple marquant de la méthode directe, démontrant que la pose de la caméra peut être estimée directement à partir de la luminosité de l'image, sans étape de détection de caractéristiques, et ce à grande échelle. L'absence totale d'extraction de caractéristiques permet d'exploiter l'information même lorsque les caractéristiques sont rares.
DSO (Direct Sparse Odometry, Engel, Koltun & Cremers, présenté pour la première fois en 2016, publié en 2018) conserve une approche directe, mais contrairement à l'estimation semi-dense produite par LSD-SLAM, elle minimise l'erreur photométrique sur un ensemble clairsemé de points, alliant précision et efficacité de calcul.
SVO (Fast Semi-Direct Monocular Visual Odometry, Forster, Pizzoli & Scaramuzza, 2014) combine la détection de caractéristiques avec une méthode directe dans une approche semi-directe, en suivant la luminosité dans des zones autour des caractéristiques détectées pour un fonctionnement rapide à des fréquences d'images élevées – une méthode conçue pour les plateformes aux ressources limitées comme les drones.
DROID-SLAM (Teed & Deng, 2021) remplace intégralement l'extraction et la mise en correspondance explicites des caractéristiques par l'apprentissage profond. Il estime la pose de la caméra et la profondeur par pixel grâce à un volume de corrélation, un opérateur de mise à jour récurrent et une couche d'ajustement de faisceaux différentiable. Cette approche, représentative de l'approche basée sur l'apprentissage, est décrite plus en détail dans Visual-SLAM Trends).
9. Approche basée sur les caractéristiques vs. Approche directe vs. Apprentissage profond
En résumé, ces algorithmes se répartissent en trois philosophies de conception.
| Aspect | Approche basée sur les caractéristiques (ex. : ORB-SLAM3) | Approche directe (ex. : DSO/LSD-SLAM) | Apprentissage profond (ex. : DROID-SLAM) |
|---|---|---|---|
| Principe | Détecte et décrit les caractéristiques, calcule la pose à partir des relations géométriques entre les correspondances | Ignore complètement les caractéristiques, minimise directement la luminosité de l'image pour trouver la pose | Un réseau neuronal apprend à remplacer l'extraction de caractéristiques, la correspondance et l'estimation de la pose/profondeur |
| Précision | Élevée lorsque les caractéristiques sont nombreuses ; tend à produire une carte clairsemée | Fonctionne partout où il y a un gradient de luminosité ; peut produire des cartes semi-denses à denses | Assez robuste même dans des environnements à faible texture ; profondeur dense facile à obtenir |
| Coût de calcul | Modéré (extraction de caractéristiques, descripteurs, correspondance) | Varie selon l'implémentation, généralement léger (DSO en particulier optimise l'efficacité) | Élevé (l'inférence seule nécessite souvent plusieurs Go à plus d'une douzaine de Go de mémoire GPU) |
| Robustesse | Faible dans les environnements à faible texture ou avec des objets dynamiques ; relativement robuste face aux changements d'éclairage | Sensible aux changements de luminosité (exposition automatique, éclairage) | Performant dans la plage de ses données d'entraînement, mais la généralisation à des environnements inconnus peut être limitée |
| Difficulté d'implémentation | Nombreuses implémentations open source éprouvées et faciles à adopter | Les calculs mathématiques (linéarisation de la luminosité) sont un peu plus complexes | L'utilisation d'un modèle pré-entraîné est simple ; le réentraînement ou l'optimisation des paramètres internes requièrent davantage d'expertise |
Les méthodes basées sur les caractéristiques sont les plus éprouvées, avec de nombreux déploiements embarqués ; les méthodes directes sont plus performantes lorsque les textures sont rares ; les méthodes d'apprentissage automatique progressent rapidement mais nécessitent une puissance de calcul plus importante — tel est le paysage actuel en 2026.
10. Le backend
Ce qui détermine en définitive la précision de Visual-SLAM, ce n'est pas seulement le frontend (extraction de caractéristiques, suivi, estimation de pose), mais le backend, qui affine l'ensemble des observations accumulées pour obtenir un résultat cohérent.
L'ajustement par faisceaux optimise conjointement les poses de la caméra et les positions 3D des points de repère afin d'assurer une cohérence maximale avec chaque observation. Elle minimise l'erreur totale de reprojection, c'est-à-dire l'écart entre la projection d'un point de repère \mathbf{X}_i sur une image via la pose de la caméra (R_j, \mathbf{t}_j) et l'emplacement réel de l'élément correspondant \mathbf{u}_{ij}.
\pi(\cdot) est la fonction de projection d'un point 3D sur le plan image, basée sur les paramètres intrinsèques de la caméra. L'ajustement global de faisceaux, qui optimise simultanément chaque image et chaque point de repère, est très précis mais coûteux en ressources ; en pratique, il est généralement associé à l'ajustement local de faisceaux, limité aux dernières images, afin de limiter la charge de calcul.
Lorsqu'une boucle de reprojection est détectée, l'optimisation par graphe de pose entre en jeu. Contrairement à l'ajustement de faisceaux, qui inclut tous les points de repère, l'optimisation par graphe de pose considère uniquement la pose de la caméra à chaque instant comme un nœud, les arêtes codant les contraintes de pose relative entre les images, optimisant ainsi rapidement la pose seule. La nouvelle contrainte ajoutée par la fermeture de boucle redistribue la dérive accumulée sur l'ensemble de la boucle.
Ces deux problèmes sont résolus dans le cadre de l'optimisation non linéaire. La fonction de projection \pi(\cdot) et la composition des rotations dans une pose étant intrinsèquement non linéaires, des méthodes itératives telles que Gauss-Newton et Levenberg-Marquardt sont utilisées, et des bibliothèques comme g2o et Ceres Solver sont largement employées dans les implémentations de Visual-SLAM.
11. Les limites de Visual-SLAM
Visual-SLAM dépendant d'un capteur passif (une caméra), sa précision se dégrade systématiquement dans certaines situations.
-
Obscurité : En l'absence de lumière suffisante, le rapport signal/bruit de l'image se dégrade, déstabilisant la détection de caractéristiques et les calculs de gradient de luminosité sur lesquels reposent les méthodes directes. Les caméras RGB-D à éclairage infrarouge peuvent compenser partiellement ce phénomène, mais l'effet est limité en extérieur la nuit. - Faible texture : Murs blancs, sols unis, surfaces vitrées – partout où les gradients de luminosité sont rares, les détails sont indétectables ou la minimisation par la méthode directe devient mal posée et sujette aux minima locaux.
-
Mouvement rapide : Les mouvements ou rotations rapides de la caméra élargissent la zone de recherche nécessaire pour trouver les correspondances entre les images et, combinés au flou de mouvement (voir ci-dessous), le suivi devient rapidement imprécis. L’utilisation d’une centrale inertielle (VIO) est la méthode standard pour pallier cette faiblesse.
-
Objets dynamiques : Traiter les détails d’un piéton ou d’une voiture en mouvement comme s’ils appartenaient à l’environnement statique introduit une erreur dans l’estimation du mouvement de la caméra. Cela nécessite soit un prétraitement pour détecter et exclure les objets dynamiques, soit des extensions qui les modélisent explicitement.
-
Flou de mouvement : Le flou causé par le mouvement de la caméra ou du sujet pendant la fenêtre d’exposition déstabilise les descripteurs de détails et dégrade la précision de la correspondance. Les caméras à obturateur global ou les environnements très lumineux avec des temps d’exposition courts atténuent cet impact.
Tous ces problèmes ont un point commun : la caméra ne reçoit tout simplement pas suffisamment d’informations visuelles pour fonctionner. Un capteur de télémétrie actif comme le LiDAR (voir Tendances technologiques LiDAR-SLAM) contourne la plupart de ces faiblesses en principe, mais présente ses propres inconvénients (voir section 2) : aucun capteur n’est universellement suffisant, et c’est précisément cette complémentarité qui rend la fusion de capteurs (voir le Présentation de la fusion de capteurs) si importante.
12. Choisir une méthode en pratique
Le choix d’une approche Visual-SLAM dépend fortement des capteurs disponibles, de la puissance de calcul disponible et des exigences de précision et de performance en temps réel de l’application.
-
Robots (robots de service intérieur, robots de nettoyage) : Souvent limités à des configurations de caméras à faible coût, les méthodes ORB-SLAM basées sur les caractéristiques ou la cartographie dense via des caméras RGB-D sont des choix pratiques. Dans les environnements comportant de nombreux couloirs et peu de textures, l’association avec un LiDAR est à envisager.
-
Drones : Les fortes contraintes de calcul et de poids de la charge utile favorisent les méthodes semi-directes légères comme SVO, ou les configurations VIO étroitement couplées avec une centrale inertielle (IMU).
-
Réalité augmentée/Réalité virtuelle : La performance en temps réel et la faible latence sont primordiales, et une configuration visuelle-inertielle associée à l’IMU intégrée du casque est devenue la norme de facto. En réalité augmentée, la cohérence globale détermine directement si les objets virtuels dérivent ; la précision de la boucle de fermeture est donc également cruciale.
-
Conduite autonome : Rarement utilisée comme SLAM visuel autonome ; Les informations visuelles issues de caméras sont généralement intégrées à un système de fusion multisensorielle, aux côtés des données LiDAR, radar et GNSS (voir le Guide d'introduction à la fusion de capteurs).
-
Intérieur vs. extérieur : En intérieur, les variations de luminosité sont faibles et l'environnement structuré, ce qui rend les méthodes basées sur les caractéristiques performantes. En extérieur, la variation de la luminosité, la présence d'objets dynamiques et l'immensité du terrain constituent des défis, rendant la robustesse de la boucle de rétroaction d'autant plus cruciale.
En 2026, l'axe de décision global se présente comme suit : privilégier l'apprentissage automatique si la puissance de calcul est abondante et que la précision maximale est l'objectif ; privilégier les méthodes basées sur les caractéristiques si l'historique du système embarqué et la faible consommation de ressources sont primordiaux ; et privilégier l'approche directe si la résilience dans les environnements pauvres en textures est essentielle. Les dernières orientations de recherche — la redéfinition de la représentation cartographique avec le splatting gaussien 3D/NeRF, les modèles de base 3D à propagation directe, et plus encore — sont abordées dans Visual-SLAM Trends.
Cinq vérifications avant la mise en œuvre
Choisir un algorithme uniquement par son nom rend le diagnostic des pannes sur le terrain difficile. Avant la mise en œuvre, assurez-vous que ces cinq points peuvent être consignés ; en cas de défaillance du suivi, vous pourrez ainsi distinguer un problème de capteur d'un problème d'estimateur.
| Vérification | Informations à préparer | Conséquences d'une vérification manquée |
|---|---|---|
| Calibrage | Paramètres intrinsèques K, distorsion de l'objectif et ligne de base stéréo (le cas échéant) | Une erreur de reprojection ressemble à une erreur de pose et l'échelle ne peut être évaluée |
| Synchronisation temporelle | Horodatage des images, décalage caméra-IMU et images perdues | Lors de mouvements rapides, les données d'image et inertielles décrivent des poses différentes. |
Obturateur et exposition : paramètres d'obturation globale/rolling shutter, temps d'exposition et exposition automatique. Un flou de mouvement ou une distorsion géométrique est interprété à tort comme une défaillance de l'algorithme.
Objets dynamiques : utilisation de masques, proportion d'objets en mouvement et correspondances rejetées. Les piétons ou les véhicules sont absorbés par la carte statique.
Journaux d'évaluation : vérité terrain, ATE/RPE, temps de perte de suivi et résultats de détection de boucles. « Il a bougé » ne suffit pas pour comparer la précision, la dérive ou la récupération.
Remplir ce tableau au préalable facilite également la distinction entre les éléments à modifier et ceux qui peuvent rester fixes lors du passage des méthodes basées sur les caractéristiques aux méthodes directes ou d'apprentissage. Le Visual-SLAM doit être choisi comme un système (caméra, synchronisation, prétraitement, optimisation et évaluation inclus) plutôt que comme un algorithme isolé.
13. Résumé
Visual-SLAM suit les correspondances à partir des seules images de la caméra, reconstitue le mouvement de la caméra par géométrie épipolaire et PnP, et corrige en continu l'erreur accumulée grâce à une fonction de mappage et de fermeture de boucle, réalisant ainsi une localisation et un mappage simultanés. Les trois philosophies de conception — basée sur les caractéristiques (famille ORB-SLAM), directe (DSO/LSD-SLAM) et basée sur l'apprentissage (DROID-SLAM) — reposent chacune sur un compromis différent et sont plus faciles à comprendre selon que les caractéristiques sont traitées explicitement, que la luminosité est utilisée directement ou non, et dans quelle mesure l'apprentissage est délégué. Le choix de la philosophie dépend de l'application, en tenant compte des capteurs disponibles, de la puissance de calcul et des performances requises en termes de précision et de temps réel.
14. Références
Les articles et pages de recherche principaux concernant les méthodes représentatives et la géométrie à deux vues mentionnées ci-dessus sont rassemblés ici comme points de départ pour la mise en œuvre et des pistes de recherche complémentaires. Pour éviter toute confusion entre les affirmations d'un article et les performances sur un produit ou un jeu de données particulier, consultez le texte associé en parallèle avec ses conditions expérimentales.
-
ORB-SLAM3 : Bibliothèque open source précise pour le SLAM visuel, visuo-inertiel et multi-cartes — Une bibliothèque couvrant les approches visuelles, visuo-inertielles et multi-cartes.
-
DROID-SLAM : SLAM visuel profond pour caméras monoculaires, stéréo et RGB-D — Une méthode d'apprentissage combinant volumes de corrélation et ajustement de faisceaux denses différentiables.
-
LSD-SLAM : SLAM monoculaire direct à grande échelle — La page de recherche officielle pour le SLAM monoculaire direct semi-dense.
-
Odométrie parcimonieuse directe — L'article de DSO sur l'optimisation de l'erreur photométrique par fenêtre glissante. - Une solution efficace au problème de la pose relative à cinq points — l'article original sur le solveur de matrice essentielle à 5 points.
Une carte attrayante permet-elle une localisation précise ?
Évaluez l'apparence de la carte indépendamment de l'erreur de trajectoire. Vérifiez l'échelle, l'alignement, l'erreur locale et la dérive à long terme.
Commentaires
Veuillez vous connecter.
Aucune entrée pour le moment.