Contents — find the section you need
Robot penyedot debu, drone, mobil otonom, dan kacamata AR semuanya memiliki satu persyaratan: menjawab pertanyaan "di mana saya berada sekarang?" GPS tidak berfungsi di dalam ruangan atau di kota-kota padat, dan peta tidak selalu tersedia sejak awal. Visual-SLAM adalah teknologi yang menjawab pertanyaan ini hanya menggunakan gambar kamera (kadang-kadang dipasangkan dengan sensor tambahan yang murah). Artikel ini dimulai dari mengapa robot kehilangan jejak posisinya sendiri, kemudian membahas pelacakan fitur, matematika geometri kamera, perbedaan antara Visual Odometry dan SLAM, silsilah algoritma penanda lokasi, dan akhirnya bagaimana memilihnya dalam praktik.
 Kamera input Visual-SLAM
 Contoh kamera kendaraan
Gambar: Intel Kamera kedalaman RealSense D435 (Marc Auledas, CC BY-SA 4.0) / Car Kamera jendela sistem Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Kamera representatif, bukan konfigurasi perangkat keras Visual-SLAM yang wajib.


0. Apa yang Dibahas Artikel Ini
- Apa itu Visual-SLAM, dan mengapa kamera saja dapat memperkirakan posisinya sendiri
- Bagaimana Visual Odometry (VO) berbeda dari SLAM
- Apa kontribusi ORB-SLAM, LSD-SLAM, DSO, SVO, dan DROID-SLAM sebagai pilihan desain
- Perbedaan antara pendekatan berbasis Fitur, Langsung, dan Berbasis Pembelajaran
- Di mana Visual-SLAM mengalami kesulitan, dan mengapa
- Bagaimana cara memilih metode yang tepat untuk robot, drone, AR/VR, atau mobil otonom
1. Apa yang Sebenarnya Dilakukan Visual-SLAM
Dalam satu kalimat: Visual-SLAM memperkirakan lintasan kamera sendiri melalui ruang (Lokalisasi) dan struktur 3D lingkungannya (Pemetaan) secara bersamaan, hanya menggunakan urutan gambar yang ditangkap kamera.
Nama itu sendiri — Simultaneous Localization And Mapping — menunjukkan hal yang paling penting: kata kuncinya. "Secara simultan." Jika peta sudah diketahui, menemukan posisi Anda sendiri akan menjadi masalah yang relatif mudah; jika posisi Anda sudah diketahui secara tepat, membangun peta juga akan mudah. Visual-SLAM tidak menghadapi kemewahan tersebut — membangun peta membutuhkan pengetahuan tentang posisi Anda, dan mengetahui posisi Anda membutuhkan peta. Ketergantungan ayam dan telur ini harus dipisahkan dari aliran pengamatan yang sama, pada waktu yang sama.
Inputnya adalah rangkaian gambar dari kamera (monokuler, stereo, atau RGB-D), dan outputnya adalah dua hal: pose kamera dengan 6 derajat kebebasan (3 untuk posisi, 3 untuk orientasi) pada setiap langkah waktu, dan peta yang mewakili lingkungan sekitar (sekumpulan titik fitur yang jarang, atau bentuk 3D yang padat). Robot penyedot debu yang mempelajari tata letak ruangan saat membersihkan, drone yang menstabilkan posisi melayangnya di dalam ruangan atau di bawah tanah di mana GPS tidak pernah menjangkau, headset AR yang melapisi objek virtual ke dunia nyata tanpa pergeseran — dalam setiap kasus ini, Visual-SLAM berjalan di bawahnya.
2. Mengapa Robot Tidak Tahu Di Mana Posisinya?
Untuk memahami masalah yang sebenarnya dipecahkan oleh Visual-SLAM, ada baiknya bertanya secara konkret: mengapa robot kehilangan jejak posisinya sendiri sejak awal?
Pertama, ada banyak lingkungan tanpa GPS, atau tanpa GPS yang dapat dipercaya. Di dalam ruangan, di bawah tanah, di terowongan, di lembah perkotaan di antara gedung pencakar langit (di mana pantulan multipath memperbesar kesalahan penentuan posisi), atau di bawah air dan di planet lain di mana konstelasi satelit bahkan tidak ada — tidak satu pun dari tempat-tempat ini memberi Anda cara untuk mendapatkan posisi absolut secara langsung.
Kedua, ada masalah tidak adanya peta. Struktur yang baru dibangun, lokasi bencana, permukaan planet yang belum dijelajahi — data peta yang sudah ada sebelumnya tidak selalu tersedia. Tanpa peta, "memeriksa posisi Anda terhadap peta" bahkan bukan pilihan.
Ketiga — dan yang paling mendasar — pembacaan sensor tunggal tidak dapat menentukan posisi absolut, bahkan secara prinsip. Kamera hanya memberi tahu Anda apa yang ada di sekitarnya saat ini. Melihat satu gambar tidak langsung memberi tahu Anda "ini berjarak 2,3 meter dari dinding itu, di ruang tamu" — mengenali dinding itu sebagai "dinding itu" membutuhkan pengalaman melihatnya sebelumnya, dan mengingat di mana Anda berada saat itu. Dengan kata lain, mengubah pengamatan saat ini menjadi informasi posisi yang bermakna membutuhkan korespondensi dengan pengamatan masa lalu (di mana Anda berada sekarang bergantung pada di mana Anda berada sebelumnya) — dan korespondensi itulah yang disediakan oleh peta.
Inti dari masalah SLAM adalah membangun korespondensi antara "apa yang saya lihat sekarang" dan "apa yang telah saya petakan sebelumnya," secara terus menerus dan konsisten, hanya dari data pengamatan, tanpa pernah memberikan posisi absolut eksternal. Satu korespondensi yang salah akan menyebarkan kesalahannya ke setiap estimasi berikutnya — dan bagaimana menekan kesalahan yang terakumulasi ini, dan bagaimana memperbaikinya setelah kejadian, adalah pertanyaan desain utama di balik setiap algoritma Visual-SLAM.
3. Apa yang Harus Ditemukan dalam Gambar Kamera
Output mentah kamera tidak lebih dari kisi nilai piksel — kecerahan, warna. Langkah pertama untuk mengetahui "bagaimana saya bergerak" adalah menemukan petunjuk yang dapat dilacak di dalam grid tersebut.
Fitur adalah titik lokal dalam gambar yang menonjol dengan jelas dari sekitarnya dan dapat dideteksi ulang secara andal bahkan ketika sudut pandang berubah — sudut, persimpangan tepi, tempat di mana gradien kecerahan berubah tajam ke berbagai arah. Sepetak langit biru yang seragam, yang tidak dapat dibedakan dari tetangganya, tidak dapat berfungsi sebagai fitur.
Deteksi Fitur menemukan titik fitur kandidat dalam satu gambar. Algoritma seperti ORB (Oriented FAST and Rotated BRIEF), SIFT, dan detektor sudut FAST menentukan piksel mana yang "terlihat seperti" fitur, dan menghitung deskriptor — ringkasan numerik dari penampilan lokal di sekitar masing-masing piksel.
Pelacakan Fitur menemukan dan mencocokkan fitur yang sama di frame berikutnya. Terdapat dua pendekatan utama: mencocokkan fitur yang terdeteksi berdasarkan kesamaan deskriptor (Pencocokan Fitur), dan memulai dari posisi fitur pada frame sebelumnya dan mencari lingkungannya pada frame berikutnya (Aliran Optik, secara klasik melalui metode Lucas-Kanade).
Hubungan ini — titik yang sama di dunia nyata muncul di lokasi berbeda di berbagai frame — disebut Korespondensi. Hampir setiap komputasi geometris dalam Visual-SLAM mengambil serangkaian korespondensi sebagai inputnya; tanpa satu korespondensi pun, pada prinsipnya, tidak ada petunjuk sama sekali tentang bagaimana kamera bergerak.
Aliran Optik adalah medan vektor yang menggambarkan seberapa jauh, dan ke arah mana, setiap titik dalam gambar (atau serangkaian titik yang jarang) bergerak antar frame — bukan hanya fitur. Di mana pelacakan berbasis fitur hanya mengikuti titik-titik yang paling khas, aliran optik dapat memanfaatkan informasi gerakan di area yang lebih luas, dengan biaya komputasi yang umumnya lebih tinggi.
4. Menghitung Pergerakan Kamera
Setelah korespondensi diperoleh, korespondensi tersebut dapat diubah secara geometris menjadi perkiraan pergerakan kamera. Dasar dari perhitungan tersebut adalah Geometri Epipolar.
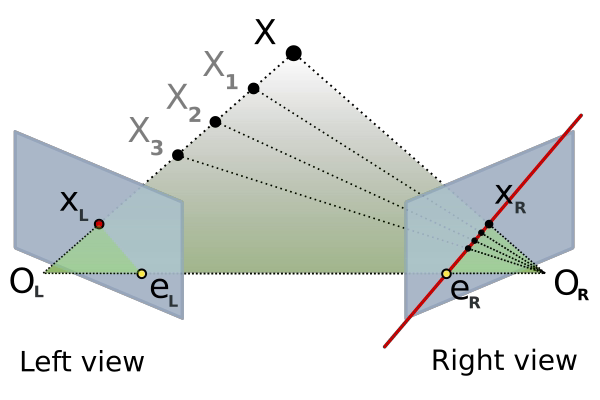
Gambar 1 — Dua sudut pandang kamera O_1 dan O_2, sebuah titik X di ruang angkasa, dan proyeksinya x_1, x_2 ke setiap bidang gambar. Dengan x_1, titik yang sesuai x_2 selalu dibatasi untuk terletak pada satu garis di gambar kedua (garis epipolar).
Gambar: Epipolar geometri (Arne Nordmann, CC BY-SA 3.0 / GFDL), Wikimedia Commons. SVG asli dikonversi ke PNG dengan latar belakang putih agar dapat ditampilkan dengan andal di browser.

Ketika titik yang sama X di ruang angkasa difoto dari dua sudut pandang yang berbeda, titik yang sesuai \mathbf{x}_2 dalam satu gambar, dengan titik \mathbf{x}_1 di gambar lainnya, tidak bebas berada di mana saja dalam gambar — titik tersebut harus terletak pada satu garis (garis epipolar). Matriks yang mengkodekan batasan geometris ini adalah Matriks Esensial E. Ketika parameter intrinsik kamera diketahui, titik-titik yang bersesuaian dalam koordinat kamera yang dinormalisasi memenuhi:
Di sini R dan \mathbf{t} adalah rotasi dan translasi dari kamera 1 ke kamera 2, dan [\mathbf{t}]_{\times} adalah matriks miring simetris yang dibangun dari \mathbf{t} yang merepresentasikan hasil perkalian silang sebagai perkalian matriks. Persamaan ini menyatakan bahwa batasan ini selalu berlaku di antara korespondensi \mathbf{x}_1, \mathbf{x}_2, dan rotasi serta translasi relatif kamera. Jumlah korespondensi yang dibutuhkan bergantung pada estimator: Matriks Esensial yang dikalibrasi memiliki penyelesai minimal 5 titik, sedangkan estimasi linier 8 titik menggunakan setidaknya 8 korespondensi. Data nyata mengandung outlier, sehingga sistem praktis mengumpulkan lebih banyak kecocokan dan menggabungkannya dengan RANSAC atau estimator tangguh lainnya. Ketika intrinsik tidak diketahui, atau ketika bekerja langsung dalam koordinat piksel, Matriks Fundamental F = K_2^{-\top} E K_1^{-1} , yang melipat matriks intrinsik K , memainkan peran yang sama.
Translasi \mathbf{t} yang diperoleh dari Matriks Esensial tidak membawa satuan dunia nyata (misalnya, meter) — dua gambar saja tidak dapat memberi tahu Anda apakah kamera bergerak satu meter atau dua meter. Ambiguitas skala ini merupakan kendala khusus untuk Visual-SLAM, khususnya konfigurasi monokular, dan akan dibahas kembali di Bagian 5.
Menghitung posisi 3D sebenarnya dari suatu korespondensi — koordinat titik X di ruang angkasa — disebut Triangulasi. Dengan memperpanjang dua sinar yang berasal dari setiap sudut pandang menuju X , kedua sinar tersebut idealnya akan berpotongan tepat di titik X ; Menemukan titik potong tersebut akan mengembalikan posisi 3D dari korespondensi (dalam praktiknya, noise observasi berarti sinar tidak bertemu tepat, sehingga titik terdekat dengan keduanya, dalam pengertian kuadrat terkecil, yang ditemukan sebagai gantinya).
Jika korespondensi tersedia antara landmark yang posisi 3D-nya sudah diketahui dan di mana ia muncul dalam gambar, pose kamera dapat dihitung langsung dari situ. Ini adalah masalah PnP (Perspective-n-Point): diberikan n titik 3D dan posisi proyeksinya dalam gambar, selesaikan untuk posisi dan orientasi kamera. Setelah peta sudah ada, PnP menjadi alat utama untuk menghitung pose kamera setiap frame baru.
5. Odometri Visual
Cukup dengan mengulangi "hitung gerakan kamera dari korespondensi," frame demi frame, sudah cukup untuk memperkirakan lintasan kamera. Ini adalah Odometri Visual (VO).
VO hanya menggabungkan gerakan relatif antara frame saat ini dan frame sebelumnya (atau beberapa frame terakhir) untuk membangun lintasan kamera. Umumnya, VO tidak memiliki mekanisme untuk mempertahankan peta yang persisten atau untuk mengenali tempat yang pernah dikunjungi sebelumnya — lebih mirip dengan odometer mobil, yang terus menghitung "seberapa jauh saya telah bergerak sejak saat ini."
Perbedaan antara VO dan SLAM terletak pada hal ini: apakah sistem tersebut mempertahankan peta dan memiliki mekanisme untuk memulihkan konsistensi dengan masa lalu. VO ringan dan mudah diimplementasikan, tetapi karena estimasi setiap frame selalu bergantung pada frame sebelumnya, kesalahan kecil akan terakumulasi tanpa batas seiring waktu. Kesalahan yang terakumulasi ini disebut Drift. Jika robot kembali ke titik awalnya, VO saja tidak memiliki cara untuk mengenali "Saya kembali ke tempat saya memulai" — lintasan yang diestimasi tetap bergeser dari titik awal dan tidak pernah kembali ke titik awal.
Ada masalah lain yang spesifik untuk VO, terutama VO monokular, yang telah dibahas di Bagian 4: masalah Skala. Gambar dari kamera monokuler saja tidak dapat menghasilkan satuan panjang absolut di dunia nyata — tidak ada dalam tampilan gambar yang membedakan "dipindahkan 2 meter, objek tampak dua kali lebih besar" dari "dipindahkan 4 meter, objek tampak empat kali lebih besar." Kamera stereo (yang memiliki jarak dasar yang diketahui antara kedua lensanya untuk menambatkan skala), kamera RGB-D (yang sensor kedalamannya memberikan jarak dunia nyata secara langsung), atau dipasangkan dengan IMU (yang akselerasi skala nyatanya memungkinkan skala diperkirakan) dapat mengatasi ambiguitas skala ini.
6. Apa yang Ditambahkan SLAM di Atas VO
Akan lebih mudah untuk menganggap SLAM sebagai VO ditambah bagian-bagian tambahan berikut.
Peta adalah representasi akumulasi dari posisi 3D setiap fitur yang diamati sejauh ini (atau bentuk 3D yang padat). Alih-alih hanya membandingkan dengan bingkai sebelumnya, seperti yang dilakukan VO, sistem sekarang dapat mencocokkan dengan semua yang terakumulasi dalam peta.
Landmark adalah elemen individual dari peta tersebut — biasanya titik fitur dengan posisi 3D. Setiap kali frame baru tiba, pencocokan frame tersebut dengan landmark yang terlihat pada frame tersebut memungkinkan sistem untuk memperkirakan posisi kamera secara konsisten, tidak hanya dengan frame sebelumnya, tetapi juga dengan seluruh peta yang telah dibangun selama riwayat pergerakan robot.
Penutupan Loop adalah keunggulan terpenting SLAM dibandingkan VO. Ketika robot kembali ke tempat yang pernah dikunjunginya sebelumnya, kemiripan gambar digunakan untuk mendeteksi fakta tersebut, dan batasan baru ditambahkan ke peta yang menghubungkan "di mana saya sekarang" dengan "di mana saya berada ketika pertama kali mengunjungi tempat ini." Penambahan batasan ini memungkinkan sistem untuk mendistribusikan kembali pergeseran yang terakumulasi di sepanjang loop dan memperbaikinya.
Hasil dari koreksi tersebut adalah Konsistensi Global. Sebelum penutupan loop, kesalahan yang terakumulasi berarti dua posisi di peta yang seharusnya berada di tempat fisik yang sama akhirnya tercatat sebagai lokasi yang sedikit berbeda. Koreksi penutupan loop mendeteksi perbedaan tersebut dan membentuk kembali seluruh peta menjadi bentuk yang konsisten — mekanisme penutupan loop inilah yang memungkinkan SLAM untuk menawarkan bukan hanya "rekaman gerakan" tetapi juga "peta yang konsisten."
7. Struktur Dasar Visual-SLAM
Dengan menggabungkan bagian-bagian ini, terungkap sebuah alur kerja yang secara garis besar dimiliki oleh setiap sistem Visual-SLAM modern utama.
Gambar 2 — Gambar dari Kamera dicocokkan dengan bingkai sebelumnya (Pelacakan Fitur/Langsung, menggunakan salah satu pendekatan dari Bagian 3 dan 8), yang mendorong Estimasi Pose (geometri epipolar dan PnP dari Bagian 4) dan, secara paralel, Pemetaan Lokal (menambahkan dan memperbarui landmark di bingkai yang baru saja dipetakan) (area yang diamati). Ketika loop terdeteksi, Loop Closing diaktifkan, dan lapisan Optimasi di Backend (Bagian 10) — Penyesuaian Bundel atau optimasi Grafik Pose — mengoreksi pose yang terakumulasi dan memetakannya menjadi satu kesatuan yang konsisten.
Gambar dari Kamera pertama-tama melalui Pelacakan Fitur/Langsung (salah satu pendekatan yang dibahas di Bagian 3 dan 8) untuk membangun korespondensi dengan bingkai sebelumnya. Dari korespondensi ini, Estimasi Pose (menggunakan geometri epipolar dan PnP dari Bagian 4) menghitung pose kamera, sementara Pemetaan Lokal (menambahkan dan memperbarui landmark di wilayah yang baru saja diamati) berjalan secara paralel. Ketika loop terdeteksi, Loop Closing diaktifkan, dan tahap Optimasi Backend (Bagian 10) mengoreksi pose yang terakumulasi dan memetakannya menjadi satu kesatuan yang konsisten secara global. Hasil akhir dari pipeline ini adalah output akhir: Pose (lintasan) kamera dan Peta (struktur 3D lingkungannya).
8. Algoritma Penting
Sejarah Visual-SLAM paling mudah diikuti dari satu sumbu: seberapa banyak yang dirancang secara eksplisit, dan seberapa banyak yang diserahkan kepada pembelajaran.
PTAM (Parallel Tracking and Mapping, Klein & Murray, 2007) adalah sistem perintis yang menjalankan Pelacakan (estimasi pose) dan Pemetaan (pembuatan peta) sebagai thread paralel terpisah. Pelacakan berjalan cepat, setiap frame, sementara Penyesuaian Bundel yang mahal secara komputasi untuk Pemetaan berjalan di thread latar belakang dengan lebih banyak waktu luang — ide pemisahan Pelacakan dari Pemetaan ini diwarisi oleh banyak sistem Visual-SLAM selanjutnya.
ORB-SLAM (Mur-Artal, Montiel & Tardós, 2015) dibangun di sekitar fitur ORB, menggabungkan struktur tiga thread (Pelacakan, Pemetaan Lokal, Penutupan Loop) dengan Pengenalan Tempat (pencocokan terhadap frame sebelumnya melalui Bag-of-Words) untuk mencapai kinerja monokular yang praktis. ORB-SLAM2 (Mur-Artal & Tardós, 2017) memperluas kerangka kerja tersebut dari monokular ke kamera stereo dan RGB-D. ORB-SLAM3 (Campos, Elvira, Gómez Rodríguez, Montiel & Tardós, 2021) menambahkan keterkaitan erat dengan IMU (Visual-Inertial SLAM) dan Multi-Map SLAM, yang mempertahankan beberapa peta dan menggabungkannya sesuai kebutuhan — dan tetap menjadi, hingga saat ini, implementasi referensi de facto untuk SLAM berbasis fitur.
LSD-SLAM (Large-Scale Direct monocular SLAM, Engel, Schöps & Cremers, 2014) adalah contoh penting dari metode Langsung, yang menunjukkan bahwa pose kamera dapat diperkirakan menggunakan kecerahan gambar secara langsung, tanpa langkah deteksi fitur, pada skala besar. Melewatkan ekstraksi fitur sama sekali memungkinkannya untuk memanfaatkan informasi bahkan di mana fitur-fiturnya jarang.
DSO (Direct Sparse Odometry, Engel, Koltun & Cremers, pertama kali diperkenalkan pada tahun 2016, diterbitkan tahun 2018) tetap menggunakan metode langsung, tetapi alih-alih estimasi semi-padat yang dihasilkan LSD-SLAM, metode ini meminimalkan kesalahan fotometrik pada sekumpulan titik yang jarang, sehingga mencapai akurasi dan efisiensi komputasi.
SVO (Fast Semi-Direct Monocular Visual Odometry, Forster, Pizzoli & Scaramuzza, 2014) menggabungkan deteksi fitur dengan metode langsung dalam pendekatan semi-langsung, melacak kecerahan pada area di sekitar fitur yang terdeteksi untuk mencapai operasi cepat pada kecepatan frame tinggi — dirancang dengan mempertimbangkan platform dengan keterbatasan sumber daya seperti drone.
DROID-SLAM (Teed & Deng, 2021) menggantikan langkah ekstraksi dan pencocokan fitur eksplisit sepenuhnya dengan pembelajaran mendalam, memperkirakan pose kamera dan kedalaman per piksel melalui volume korelasi, operator pembaruan berulang, dan lapisan Penyesuaian Bundel yang dapat dibedakan — pendekatan berbasis Pembelajaran yang representatif (mekanisme internalnya dibahas lebih detail di Tren Visual-SLAM).
9. Berbasis Fitur vs. Langsung vs. Berbasis Pembelajaran
Singkatnya, algoritma ini termasuk dalam salah satu dari tiga filosofi desain.
| Aspek | Berbasis Fitur (misalnya ORB-SLAM3) | Langsung (misalnya DSO/LSD-SLAM) | Berbasis Pembelajaran (misalnya DROID-SLAM) |
|---|---|---|---|
| Prinsip | Mendeteksi dan mendeskripsikan fitur, menghitung pose dari hubungan geometris antar korespondensi | Melewatkan fitur sepenuhnya, meminimalkan kecerahan gambar secara langsung untuk menemukan pose | Jaringan saraf belajar untuk menggantikan ekstraksi fitur, korespondensi, dan estimasi pose/kedalaman |
| Akurasi | Tinggi di mana fitur berlimpah; cenderung menghasilkan peta yang jarang | Bekerja di mana pun ada gradien kecerahan; dapat menghasilkan peta semi-padat hingga padat | Cukup kuat bahkan di lingkungan dengan tekstur rendah; mudah untuk mendapatkan kedalaman yang padat |
| Biaya komputasi | Sedang (ekstraksi fitur, deskriptor, pencocokan) | Bervariasi tergantung implementasi, umumnya ringan (DSO khususnya mengoptimalkan efisiensi) | Tinggi (inferensi saja sering membutuhkan beberapa hingga lebih dari selusin GB memori GPU) |
| Ketahanan | Lemah di lingkungan dengan tekstur rendah atau dengan objek dinamis; relatif kuat terhadap perubahan pencahayaan | Sensitif terhadap perubahan kecerahan (pencahayaan otomatis, pencahayaan) | Kuat dalam rentang data pelatihannya, tetapi generalisasi ke lingkungan yang belum pernah dilihat sebelumnya dapat terbatas |
Kesulitan implementasi | Banyak implementasi open-source yang matang, mudah diadopsi | Matematika (linierisasi kecerahan) agak lebih rumit | Mudah menggunakan model yang sudah dilatih sebelumnya; pelatihan ulang atau penyetelan internal membutuhkan lebih banyak keahlian |
Metode berbasis fitur memiliki rekam jejak terpanjang, termasuk banyak penerapan terintegrasi; Metode langsung lebih baik di mana tekstur langka; Metode berbasis pembelajaran berkembang pesat tetapi membutuhkan komputasi yang lebih berat — kira-kira itulah lanskap saat ini pada tahun 2026.
10. Backend
Yang pada akhirnya menentukan akurasi Visual-SLAM bukanlah hanya frontend (ekstraksi fitur, pelacakan, estimasi pose) — melainkan Backend, yang memoles seluruh kumpulan pengamatan yang terkumpul menjadi sesuatu yang konsisten.
Penyesuaian Bundel secara bersamaan mengoptimalkan pose kamera dan posisi 3D landmark sehingga konsisten secara maksimal dengan setiap pengamatan. Ini meminimalkan total kesalahan reproyeksi — perbedaan antara landmark \mathbf{X}_i yang diproyeksikan ke dalam gambar melalui pose kamera (R_j, \mathbf{t}_j) dan di mana fitur yang sesuai sebenarnya diamati, \mathbf{u}_{ij} .
\pi(\cdot) adalah fungsi proyeksi dari titik 3D ke bidang gambar, berdasarkan parameter intrinsik kamera. Penyesuaian Bundel Global, yang mengoptimalkan setiap frame dan setiap landmark secara bersamaan, sangat akurat tetapi mahal; dalam praktiknya biasanya dipasangkan dengan Penyesuaian Bundel Lokal, yang dibatasi hanya pada beberapa frame terbaru, untuk menjaga agar komputasi tetap terkendali.
Ketika penutupan loop terdeteksi, optimasi Grafik Pose mulai berperan. Tidak seperti Penyesuaian Bundel, yang mencakup setiap landmark, optimasi Grafik Pose hanya memperlakukan pose kamera pada setiap langkah waktu sebagai node, dengan tepi yang mengkodekan batasan pose relatif antar frame — mengoptimalkan pose saja, dengan cepat. Kendala baru yang ditambahkan oleh penutupan loop mendistribusikan kembali pergeseran yang terakumulasi di seluruh loop.
Kedua hal ini diselesaikan dalam kerangka Optimasi Nonlinier. Karena fungsi proyeksi \pi(\cdot) dan komposisi rotasi dalam sebuah pose pada dasarnya nonlinier, metode iteratif seperti Gauss-Newton dan Levenberg-Marquardt digunakan, dan pustaka seperti g2o dan Ceres Solver banyak diandalkan dalam implementasi Visual-SLAM.
11. Di Mana Visual-SLAM Mengalami Kesulitan
Karena Visual-SLAM bergantung pada sensor pasif — kamera — akurasinya menurun secara sistematis dalam beberapa situasi.
-
Kegelapan: Tanpa cahaya yang cukup, rasio sinyal-ke-derau gambar menurun, sehingga mengganggu deteksi fitur dan perhitungan gradien kecerahan yang diandalkan oleh metode langsung. Kamera RGB-D yang diterangi inframerah dapat mengkompensasi sampai batas tertentu, tetapi efeknya terbatas di luar ruangan pada malam hari.
-
Tekstur rendah: Dinding putih, lantai polos, permukaan kaca — di mana pun gradien kecerahan langka, fitur tidak dapat ditemukan, atau minimisasi metode langsung menjadi tidak tepat dan rentan terhadap minimum lokal.
-
Gerakan cepat: Pergerakan atau rotasi kamera yang cepat memperluas rentang pencarian yang dibutuhkan untuk menemukan korespondensi antar frame, dan dikombinasikan dengan blur gerak (di bawah), pelacakan mudah rusak. Memadukan dengan IMU (VIO) adalah cara standar untuk mengkompensasi kelemahan ini.
-
Objek dinamis: Memperlakukan fitur pada pejalan kaki atau mobil yang bergerak seolah-olah mereka termasuk dalam lingkungan statis menyuntikkan kesalahan ke dalam perkiraan gerakan kamera itu sendiri. Ini membutuhkan pra-pemrosesan untuk mendeteksi dan mengecualikan objek dinamis, atau ekstensi yang memodelkannya secara eksplisit.
-
Blur Gerak: Blur yang disebabkan oleh gerakan kamera atau subjek selama jendela eksposur, yang mendestabilisasi deskriptor fitur dan menurunkan akurasi pencocokan. Kamera rana global atau lingkungan dengan cahaya tinggi dengan waktu eksposur singkat mengurangi dampaknya.
Semua ini memiliki kesamaan: kamera tidak mendapatkan cukup informasi visual untuk diolah. Sensor pengukur jarak aktif seperti LiDAR (lihat Tren Teknologi LiDAR-SLAM) pada prinsipnya menghindari sebagian besar kelemahan ini, tetapi memiliki serangkaian kelemahan tersendiri (lihat Bagian 2) — tidak ada satu sensor pun yang cukup universal, dan komplementaritas inilah yang menjadi alasan mengapa Sensor Fusion (lihat Panduan Sensor Fusion) penting.
12. Memilih Metode dalam Praktik
Cara memilih pendekatan Visual-SLAM sangat bergantung pada sensor apa yang dapat Anda bawa, berapa banyak daya komputasi yang tersedia, dan akurasi serta kinerja waktu nyata apa yang dibutuhkan aplikasi.
- Robot (robot layanan dalam ruangan, robot pembersih): Seringkali dibatasi pada pengaturan kamera berbiaya rendah, di mana metode keluarga ORB-SLAM berbasis fitur atau pemetaan padat melalui kamera RGB-D merupakan pilihan praktis. Di lingkungan dengan banyak koridor dan tekstur rendah, pemasangan dengan LiDAR patut dipertimbangkan.
- Drone: Keterbatasan yang parah pada komputasi dan berat muatan mendorong ke arah metode semi-langsung yang ringan seperti SVO, atau konfigurasi VIO yang terhubung erat dengan IMU.
- AR/VR: Kinerja waktu nyata dan latensi rendah adalah prioritas utama, dan konfigurasi Visual-Inertial yang dipasangkan dengan IMU bawaan headset telah menjadi standar de facto. Khususnya dalam AR, Konsistensi Global secara langsung menentukan apakah objek virtual bergeser, sehingga akurasi penutupan loop juga sangat penting.
- Pengemudi otonom: Jarang digunakan sebagai Visual-SLAM mandiri; Informasi visual berbasis kamera biasanya digabungkan ke dalam pengaturan fusi multi-sensor bersama dengan LiDAR, radar, dan GNSS (lihat Panduan Fusi Sensor).
- Dalam ruangan vs. luar ruangan: Di dalam ruangan, perubahan pencahayaan bersifat lembut dan terdapat banyak struktur, sehingga metode berbasis fitur cenderung bekerja dengan baik; di luar ruangan, variasi pencahayaan, objek dinamis, dan skala yang luas menjadi tantangan, sehingga ketahanan penutupan loop menjadi jauh lebih penting.
Pada tahun 2026, sumbu keputusan kasar terlihat seperti ini: pilih Berbasis Pembelajaran jika komputasi melimpah dan akurasi tertinggi adalah tujuannya, Berbasis Fitur jika rekam jejak yang tertanam dan penggunaan sumber daya yang rendah paling penting, dan Langsung jika ketahanan di lingkungan yang miskin tekstur sangat penting. Arah penelitian terbaru — membentuk ulang representasi peta dengan 3D Gaussian Splatting/NeRF, model dasar 3D feed-forward, dan lainnya — dibahas dalam Tren Visual-SLAM.
Lima pemeriksaan sebelum implementasi
Memilih berdasarkan nama algoritma saja membuat kegagalan di lapangan sulit didiagnosis. Sebelum implementasi, pastikan kelima hal ini dapat dicatat; ketika pelacakan gagal, Anda kemudian dapat memisahkan masalah sensor dari masalah estimator.
| Periksa | Informasi yang perlu disiapkan | Apa yang salah jika terlewatkan |
|---|---|---|
| Kalibrasi | Intrinsik K , distorsi lensa, dan garis dasar stereo jika berlaku | Kesalahan reproyeksi terlihat seperti kesalahan pose, dan skala tidak dapat dievaluasi |
| Sinkronisasi waktu | Stempel waktu bingkai, offset kamera–IMU, dan bingkai yang hilang | Selama gerakan cepat, data gambar dan inersia menggambarkan pose yang berbeda |
| Rana dan eksposur | Rana global/bergulir, waktu eksposur, dan pengaturan eksposur otomatis | Kekaburan gerak atau distorsi geometris disalahartikan sebagai kegagalan algoritma |
| Objek dinamis | Apakah masker digunakan, fraksi objek bergerak, dan korespondensi yang ditolak | Pejalan kaki atau kendaraan diserap ke dalam peta statis |
| Log evaluasi | Kebenaran dasar, ATE/RPE, waktu kehilangan jejak, dan hasil deteksi loop | "Itu bergerak" tidak cukup untuk membandingkan akurasi, pergeseran, atau pemulihan |
Mengisi tabel ini terlebih dahulu juga memudahkan untuk memisahkan apa yang harus diubah dan apa yang dapat tetap tetap saat beralih dari metode berbasis fitur ke metode langsung atau berbasis pembelajaran. Visual-SLAM harus dipilih sebagai sebuah sistem — termasuk kamera, pengaturan waktu, pra-pemrosesan, optimasi, dan evaluasi — daripada sebagai algoritma secara terpisah.
13. Ringkasan
Visual-SLAM melacak korespondensi hanya dari gambar kamera, memulihkan gerakan kamera melalui geometri epipolar dan PnP, dan terus menerus mengoreksi kesalahan yang terakumulasi melalui peta dan penutupan loop — mencapai lokalisasi dan pemetaan simultan. Tiga filosofi desain — Berbasis Fitur (keluarga ORB-SLAM), Langsung (DSO/LSD-SLAM), dan Berbasis Pembelajaran (DROID-SLAM) — masing-masing bertumpu pada kompromi yang berbeda, dan paling mudah dipahami sepanjang sumbu apakah fitur ditangani secara eksplisit, apakah kecerahan digunakan secara langsung, dan seberapa banyak yang didelegasikan ke pembelajaran. Mana yang sebenarnya dipilih adalah keputusan spesifik aplikasi, yang diseimbangkan dengan sensor yang tersedia, komputasi, dan akurasi serta kinerja waktu nyata yang dibutuhkan.
14. Referensi
Makalah dan halaman penelitian utama untuk metode representatif dan geometri dua pandangan yang dibahas di atas dikumpulkan di sini sebagai titik awal untuk implementasi dan bacaan lebih lanjut. Untuk menghindari kebingungan antara klaim suatu makalah dengan kinerja pada produk atau dataset tertentu, bacalah teks yang ditautkan bersama dengan kondisi eksperimennya.
- ORB-SLAM3: Pustaka Sumber Terbuka Akurat untuk SLAM Visual, Visual-Inersial, dan Multi-Peta — sebuah pustaka yang mencakup desain visual, visual-inersial, dan multi-peta.
- DROID-SLAM: SLAM Visual Mendalam untuk Kamera Monokular, Stereo, dan RGB-D — metode berbasis pembelajaran yang menggabungkan volume korelasi dengan penyesuaian bundel padat yang dapat dibedakan.
- LSD-SLAM: SLAM Monokular Langsung Skala Besar — halaman penelitian resmi untuk SLAM monokular langsung dan semi-padat.
- Direct Sparse Odometry — makalah DSO tentang optimasi kesalahan fotometrik jendela geser. - Solusi efisien untuk masalah pose relatif lima titik — makalah asli tentang pemecah Matriks Esensial 5 titik.
Apakah peta yang menarik menghasilkan lokalisasi yang akurat?
Evaluasi tampilan peta secara terpisah dari kesalahan lintasan. Periksa skala, keselarasan, kesalahan lokal, dan pergeseran jangka panjang.
Komentar
Silakan masuk terlebih dahulu.
Belum ada data.