Contents — find the section you need
Las aspiradoras robot, los drones, los coches autónomos y las gafas de realidad aumentada comparten un requisito: responder a la pregunta "¿dónde estoy ahora mismo?". El GPS no funciona en interiores ni en ciudades densamente pobladas, y, para empezar, no siempre se dispone de un mapa. Visual-SLAM es la tecnología que responde a esta pregunta utilizando únicamente imágenes de cámara (a veces combinadas con sensores auxiliares económicos). Este artículo comienza explicando por qué un robot pierde la noción de su posición, luego aborda el seguimiento de características, las matemáticas de la geometría de la cámara, la diferencia entre la odometría visual y SLAM, el origen de los algoritmos de reconocimiento de puntos de referencia y, finalmente, cómo elegir uno en la práctica.
 Cámara de entrada Visual-SLAM
 Ejemplo de cámara de vehículo
Imágenes: Intel Cámara de profundidad RealSense D435 (Marc Auledas, CC BY-SA 4.0) / Car Cámara de ventana del sistema Mobileye (Ranbar, CC BY-SA 4.0), Wikimedia Comunes. Cámaras representativas, no una configuración de hardware Visual-SLAM requerida.


0. Contenido de este artículo
- Qué es Visual-SLAM y por qué una cámara por sí sola puede estimar su propia posición
- En qué se diferencia la odometría visual (VO) de SLAM
- Qué aportan ORB-SLAM, LSD-SLAM, DSO, SVO y DROID-SLAM como opciones de diseño
- La diferencia entre los enfoques basados en características, directos y basados en aprendizaje
- Dónde tiene dificultades Visual-SLAM y por qué
- Cómo elegir un método para un robot, un dron, AR/VR o un coche autónomo
1. Qué hace Visual-SLAM
En una frase: Visual-SLAM estima simultáneamente la trayectoria de una cámara en el espacio (Localización) y la estructura 3D de su entorno (Mapeo), utilizando únicamente la secuencia de imágenes que captura la cámara.
El nombre en sí —Localización y Mapeo Simultáneos— apunta a lo más importante: la palabra "Simultáneo". Si el mapa ya se conociera, encontrar la propia posición sería relativamente fácil; si la posición se conociera con precisión, construir el mapa también sería sencillo. Visual-SLAM no se enfrenta a ninguna de estas ventajas: construir el mapa requiere conocer la posición, y conocer la posición requiere el mapa. Esta dependencia, que se asemeja a un círculo vicioso, debe resolverse a partir del mismo flujo de observaciones, simultáneamente.
La entrada es una serie temporal de imágenes de una cámara (monocular, estéreo o RGB-D), y la salida consta de dos elementos: la pose de la cámara con 6 grados de libertad (3 para la posición y 3 para la orientación) en cada instante, y un mapa que representa el entorno (un conjunto disperso de puntos característicos o una forma 3D densa). Una aspiradora robot que aprende la distribución de una habitación mientras limpia, un dron que estabiliza su vuelo estacionario en interiores o bajo tierra donde el GPS no llega, unas gafas de realidad aumentada que superponen objetos virtuales al mundo real sin desviaciones: en todos estos casos, Visual-SLAM está funcionando subyacentemente.
2. ¿Por qué un robot no sabe dónde está?
Para comprender el problema que Visual-SLAM resuelve, conviene preguntarse concretamente: ¿por qué un robot pierde la noción de su posición?
Primero, existen numerosos entornos sin GPS, o con un GPS poco fiable. Interiores, subterráneos, túneles, los cañones urbanos entre rascacielos (donde las reflexiones multitrayecto aumentan el error de posicionamiento), bajo el agua o en otros planetas donde ni siquiera existe una constelación de satélites: ninguno de estos entornos permite obtener una posición absoluta directamente.
Segundo, está el problema de la simple inexistencia de un mapa. Una estructura recién construida, una zona de desastre, una superficie planetaria inexplorada: los datos cartográficos preexistentes no siempre están disponibles. Sin un mapa, «comprobar la posición con el mapa» ni siquiera es una opción.
Tercero, y lo más importante, una sola lectura de un sensor no puede determinar la posición absoluta, ni siquiera en teoría. Una cámara solo te muestra lo que hay a su alrededor en ese preciso instante. Al observar una imagen, no te dice al instante: "Esto está a 2,3 metros de esa pared, en el salón". Reconocer esa pared como "esa pared" requiere haberla visto antes y recordar dónde estabas cuando la viste. En otras palabras, convertir una observación actual en información de posición útil requiere una correspondencia con observaciones anteriores (tu ubicación actual depende de dónde has estado), y esa correspondencia es precisamente lo que proporciona un mapa.
La esencia del problema SLAM reside en construir esta correspondencia entre "lo que veo ahora" y "lo que he mapeado antes", de forma continua y consistente, a partir únicamente de los datos de observación, sin que se proporcione nunca una posición absoluta externa. Una sola correspondencia errónea propaga su error a todas las estimaciones posteriores, y cómo suprimir este error acumulado y cómo corregirlo a posteriori es la cuestión central del diseño de todo algoritmo Visual-SLAM.
3. Qué encontrar en una imagen de cámara
La salida sin procesar de una cámara no es más que una cuadrícula de valores de píxeles: brillo, color. El primer paso para comprender "cómo me moví" es encontrar pistas rastreables dentro de esa cuadrícula.
Una Característica es un punto local en la imagen que destaca claramente de su entorno y que puede detectarse de forma fiable incluso al cambiar el punto de vista: una esquina, una intersección de bordes, un lugar donde los gradientes de brillo cambian bruscamente en múltiples direcciones. Una zona uniforme de cielo azul, indistinguible de sus vecinas, no puede considerarse una característica.
La Detección de Características encuentra posibles puntos característicos dentro de una sola imagen. Algoritmos como ORB (Oriented FAST and Rotated BRIEF), SIFT y el detector de esquinas FAST determinan qué píxeles "parecen" características y calculan un descriptor: un resumen numérico de la apariencia local alrededor de cada una.
El Seguimiento de Características encuentra y compara esas mismas características en el siguiente fotograma. Existen dos enfoques principales: la coincidencia de características detectadas mediante la similitud de descriptores (coincidencia de características) y la exploración de su entorno en el siguiente fotograma, partiendo de la posición de una característica en el fotograma anterior (flujo óptico, clásicamente mediante el método de Lucas-Kanade).
Esta relación —la aparición de un mismo punto en el mundo real en diferentes ubicaciones a lo largo de distintos fotogramas— se denomina correspondencia. Casi todos los cálculos geométricos en Visual-SLAM utilizan un conjunto de correspondencias como entrada; sin una sola correspondencia, en principio, no hay ninguna pista sobre el movimiento de la cámara.
El flujo óptico es un campo vectorial que describe la distancia y la dirección del movimiento de cada punto de la imagen (o un conjunto disperso de puntos) entre fotogramas, no solo de las características. Mientras que el seguimiento basado en características solo sigue los puntos más distintivos, el flujo óptico puede aprovechar la información de movimiento en un área más amplia, aunque con un coste computacional generalmente mayor.
4. Cálculo del movimiento de la cámara
Una vez establecidas las correspondencias, se pueden transformar geométricamente en una estimación del movimiento de la cámara. La base de este cálculo es la geometría epipolar.
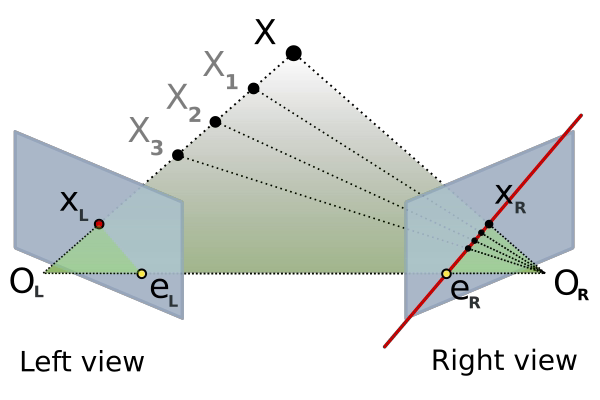
Figura 1 — Dos puntos de vista de cámara O_1 y O_2, un punto X en el espacio y sus proyecciones x_1 y x_2 sobre cada plano de imagen. Dado x_1, su punto correspondiente x_2 siempre está restringido a estar sobre una sola línea en la segunda imagen (la línea epipolar).
Figura: Epipolar geometry (Arne Nordmann, CC BY-SA 3.0 / GFDL), Wikimedia Commons. El SVG original se convierte a PNG con fondo blanco para una visualización correcta en el navegador.

Cuando se fotografía el mismo punto X en el espacio desde dos puntos de vista diferentes, el punto correspondiente \mathbf{x}_2 en una imagen, dado un punto \mathbf{x}_1 en la otra, no puede ubicarse libremente en cualquier parte de la imagen; debe estar sobre una sola línea (la línea epipolar). La matriz que codifica esta restricción geométrica es la Matriz Esencial E. Cuando se conocen los parámetros intrínsecos de la cámara, los puntos correspondientes en coordenadas normalizadas de la cámara satisfacen:
Aquí, R y \mathbf{t} representan la rotación y la traslación de la cámara 1 a la cámara 2, y [\mathbf{t}]_{\times} es la matriz antisimétrica construida a partir de \mathbf{t} que representa un producto vectorial como una multiplicación de matrices. Esta ecuación indica que esta restricción siempre se cumple entre una correspondencia \mathbf{x}_1, \mathbf{x}_2 y la rotación y traslación relativas de la cámara. El número de correspondencias requerido depende del estimador: una matriz esencial calibrada tiene un solucionador mínimo de 5 puntos, mientras que la estimación lineal de 8 puntos utiliza al menos 8 correspondencias. Los datos reales contienen valores atípicos, por lo que los sistemas prácticos recopilan más coincidencias y las combinan con RANSAC u otro estimador robusto. Cuando se desconocen los parámetros intrínsecos, o cuando se trabaja directamente con coordenadas de píxeles, la Matriz Fundamental F = K_2^{-\top} E K_1^{-1}, que incorpora la matriz intrínseca K, cumple la misma función.
La traslación \mathbf{t} obtenida de la Matriz Esencial no tiene una unidad del mundo real (metros, por ejemplo); dos imágenes por sí solas no permiten determinar si la cámara se movió uno o dos metros. Esta ambigüedad de escala es una limitación específica de Visual-SLAM, particularmente en configuraciones monoculares, y se retoma en la Sección 5.
El cálculo de la posición 3D real de una correspondencia —las coordenadas del punto X en el espacio— se denomina Triangulación. Al extender los dos rayos que parten de cada punto de vista hacia X, estos dos rayos deberían, idealmente, intersecarse exactamente en el punto X. Encontrar esa intersección permite recuperar la posición 3D de la correspondencia (en la práctica, el ruido de observación impide que los rayos se encuentren exactamente, por lo que se busca el punto más cercano a ambos, en el sentido de mínimos cuadrados).
Si existe una correspondencia entre un punto de referencia cuya posición 3D ya se conoce y su ubicación en la imagen, la pose de la cámara se puede calcular directamente a partir de ella. Este es el problema PnP (Perspectiva de n puntos): dados n puntos 3D y sus posiciones proyectadas en la imagen, se calcula la posición y orientación de la cámara. Una vez que existe un mapa, PnP se convierte en la herramienta principal para calcular la pose de la cámara en cada nuevo fotograma.
5. Odometría Visual
Repitiendo simplemente "calcular el movimiento de la cámara a partir de correspondencias", fotograma tras fotograma, es suficiente para estimar la trayectoria de la cámara. Esto es la Odometría Visual (OV).
La visión óptica (VO) solo combina el movimiento relativo entre el fotograma actual y el anterior (o los últimos fotogramas) para construir la trayectoria de la cámara. Generalmente, carece de un mecanismo para mantener un mapa persistente o para reconocer un lugar visitado previamente; su funcionamiento se asemeja más al del odómetro de un coche, que calcula continuamente "cuánto he avanzado desde hace un momento".
La diferencia entre VO y SLAM radica precisamente en esto: si el sistema mantiene un mapa y dispone de un mecanismo para recuperar la coherencia con el pasado. VO es ligero y sencillo de implementar, pero dado que la estimación de cada fotograma siempre depende del anterior, los pequeños errores se acumulan sin límite con el tiempo. Este error acumulado se denomina deriva. Si un robot regresa a su punto de partida, VO por sí solo no tiene forma de reconocer "he vuelto al punto de partida"; la trayectoria estimada permanece desviada del inicio y nunca se cierra.
Existe otro problema específico de VO, especialmente de VO monocular, que ya se abordó en la Sección 4: el problema de la escala. Las imágenes de una cámara monocular por sí solas no pueden recuperar una unidad de longitud absoluta del mundo real; nada en la apariencia de la imagen distingue entre "movido 2 metros, el objeto parece el doble de grande" y "movido 4 metros, el objeto parece cuatro veces más grande". Una cámara estéreo (que tiene una distancia de referencia conocida entre sus dos lentes para anclar la escala), una cámara RGB-D (cuyo sensor de profundidad proporciona distancias del mundo real directamente) o la combinación con una IMU (cuya aceleración a escala real permite estimar la escala) pueden resolver esta ambigüedad de escala.
6. Lo que SLAM añade a la VO
Es útil pensar en SLAM como VO más los siguientes elementos adicionales.
Un Mapa es una representación acumulada de la posición 3D de cada elemento observado hasta el momento (o una forma 3D densa). En lugar de comparar solo con el fotograma inmediatamente anterior, como hace la VO, el sistema ahora puede comparar con todo lo acumulado en el mapa.
Un Punto de Referencia es un elemento individual de ese mapa, generalmente un punto característico con una posición 3D. Cada vez que llega un nuevo fotograma, al compararlo con los puntos de referencia visibles en él, el sistema estima la pose de la cámara de forma consistente, no solo con el fotograma anterior, sino con todo el mapa construido a lo largo del historial del robot.
El cierre de bucle es la principal ventaja de SLAM sobre la VO. Cuando un robot regresa a un lugar que ya ha visitado, se utiliza la similitud de imágenes para detectarlo y se añade una nueva restricción al mapa que vincula "dónde estoy ahora" con "dónde estaba cuando visité este lugar por primera vez". Esta restricción permite al sistema redistribuir la desviación acumulada a lo largo del bucle y corregirla.
El resultado de esta corrección es la consistencia global. Antes del cierre de bucle, el error acumulado provoca que dos posiciones en el mapa que deberían ser el mismo lugar físico se registren como ubicaciones ligeramente diferentes. La corrección del cierre de bucle detecta esta discrepancia y reformatea todo el mapa para que sea coherente. Este mecanismo de cierre de bucle es precisamente la razón por la que SLAM puede ofrecer no solo "un registro de movimiento", sino "un mapa coherente".
7. Estructura básica de Visual-SLAM
Al unir estas piezas, se revela un flujo de trabajo común, a grandes rasgos, a todos los principales sistemas Visual-SLAM modernos.
Figura 2: Las imágenes de la cámara se comparan con el fotograma anterior (Seguimiento directo/de características, utilizando uno de los enfoques de las secciones 3 y 8), lo que impulsa la estimación de pose (geometría epipolar y PnP de la sección 4) y, en paralelo, el mapeo local (añadiendo y actualizando puntos de referencia en el área observada recientemente). Cuando se detecta un bucle, se activa el Cierre de Bucle y la capa de Optimización en el Backend (Sección 10) —Ajuste de Paquetes u Optimización del Grafo de Poses— corrige las poses acumuladas y las mapea para lograr un conjunto coherente.
Las imágenes de la cámara primero pasan por el Seguimiento Directo/de Características (cualquiera de los enfoques descritos en las Secciones 3 y 8) para establecer correspondencias con el fotograma anterior. A partir de estas correspondencias, la Estimación de Pose (utilizando la geometría epipolar y PnP de la Sección 4) calcula la pose de la cámara, mientras que el Mapeo Local (que añade y actualiza puntos de referencia en la región observada recientemente) se ejecuta en paralelo. Cuando se detecta un bucle, se activa el Cierre de Bucle y la etapa de Optimización del Backend (Sección 10) corrige las poses acumuladas y las mapea para lograr un conjunto globalmente coherente. El resultado final de este proceso es la salida final: la Pose (trayectoria) de la cámara y el Mapa (la estructura 3D de su entorno).
8. Algoritmos emblemáticos
La historia de Visual-SLAM se comprende mejor si se analiza desde un eje: cuánto se diseña explícitamente y cuánto se delega al aprendizaje.
PTAM (Seguimiento y Mapeo Paralelo, Klein y Murray, 2007) fue un sistema pionero que ejecutaba el seguimiento (estimación de la pose) y el mapeo (construcción del mapa) como hilos paralelos independientes. El seguimiento se ejecuta rápidamente en cada fotograma, mientras que el ajuste de haces (Bundle Adjustment) para el mapeo, computacionalmente costoso, se ejecuta en un hilo en segundo plano con más tiempo disponible. Esta idea de separar el seguimiento del mapeo fue adoptada por muchos sistemas Visual-SLAM posteriores.
ORB-SLAM (Mur-Artal, Montiel y Tardós, 2015) se basa en las características de ORB, combinando una estructura de tres hilos (seguimiento, mapeo local y cierre de bucle) con reconocimiento de lugar (comparación con fotogramas anteriores mediante Bag-of-Words) para lograr un rendimiento práctico con visión monocular. ORB-SLAM2 (Mur-Artal y Tardós, 2017) extendió este marco más allá de las cámaras monoculares, incluyendo cámaras estéreo y RGB-D. ORB-SLAM3 (Campos, Elvira, Gómez Rodríguez, Montiel y Tardós, 2021) añadió una estrecha integración con una IMU (SLAM visual-inercial) y SLAM multimapa, que mantiene múltiples mapas y los fusiona según sea necesario; y sigue siendo, hasta la fecha, la implementación de referencia de facto para SLAM basado en características.
LSD-SLAM (SLAM monocular directo a gran escala, Engel, Schöps y Cremers, 2014) es un ejemplo clave del método directo, que demuestra que la pose de la cámara se puede estimar directamente utilizando el brillo de la imagen, sin necesidad de detección de características, a gran escala. Al omitir por completo la extracción de características, aprovecha la información incluso cuando estas son escasas.
DSO (Odometría Dispersa Directa, Engel, Koltun y Cremers, presentada por primera vez en 2016, publicada en 2018) mantiene un enfoque directo, pero en lugar de la estimación semidensa que produce LSD-SLAM, minimiza el error fotométrico sobre un conjunto disperso de puntos, logrando así precisión y eficiencia computacional.
SVO (Odometría Visual Monocular Semidirecta Rápida, Forster, Pizzoli y Scaramuzza, 2014) combina la detección de características con un método directo en un enfoque semidirecto, rastreando el brillo en parches alrededor de las características detectadas para lograr un funcionamiento rápido a altas velocidades de fotogramas; diseñado pensando en plataformas con recursos limitados como los drones.
DROID-SLAM (Teed & Deng, 2021) reemplaza por completo el paso explícito de extracción y coincidencia de características con aprendizaje profundo, estimando la pose de la cámara y la profundidad por píxel mediante un volumen de correlación, un operador de actualización recurrente y una capa de ajuste de haces diferenciable; el enfoque representativo basado en aprendizaje (su mecánica interna se describe con más detalle en Tendencias de Visual-SLAM).
9. Basado en características vs. Directo vs. Basado en aprendizaje
En resumen, estos algoritmos se enmarcan en una de tres filosofías de diseño.
| Aspecto | Basado en características (p. ej., ORB-SLAM3) | Directo (p. ej., DSO/LSD-SLAM) | Basado en aprendizaje (p. ej., DROID-SLAM) |
|---|---|---|---|
| Principio | Detecta y describe características, calcula la pose a partir de la relación geométrica entre correspondencias | Omite características por completo, minimiza el brillo de la imagen directamente para encontrar la pose | Una red neuronal aprende a reemplazar la extracción de características, la correspondencia y la estimación de pose/profundidad |
| Precisión | Alta donde las características son abundantes; tiende a producir un mapa disperso | Funciona dondequiera que haya un gradiente de brillo; puede producir mapas semidensos a densos | Razonablemente robusto incluso en entornos con poca textura; es fácil obtener profundidad densa |
| Costo computacional | Moderado (extracción de características, descriptores, coincidencia) | Varía según la implementación, generalmente ligero (DSO en particular optimiza para la eficiencia) | Alto (la inferencia por sí sola a menudo necesita de varios a más de una docena de GB de memoria GPU) |
| Robustez | Débil en entornos con poca textura o con objetos dinámicos; comparativamente fuerte frente a cambios de iluminación | Sensible a cambios de brillo (autoexposición, iluminación) | Fuerte dentro del rango de sus datos de entrenamiento, pero la generalización a entornos no vistos puede ser limitada |
| Dificultad de implementación | Numerosas implementaciones de código abierto maduras y fáciles de adoptar | Las matemáticas (linealización del brillo) son algo más complejas | Es fácil usar un modelo preentrenado; el reentrenamiento o el ajuste interno requieren más experiencia |
Los métodos basados en características tienen la trayectoria más larga, incluyendo numerosas implementaciones integradas; los métodos directos funcionan mejor cuando la textura es escasa; los métodos basados en aprendizaje están mejorando rápidamente, pero requieren mayor capacidad de procesamiento; este es, aproximadamente, el panorama actual a partir de 2026.
10. El Backend
Lo que determina en última instancia la precisión de Visual-SLAM no es solo el frontend (extracción de características, seguimiento, estimación de pose), sino el Backend, que refina el conjunto completo de observaciones acumuladas para lograr coherencia interna.
El Ajuste de Paquetes optimiza conjuntamente las poses de la cámara y las posiciones 3D de los puntos de referencia para que sean lo más consistentes posible con cada observación. Minimiza el error total de reproyección: la discrepancia entre un punto de referencia \mathbf{X}_i proyectado en una imagen mediante la pose de la cámara (R_j, \mathbf{t}_j) y la ubicación real de la característica correspondiente, \mathbf{u}_{ij}.
\pi(\cdot) es la función de proyección desde un punto 3D al plano de la imagen, basada en los parámetros intrínsecos de la cámara. El ajuste de haces global, que optimiza cada fotograma y cada punto de referencia simultáneamente, es muy preciso pero costoso; en la práctica, suele combinarse con el ajuste de haces local, restringido a los últimos fotogramas, para mantener la complejidad computacional.
Cuando se detecta el cierre de un bucle, entra en juego la optimización del grafo de poses. A diferencia del ajuste de haces, que incluye todos los puntos de referencia, la optimización del grafo de poses trata únicamente la pose de la cámara en cada paso de tiempo como un nodo, con aristas que codifican las restricciones de pose relativa entre fotogramas, optimizando así la pose de forma rápida. La nueva restricción añadida por el cierre del bucle redistribuye la deriva acumulada a lo largo de todo el bucle.
Ambos problemas se resuelven dentro del marco de la Optimización No Lineal. Dado que la función de proyección \pi(\cdot) y la composición de rotaciones en una pose son inherentemente no lineales, se utilizan métodos iterativos como Gauss-Newton y Levenberg-Marquardt, y bibliotecas como g2o y Ceres Solver son ampliamente utilizadas en las implementaciones de Visual-SLAM.
11. Problemas de Visual-SLAM
Debido a que Visual-SLAM depende de un sensor pasivo (una cámara), su precisión se degrada sistemáticamente en ciertas situaciones.
- Oscuridad: Sin suficiente luz, la relación señal-ruido de la imagen se degrada, desestabilizando tanto la detección de características como los cálculos del gradiente de brillo en los que se basan los métodos directos. Las cámaras RGB-D con iluminación infrarroja pueden compensar parcialmente esta deficiencia, pero su efecto es limitado en exteriores por la noche.
-
Textura baja: Paredes blancas, suelos lisos, superficies de vidrio; en cualquier lugar donde los gradientes de brillo sean escasos, no se puedan encontrar características o la minimización del método directo se vuelva mal condicionada y propensa a mínimos locales.
-
Movimiento rápido: El movimiento o la rotación rápidos de la cámara amplían el rango de búsqueda necesario para encontrar correspondencias entre fotogramas y, combinados con el desenfoque de movimiento (ver más abajo), el seguimiento falla fácilmente. El uso de una IMU (VIO) es la forma estándar de compensar esta debilidad.
-
Objetos dinámicos: Tratar las características de un peatón o un coche en movimiento como si pertenecieran al entorno estático introduce errores en la estimación del movimiento de la cámara. Esto requiere un preprocesamiento para detectar y excluir objetos dinámicos, o bien extensiones que los modelen explícitamente.
-
Desenfoque de movimiento: El desenfoque causado por el movimiento de la cámara o del sujeto durante el período de exposición desestabiliza los descriptores de características y reduce la precisión de la coincidencia. Las cámaras con obturador global o los entornos con mucha luz y tiempos de exposición cortos reducen este impacto.
Todos estos problemas comparten un denominador común: la cámara simplemente no recibe suficiente información visual para funcionar correctamente. Un sensor de medición de distancia activo como LiDAR (véase Tendencias en la tecnología LiDAR-SLAM) evita la mayoría de estas limitaciones en principio, pero también presenta sus propias limitaciones (véase la Sección 2): ningún sensor es universalmente suficiente, y esa complementariedad es precisamente la razón por la que la fusión de sensores (véase Introducción a la fusión de sensores) es tan importante.
12. Elección de un método en la práctica
La elección de un enfoque Visual-SLAM depende en gran medida de los sensores disponibles, la capacidad de procesamiento y la precisión y el rendimiento en tiempo real que requiera la aplicación.
-
Robots (robots de servicio para interiores, robots de limpieza): A menudo se ven limitados a configuraciones de cámara de bajo costo, donde los métodos de la familia ORB-SLAM basados en características o el mapeo denso mediante cámaras RGB-D son opciones prácticas. En entornos con muchos pasillos y poca textura, vale la pena considerar la combinación con LiDAR.
-
Drones: Las severas limitaciones de procesamiento y peso de la carga útil impulsan el uso de métodos semidirectos ligeros como SVO, o configuraciones VIO estrechamente acopladas con una IMU.
-
AR/VR: El rendimiento en tiempo real y la baja latencia son la máxima prioridad, y una configuración visual-inercial combinada con la IMU integrada del casco se ha convertido en el estándar de facto. En AR específicamente, la consistencia global determina directamente si los objetos virtuales se desplazan, por lo que la precisión del cierre del bucle también es muy importante.
-
Conducción autónoma: Rara vez se utiliza como Visual-SLAM independiente; La información visual obtenida mediante cámaras se integra normalmente en una configuración de fusión multisensor junto con LiDAR, radar y GNSS (véase la Introducción a la fusión de sensores).
-
Interiores vs. exteriores: En interiores, los cambios de iluminación son suaves y la estructura es abundante, por lo que los métodos basados en características suelen funcionar bien; en exteriores, la variación de la iluminación, los objetos dinámicos y la gran escala suponen un desafío, lo que hace que la robustez del cierre del bucle sea aún más importante.
A partir de 2026, el eje de decisión aproximado es el siguiente: elegir métodos basados en aprendizaje si se dispone de una gran capacidad de procesamiento y se busca la máxima precisión; métodos basados en características si lo más importante es el historial de integración y el bajo consumo de recursos; y métodos directos si la resiliencia en entornos con poca textura es esencial. Las últimas líneas de investigación —como la remodelación de la representación de mapas con 3D Gaussian Splatting/NeRF, los modelos de base 3D de propagación directa y otros— se tratan en Tendencias de Visual-SLAM.
Cinco comprobaciones antes de la implementación
Elegir un algoritmo solo por su nombre dificulta el diagnóstico de fallos en el campo. Antes de la implementación, asegúrese de que estos cinco elementos se puedan registrar; cuando el seguimiento falle, podrá diferenciar un problema del sensor de un problema del estimador.
| Comprobación | Información a preparar | Qué ocurre si se omite |
|---|---|---|
| Calibración | Parámetros intrínsecos K, distorsión de la lente y la línea base estéreo, si corresponde | El error de reproyección se parece a un error de pose y la escala no se puede evaluar |
| Sincronización temporal | Marcas de tiempo de fotograma, desfase cámara-IMU y fotogramas perdidos | Durante el movimiento rápido, la imagen y los datos inerciales describen diferentes poses |
| Obturador y exposición | Obturador global/rolling, tiempo de exposición y ajustes de autoexposición | El desenfoque de movimiento o la distorsión geométrica se confunden con un fallo del algoritmo |
| Objetos dinámicos | Uso de máscaras, fracción de objetos en movimiento y correspondencias rechazadas | Los peatones o vehículos se integran en el mapa estático |
| Registros de evaluación | Datos reales, ATE/RPE, tiempos de pérdida de seguimiento y resultados de detección de bucles | El simple hecho de que se haya movido no es suficiente para comparar la precisión, la deriva o la recuperación |
Completar esta tabla primero también facilita la distinción entre lo que debe cambiarse y lo que puede permanecer fijo al pasar de métodos basados en características a métodos directos o basados en aprendizaje. Visual-SLAM debe seleccionarse como un sistema —que incluye cámara, sincronización, preprocesamiento, optimización y evaluación— en lugar de como un algoritmo aislado.
13. Resumen
Visual-SLAM rastrea correspondencias a partir únicamente de imágenes de la cámara, recupera el movimiento de la cámara mediante geometría epipolar y PnP, y corrige continuamente el error acumulado a través de un mapa y un cierre de bucle, logrando así la localización y el mapeo simultáneos. Las tres filosofías de diseño —basada en características (la familia ORB-SLAM), directa (DSO/LSD-SLAM) y basada en aprendizaje (DROID-SLAM)— se basan en diferentes compensaciones y se comprenden mejor si se consideran si las características se manejan explícitamente, si se utiliza el brillo directamente y cuánto se delega al aprendizaje. La elección de una u otra depende de las necesidades específicas de cada aplicación, sopesando los sensores disponibles, la capacidad de procesamiento y la precisión y el rendimiento en tiempo real requeridos.
14. Referencias
Los artículos y páginas de investigación principales sobre los métodos representativos y la geometría de dos vistas mencionados anteriormente se recopilan aquí como puntos de partida para la implementación y lecturas adicionales. Para evitar confusiones entre las afirmaciones de un artículo y su rendimiento en un producto o conjunto de datos específico, consulte el texto enlazado junto con sus condiciones experimentales.
-
ORB-SLAM3: Una biblioteca de código abierto precisa para SLAM visual, visual-inercial y multimapa — una biblioteca que abarca diseños visuales, visual-inerciales y multimapa.
-
DROID-SLAM: SLAM visual profundo para cámaras monoculares, estéreo y RGB-D — un método basado en aprendizaje que combina volúmenes de correlación con ajuste de haces densos diferenciables.
-
LSD-SLAM: SLAM monocular directo a gran escala — la página oficial de investigación para SLAM monocular directo y semidenso.
-
Odometría dispersa directa — el artículo de DSO sobre optimización de errores fotométricos con ventana deslizante.
- Una solución eficiente al problema de la pose relativa de cinco puntos — el artículo original sobre el solucionador de la matriz esencial de cinco puntos.
¿Un mapa atractivo establece una localización precisa?
Evalúa la apariencia del mapa independientemente del error de trayectoria. Comprueba la escala, la alineación, el error local y la deriva a largo plazo.
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.