Contents — find the section you need
रोबोट वैक्यूम क्लीनर, ड्रोन, सेल्फ-ड्राइविंग कार और एआर ग्लास, इन सभी की एक ही आवश्यकता है: "मैं अभी कहाँ हूँ?" इस प्रश्न का उत्तर देना। जीपीएस घर के अंदर या घनी आबादी वाले शहरों में काम नहीं करता, और वैसे भी, नक्शा हमेशा उपलब्ध नहीं होता। विजुअल-एसएलएएम एक ऐसी तकनीक है जो केवल कैमरा छवियों (कभी-कभी सस्ते सहायक सेंसरों के साथ) का उपयोग करके इस प्रश्न का उत्तर देती है। यह लेख इस बात से शुरू होता है कि आखिर रोबोट अपनी स्थिति का पता क्यों खो देता है, फिर फीचर ट्रैकिंग, कैमरा ज्यामिति का गणित, विजुअल ओडोमेट्री और एसएलएएम के बीच अंतर, लैंडमार्क एल्गोरिदम का इतिहास और अंत में व्यवहार में इनमें से किसी एक को चुनने के तरीके पर चर्चा करता है।
 विजुअल-एसएलएएम इनपुट कैमरा
 वाहन कैमरा उदाहरण
छवियां: Intel RealSense डेप्थ कैमरा D435 (मार्क औलेदास, CC BY-SA 4.0) / Car Mobileye सिस्टम का विंडो कैमरा (रैनबार, CC BY-SA 4.0), विकिमीडिया कॉमन्स। प्रतिनिधि कैमरे, आवश्यक विज़ुअल-एसएलएएम हार्डवेयर कॉन्फ़िगरेशन नहीं।


0. इस लेख में क्या शामिल है
- विज़ुअल-एसएलएएम क्या है, और कैसे एक कैमरा अकेले अपनी स्थिति का अनुमान लगा सकता है
- विज़ुअल ओडोमेट्री (वीओ) एसएलएएम से कैसे भिन्न है
- ORB-SLAM, LSD-SLAM, DSO, SVO, और DROID-SLAM डिज़ाइन विकल्पों के रूप में क्या योगदान देते हैं
- फ़ीचर-आधारित, प्रत्यक्ष और शिक्षण-आधारित दृष्टिकोणों में अंतर
- विज़ुअल-एसएलएएम की कमियाँ और उनके कारण
- रोबोट, ड्रोन, AR/VR, या सेल्फ-ड्राइविंग कार के लिए विधि का चयन कैसे करें
1. विज़ुअल-एसएलएएम वास्तव में क्या करता है
संक्षेप में: विज़ुअल-एसएलएएम कैमरे द्वारा कैप्चर की गई छवियों के अनुक्रम का उपयोग करके, एक साथ कैमरे के अंतरिक्ष में प्रक्षेप पथ (स्थानीयकरण) और उसके परिवेश की 3D संरचना (मैपिंग) का अनुमान लगाता है।
नाम ही - एक साथ स्थानीयकरण और मैपिंग - इंगित करता है सबसे महत्वपूर्ण बात पर आते हैं: "समकालिक" शब्द। यदि मानचित्र पहले से ज्ञात हो, तो अपनी स्थिति ज्ञात करना अपेक्षाकृत आसान होगा; यदि आपकी स्थिति पहले से सटीक रूप से ज्ञात हो, तो मानचित्र बनाना भी आसान होगा। विज़ुअल-एसएलएएम को इनमें से कोई भी सुविधा प्राप्त नहीं है - मानचित्र बनाने के लिए आपकी स्थिति का ज्ञान आवश्यक है, और आपकी स्थिति का ज्ञान मानचित्र पर निर्भर करता है। इस जटिल समस्या को एक ही समय में, एक ही अवलोकन प्रवाह से सुलझाना होगा।
इनपुट एक कैमरे (मोनोक्युलर, स्टीरियो या आरजीबी-डी) से प्राप्त छवियों की एक समय श्रृंखला है, और आउटपुट दो चीजें हैं: प्रत्येक समय चरण पर कैमरे की 6-डिग्री-ऑफ-फ्रीडम पोज़ (3 स्थिति के लिए, 3 अभिविन्यास के लिए), और परिवेश को दर्शाने वाला एक मानचित्र (फीचर बिंदुओं का एक विरल समूह, या एक सघन 3डी आकृति)। एक रोबोट वैक्यूम क्लीनर सफाई करते समय कमरे का लेआउट सीखता है, एक ड्रोन घर के अंदर या भूमिगत जगहों पर स्थिर रूप से मंडराता है जहाँ GPS सिग्नल नहीं पहुँचता, एक AR हेडसेट बिना किसी विचलन के आभासी वस्तुओं को वास्तविक दुनिया पर ओवरले करता है — इन सभी मामलों में, Visual-SLAM अंतर्निहित रूप से काम कर रहा है।
2. रोबोट को अपनी स्थिति का पता क्यों नहीं चलता?
Visual-SLAM जिस समस्या का समाधान करता है, उसे समझने के लिए, यह सवाल पूछना ज़रूरी है: आखिर रोबोट अपनी स्थिति का पता क्यों खो देता है?
पहला कारण यह है कि ऐसे कई वातावरण हैं जहाँ GPS उपलब्ध नहीं है, या भरोसेमंद GPS उपलब्ध नहीं है। घर के अंदर, भूमिगत, सुरंगों में, गगनचुंबी इमारतों के बीच शहरी घाटियों में (जहाँ मल्टीपाथ रिफ्लेक्शन से स्थिति निर्धारण में त्रुटि बढ़ जाती है), या पानी के नीचे और अन्य ग्रहों पर जहाँ उपग्रहों का कोई समूह ही मौजूद नहीं है — इनमें से कोई भी आपको सीधे सटीक स्थिति प्राप्त करने का तरीका नहीं देता है।
दूसरा कारण यह है कि मानचित्र का अस्तित्व ही नहीं है। नवनिर्मित संरचना, आपदा स्थल, या किसी अज्ञात ग्रह की सतह — हर जगह पहले से तैयार मानचित्र डेटा उपलब्ध नहीं होता। मानचित्र के बिना, "मानचित्र से अपनी स्थिति का मिलान करना" संभव ही नहीं है।
तीसरा — और सबसे महत्वपूर्ण — एक सेंसर रीडिंग से सटीक स्थिति का निर्धारण नहीं किया जा सकता, सिद्धांत रूप में भी नहीं। एक कैमरा केवल यह बताता है कि उसके आसपास अभी क्या है। एक छवि को देखकर तुरंत यह नहीं पता चलता कि "यह उस दीवार से 2.3 मीटर दूर, लिविंग रूम में है" — उस दीवार को "वही दीवार" के रूप में पहचानने के लिए उसे पहले देखना और यह याद रखना आवश्यक है कि आप उस समय कहाँ थे। दूसरे शब्दों में, वर्तमान अवलोकन को सार्थक स्थिति जानकारी में बदलने के लिए पिछले अवलोकनों के साथ एक संबंध आवश्यक है (आप अभी कहाँ हैं यह इस बात पर निर्भर करता है कि आप पहले कहाँ थे) — और यही संबंध मानचित्र प्रदान करता है।
SLAM समस्या का सार यह है कि केवल अवलोकन डेटा के आधार पर, बिना किसी बाहरी सटीक स्थिति के, "मैं अभी क्या देख रहा हूँ" और "मैंने पहले क्या मानचित्रित किया है" के बीच निरंतर और सुसंगत रूप से यह संबंध स्थापित किया जाए। एक गलत मिलान अपनी त्रुटि को बाद के सभी अनुमानों में फैला देता है — और इस संचित त्रुटि को कैसे कम किया जाए, और बाद में इसे कैसे ठीक किया जाए, यही हर विज़ुअल-एसएलएएम एल्गोरिदम के पीछे का मुख्य डिज़ाइन प्रश्न है।
3. कैमरा इमेज में क्या खोजना है
कैमरे का रॉ आउटपुट पिक्सेल मानों का एक ग्रिड मात्र होता है — चमक, रंग। "मैं कैसे चला" यह पता लगाने का पहला कदम उस ग्रिड के भीतर ट्रैक करने योग्य संकेतों को खोजना है।
फीचर* इमेज में एक स्थानीय बिंदु होता है जो अपने परिवेश से स्पष्ट रूप से अलग दिखता है और देखने का कोण बदलने पर भी विश्वसनीय रूप से पुनः पहचाना जा सकता है — एक कोना, एक किनारा प्रतिच्छेदन, एक ऐसी जगह जहाँ चमक प्रवणता कई दिशाओं में तेज़ी से बदलती है। नीले आकाश का एक समान पैच, जो अपने पड़ोसियों से अलग नहीं दिखता, फीचर के रूप में काम नहीं कर सकता।
फीचर डिटेक्शन* एक ही इमेज के भीतर संभावित फीचर बिंदुओं को खोजता है। ORB (ओरिएंटेड फास्ट एंड रोटेटेड ब्रीफ), SIFT और FAST कॉर्नर डिटेक्टर जैसे एल्गोरिदम यह तय करते हैं कि कौन से पिक्सेल "फीचर्स जैसे दिखते हैं", और प्रत्येक पिक्सेल के आसपास की स्थानीय उपस्थिति का संख्यात्मक सारांश - एक डिस्क्रिप्टर - की गणना करते हैं।
फीचर ट्रैकिंग अगले फ्रेम में उन्हीं फीचर्स को ढूंढती और उनका मिलान करती है। इसके दो मुख्य तरीके हैं: डिस्क्रिप्टर समानता के आधार पर पहचाने गए फीचर्स का मिलान करना (फीचर मैचिंग), और पिछले फ्रेम में फीचर की स्थिति से शुरू करके अगले फ्रेम में उसके आस-पास के क्षेत्र को खोजना (ऑप्टिकल फ्लो, जिसे आमतौर पर लुकास-कनाडे विधि द्वारा किया जाता है)।
यह संबंध - वास्तविक दुनिया में एक ही बिंदु का अलग-अलग फ्रेम में अलग-अलग स्थानों पर दिखना - कॉरेस्पोंडेंस कहलाता है। विजुअल-SLAM में लगभग हर ज्यामितीय गणना कॉरेस्पोंडेंस के एक सेट को इनपुट के रूप में लेती है; एक भी कॉरेस्पोंडेंस के बिना, सिद्धांत रूप में, कैमरे की गति के बारे में कोई सुराग नहीं मिल सकता।
ऑप्टिकल फ्लो एक वेक्टर क्षेत्र है जो यह बताता है कि छवि में प्रत्येक बिंदु (या बिंदुओं का एक विरल समूह) फ्रेम के बीच कितनी दूर और किस दिशा में चला गया - न केवल विशेषताएं। जहां विशेषता-आधारित ट्रैकिंग केवल सबसे विशिष्ट बिंदुओं का अनुसरण करती है, वहीं ऑप्टिकल फ्लो अधिक गणना लागत पर भी व्यापक क्षेत्र में गति की जानकारी का उपयोग कर सकता है।
4. कैमरे की गति की गणना
एक बार पत्राचार प्राप्त हो जाने पर, उन्हें ज्यामितीय रूप से कैमरे की गति का अनुमान लगाने में परिवर्तित किया जा सकता है। इस गणना का आधार एपिपोलर ज्यामिति है।
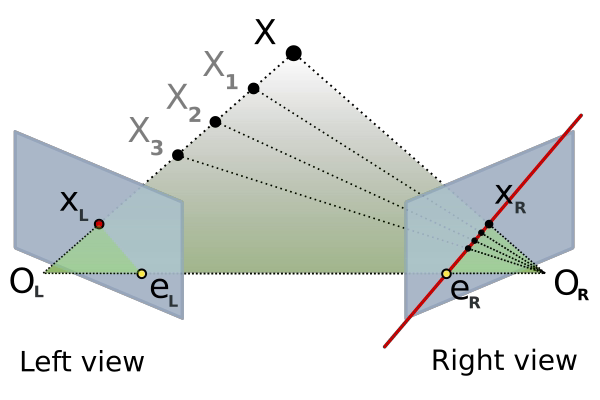
चित्र 1 — दो कैमरा व्यूप्वाइंट O_1 और O_2, अंतरिक्ष में एक बिंदु X, और प्रत्येक छवि तल पर इसके प्रक्षेपण x_1 और x_2। x_1 दिए जाने पर, इसका संगत बिंदु x_2 हमेशा दूसरी छवि (एपिपोलर रेखा) में एक ही रेखा पर स्थित होने के लिए विवश होता है।
चित्र: Epipolar ज्यामिति (आर्ने नॉर्डमैन, CC BY-SA 3.0 / GFDL), विकिमीडिया कॉमन्स। विश्वसनीय ब्राउज़र प्रदर्शन के लिए मूल SVG को सफेद पृष्ठभूमि वाले PNG में परिवर्तित किया गया है।

जब अंतरिक्ष में एक ही बिंदु X को दो अलग-अलग दृष्टिकोणों से फोटो खींचा जाता है, तो एक छवि में संगत बिंदु \mathbf{x}_2, दूसरी छवि में एक बिंदु \mathbf{x}_1 दिए जाने पर, छवि में कहीं भी स्थित होने के लिए स्वतंत्र नहीं होता है - इसे एक ही रेखा (एपिपोलर रेखा) पर स्थित होना चाहिए। इस ज्यामितीय बाधा को एन्कोड करने वाला मैट्रिक्स आवश्यक मैट्रिक्स E है। जब कैमरे के आंतरिक पैरामीटर ज्ञात होते हैं, तो मानकीकृत कैमरा निर्देशांकों में संगत बिंदु निम्न को संतुष्ट करते हैं:
यहाँ R और \mathbf{t} कैमरा 1 से कैमरा 2 तक का घूर्णन और स्थानांतरण हैं, और [\mathbf{t}]_{\times} विषम-सममित मैट्रिक्स है जो \mathbf{t} से निर्मित है और एक क्रॉस प्रोडक्ट को मैट्रिक्स गुणन के रूप में दर्शाता है। यह समीकरण कहता है कि यह बाधा हमेशा पत्राचार \mathbf{x}_1, \mathbf{x}_2 और कैमरे के सापेक्ष घूर्णन और स्थानांतरण के बीच लागू होती है। आवश्यक पत्राचारों की संख्या अनुमानक पर निर्भर करती है: एक कैलिब्रेटेड एसेंशियल मैट्रिक्स में 5-बिंदु न्यूनतम सॉल्वर होता है, जबकि रैखिक 8-बिंदु अनुमान में कम से कम 8 पत्राचारों का उपयोग होता है। वास्तविक डेटा में आउटलायर्स होते हैं, इसलिए व्यावहारिक प्रणालियाँ अधिक मिलान एकत्र करती हैं और उन्हें RANSAC या किसी अन्य मजबूत अनुमानक के साथ संयोजित करती हैं। जब आंतरिक मान अज्ञात हों, या जब सीधे पिक्सेल निर्देशांकों में काम किया जा रहा हो, तो मौलिक मैट्रिक्स F = K_2^{-\top} E K_1^{-1}, जो आंतरिक मैट्रिक्स K को समाहित करता है, वही भूमिका निभाता है।
आवश्यक मैट्रिक्स से प्राप्त अनुवाद \mathbf{t} में कोई वास्तविक इकाई (जैसे मीटर) नहीं होती है — केवल दो छवियों से यह नहीं बताया जा सकता कि कैमरा एक मीटर चला या दो मीटर। यह पैमाने की अस्पष्टता विज़ुअल-एसएलएएम, विशेष रूप से मोनोक्युलर कॉन्फ़िगरेशन की एक विशिष्ट बाधा है, और इस पर अनुभाग 5 में फिर से चर्चा की गई है।
किसी पत्राचार की वास्तविक 3डी स्थिति की गणना करना — अंतरिक्ष में बिंदु X के निर्देशांक — त्रिकोणीकरण कहलाता है। प्रत्येक दृष्टिकोण से X की ओर जाने वाली दो किरणों को आगे बढ़ाते हुए, आदर्श रूप से, ये दोनों किरणें ठीक X बिंदु पर प्रतिच्छेदित होनी चाहिए; इस प्रतिच्छेदन को ज्ञात करने से पत्राचार की 3D स्थिति प्राप्त होती है (व्यवहार में, अवलोकन शोर के कारण किरणें ठीक से नहीं मिलतीं, इसलिए न्यूनतम वर्ग विधि के अनुसार, दोनों के सबसे निकटतम बिंदु को ज्ञात किया जाता है)।
यदि किसी ज्ञात 3D स्थिति वाले लैंडमार्क और छवि में उसके स्थान के बीच पत्राचार उपलब्ध है, तो कैमरे की स्थिति की गणना सीधे उससे की जा सकती है। यही PnP (परिप्रेक्ष्य-बिंदु) समस्या है: n 3D बिंदुओं और छवि में उनकी प्रक्षेपित स्थितियों को देखते हुए, कैमरे की स्थिति और अभिविन्यास ज्ञात करें। एक बार मानचित्र बन जाने पर, PnP प्रत्येक नए फ्रेम के कैमरे की स्थिति की गणना करने का मुख्य उपकरण बन जाता है।
5. विज़ुअल ओडोमेट्री
फ्रेम दर फ्रेम "संगतियों से कैमरे की गति की गणना करें" को दोहराने मात्र से ही कैमरे के प्रक्षेप पथ का अनुमान लगाना संभव हो जाता है। इसे विज़ुअल ओडोमेट्री (VO) कहते हैं।
VO कैमरे के प्रक्षेप पथ को बनाने के लिए केवल वर्तमान फ्रेम और पिछले फ्रेम (या पिछले कुछ फ्रेमों) के बीच सापेक्ष गति को जोड़ता है। इसमें आमतौर पर कोई स्थायी मानचित्र बनाए रखने या पहले से देखी गई जगह को पहचानने की व्यवस्था नहीं होती है - यह एक कार के ओडोमीटर के समान है, जो लगातार गणना करता है कि "अभी-अभी से मैं कितनी दूर चला हूँ।"
VO और SLAM के बीच का अंतर ठीक इसी बात में निहित है: क्या सिस्टम मानचित्र बनाए रखता है और अतीत के साथ संगति बनाए रखने की व्यवस्था रखता है। VO हल्का और लागू करने में सरल है, लेकिन चूंकि प्रत्येक फ्रेम का अनुमान हमेशा पिछले फ्रेम पर निर्भर करता है, इसलिए समय के साथ छोटी-छोटी त्रुटियाँ असीमित रूप से जमा होती जाती हैं। इस संचित त्रुटि को ड्रिफ्ट कहा जाता है। यदि कोई रोबोट अपने आरंभिक बिंदु पर वापस लौटता है, तो केवल VO के पास यह पहचानने का कोई तरीका नहीं है कि "मैं वहीं वापस आ गया हूँ जहाँ से शुरू किया था" — अनुमानित प्रक्षेप पथ आरंभिक बिंदु से हटकर ही रहता है और कभी भी पूर्ण नहीं होता।
VO, विशेष रूप से मोनोक्युलर VO से जुड़ी एक और समस्या है, जिसका उल्लेख खंड 4 में पहले ही किया जा चुका है: स्केल समस्या। केवल मोनोक्युलर कैमरे से प्राप्त छवियाँ लंबाई की एक सटीक वास्तविक इकाई को पुनः प्राप्त नहीं कर सकतीं — छवि की दिखावट में ऐसा कुछ भी नहीं है जो "2 मीटर चलने पर वस्तु दोगुनी बड़ी दिखाई देती है" और "4 मीटर चलने पर वस्तु चार गुनी बड़ी दिखाई देती है" के बीच अंतर कर सके। एक स्टीरियो कैमरा (जिसमें स्केल को स्थिर करने के लिए उसके दो लेंसों के बीच एक ज्ञात आधारभूत दूरी होती है), एक RGB-D कैमरा (जिसका डेप्थ सेंसर सीधे वास्तविक दूरी देता है), या एक IMU के साथ युग्मन (जिसका वास्तविक-स्केल त्वरण स्केल का अनुमान लगाने की अनुमति देता है) इस स्केल अस्पष्टता को दूर कर सकता है।
6. SLAM VO के ऊपर क्या जोड़ता है
SLAM को VO के साथ निम्नलिखित अतिरिक्त घटकों के रूप में समझना सहायक होता है।
एक मैप अब तक देखे गए प्रत्येक फीचर की 3D स्थिति (या एक सघन 3D आकृति) का संचित निरूपण है। VO की तरह केवल तत्काल पिछले फ्रेम से तुलना करने के बजाय, सिस्टम अब मैप में संचित सभी डेटा से मिलान कर सकता है।
एक लैंडमार्क उस मैप का एक व्यक्तिगत तत्व है - आमतौर पर एक फीचर बिंदु जिसकी 3D स्थिति होती है। हर बार जब एक नया फ्रेम आता है, तो उस फ्रेम में दिखाई देने वाले लैंडमार्क से मिलान करके सिस्टम कैमरे की स्थिति का अनुमान न केवल पिछले फ्रेम के साथ, बल्कि रोबोट के पूरे इतिहास में निर्मित मैप के साथ भी सुसंगत रूप से लगा सकता है।
लूप क्लोजर SLAM का VO पर सबसे महत्वपूर्ण लाभ है। जब कोई रोबोट किसी ऐसे स्थान पर लौटता है जहाँ वह पहले जा चुका है, तो छवि समानता का उपयोग करके इस तथ्य का पता लगाया जाता है, और मैप में एक नया अवरोध जोड़ा जाता है जो "मैं अभी कहाँ हूँ" को "मैं उस स्थान पर कहाँ था जब मैंने पहली बार इस स्थान का दौरा किया था" से जोड़ता है। इस अवरोध को जोड़ने से सिस्टम पूरे लूप में संचित विचलन को पुनर्वितरित और ठीक कर सकता है।
इस सुधार का परिणाम वैश्विक संगति है। लूप क्लोज़र से पहले, संचित त्रुटि का अर्थ है कि मानचित्र में दो स्थान जो वास्तव में एक ही भौतिक स्थान होने चाहिए, वे थोड़े भिन्न स्थानों के रूप में दर्ज हो जाते हैं। लूप क्लोज़र सुधार इस विसंगति का पता लगाता है और पूरे मानचित्र को एक सुसंगत रूप में पुनर्गठित करता है - यह लूप क्लोज़र तंत्र ही वह कारण है जिससे SLAM न केवल "गति का रिकॉर्ड" बल्कि "एक सुसंगत मानचित्र" भी प्रदान कर सकता है।
7. विज़ुअल-SLAM की मूल संरचना
इन सभी पहलुओं को एक साथ देखने से एक ऐसी पाइपलाइन का पता चलता है जो मोटे तौर पर हर प्रमुख आधुनिक विज़ुअल-SLAM सिस्टम में पाई जाती है।
चित्र 2 — कैमरे से ली गई छवियों का मिलान पिछली छवियों से किया गया है
फ्रेम (फीचर/डायरेक्ट ट्रैकिंग, सेक्शन 3 और 8 में वर्णित तरीकों में से किसी एक का उपयोग करते हुए) से होकर गुजरता है, जो पोज एस्टिमेशन (सेक्शन 4 से एपिपोलर ज्योमेट्री और पीएनपी) और समानांतर रूप से लोकल मैपिंग (हाल ही में देखे गए क्षेत्र में लैंडमार्क जोड़ना और अपडेट करना) को संचालित करता है। जब कोई लूप पाया जाता है, तो लूप क्लोजिंग सक्रिय हो जाती है, और बैकएंड (सेक्शन 10) में ऑप्टिमाइजेशन लेयर - बंडल एडजस्टमेंट या पोज ग्राफ ऑप्टिमाइजेशन - संचित पोज को ठीक करती है और उन्हें एक सुसंगत रूप में मैप करती है।
कैमरे से प्राप्त छवियां पहले फीचर/डायरेक्ट ट्रैकिंग (सेक्शन 3 और 8 में वर्णित तरीकों में से किसी एक) से गुजरती हैं ताकि पिछले फ्रेम के साथ पत्राचार स्थापित किया जा सके। इन पत्राचारों से, पोज एस्टिमेशन (सेक्शन 4 से एपिपोलर ज्योमेट्री और पीएनपी का उपयोग करते हुए) कैमरा पोज की गणना करता है, जबकि लोकल मैपिंग (हाल ही में देखे गए क्षेत्र में लैंडमार्क जोड़ना और अपडेट करना) समानांतर रूप से आगे बढ़ती है। जब कोई लूप डिटेक्ट होता है, तो लूप क्लोज़िंग सक्रिय हो जाता है, और बैकएंड (सेक्शन 10) का ऑप्टिमाइज़ेशन चरण संचित पोज़ और मैप को एक समग्र रूप से सुसंगत संरचना में परिवर्तित करता है। इस पाइपलाइन का अंतिम परिणाम फाइनल आउटपुट होता है: कैमरे का पोज़ (ट्रैजेक्टरी) और मैप (उसके परिवेश की 3D संरचना)।
8. लैंडमार्क एल्गोरिदम
विज़ुअल-एसएलएएम के इतिहास को एक अक्ष पर समझना सबसे आसान है: कितना हिस्सा स्पष्ट रूप से डिज़ाइन किया गया है, और कितना हिस्सा लर्निंग पर छोड़ दिया गया है।
पीटीएएम (पैरेलल ट्रैकिंग एंड मैपिंग, क्लेन और मरे, 2007) एक अग्रणी सिस्टम था जो ट्रैकिंग (पोज़ एस्टिमेशन) और मैपिंग (मैप बिल्डिंग) को अलग-अलग पैरेलल थ्रेड्स के रूप में चलाता था। ट्रैकिंग हर फ्रेम में तेज़ी से चलती है, जबकि मैपिंग के लिए कम्प्यूटेशनल रूप से महंगी बंडल एडजस्टमेंट बैकग्राउंड थ्रेड में अधिक समय के साथ चलती है - ट्रैकिंग को मैपिंग से अलग करने का यह विचार बाद के कई विज़ुअल-एसएलएएम सिस्टम द्वारा अपनाया गया।
ORB-SLAM (मुर-आर्टल, मोंटिएल और टार्डोस, 2015) ORB विशेषताओं पर आधारित है, जो व्यावहारिक मोनोक्युलर प्रदर्शन प्राप्त करने के लिए प्लेस रिकग्निशन (बैग-ऑफ-वर्ड्स के माध्यम से पिछले फ्रेम से मिलान) के साथ तीन-थ्रेड संरचना (ट्रैकिंग, लोकल मैपिंग, लूप क्लोजिंग) को जोड़ती है। ORB-SLAM2 (मुर-आर्टल और टार्डोस, 2017) ने इस फ्रेमवर्क को मोनोक्युलर से आगे स्टीरियो और RGB-D कैमरों तक विस्तारित किया। ORB-SLAM3 (कैम्पोस, एल्विरा, गोमेज़ रोड्रिगेज़, मोंटिएल और टार्डोस, 2021) ने IMU (विज़ुअल-इनर्टियल SLAM) और मल्टी-मैप SLAM के साथ टाइट कपलिंग को जोड़ा, जो कई मैप्स को बनाए रखता है और आवश्यकतानुसार उन्हें मर्ज करता है — और आज भी, फीचर-आधारित SLAM के लिए वास्तविक संदर्भ कार्यान्वयन बना हुआ है।
LSD-SLAM (लार्ज-स्केल डायरेक्ट मोनोक्युलर SLAM, एंगेल, शोप्स और क्रेमर्स, 2014) प्रत्यक्ष विधि का एक महत्वपूर्ण उदाहरण है, जो दर्शाता है कि कैमरे की स्थिति का अनुमान छवि की चमक का उपयोग करके सीधे, बिना किसी फीचर डिटेक्शन चरण के, बड़े पैमाने पर लगाया जा सकता है। फीचर एक्सट्रैक्शन को पूरी तरह से छोड़ देने से यह उन स्थानों पर भी जानकारी का उपयोग कर पाता है जहां फीचर विरल होते हैं।
DSO (डायरेक्ट स्पार्स ओडोमेट्री, एंगेल, कोल्टन और क्रेमर्स, पहली बार 2016 में प्रस्तुत, 2018 में प्रकाशित) प्रत्यक्ष विधि बनी रहती है, लेकिन LSD-SLAM द्वारा उत्पादित अर्ध-घने अनुमान के बजाय, यह विरल बिंदुओं के समूह पर फोटोमेट्रिक त्रुटि को कम करती है, जिससे सटीकता और कम्प्यूटेशनल दक्षता दोनों प्राप्त होती हैं।
SVO (फास्ट सेमी-डायरेक्ट मोनोक्युलर विजुअल ओडोमेट्री, फोर्स्टर, पिज़ोली और स्कारामुज़ा, 2014) फीचर डिटेक्शन को एक सेमी-डायरेक्ट विधि में डायरेक्ट मेथड के साथ जोड़ता है, और पता लगाए गए फीचर्स के आसपास के पैच में ब्राइटनेस को ट्रैक करके उच्च फ्रेम रेट पर तेज़ ऑपरेशन प्राप्त करता है — इसे ड्रोन जैसे सीमित संसाधनों वाले प्लेटफॉर्म को ध्यान में रखकर डिज़ाइन किया गया है।
DROID-SLAM (टीड और डेंग, 2021) स्पष्ट फीचर एक्सट्रैक्शन और मैचिंग स्टेप को पूरी तरह से डीप लर्निंग से बदल देता है, और कोरिलेशन वॉल्यूम, रिकरेंट अपडेट ऑपरेटर और डिफरेंशिएबल बंडल एडजस्टमेंट लेयर के माध्यम से कैमरा पोज़ और प्रति-पिक्सेल डेप्थ का अनुमान लगाता है — यह लर्निंग-आधारित दृष्टिकोण का प्रतिनिधि उदाहरण है (इसके आंतरिक कार्य करने के तरीके Visual-SLAM Trends में अधिक विस्तार से बताए गए हैं)।
9. फीचर-आधारित बनाम डायरेक्ट बनाम लर्निंग-आधारित
संक्षेप में, ये एल्गोरिदम तीन डिज़ाइन दर्शनों में से एक में आते हैं।
| पहलू | फ़ीचर-आधारित (जैसे ORB-SLAM3) | प्रत्यक्ष (जैसे DSO/LSD-SLAM) | लर्निंग-आधारित (जैसे DROID-SLAM) |
|---|---|---|---|
| सिद्धांत | फ़ीचर का पता लगाता है और उनका वर्णन करता है, पत्राचारों के बीच ज्यामितीय संबंध से पोज़ की गणना करता है | फ़ीचर को पूरी तरह से छोड़ देता है, पोज़ का पता लगाने के लिए सीधे छवि की चमक को कम करता है | एक न्यूरल नेटवर्क फ़ीचर निष्कर्षण, पत्राचार और पोज़/गहराई अनुमान को प्रतिस्थापित करना सीखता है |
| सटीकता | जहां फ़ीचर प्रचुर मात्रा में होते हैं वहां उच्च; विरल मानचित्र उत्पन्न करने की प्रवृत्ति रखता है | जहां भी चमक प्रवणता होती है वहां काम करता है; अर्ध-घने से घने मानचित्र उत्पन्न कर सकता है | कम बनावट वाले वातावरण में भी काफी मजबूत; घनी गहराई प्राप्त करना आसान |
| गणना लागत | मध्यम (फ़ीचर निष्कर्षण, विवरणक, मिलान) | कार्यान्वयन के अनुसार भिन्न होता है, आमतौर पर हल्का (विशेष रूप से DSO दक्षता के लिए अनुकूलित होता है) | उच्च (केवल अनुमान लगाने के लिए ही अक्सर कई से लेकर एक दर्जन जीबी से अधिक जीपीयू मेमोरी की आवश्यकता होती है) |
| मजबूती | कम बनावट वाले वातावरण या गतिशील वस्तुओं के साथ कमजोर; प्रकाश परिवर्तन के प्रति अपेक्षाकृत मजबूत | चमक में बदलाव के प्रति संवेदनशील (स्वचालित एक्सपोजर, प्रकाश व्यवस्था) | अपने प्रशिक्षण डेटा की सीमा के भीतर मजबूत, लेकिन अनदेखे वातावरण में सामान्यीकरण सीमित हो सकता है |
| कार्यान्वयन में कठिनाई | कई परिपक्व ओपन-सोर्स कार्यान्वयन उपलब्ध हैं, जिन्हें अपनाना आसान है | गणितीय गणना (चमक को रेखीय बनाना) थोड़ी अधिक जटिल है | पूर्व-प्रशिक्षित मॉडल का उपयोग करना आसान है; आंतरिक प्रक्रियाओं को पुनः प्रशिक्षित करने या ट्यून करने के लिए अधिक विशेषज्ञता की आवश्यकता होती है |
फीचर-आधारित विधियों का सबसे लंबा ट्रैक रिकॉर्ड है, जिसमें कई एम्बेडेड अनुप्रयोग शामिल हैं; बनावट की कमी होने पर प्रत्यक्ष विधियाँ बेहतर प्रदर्शन करती हैं; लर्निंग-आधारित विधियाँ तेजी से बेहतर हो रही हैं, लेकिन इसके लिए अधिक कंप्यूटिंग शक्ति की आवश्यकता होती है — 2026 तक लगभग यही स्थिति रहेगी।
10. बैकएंड
विजुअल-एसएलएएम की सटीकता केवल फ्रंटएंड (फीचर एक्सट्रैक्शन, ट्रैकिंग, पोज़ एस्टिमेशन) से ही निर्धारित नहीं होती — बल्कि बैकएंड से भी निर्धारित होती है, जो एकत्रित किए गए सभी ऑब्ज़र्वेशन्स को सुसंगत रूप में परिष्कृत करता है।
बंडल एडजस्टमेंट* कैमरे के पोज़ और लैंडमार्क की 3D स्थिति को संयुक्त रूप से अनुकूलित करता है ताकि वे प्रत्येक ऑब्ज़र्वेशन के साथ अधिकतम रूप से सुसंगत हों। यह कुल रीप्रोजेक्शन त्रुटि को कम करता है — एक लैंडमार्क \mathbf{X}_i को कैमरे के पोज़ (R_j, \mathbf{t}_j) के माध्यम से छवि में प्रक्षेपित करने और संबंधित फीचर को वास्तव में कहाँ देखा गया था, \mathbf{u}_{ij} के बीच का अंतर।
\pi(\cdot) एक 3D बिंदु से इमेज प्लेन पर प्रोजेक्शन फंक्शन है, जो कैमरे के आंतरिक मापदंडों पर आधारित है। ग्लोबल बंडल एडजस्टमेंट, जो प्रत्येक फ्रेम और प्रत्येक लैंडमार्क को एक साथ ऑप्टिमाइज़ करता है, अत्यधिक सटीक है लेकिन खर्चीला है; व्यवहार में, गणना को प्रबंधनीय रखने के लिए इसे आमतौर पर लोकल बंडल एडजस्टमेंट के साथ जोड़ा जाता है, जो केवल हाल के कुछ फ्रेम तक सीमित होता है।
जब लूप क्लोज़र का पता चलता है, तो पोज़ ग्राफ़ ऑप्टिमाइज़ेशन सक्रिय हो जाता है। बंडल एडजस्टमेंट के विपरीत, जिसमें प्रत्येक लैंडमार्क शामिल होता है, पोज़ ग्राफ़ ऑप्टिमाइज़ेशन प्रत्येक टाइमस्टेप पर केवल कैमरे की पोज़ को एक नोड के रूप में मानता है, जिसमें किनारे फ्रेम के बीच सापेक्ष-पोज़ बाधाओं को एन्कोड करते हैं - केवल पोज़ को तेज़ी से ऑप्टिमाइज़ करते हैं। लूप क्लोज़र द्वारा जोड़ी गई नई बाधा संचित ड्रिफ्ट को पूरे लूप में पुनर्वितरित करती है।
इन दोनों को नॉनलाइनियर ऑप्टिमाइज़ेशन के ढांचे के भीतर हल किया जाता है। क्योंकि प्रोजेक्शन फ़ंक्शन \pi(\cdot) और किसी पोज़ में रोटेशन का संयोजन स्वाभाविक रूप से नॉन-लीनियर होता है, इसलिए गॉस-न्यूटन और लेवेनबर्ग-मार्क्वार्ड जैसी पुनरावृत्ति विधियों का उपयोग किया जाता है, और Visual-SLAM कार्यान्वयन में g2o और Ceres Solver जैसी लाइब्रेरीज़ पर व्यापक रूप से भरोसा किया जाता है।
11. Visual-SLAM की कमियाँ
क्योंकि Visual-SLAM एक निष्क्रिय सेंसर — एक कैमरा — पर निर्भर करता है, इसलिए कुछ स्थितियों में इसकी सटीकता में व्यवस्थित रूप से गिरावट आती है।
-
अंधेरा: पर्याप्त प्रकाश के अभाव में, छवि का सिग्नल-टू-नॉइज़ अनुपात कम हो जाता है, जिससे फ़ीचर डिटेक्शन और ब्राइटनेस-ग्रेडिएंट गणनाएँ, जिन पर प्रत्यक्ष विधियाँ निर्भर करती हैं, दोनों अस्थिर हो जाती हैं। इन्फ्रारेड-प्रकाशित RGB-D कैमरे कुछ हद तक इसकी भरपाई कर सकते हैं, लेकिन रात में बाहर इसका प्रभाव सीमित होता है।
-
कम बनावट: सफेद दीवारें, सादे फर्श, कांच की सतहें — जहां भी चमक में अंतर कम होता है, वहां विशेषताएं नहीं मिल पातीं, या प्रत्यक्ष विधि द्वारा न्यूनतमकरण प्रक्रिया जटिल हो जाती है और स्थानीय न्यूनतम बिंदुओं के प्रति संवेदनशील हो जाती है।
-
तेज़ गति: कैमरे की तीव्र गति या घुमाव से फ्रेम के बीच समानताएं खोजने के लिए आवश्यक खोज सीमा बढ़ जाती है, और गति धुंधलापन (नीचे) के साथ मिलकर, ट्रैकिंग आसानी से विफल हो जाती है। इस कमजोरी को दूर करने के लिए IMU (VIO) का उपयोग करना मानक तरीका है।
गतिशील वस्तुएं*: चलते हुए पैदल यात्री या कार की विशेषताओं को स्थिर वातावरण का हिस्सा मानकर, कैमरे की गति के अनुमान में त्रुटि उत्पन्न हो जाती है। इसके लिए या तो गतिशील वस्तुओं का पता लगाने और उन्हें बाहर करने के लिए पूर्व-प्रसंस्करण की आवश्यकता होती है, या उन्हें स्पष्ट रूप से मॉडल करने वाले एक्सटेंशन की।
गति धुंधलापन*: एक्सपोज़र विंडो के दौरान कैमरे या विषय की गति के कारण होने वाला धुंधलापन, जो विशेषता विवरणकों को अस्थिर कर देता है और मिलान सटीकता को कम कर देता है। ग्लोबल-शटर कैमरे या कम एक्सपोज़र समय वाले उच्च प्रकाश वातावरण इसके प्रभाव को कम करते हैं।
इन सभी में एक बात समान है: कैमरे को काम करने के लिए पर्याप्त दृश्य जानकारी नहीं मिल रही है। LiDAR जैसे सक्रिय रेंजिंग सेंसर (देखें LiDAR-SLAM टेक्नोलॉजी ट्रेंड्स) सिद्धांत रूप में इनमें से अधिकांश कमियों को दूर कर देते हैं, लेकिन इनकी अपनी कुछ कमियां भी हैं (देखें सेक्शन 2) — कोई भी एक सेंसर सार्वभौमिक रूप से पर्याप्त नहीं है, और यही पूरकता सेंसर फ्यूजन (देखें सेंसर फ्यूजन प्राइमर) के महत्व का कारण है।
12. व्यवहार में विधि का चयन
विजुअल-SLAM दृष्टिकोण का चयन इस बात पर बहुत हद तक निर्भर करता है कि आप कौन से सेंसर ले जा सकते हैं, कितनी कंप्यूटिंग क्षमता उपलब्ध है, और एप्लिकेशन को कितनी सटीकता और वास्तविक समय प्रदर्शन की आवश्यकता है।
-
रोबोट (इनडोर सर्विस रोबोट, सफाई रोबोट): अक्सर कम लागत वाले कैमरा सेटअप तक सीमित रहते हैं, जहां फीचर-आधारित ORB-SLAM-परिवार के तरीके या RGB-D कैमरों के माध्यम से सघन मैपिंग व्यावहारिक विकल्प होते हैं। गलियारों की अधिकता और कम बनावट वाले वातावरण में, LiDAR के साथ संयोजन पर विचार करना उचित है।
-
ड्रोन: कंप्यूटिंग और पेलोड वजन पर गंभीर प्रतिबंधों के कारण SVO जैसे हल्के अर्ध-प्रत्यक्ष तरीकों या IMU के साथ कसकर जुड़े VIO कॉन्फ़िगरेशन की ओर रुझान बढ़ रहा है।
-
AR/VR: रीयल-टाइम प्रदर्शन और कम विलंबता सर्वोच्च प्राथमिकता है, और हेडसेट के अंतर्निर्मित IMU के साथ एक विज़ुअल-इनर्टियल कॉन्फ़िगरेशन मानक बन गया है। विशेष रूप से AR में, ग्लोबल कंसिस्टेंसी सीधे निर्धारित करती है कि आभासी वस्तुएं विचलित होती हैं या नहीं, इसलिए लूप क्लोजर सटीकता भी बहुत मायने रखती है।
-
स्वायत्त ड्राइविंग: स्टैंडअलोन विज़ुअल-SLAM के रूप में शायद ही कभी उपयोग किया जाता है; कैमरा-आधारित दृश्य जानकारी को आमतौर पर LiDAR, रडार और GNSS के साथ एक बहु-सेंसर संलयन सेटअप में शामिल किया जाता है (देखें सेंसर संलयन प्राइमर)।
- इनडोर बनाम आउटडोर: इनडोर में, प्रकाश परिवर्तन सूक्ष्म होते हैं और पर्याप्त संरचना होती है, इसलिए फीचर-आधारित विधियाँ आमतौर पर बेहतर काम करती हैं; आउटडोर में, प्रकाश भिन्नता, गतिशील वस्तुएँ और विशाल पैमाना चुनौतियाँ बन जाते हैं, जिससे लूप क्लोजर की मजबूती और भी महत्वपूर्ण हो जाती है।
2026 तक, निर्णय लेने का मोटा-मोटा तरीका इस प्रकार है: यदि कंप्यूटिंग संसाधन प्रचुर मात्रा में उपलब्ध हैं और उच्चतम सटीकता लक्ष्य है, तो लर्निंग-आधारित विधि चुनें; यदि एम्बेडेड कार्य अनुभव और कम संसाधन उपयोग सबसे महत्वपूर्ण हैं, तो फीचर-आधारित विधि चुनें; और यदि कम बनावट वाले वातावरण में लचीलापन आवश्यक है, तो डायरेक्ट विधि चुनें। नवीनतम शोध दिशाएँ — 3D गॉसियन स्प्लैटिंग/NeRF, फीड-फॉरवर्ड 3D फाउंडेशन मॉडल आदि के साथ मानचित्र प्रतिनिधित्व को नया रूप देना — Visual-SLAM Trends में शामिल हैं।
कार्यान्वयन से पहले पाँच जाँचें
केवल एल्गोरिदम के नाम से चयन करने से क्षेत्र में विफलताओं का निदान करना कठिन हो जाता है। कार्यान्वयन से पहले, सुनिश्चित करें कि इन पाँच बिंदुओं को लॉग किया जा सके; ट्रैकिंग विफल होने पर, आप सेंसर समस्या को एस्टीमेटर समस्या से अलग कर सकते हैं।
| जाँच | तैयारी के लिए जानकारी | चूक होने पर क्या गलत होगा |
|---|---|---|
| अंशांकन | इंट्रिंसिक्स K, लेंस विरूपण, और यदि लागू हो तो स्टीरियो बेसलाइन | रीप्रोजेक्शन त्रुटि पोज़ त्रुटि जैसी दिखती है, और स्केल का मूल्यांकन नहीं किया जा सकता |
| समय तुल्यकालन | फ्रेम टाइमस्टैम्प, कैमरा-IMU ऑफ़सेट, और छूटे हुए फ्रेम | तेज़ गति के दौरान, छवि और जड़त्वीय डेटा अलग-अलग स्थितियों का वर्णन करते हैं |
| शटर और एक्सपोज़र | ग्लोबल/रोलिंग शटर, एक्सपोज़र समय और ऑटो-एक्सपोज़र सेटिंग्स | मोशन ब्लर या ज्यामितीय विकृति को एल्गोरिदम की विफलता मान लिया जाता है |
| गतिशील वस्तुएँ | क्या मास्क का उपयोग किया जाता है, गतिशील वस्तुओं का अंश और अस्वीकृत पत्राचार | पैदल यात्री या वाहन स्थिर मानचित्र में समाहित हो जाते हैं |
| मूल्यांकन लॉग | ग्राउंड ट्रुथ, एटीई/आरपीई, ट्रैक-लॉस समय और लूप-डिटेक्शन परिणाम | सटीकता, ड्रिफ्ट या रिकवरी की तुलना करने के लिए केवल "यह हिल गया" कहना पर्याप्त नहीं है |
इस तालिका को पहले भरने से यह अलग करना भी आसान हो जाता है कि फ़ीचर-आधारित से डायरेक्ट या लर्निंग-आधारित विधियों पर स्विच करते समय क्या बदलना आवश्यक है और क्या स्थिर रह सकता है। विज़ुअल-एसएलएएम को एक एल्गोरिदम के रूप में नहीं, बल्कि एक सिस्टम के रूप में चुना जाना चाहिए - जिसमें कैमरा, टाइमिंग, प्रीप्रोसेसिंग, ऑप्टिमाइज़ेशन और मूल्यांकन शामिल हैं।
13. सारांश
विज़ुअल-एसएलएएम केवल कैमरा छवियों से पत्राचार का पता लगाता है, एपिपोलर ज्यामिति और पीएनपी के माध्यम से कैमरे की गति को पुनर्प्राप्त करता है, और मानचित्र और लूप क्लोज़र के माध्यम से संचित त्रुटि को लगातार ठीक करता है - जिससे एक साथ स्थानीयकरण और मानचित्रण प्राप्त होता है। तीन डिज़ाइन दर्शन - फ़ीचर-आधारित (ओआरबी-एसएलएएम परिवार), प्रत्यक्ष (डीएसओ/एलएसडी-एसएलएएम), और लर्निंग-आधारित (ड्रॉइड-एसएलएएम) - प्रत्येक एक अलग ट्रेडऑफ़ पर आधारित हैं, और इन्हें इस आधार पर समझना सबसे आसान है कि क्या फ़ीचर को स्पष्ट रूप से संभाला जाता है, क्या चमक का सीधे उपयोग किया जाता है, और कितना लर्निंग को सौंपा जाता है। वास्तव में कौन सा चुनना है, यह एक अनुप्रयोग-विशिष्ट निर्णय है, जो उपलब्ध सेंसर, कंप्यूटिंग क्षमता, और आवश्यक सटीकता और वास्तविक समय प्रदर्शन के आधार पर लिया जाता है।
14. संदर्भ
ऊपर चर्चा की गई प्रतिनिधि विधियों और दो-दृश्य ज्यामिति के लिए प्राथमिक शोध पत्र और शोध पृष्ठ यहां कार्यान्वयन और आगे पढ़ने के लिए प्रारंभिक बिंदु के रूप में एकत्रित किए गए हैं। किसी शोध पत्र के दावे को किसी विशेष उत्पाद या डेटासेट पर प्रदर्शन के साथ भ्रमित होने से बचने के लिए, लिंक किए गए पाठ को उसकी प्रायोगिक स्थितियों के साथ पढ़ें।
-
ORB-SLAM3: विज़ुअल, विज़ुअल-इनर्टियल और मल्टी-मैप SLAM के लिए एक सटीक ओपन-सोर्स लाइब्रेरी — एक लाइब्रेरी जो विज़ुअल, विज़ुअल-इनर्टियल और मल्टी-मैप डिज़ाइनों को कवर करती है।
-
DROID-SLAM: मोनोक्युलर, स्टीरियो और RGB-D कैमरों के लिए डीप विज़ुअल SLAM — एक लर्निंग-आधारित विधि जो सहसंबंध वॉल्यूम को डिफरेंशिएबल डेंस बंडल एडजस्टमेंट के साथ जोड़ती है।
-
LSD-SLAM: लार्ज-स्केल डायरेक्ट मोनोक्युलर SLAM — डायरेक्ट, सेमी-डेंस मोनोक्युलर SLAM के लिए आधिकारिक शोध पृष्ठ।
-
डायरेक्ट स्पार्स ओडोमेट्री — स्लाइडिंग-विंडो फोटोमेट्रिक-त्रुटि अनुकूलन पर DSO का शोध पत्र।
-
पांच-बिंदु सापेक्ष स्थिति समस्या का एक कुशल समाधान — 5-बिंदु एसेंशियल मैट्रिक्स सॉल्वर पर मूल शोधपत्र।
क्या एक आकर्षक मानचित्र सटीक स्थान निर्धारण स्थापित करता है?
प्रक्षेपवक्र त्रुटि से अलग मानचित्र की दिखावट का मूल्यांकन करें। पैमाने, संरेखण, स्थानीय त्रुटि और दीर्घकालिक बहाव की जाँच करें।
टिप्पणियाँ
पहले लॉग इन करें।
अभी कोई डेटा नहीं है।