Contents — find the section you need
Saugroboter, Drohnen, selbstfahrende Autos und AR-Brillen haben eine gemeinsame Anforderung: die Antwort auf die Frage „Wo befinde ich mich gerade?“. GPS funktioniert weder in Innenräumen noch in dicht besiedelten Städten, und Karten sind ohnehin nicht immer verfügbar. Visual-SLAM ist die Technologie, die diese Frage allein mithilfe von Kamerabildern (manchmal in Kombination mit kostengünstigen Zusatzsensoren) beantwortet. Dieser Artikel beginnt mit der Frage, warum ein Roboter überhaupt seine Position verliert, behandelt dann die Merkmalserkennung, die mathematischen Grundlagen der Kamerageometrie, den Unterschied zwischen visueller Odometrie und SLAM, die Entwicklung von Landmarkenalgorithmen und schließlich die praktische Auswahl des passenden Algorithmus.
 Visual-SLAM-Eingabekamera
 Beispiel für eine Fahrzeugkamera
Bilder: Intel RealSense Tiefenkamera D435 (Marc Auledas, CC BY-SA 4.0) / Car Fensterkamera des Mobileye-Systems (Ranbar, CC BY-SA 4.0), Wikimedia Commons. Repräsentative Kameras, keine erforderliche Hardwarekonfiguration für Visual-SLAM.


0. Inhalt dieses Artikels
- Was Visual-SLAM ist und warum eine Kamera allein ihre Position schätzen kann
-
Wie sich visuelle Odometrie (VO) von SLAM unterscheidet
-
Welchen Beitrag ORB-SLAM, LSD-SLAM, DSO, SVO und DROID-SLAM jeweils als Designoptionen leisten
-
Der Unterschied zwischen merkmalsbasierten, direkten und lernbasierten Ansätzen
-
Wo Visual-SLAM an seine Grenzen stößt und warum
-
Wie man die richtige Methode für einen Roboter, eine Drohne, AR/VR oder ein autonomes Fahrzeug auswählt
1. Was Visual-SLAM tatsächlich leistet
Kurz gesagt: Visual-SLAM schätzt gleichzeitig die Bewegung einer Kamera im Raum (Lokalisierung) und die 3D-Struktur ihrer Umgebung (Kartierung) – ausschließlich anhand der von der Kamera aufgenommenen Bildsequenz.
Der Name selbst – Simultaneous Localization And Mapping (SLAM) – verweist auf das Wesentliche: die Das Wort „simultan“ spielt hier eine wichtige Rolle. Wäre die Karte bereits bekannt, wäre die Positionsbestimmung vergleichsweise einfach; wäre die Position präzise bekannt, ließe sich die Karte ebenfalls leicht erstellen. Visual-SLAM hat diesen Vorteil nicht: Die Kartenerstellung erfordert die Kenntnis der eigenen Position, und die Kenntnis der Position erfordert die Karte. Diese Henne-Ei-Abhängigkeit muss aus demselben Datenstrom, der gleichzeitig erfasst wird, entwirrt werden.
Die Eingabe besteht aus einer Zeitreihe von Bildern einer Kamera (monokular, stereo oder RGB-D), die Ausgabe aus zwei Dingen: der 6-Freiheitsgrade-Pose der Kamera (3 für die Position, 3 für die Orientierung) in jedem Zeitschritt und einer Karte der Umgebung (einer spärlichen Menge von Merkmalspunkten oder einer dichten 3D-Form). Ein Saugroboter, der während der Reinigung den Grundriss eines Raumes lernt, eine Drohne, die in Innenräumen oder unterirdisch, wo GPS nicht verfügbar ist, stabil schwebt, ein AR-Headset, das virtuelle Objekte driftfrei in die reale Welt einblendet – in all diesen Fällen kommt Visual-SLAM zum Einsatz.
2. Warum weiß ein Roboter nicht, wo er ist?
Um das Problem zu verstehen, das Visual-SLAM tatsächlich löst, hilft es, sich konkret zu fragen: Warum verliert ein Roboter überhaupt seine Position?
Erstens gibt es viele Umgebungen ohne GPS oder mit unzuverlässigem GPS. Ob in Gebäuden, unterirdisch, in Tunneln, in den Straßenschluchten zwischen Wolkenkratzern (wo Mehrwegeausbreitung den Positionsfehler massiv erhöht) oder unter Wasser und auf anderen Planeten, wo es keine Satellitenkonstellation gibt – all diese Orte bieten keine Möglichkeit, direkt eine absolute Position zu bestimmen.
Zweitens gibt es das Problem, dass schlicht keine Karte existiert. Ein Neubau, ein Katastrophengebiet, eine unerforschte Planetenoberfläche – vorgefertigte Kartendaten sind nicht immer verfügbar. Ohne Karte ist es unmöglich, die Position anhand einer Karte zu überprüfen.
Drittens – und das ist der grundlegendste Punkt – kann eine einzelne Sensormessung prinzipiell keine absolute Position bestimmen. Eine Kamera erfasst nur ihre aktuelle Umgebung. Ein einzelnes Bild sagt nicht sofort: „Das ist 2,3 Meter von dieser Wand im Wohnzimmer entfernt.“ Um eine Wand als „diese Wand“ zu erkennen, muss man sie zuvor gesehen haben und sich erinnern, wo man sich damals befand. Anders ausgedrückt: Um aus einer aktuellen Beobachtung sinnvolle Positionsinformationen zu gewinnen, ist eine Korrespondenz mit früheren Beobachtungen erforderlich (Ihr aktueller Standort hängt davon ab, wo Sie sich zuvor befanden) – und genau diese Korrespondenz liefert eine Karte.
Das Kernproblem von SLAM besteht darin, diese Korrespondenz zwischen „Was ich jetzt sehe“ und „Was ich zuvor kartiert habe“ kontinuierlich und konsistent allein anhand von Beobachtungsdaten herzustellen, ohne dass jemals eine externe absolute Position angegeben wird. Eine einzige fehlerhafte Korrespondenz pflanzt ihren Fehler in jede nachfolgende Schätzung fort – und wie dieser akkumulierte Fehler unterdrückt und nachträglich korrigiert werden kann, ist die zentrale Designfrage hinter jedem Visual-SLAM-Algorithmus.
3. Was findet man in einem Kamerabild?
Die Rohdaten einer Kamera sind nichts anderes als ein Raster von Pixelwerten – Helligkeit, Farbe. Der erste Schritt, um herauszufinden, wie ich mich bewegt habe, besteht darin, innerhalb dieses Rasters nachverfolgbare Merkmale zu finden.
Ein Merkmal ist ein lokaler Punkt im Bild, der sich deutlich von seiner Umgebung abhebt und auch bei einem Wechsel des Blickwinkels zuverlässig wiedererkannt werden kann – beispielsweise eine Ecke, ein Kantenschnittpunkt oder eine Stelle, an der sich Helligkeitsgradienten in mehrere Richtungen stark verändern. Ein gleichmäßiger blauer Himmelsfleck, der sich nicht von seinen Nachbarn unterscheidet, kann nicht als Merkmal dienen.
Die Merkmalserkennung findet potenzielle Merkmalspunkte in einem einzelnen Bild. Algorithmen wie ORB (Oriented FAST and Rotated BRIEF), SIFT und der FAST-Eckendetektor entscheiden, welche Pixel Merkmalen ähneln, und berechnen einen Deskriptor – eine numerische Zusammenfassung des lokalen Erscheinungsbilds um jedes dieser Pixel herum.
Die Merkmalsverfolgung findet und vergleicht dieselben Merkmale im nächsten Bild. Es gibt zwei grundlegende Ansätze: das Abgleichen erkannter Merkmale anhand der Ähnlichkeit ihrer Deskriptoren (Feature Matching) und das Suchen in der Umgebung eines Merkmals im nächsten Frame, ausgehend von dessen Position im vorherigen Frame (Optischer Fluss, klassisch mittels der Lucas-Kanade-Methode).
Diese Beziehung – derselbe Punkt in der realen Welt erscheint in verschiedenen Frames an unterschiedlichen Positionen – wird als Korrespondenz bezeichnet. Nahezu jede geometrische Berechnung in Visual-SLAM benötigt eine Menge von Korrespondenzen als Eingabe; ohne eine einzige Korrespondenz gibt es prinzipiell keinerlei Anhaltspunkt für die Kamerabewegung.
Der Optische Fluss ist ein Vektorfeld, das beschreibt, wie weit und in welche Richtung sich jeder Punkt im Bild (oder eine kleine Menge von Punkten) zwischen den Frames bewegt hat – nicht nur Merkmale. Während die merkmalsbasierte Verfolgung nur den markantesten Punkten folgt, kann der Optische Fluss Bewegungsinformationen über einen größeren Bereich nutzen, allerdings mit in der Regel höherem Rechenaufwand.
4. Berechnung der Kamerabewegung
Sobald Korrespondenzen vorliegen, können sie geometrisch in eine Schätzung der Kamerabewegung umgewandelt werden. Grundlage dieser Berechnung ist die Epipolargeometrie.
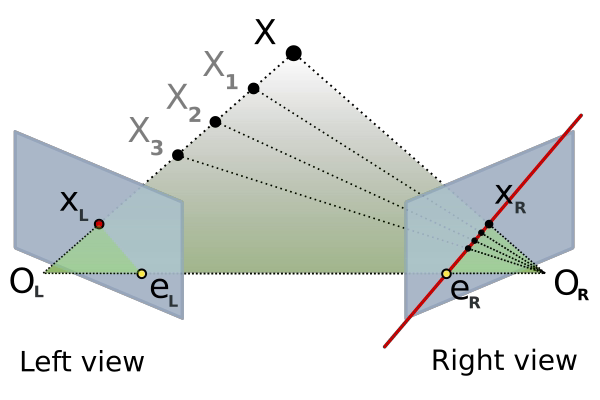
Abbildung 1 – Zwei Kameraperspektiven O_1 und O_2, ein Punkt X im Raum und seine Projektionen x_1 und x_2 auf die jeweiligen Bildebenen. Gegeben x_1, liegt der zugehörige Punkt x_2 im zweiten Bild stets auf einer Geraden (der Epipolarlinie).
Abbildung: Epipolar Geometrie (Arne Nordmann, CC BY-SA 3.0 / GFDL), Wikimedia Commons. Die ursprüngliche SVG-Datei wurde für eine zuverlässige Browserdarstellung in eine PNG-Datei mit weißem Hintergrund konvertiert.

Wird derselbe Punkt X im Raum aus zwei verschiedenen Blickwinkeln fotografiert, so kann der entsprechende Punkt \mathbf{x}_2 im einen Bild, gegeben einen Punkt \mathbf{x}_1 im anderen Bild, nicht frei im Bild liegen – er muss auf einer einzigen Geraden (der Epipolarlinie) liegen. Die Matrix, die diese geometrische Einschränkung beschreibt, ist die Essentielle Matrix E. Sind die intrinsischen Kameraparameter bekannt, erfüllen korrespondierende Punkte in normalisierten Kamerakoordinaten folgende Bedingung:
Dabei bezeichnen R und \mathbf{t} die Rotation bzw. Translation von Kamera 1 zu Kamera 2, und [\mathbf{t}]_{\times} ist die schiefsymmetrische Matrix, die aus \mathbf{t} gebildet wird und ein Kreuzprodukt als Matrixmultiplikation darstellt. Diese Gleichung besagt, dass diese Bedingung stets zwischen einer Korrespondenz \mathbf{x}_1, \mathbf{x}_2 und der relativen Rotation bzw. Translation der Kamera gilt. Die benötigte Anzahl an Korrespondenzen hängt vom Schätzer ab: Eine kalibrierte Essentielle Matrix benötigt einen minimalen 5-Punkt-Solver, während die lineare 8-Punkt-Schätzung mindestens 8 Korrespondenzen verwendet. Da reale Daten Ausreißer enthalten, sammeln praktische Systeme mehr Übereinstimmungen und kombinieren diese mit RANSAC oder einem anderen robusten Schätzer. Wenn die intrinsischen Parameter unbekannt sind oder direkt mit Pixelkoordinaten gearbeitet wird, spielt die Fundamentalmatrix F = K_2^{-\top} E K_1^{-1}, die die intrinsische Matrix K enthält, dieselbe Rolle.
Die aus der Essentiellen Matrix abgeleitete Translation \mathbf{t} besitzt keine reale Einheit (z. B. Meter) – zwei Bilder allein geben keine Auskunft darüber, ob sich die Kamera um einen oder zwei Meter bewegt hat. Diese Skalenmehrdeutigkeit ist eine spezifische Einschränkung von Visual-SLAM, insbesondere bei monokularen Konfigurationen, und wird in Abschnitt 5 erneut behandelt.
Die Berechnung der tatsächlichen 3D-Position einer Korrespondenz – der Koordinaten des Punktes X im Raum – wird als Triangulation bezeichnet. Verlängert man die beiden Strahlen, die von jedem Standpunkt auf X gerichtet sind, sollten sich diese idealerweise genau im Punkt X schneiden. Die Ermittlung des Schnittpunkts liefert die 3D-Position der Korrespondenz (in der Praxis treffen sich die Strahlen aufgrund von Beobachtungsrauschen nicht exakt; stattdessen wird der Punkt gefunden, der beiden Punkten im Sinne der kleinsten Quadrate am nächsten liegt).
Wenn eine Korrespondenz zwischen einem Landmarkenpunkt mit bekannter 3D-Position und seiner Position im Bild vorliegt, kann die Kamerapose direkt daraus berechnet werden. Dies ist das PnP-Problem (Perspektive-n-Punkt): Gegeben n 3D-Punkte und ihre projizierten Positionen im Bild, werden Position und Orientierung der Kamera bestimmt. Sobald eine solche Karte existiert, wird PnP zum zentralen Werkzeug für die Berechnung der Kamerapose in jedem neuen Frame.
5. Visuelle Odometrie
Die einfache Wiederholung der Berechnung der Kamerabewegung anhand der Korrespondenzen Frame für Frame genügt bereits, um die Kameratrajektorie zu schätzen. Dies ist die Visuelle Odometrie (VO).
VO setzt lediglich die relative Bewegung zwischen dem aktuellen und dem vorherigen (oder den letzten paar) Frames zusammen, um die Kameratrajektorie zu berechnen. Es verfügt in der Regel über keinen Mechanismus zur Speicherung einer persistenten Karte oder zur Erkennung bereits besuchter Orte – es ähnelt eher dem Kilometerzähler eines Autos, der kontinuierlich berechnet: „Wie weit bin ich seit eben gefahren?“
Der Unterschied zwischen VO und SLAM liegt genau darin: ob das System eine Karte speichert und einen Mechanismus zur Wiederherstellung der Konsistenz mit der Vergangenheit besitzt. VO ist ressourcenschonend und einfach zu implementieren, aber da die Schätzung jedes Frames immer vom vorherigen abhängt, akkumulieren sich kleine Fehler mit der Zeit unbegrenzt. Dieser akkumulierte Fehler wird als Drift bezeichnet. Kehrt ein Roboter zu seinem Ausgangspunkt zurück, kann VO allein nicht erkennen: „Ich bin wieder da, wo ich angefangen habe“ – die geschätzte Trajektorie bleibt vom Startpunkt versetzt und schließt sich nie.
Es gibt ein weiteres Problem, das spezifisch für VO, insbesondere für monokulares VO, ist und das bereits in Abschnitt 4 angesprochen wurde: das Skalierungsproblem. Bilder einer Monokularkamera allein können keine absolute Längeneinheit in der realen Welt erfassen – nichts im Bild unterscheidet zwischen „2 Meter bewegt, Objekt erscheint doppelt so groß“ und „4 Meter bewegt, Objekt erscheint viermal so groß“. Eine Stereokamera (deren Linsen einen bekannten Abstand zur Skalierung haben), eine RGB-D-Kamera (deren Tiefensensor Entfernungen in der realen Welt direkt misst) oder die Kombination mit einer IMU (deren Beschleunigungsmessung in der realen Welt die Skalierung ermöglicht) kann diese Mehrdeutigkeit der Skalierung auflösen.
6. Was SLAM zusätzlich zu VO bietet
SLAM lässt sich als VO mit den folgenden zusätzlichen Komponenten verstehen:
Eine Karte ist eine akkumulierte Darstellung der 3D-Position jedes bisher beobachteten Objekts (oder einer dichten 3D-Form). Anstatt wie bei VO nur mit dem unmittelbar vorhergehenden Bild zu vergleichen, kann das System nun alle in der Karte gespeicherten Daten abgleichen.
Ein Landmark ist ein einzelnes Element dieser Karte – üblicherweise ein markanter Punkt mit einer 3D-Position. Jedes Mal, wenn ein neues Bild eintrifft, ermöglicht der Abgleich mit den darin sichtbaren Landmarks dem System, die Kameraposition konsistent zu schätzen – nicht nur anhand des vorherigen Bildes, sondern anhand der gesamten, über die gesamte Roboterhistorie erstellten Karte.
Der Schleifenschluss ist der wichtigste Vorteil von SLAM gegenüber VO. Kehrt ein Roboter zu einem bereits besuchten Ort zurück, wird dies mithilfe der Bildähnlichkeit erkannt und der Karte eine neue Bedingung hinzugefügt, die den aktuellen Standort mit dem Standort beim ersten Besuch verknüpft. Durch diese Bedingung kann das System die entlang der gesamten Schleife akkumulierte Abweichung neu verteilen und korrigieren.
Das Ergebnis dieser Korrektur ist die globale Konsistenz. Vor dem Schleifenschluss führt der akkumulierte Fehler dazu, dass zwei Positionen auf der Karte, die eigentlich denselben physischen Ort darstellen sollten, als leicht unterschiedliche Positionen aufgezeichnet werden. Die Schleifenkorrektur erkennt diese Diskrepanz und formt die gesamte Karte in eine konsistente Form um – genau dieser Schleifenkorrekturmechanismus ermöglicht es SLAM, nicht nur „Bewegungsdaten“, sondern eine „konsistente Karte“ zu liefern.
7. Die Grundstruktur von Visual-SLAM
Die Zusammenführung dieser Elemente ergibt eine Pipeline, die im Wesentlichen allen wichtigen modernen Visual-SLAM-Systemen gemeinsam ist.
Abbildung 2 – Die Bilder der Kamera werden mit dem vorherigen Frame abgeglichen (Feature-/Direkt-Tracking, unter Verwendung eines der Verfahren aus den Abschnitten 3 und 8). Dies steuert die Pose-Schätzung (epipolare Geometrie und PnP aus Abschnitt 4) und parallel dazu das lokale Mapping (Hinzufügen und Aktualisieren von Landmarken im zuletzt beobachteten Bild). Wird eine Schleife erkannt, wird die Schleifenschließung ausgelöst, und die Optimierungsschicht im Backend (Abschnitt 10) – Bündelausgleich oder Pose-Graph-Optimierung – korrigiert die akkumulierten Posen und stellt sie in ein konsistentes Ganzes dar.
Die Kamerabilder durchlaufen zunächst Feature-/Direkt-Tracking (eines der in den Abschnitten 3 und 8 beschriebenen Verfahren), um Korrespondenzen mit dem vorherigen Frame herzustellen. Aus diesen Korrespondenzen berechnet die Pose-Schätzung (unter Verwendung der Epipolargeometrie und PnP aus Abschnitt 4) die Kamerapose, während parallel das lokale Mapping (Hinzufügen und Aktualisieren von Landmarken im zuletzt beobachteten Bereich) erfolgt. Wird eine Schleife erkannt, wird die Schleifenschließung ausgelöst, und die Optimierungsstufe im Backend (Abschnitt 10) korrigiert die akkumulierten Posen und stellt sie in ein global konsistentes Ganzes dar. Das Endergebnis dieser Pipeline ist die endgültige Ausgabe: die Pose (Trajektorie) der Kamera und die Karte (die 3D-Struktur ihrer Umgebung).
8. Wegweisende Algorithmen
Die Geschichte von Visual-SLAM lässt sich am einfachsten anhand einer Achse nachvollziehen: Wie viel wurde explizit entworfen und wie viel wurde dem Lernprozess überlassen?
PTAM (Parallel Tracking and Mapping, Klein & Murray, 2007) war ein Pioniersystem, das Tracking (Pose-Schätzung) und Mapping (Kartenerstellung) in separaten parallelen Threads ausführte. Tracking läuft schnell in jedem Frame, während die rechenintensive Bundle Adjustment für Mapping in einem Hintergrundthread mit mehr Zeitreserven ausgeführt wird – diese Idee der Trennung von Tracking und Mapping wurde von vielen späteren Visual-SLAM-Systemen übernommen.
ORB-SLAM (Mur-Artal, Montiel & Tardós, 2015) basiert auf ORB-Funktionen und kombiniert eine Drei-Thread-Struktur (Tracking, lokales Mapping, Schleifenschluss) mit Ortserkennung (Abgleich mit vorherigen Frames mittels Bag-of-Words), um eine praktikable monokulare Leistung zu erzielen. ORB-SLAM2 (Mur-Artal & Tardós, 2017) erweiterte dieses Framework über monokulare Kameras hinaus auf Stereo- und RGB-D-Kameras. ORB-SLAM3 (Campos, Elvira, Gómez Rodríguez, Montiel & Tardós, 2021) ergänzte es um eine enge Kopplung mit einer IMU (Visual-Inertial SLAM) und Multi-Map SLAM, das mehrere Karten verwaltet und diese nach Bedarf zusammenführt – und gilt bis heute als De-facto-Referenzimplementierung für merkmalsbasiertes SLAM.
LSD-SLAM (Large-Scale Direct monocular SLAM, Engel, Schöps & Cremers, 2014) ist ein wegweisendes Beispiel für die direkte Methode. Es zeigt, dass die Kamerapose direkt anhand der Bildhelligkeit geschätzt werden kann, ohne dass ein Schritt zur Merkmalserkennung erforderlich ist – und zwar in großem Maßstab. Durch den vollständigen Verzicht auf die Merkmalsextraktion können Informationen auch dann genutzt werden, wenn nur wenige Merkmale vorhanden sind.
DSO (Direct Sparse Odometry, Engel, Koltun & Cremers, erstmals vorgestellt 2016, veröffentlicht 2018) arbeitet direkt, minimiert aber – im Gegensatz zu LSD-SLAM, das eine semidichte Schätzung liefert – den photometrischen Fehler über eine kleine Anzahl von Punkten und erzielt so sowohl Genauigkeit als auch Recheneffizienz.
SVO (Fast Semi-Direct Monocular Visual Odometry, Forster, Pizzoli & Scaramuzza, 2014) kombiniert Merkmalserkennung mit einer direkten Methode in einem semidirekten Ansatz. Dabei wird die Helligkeit in Bereichen um erkannte Merkmale herum verfolgt, um eine schnelle Verarbeitung bei hohen Bildraten zu ermöglichen – speziell entwickelt für ressourcenbeschränkte Plattformen wie Drohnen.
SVO (Fast Semi-Direct Monocular Visual Odometry, Forster, Pizzoli & Scaramuzza, 2014) kombiniert Merkmalserkennung mit einer direkten Methode in einem semidirekten Ansatz. Dabei wird die Helligkeit in Bereichen um erkannte Merkmale herum verfolgt, um eine schnelle Verarbeitung bei hohen Bildraten zu erreichen – insbesondere für ressourcenbeschränkte Plattformen wie Drohnen. DROID-SLAM (Teed & Deng, 2021)** ersetzt die explizite Merkmalsextraktion und den Matching-Schritt vollständig durch Deep Learning. Dabei werden Kamerapose und Tiefeninformationen pro Pixel mithilfe eines Korrelationsvolumens, eines rekurrenten Aktualisierungsoperators und einer differenzierbaren Bundle-Adjustment-Schicht geschätzt – der repräsentative lernbasierte Ansatz (seine internen Mechanismen werden in Visual-SLAM Trends detaillierter beschrieben).
9. Merkmalsbasiert vs. Direkt vs. Lernbasiert
Im Wesentlichen lassen sich diese Algorithmen einer von drei Designphilosophien zuordnen.
| Aspekt | Merkmalsbasiert (z. B. ORB-SLAM3) | Direkt (z. B. DSO/LSD-SLAM) | Lernbasiert (z. B. DROID-SLAM) |
|---|---|---|---|
| Prinzip | Erkennt und beschreibt Merkmale und berechnet die Pose aus der geometrischen Beziehung zwischen Korrespondenzen | Überspringt Merkmale vollständig und minimiert die Bildhelligkeit direkt, um die Pose zu bestimmen | Ein neuronales Netzwerk lernt, Merkmalsextraktion, Korrespondenz und Pose-/Tiefenschätzung zu ersetzen |
| Genauigkeit | Hoch bei vielen Merkmalen; erzeugt tendenziell eine spärliche Karte | Funktioniert überall dort, wo ein Helligkeitsgradient vorhanden ist; kann semidichte bis dichte Karten erzeugen | Relativ robust auch in texturarmen Umgebungen; dichte Tiefeninformationen lassen sich leicht ermitteln |
| Rechenaufwand | Mittel (Merkmalsextraktion, Deskriptoren, Matching) | Variiert je nach Implementierung, im Allgemeinen ressourcenschonend (insbesondere DSO optimiert auf Effizienz) | Hoch (allein die Inferenz benötigt oft mehrere bis über ein Dutzend GB GPU-Speicher) |
| Robustheit | Schwach in texturarmen Umgebungen oder bei dynamischen Objekten; vergleichsweise robust gegenüber Lichtänderungen | Empfindlich gegenüber Helligkeitsänderungen (automatische Belichtung, Beleuchtung) | Stark innerhalb des Bereichs der Trainingsdaten, aber die Generalisierung auf unbekannte Umgebungen kann eingeschränkt sein |
Implementierungsschwierigkeiten | Viele ausgereifte Open-Source-Implementierungen, einfach zu übernehmen | Mathematische Berechnungen (Linearisierung der Helligkeit) sind etwas komplexer | Vortrainierte Modelle sind einfach zu verwenden; das erneute Training oder die Optimierung der internen Parameter erfordert mehr Fachwissen |
Merkmalsbasierte Methoden haben die längste Erfolgsgeschichte und werden häufig in eingebetteten Systemen eingesetzt. Direkte Methoden eignen sich besser für Umgebungen mit wenigen Texturen. Lernbasierte Methoden verbessern sich rasant, benötigen aber mehr Rechenleistung – dies ist in etwa die aktuelle Situation im Jahr 2026.
10. Das Backend
Die Genauigkeit von Visual-SLAM hängt letztendlich nicht nur vom Frontend (Merkmalsextraktion, Tracking, Pose-Schätzung) ab, sondern vom Backend, das die gesammelten Beobachtungen zu einem konsistenten Ergebnis verarbeitet.
Die Bundle Adjustment optimiert Kameraposen und die 3D-Positionen von Landmarken gemeinsam, um maximale Konsistenz mit jeder Beobachtung zu gewährleisten. Es minimiert den gesamten Reprojektionsfehler – die Diskrepanz zwischen einem Landmarkenpunkt \mathbf{X}_i, der mithilfe der Kamerapose (R_j, \mathbf{t}_j) in ein Bild projiziert wird, und dem tatsächlichen Beobachtungsort des entsprechenden Merkmals \mathbf{u}_{ij}.
\pi(\cdot) ist die Projektionsfunktion von einem 3D-Punkt auf die Bildebene, basierend auf den intrinsischen Kameraparametern. Die globale Bündelausgleichung, die jedes Bild und jeden Landmarkenpunkt gleichzeitig optimiert, ist hochpräzise, aber rechenintensiv. In der Praxis wird sie typischerweise mit der lokalen Bündelausgleichung kombiniert, die auf die letzten wenigen Bilder beschränkt ist, um den Rechenaufwand überschaubar zu halten.
Wird ein Schleifenschluss erkannt, kommt die Pose-Graph-Optimierung zum Einsatz. Im Gegensatz zur Bündelausgleichung, die jeden Landmarkenpunkt berücksichtigt, behandelt die Pose-Graph-Optimierung nur die Kamerapose in jedem Zeitschritt als Knoten. Die Kanten kodieren relative Posebeschränkungen zwischen den Bildern – so wird die Pose schnell optimiert. Die durch den Schleifenschluss hinzugefügte neue Nebenbedingung verteilt die akkumulierte Drift über die gesamte Schleife.
Beide Probleme werden im Rahmen der nichtlinearen Optimierung gelöst. Da die Projektionsfunktion \pi(\cdot) und die Zusammensetzung von Rotationen in einer Pose inhärent nichtlinear sind, werden iterative Verfahren wie Gauss-Newton und Levenberg-Marquardt verwendet. Bibliotheken wie g2o und Ceres Solver sind in Visual-SLAM-Implementierungen weit verbreitet.
11. Wo Visual-SLAM an seine Grenzen stößt
Da Visual-SLAM auf einem passiven Sensor – einer Kamera – basiert, verschlechtert sich seine Genauigkeit in einigen Situationen systematisch.
-
Dunkelheit: Bei unzureichendem Licht verschlechtert sich das Signal-Rausch-Verhältnis des Bildes, was sowohl die Merkmalserkennung als auch die Helligkeitsgradientenberechnungen, auf denen direkte Methoden beruhen, destabilisiert. Infrarotbeleuchtete RGB-D-Kameras können dies teilweise kompensieren, der Effekt ist jedoch im Freien bei Nacht begrenzt.
-
Geringe Textur: Weiße Wände, glatte Böden, Glasflächen – überall dort, wo Helligkeitsverläufe selten sind, lassen sich keine Merkmale erkennen oder die Minimierung des direkten Verfahrens wird schlecht konditioniert und neigt zu lokalen Minima.
-
Schnelle Bewegung: Schnelle Kamerabewegungen oder -rotationen vergrößern den Suchbereich, der für die Zuordnung von Bildern benötigt wird. In Kombination mit Bewegungsunschärfe (siehe unten) bricht das Tracking leicht zusammen. Die Verwendung eines IMU (VIO) ist die Standardmethode, um diese Schwäche auszugleichen.
-
Dynamische Objekte: Werden Merkmale eines sich bewegenden Fußgängers oder Autos so behandelt, als gehörten sie zur statischen Umgebung, führt dies zu Fehlern in der Schätzung der Kamerabewegung. Dies erfordert entweder eine Vorverarbeitung zur Erkennung und zum Ausschluss dynamischer Objekte oder Erweiterungen, die diese explizit modellieren.
-
Bewegungsunschärfe: Unschärfe durch Kamera- oder Objektbewegungen während des Belichtungsfensters destabilisiert Merkmalsdeskriptoren und verschlechtert die Genauigkeit der Zuordnung. Global-Shutter-Kameras oder Umgebungen mit hellem Licht und kurzen Belichtungszeiten reduzieren die Auswirkungen.
All diese Probleme haben eines gemeinsam: Die Kamera erhält schlichtweg nicht genügend visuelle Informationen. Ein aktiver Entfernungsmesser wie LiDAR (siehe LiDAR-SLAM-Technologietrends) umgeht die meisten dieser Schwächen prinzipiell, weist aber selbst Schwächen auf (siehe Abschnitt 2) – kein einzelner Sensor ist universell ausreichend, und genau diese Komplementarität macht die Sensorfusion (siehe Einführung in die Sensorfusion) so wichtig.
12. Die Wahl einer Methode in der Praxis
Die Wahl eines Visual-SLAM-Ansatzes hängt stark davon ab, welche Sensoren verfügbar sind, wie viel Rechenleistung zur Verfügung steht und welche Genauigkeit und Echtzeitfähigkeit die Anwendung erfordert.
-
Roboter (Serviceroboter für Innenräume, Reinigungsroboter): Oftmals auf kostengünstige Kamerasysteme beschränkt, bei denen merkmalsbasierte ORB-SLAM-Verfahren oder dichte Kartierung mittels RGB-D-Kameras praktikable Optionen darstellen. In Umgebungen mit vielen Korridoren und geringer Textur ist die Kombination mit LiDAR sinnvoll.
-
Drohnen: Strenge Beschränkungen hinsichtlich Rechenleistung und Nutzlastgewicht erfordern ressourcenschonende, semi-direkte Verfahren wie SVO oder eng gekoppelte VIO-Konfigurationen mit einer IMU.
-
AR/VR: Echtzeitfähigkeit und geringe Latenz haben höchste Priorität, und eine visuell-inertiale Konfiguration in Kombination mit der im Headset integrierten IMU hat sich als De-facto-Standard etabliert. Insbesondere in AR bestimmt die globale Konsistenz direkt, ob virtuelle Objekte driften, weshalb die Genauigkeit des Schleifenschlusses ebenfalls von großer Bedeutung ist.
-
Autonomes Fahren: Wird selten als eigenständiges Visual-SLAM eingesetzt; Kamerabasierte visuelle Informationen werden typischerweise in ein Multisensorfusionssystem mit LiDAR, Radar und GNSS integriert (siehe Sensor Fusion Primer).
– Innen- vs. Außenbereich: In Innenräumen sind die Lichtveränderungen gering und die Umgebung strukturiert, sodass merkmalsbasierte Verfahren gut funktionieren. Im Freien stellen hingegen wechselnde Lichtverhältnisse, dynamische Objekte und große Flächen Herausforderungen dar, wodurch die Robustheit des Schleifenschlusses umso wichtiger wird.
Ab 2026 sieht die grobe Entscheidungsgrundlage wie folgt aus: Lernbasierte Verfahren sind die richtige Wahl, wenn ausreichend Rechenleistung zur Verfügung steht und höchste Genauigkeit angestrebt wird; merkmalsbasierte Verfahren sind optimal, wenn es vorgefundene Daten und geringer Ressourcenverbrauch besonders wichtig sind; und direkte Verfahren sind unerlässlich, wenn Robustheit in Umgebungen mit geringer Textur erforderlich ist. Die neuesten Forschungsrichtungen – die Umgestaltung der Kartendarstellung mit 3D Gaussian Splatting/NeRF, Feedforward-3D-Fundamentmodelle und mehr – werden in Visual-SLAM Trends behandelt.
Fünf Prüfungen vor der Implementierung
Die alleinige Auswahl anhand des Algorithmusnamens erschwert die Fehlerdiagnose im Feld. Stellen Sie vor der Implementierung sicher, dass diese fünf Punkte protokolliert werden können. So können Sie bei einem Tracking-Fehler ein Sensorproblem von einem Problem des Schätzers unterscheiden.
| Prüfung | Vorbereitende Informationen | Was passiert, wenn etwas fehlt? | |---|---| | Kalibrierung | Intrinsische Parameter K, Linsenverzerrung und ggf. die Stereo-Baseline | Reprojektionsfehler ähneln einem Positionsfehler, und die Skalierung kann nicht berechnet werden | | Zeitsynchronisation | Frame-Zeitstempel, Kamera-IMU-Offset und Frame-Drops | Bei schnellen Bewegungen beschreiben Bild- und Inertialdaten unterschiedliche Positionen. |
Verschluss und Belichtung | Globaler/Rolling-Shutter, Belichtungszeit und Einstellungen für die automatische Belichtung | Bewegungsunschärfe oder geometrische Verzerrung werden fälschlicherweise als Algorithmusfehler interpretiert. |
Dynamische Objekte | Verwendung von Masken, Anteil bewegter Objekte und verworfene Korrespondenzen | Fußgänger oder Fahrzeuge werden in die statische Karte integriert. |
Evaluierungsprotokolle | Ground Truth, ATE/RPE, Track-Loss-Zeiten und Ergebnisse der Schleifenerkennung | Die bloße Beobachtung einer Bewegung reicht nicht aus, um Genauigkeit, Drift oder Wiederherstellung zu vergleichen. |
Das Ausfüllen dieser Tabelle erleichtert zudem die Unterscheidung zwischen notwendigen und unveränderlichen Parametern beim Wechsel von Feature-basierten zu direkten oder lernbasierten Methoden. Visual-SLAM sollte als System – inklusive Kamera, Timing, Vorverarbeitung, Optimierung und Evaluierung – und nicht als isolierter Algorithmus betrachtet werden.
13. Zusammenfassung
Visual-SLAM verfolgt Korrespondenzen ausschließlich anhand von Kamerabildern, rekonstruiert die Kamerabewegung mittels Epipolargeometrie und PnP und korrigiert kontinuierlich akkumulierte Fehler durch eine Mapping- und Schleifenschließung – wodurch simultane Lokalisierung und Kartierung erreicht werden. Die drei Designphilosophien – Feature-basiert (die ORB-SLAM-Familie), Direkt (DSO/LSD-SLAM) und Lernbasiert (DROID-SLAM) – basieren jeweils auf unterschiedlichen Kompromissen und lassen sich am besten anhand der Achsen verstehen, ob Features explizit verarbeitet werden, ob die Helligkeit direkt genutzt wird und wie viel dem Lernen überlassen wird. Die Wahl des Ansatzes ist eine anwendungsspezifische Entscheidung, die die verfügbaren Sensoren, Rechenkapazitäten sowie die erforderliche Genauigkeit und Echtzeitfähigkeit berücksichtigt.
14. Referenzen
Die wichtigsten Veröffentlichungen und Forschungsseiten zu den oben beschriebenen repräsentativen Methoden und der Zwei-Ansichten-Geometrie sind hier als Ausgangspunkte für die Implementierung und weiterführende Literatur zusammengestellt. Um Verwechslungen zwischen den Aussagen einer Veröffentlichung und der tatsächlichen Leistung auf einem bestimmten Produkt oder Datensatz zu vermeiden, lesen Sie bitte den verlinkten Text zusammen mit den zugehörigen experimentellen Bedingungen.
-
ORB-SLAM3: Eine präzise Open-Source-Bibliothek für visuelles, visuell-inertiales und Multi-Map-SLAM – eine Bibliothek für visuelle, visuell-inertiale und Multi-Map-Verfahren.
-
DROID-SLAM: Deep Visual SLAM für monokulare, Stereo- und RGB-D-Kameras – ein lernbasiertes Verfahren, das Korrelationsvolumina mit differenzierbarer dichter Bündelausgleichung kombiniert.
-
LSD-SLAM: Großflächiges direktes monokulares SLAM – die offizielle Forschungsseite für direktes, semidichtes monokulares SLAM.
-
Direkte spärliche Odometrie – die DSO-Veröffentlichung zur Optimierung photometrischer Fehler mittels gleitender Fenster.
-
Eine effiziente Lösung für das Fünf-Punkt-Problem der relativen Lagebestimmung – die Originalveröffentlichung zum 5-Punkt-Essential-Matrix-Solver.
Führt eine ansprechende Karte zu einer genauen Lokalisierung?
Bewerten Sie die Kartendarstellung unabhängig vom Trajektorienfehler. Prüfen Sie Skalierung, Ausrichtung, lokalen Fehler und Langzeitdrift.
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.