
Contents — find the section you need
I metodi neurali 3D apprendono una rappresentazione della scena da più immagini e posizioni della telecamera, quindi renderizzano un'immagine da un punto di vista non acquisito. Mentre la SfM (Screen from Motion) stima principalmente le posizioni e i punti sparsi, e la MVS (Multi-View Synthesis) ricostruisce principalmente la geometria densa, il 3D neurale modella anche l'aspetto di una scena da una posizione e direzione di visualizzazione.
In breve
-
NeRF rappresenta una scena come una funzione che restituisce densità e radianza in base alla posizione e alla direzione di visualizzazione; 3D Gaussian Splatting ottimizza molti elementi gaussiani 3D espliciti.
-
Riprodurre correttamente le viste di addestramento non dimostra che le viste o la geometria non viste siano corrette.
-
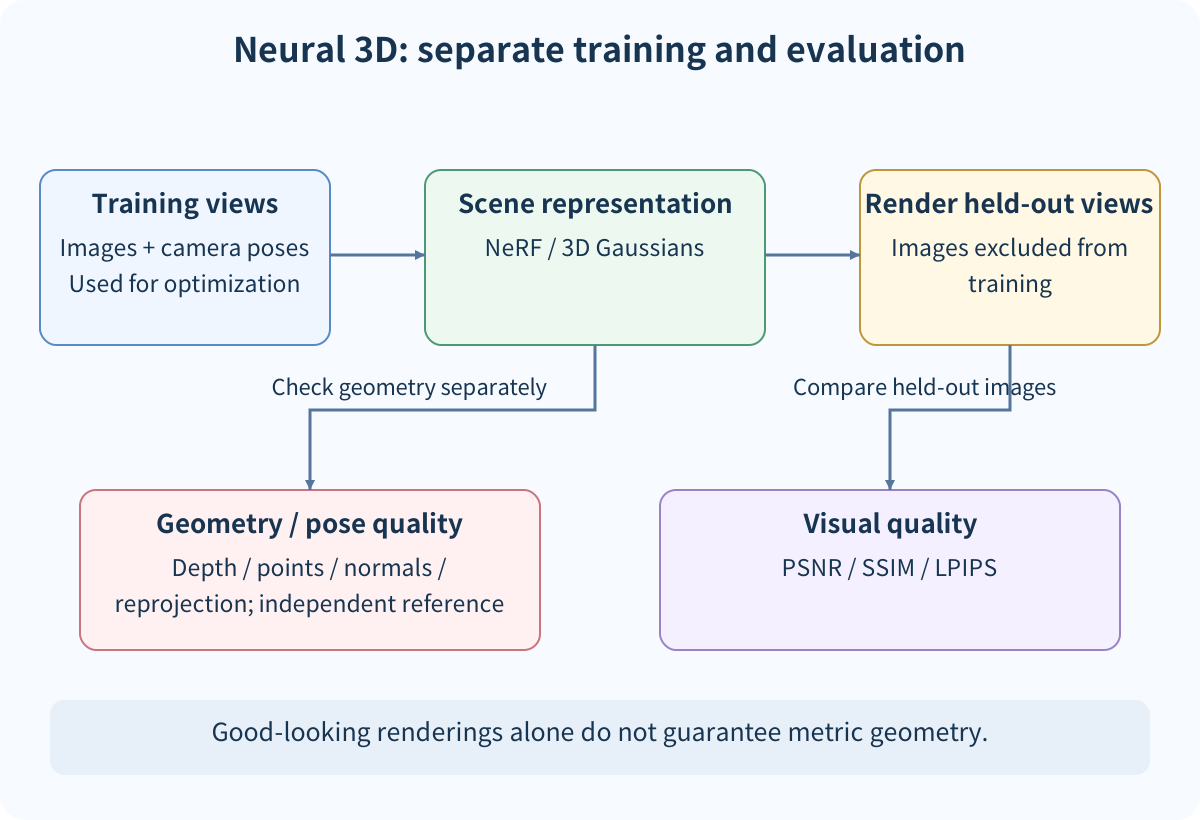
Separare le metriche dell'immagine come PSNR/SSIM dalla valutazione geometrica di profondità, punti, normali e posizioni. La sintesi di viste nuove non è una prova di accuratezza di un'indagine.
Scelte di rappresentazione
NeRF valuta (\sigma,\mathbf{c})=F_\theta(\mathbf{x},\mathbf{d}) in corrispondenza di campioni lungo i raggi della telecamera e utilizza il rendering volumetrico per formare un'immagine. L'addestramento minimizza la differenza tra l'immagine renderizzata e l'immagine di input. Il 3D Gaussian Splatting proietta funzioni gaussiane con posizione, covarianza, opacità e colore, ottimizzando questi elementi a partire da punti sparsi.
| Rappresentazione | Punti di forza | Avvertenza |
|---|---|---|
| Famiglia NeRF | Campo di radianza continuo e aspetto dipendente dal punto di vista | Molti campioni di raggi; addestramento e rendering dipendono dalla configurazione |
| 3D Gaussian Splatting | Gli elementi proiettati esplicitamente possono essere renderizzati rapidamente | Validazione separata di densità, geometria non visibile e oggetti dinamici |
| Mesh / MVS | La geometria della superficie è esplicita e facile da ispezionare | Sensibile a riflessi, occlusioni, fori e texture deboli |
Separazione tra viste di addestramento e di valutazione
Il rendering di ogni immagine di input utilizzata per l'addestramento misura solo la ricostruzione delle viste osservate. Non stabilisce l'interpolazione nelle regioni non viste. Suddividere le immagini o la traiettoria della telecamera in viste di addestramento, di validazione e di test, e fissare la spaziatura delle viste, la sovrapposizione, gli oggetti in movimento e la sorgente della posa della telecamera. Se le pose vengono stimate, registrare anche la loro incertezza.
PSNR, SSIM e LPIPS possono misurare la somiglianza delle immagini, ma misurano l'aspetto. La valutazione geometrica dovrebbe confrontare separatamente profondità, punti, normali, pose della telecamera ed errore di riproiezione. Una rappresentazione sfocata può migliorare il punteggio di un'immagine, ma posizionare un muro o una struttura sottile in modo errato.
Condizioni di errore comuni
-
Specchi, superfici trasparenti, riflessi e illuminazione variabile invalidano l'assunto che un punto abbia un aspetto coerente.
-
Le regioni al di fuori della traiettoria di addestramento o nascoste da occlusioni possono apparire plausibili senza prove concrete.
-
Persone, veicoli o piante in movimento trattati come geometria statica possono creare immagini fantasma e superfici duplicate.
-
Se le pose o la scala SfM sono instabili, le sole immagini renderizzate non sono sufficienti a identificarne la causa.
Riepilogo
Neural 3D apprende una rappresentazione della scena dipendente dal punto di vista a partire da immagini e pose. NeRF e 3D Gaussian Splatting utilizzano rappresentazioni e strategie di rendering diverse, ma entrambe richiedono una chiara separazione tra la ricostruzione della vista di training e la generalizzazione della vista di test. Registrare separatamente la qualità visiva, la geometria, l'errore di posa, il contenuto dinamico e le divisioni della vista prima di interpretare un risultato.
Un PSNR elevato nella vista di training dimostra che la geometria 3D è corretta?
No.
Verifica separatamente le viste nascoste, le metriche di profondità o di nuvola di punti e l'errore di posa della telecamera.Riferimenti
- Mildenhall et al., NeRF: Rappresentazione delle scene come campi di radianza neurale per la sintesi delle viste
- Kerbl et al., Splatting gaussiano 3D per il rendering in tempo reale dei campi di radianza
Commenti
Accedi per continuare.
Nessun dato disponibile.